Czy generator obrazów potrafi znaleźć krzesło, które sam mógłby narysować?
Open Vision Banana traktuje segmentację i ocenę głębi jak edycję obrazu. Porównaj warianty badawcze, warunki pomiarów i sposób sprawdzenia ich na własnych zdjęciach.
Sklep meblowy chce podmienić tło na zdjęciu pokoju. Osoba edytująca zdjęcie musi wiedzieć, gdzie kończy się krzesło, która część rośliny je zasłania i czy dywan przechodzi za jego nogami. Generator potrafi narysować przekonujące nowe wnętrze. Do wiarygodnego oddzielenia krzesła, które już jest na zdjęciu, od jego otoczenia potrzeba jednak czegoś więcej.
Autorzy Open Vision Banana traktują takie zadania percepcji jak edycję obrazu. Dostosowują generatory FLUX.2 [klein] Base z 4 i 9 mld parametrów tak, aby różne odpowiedzi dało się zapisać w RGB. Maska wskazuje obszary, a obraz głębi opisuje zależności odległości między powierzchniami w reprezentacji modelu. Format wyniku jest wspólny, a zadania i sposoby pomiaru błędu pozostają różne. Preprint z 11 listopada 2026 r..
To rozróżnienie ma praktyczne znaczenie. Wspólna podstawa pozwala podjąć kilka zadań wizualnych, ale każdy wynik trzeba sprawdzić według innych kryteriów. Zespół edycyjny chce wiedzieć, czy maska nadaje się do kompozycji i czy przybliżona mapa głębi zachowuje potrzebną kolejność obiektów. Przyjrzyjmy się temu na przykładzie zdjęcia pokoju.
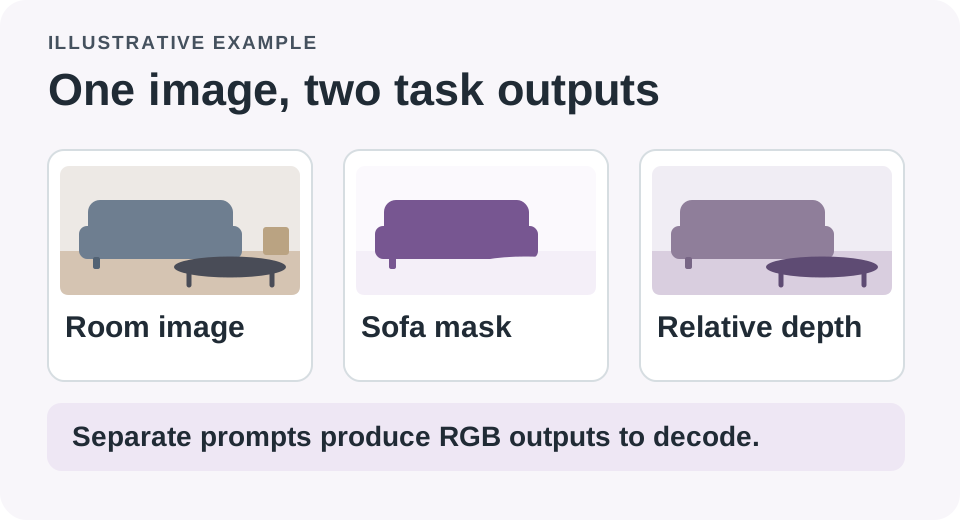
Segmentacja i głębia mogą korzystać z jednego formatu, odpowiadając na różne pytania o to samo zdjęcie.
Z jednego zdjęcia można uzyskać różne odpowiedzi
Segmentacja semantyczna przypisuje piksele do kategorii, takich jak krzesło lub podłoga. Segmentacja instancji próbuje rozdzielić konkretne obiekty z tej samej kategorii, na przykład niemal identyczne krzesła z lewej i prawej strony. Segmentacja na podstawie opisu wskazuje obszar odpowiadający poleceniu takiemu jak „krzesło przy oknie”. Mapa głębi oddaje pozorną odległość elementów sceny. Projekt obsługuje też wektory normalne, które opisują orientację powierzchni.
Open Vision Banana dostaje obraz wejściowy i polecenie, a zwraca zmieniony obraz z odpowiedzią. W poleceniu segmentacji można ustalić legendę, w której klasa ma przypisany kolor. Wygenerowane oznaczenia da się wtedy odczytać według tej legendy. Głębię dekoduje się i ocenia według osobnych reguł. Autorzy zwracają uwagę na treść polecenia, sposób kodowania kolorów, dostosowanie parametrów i dobór zadań do wspólnego treningu. Połączenie kilku obiecujących pojedynczych decyzji nie zawsze daje najlepszy model wielozadaniowy.
Przy zdjęciu wnętrza dobra maska pozwala podmienić tło i zachować krawędzie krzesła. Przybliżona głębia może pomóc sprawdzić kompozycję, w której nowy element ma znaleźć się za krzesłem, ale przed ścianą. Te dwa zadania potrzebują innych kontroli jakości. Gładka mapa bywa nieprzydatna, jeśli umieści zasłaniającą roślinę za krzesłem. Ładny obraz z mniej więcej poprawnym obszarem krzesła może pomijać cienkie nogi, których potrzebuje końcowa kompozycja.
| Wynik | Co sprawdzić na zdjęciu pokoju | Co może ukryć podgląd |
|---|---|---|
| Maska klasy | Piksele krzesła są oddzielone od podłogi i ściany | Znikają cienkie nogi lub prześwit pod krzesłem |
| Maska według opisu lub instancji | Wskazane krzesło jest oddzielone od pozostałych | Kategoria jest poprawna, lecz wskazano inne krzesło |
| Ocena głębi | Pierwszy plan i tło zachowują potrzebną kolejność | Gładka mapa umieszcza obiekt zasłaniający za tym, który jest zasłonięty |
Galeria przedstawia wyniki przygotowane przez autorów. Scena z krzesłem jest przykładem. Próba wycięcia obiektu z własnego zdjęcia mówi o przydatności w pracy więcej niż udany przypadek wybrany do prezentacji badawczej.
Wysoki wynik ma określony protokół pomiaru
W semantycznej segmentacji Cityscapes autorzy podają 73,9 mIoU dla swojej wersji zero-shot z 9 mld parametrów. Dla Vision Banana podano wcześniej 69,9. mIoU określa średni według zasad testu stosunek części wspólnej obszarów przewidywanych i referencyjnych do ich sumy. W wyniku dla Cityscapes połączono 20 przebiegów. W każdym inaczej przypisywano kolory tym samym klasom, a potem uzgadniano odpowiedzi. Jeden przebieg i dwadzieścia mają różne opóźnienia i koszty. Oficjalne uwagi o ocenie.
W pracy pokazano przypadki poprawy wyniku dzięki głosowaniu, bez zmiany wag. To dane z konfiguracji testowej autorów. Zacznij od prostszych ustawień i sprawdź, czy dodatkowe przebiegi pomagają na błędy, które Ciebie interesują. Gdy każdy przebieg pomija cienką przezroczystą krawędź, głosowanie nie zastąpi lepiej dobranego narzędzia. Może za to pomóc przy niestabilnym odczycie polecenia lub przypisania koloru. Z myślą o tym powstała ta technika.
Dokumentacja odróżnia zestawy treningowe zero-shot od non-zero-shot. Druga grupa może zawierać części treningowe zestawów używanych do oceny. Pierwsza je według projektu wyklucza. Nagłówek porównujący tylko podobne liczby może zakryć tę różnicę. Ponadto niektóre próby segmentacji instancji używają innego modelu do sprawdzenia obecności obiektu, a ReasonSeg korzysta z przeredagowanych zapytań. Według autorów wyraźniejsza luka względem Vision Banana pozostaje w segmentacji instancji. Czytaj tabelę wyników jako zestaw różnych protokołów.
Głębia również potrzebuje osobnego kontekstu. W ocenie na NYUv2 projekt dopasowuje wartości odwrotnej głębi osobno dla każdego zdjęcia. Dzięki temu można porównać istotne aspekty głębi względnej w ramach przyjętego protokołu. Wysoki wynik po dopasowaniu nie podaje wymiarów w centymetrach. Projektant może sprawdzić, co leży z przodu. Pomiary bezwzględne, prześwit dla robota i decyzje dotyczące bezpieczeństwa wymagają danych z systemów zbudowanych i sprawdzonych do tych celów.
Nawet przekonujący obraz trzeba sprawdzić na krawędziach oraz w miejscach, gdzie obiekty się nakładają.
Jeden model może uprościć integrację i wymagać więcej kontroli
Warto spróbować nawet wtedy, gdy specjalistyczny model wciąż wygrywa w jednym zadaniu. Maskę obszaru, obraz głębi i edycję można zamawiać w podobny sposób, korzystając z tej samej rodziny modeli w badaniu. Według autorów dostosowane modele w dużej mierze zachowują zdolność do edycji obrazów. Można więc sprawdzić, jak jeden system sporządza maskę i przygotowuje edycję na powiązanych danych. Zanim porzucisz narzędzie skuteczne w którymś zadaniu, sprawdź obydwa wyniki.
Porównaj generator i wyspecjalizowany model maskowania na tym samym obiekcie. Zapisz, czy wynik da się łatwo zmienić na kanał alfa potrzebny edytorowi. Policz osobno błędy na włosach, szkle, prześwitach i cieniach oraz błędy na dużych nieprzezroczystych powierzchniach. Zdjęcie biurka może zadziałać w jednym przebiegu. Przy katalogu mebli o połyskliwych powierzchniach sprawdzanie i poprawki mogą kosztować więcej niż integracja wyspecjalizowanego narzędzia.
Zarówno w rodzinie 4B, jak i 9B wydano warianty zero-shot oraz non-zero-shot. Mniejsza wersja jest dobrą kandydatką do ograniczonej próby, a potrzeby pamięci zależą od sposobu uruchomienia. Zużycie zasobów zależy od całego procesu, rozdzielczości, precyzji, środowiska wykonawczego i liczby przebiegów. Zapisuj ustawienia, żeby oddzielić efekt zmiany modelu od zmiany konfiguracji. Porównuj cały czas potrzebny na uzyskanie akceptowalnego rezultatu.
Zespół udostępnia kod i instrukcje uruchomienia oraz galerię wyników. Repozytorium wskazuje Apache 2.0 dla kodu i FLUX Non-Commercial License dla opublikowanych wag. Dane zachowują swoje pierwotne licencje. Publiczne wagi ułatwiają badania. Przed użyciem w komercyjnym katalogu trzeba sprawdzić uprawnienia. Poniższa próba pomaga poznać metodę. Przed wdrożeniem uzyskaj zgodę odpowiednią do planowanego zastosowania.
Zacznij od zdjęć, na których łatwo zauważyć błąd
Pierwsze porównanie może być niewielkie. Weź własne zdjęcia lub takie, które wolno Ci przetwarzać. Obiekt i przybliżona kolejność planów powinny być rozpoznawalne bez pomocy modelu. Wybierz przykłady z prostym konturem i z trudnym nakładaniem się przedmiotów. Przy porównywalnych uruchomieniach zachowaj ten sam rozmiar obrazu i treść polecenia. Dzięki temu ustalisz, gdzie i w jaki sposób wynik zawodzi, zanim rozszerzysz proces, który może działać tylko na wybranych scenach.
- Oznacz ręcznie kilka obiektów i zasłonięć. Dodaj ujęcie bez poszukiwanego obiektu. Łatwiej wtedy wyłapać przekonujące fałszywe wskazanie.
- Wybierz i zapisz punkt kontrolny, polecenie, rozmiar zdjęcia i liczbę przebiegów. Uruchom specjalistyczne i wspólne rozwiązanie na identycznych danych.
- Przetestuj końcową maskę lub mapę głębi w operacji, której ma służyć. Wycięty obiekt umieść na kontrastowym tle.
- Notuj czas poprawek i typowe kategorie błędów. Zachowaj specjalistyczne narzędzie tam, gdzie wspólny model wymaga więcej edycji lub ukrywa poważny błąd.
Jeśli model przygotował słabą maskę i udaną przeróbkę zdjęcia, zanotuj obie obserwacje. Odpowiadają na różne pytania. W projekcie wielozadaniowym średni wynik może ukryć ten jeden słaby rezultat, przez który człowiek musi powtórzyć kolejny krok. Pierwsza próba ma wskazać decyzje, które model wspiera wystarczająco dobrze.
Mierz przypadki ważne dla osoby edytującej materiał. Możesz policzyć, przy ilu krzesłach trzeba było poprawić nogi lub ramę i w ilu scenach model zachował porządek zasłaniania. Dziesięć własnych zdjęć nie daje dowodu szerokiej skuteczności. Może jednak szybko wskazać powtarzalny błąd na realistycznym materiale, który w rankingu zniknąłby po uśrednieniu.
Porównanie powinno objąć też końcowy format wyniku. Maskę zapisaną jako wizualizacja RGB czasem trzeba przekonwertować na przezroczystość. Sprawdź, czy konwersja zachowuje legendę klas i czy w pliku wynikowym nie powstają niejednoznaczne piksele. Trzymaj oddzielnie wygenerowany obraz i otrzymaną maskę, by pomyłki przy konwersji nie uznać za błąd modelu. Przy zmianie legendy kolorów zapisz ją obok wyniku. Dzięki temu kolory w pliku będzie można potem poprawnie odczytać.
Drugim zastosowaniem może być biblioteka odniesień wizualnych. Projektant szukający „lampy między półkami” potrzebuje podpowiedzi obszaru. Dokładność każdego piksela jest mniej ważna niż w publikowanym obrazie. Kilka propozycji do wyboru może dać więcej niż jedno samodzielnie wykrojone, pewne siebie wskazanie. Wymagania zależą od zadania. Pominięcie przedmiotu na tablicy inspiracji ma inny koszt niż przekazanie montażyście subtelnie niekompletnej sylwetki.
Ładny obraz i trafne rozpoznanie wymagają osobnych sprawdzianów
Przykład kreatywny daje wynikowi konkretne zadanie. Osoba edytująca zdjęcie potrzebuje obszaru, który poprawnie zachowuje się w kompozycji. Sam wygląd maski niewiele o tym mówi. Open Vision Banana warto obserwować, ponieważ jedna rodzina modeli podejmuje kilka zadań, a opublikowana metoda pozwala to sprawdzić. Czasem wystarczy zobaczyć, czy po podmianie tła krzesło zachowa wszystkie cztery nogi.
Źródła
- Preprint Open Vision Banana, pierwsza publikacja 11 listopada 2026 r.
- Projekt zespołu badawczego i galeria wyników
- Oficjalny kod, punkty kontrolne, protokół oceny i licencje
Uporządkuj zdjęcia testowe, polecenia i porównania podczas oceny procesu wizyjnego. Utwórz pierwszą notatkę w Telli.sh.