Un generatore di immagini sa trovare la sedia che di solito disegnerebbe?
Open Vision Banana tratta segmentazione e profondità come compiti di editing. Confronta i checkpoint di ricerca, le condizioni del benchmark e un modo pratico per provarli.
Un rivenditore di mobili vuole cambiare lo sfondo di una foto d’interni. Chi modifica l’immagine deve capire dove finisce la sedia, quale parte della pianta le si sovrappone e se il tappeto passa dietro le sue gambe. Un generatore può dipingere una stanza nuova e convincente. Per ricavarne una maschera affidabile che separi la sedia esistente da ciò che la circonda serve un’altra verifica.
In un preprint dell’11 novembre 2026, gli autori di Open Vision Banana trattano questi compiti di percezione come operazioni di editing. Adattano i generatori di immagini FLUX.2 [klein] Base da 4 e 9 miliardi di parametri per esprimere in immagini RGB più tipi di risposta. Nel caso di una maschera, la risposta identifica regioni. Nel caso della profondità, codifica la relazione fra le distanze delle superfici secondo la rappresentazione del modello. Il formato di output è condiviso, mentre il compito e il modo di misurare gli errori restano diversi.
La distinzione è al centro di questa ricerca. Dalla stessa base si possono ricavare più funzioni visive, ma il risultato deve superare i controlli propri di ciascuna. Per chi modifica immagini, questo significa verificare se la maschera regge quando la si inserisce in un fotomontaggio e se la mappa di profondità approssimata conserva l’ordine degli oggetti che conta per il ritocco. Usiamo una foto d’interni per vedere come fare il confronto.
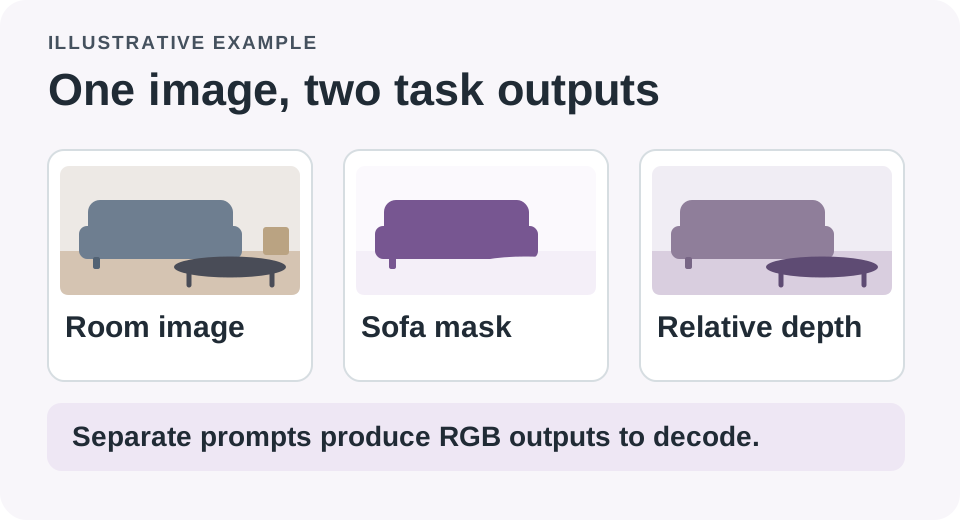
Segmentazione e profondità possono condividere il formato di output pur rispondendo a domande diverse sulla stessa immagine.
Si può trasformare una foto in una risposta in più modi
La segmentazione semantica assegna i pixel a categorie come sedia o pavimento. La segmentazione per istanze cerca di separare singoli oggetti della stessa categoria: la sedia da pranzo a sinistra è distinta da quella quasi identica a destra. La segmentazione guidata da descrizione parte da un’indicazione, come la sedia vicino alla finestra, e chiede la regione corrispondente. Una mappa di profondità rappresenta la scena in base alle distanze apparenti. Il progetto supporta anche le normali alle superfici, che ne descrivono l’orientamento.
Open Vision Banana usa un’immagine di partenza e un prompt per il compito. Restituisce un’immagine modificata che contiene la risposta. Un prompt di segmentazione può specificare una legenda che associa ciascuna classe a un colore. Le etichette generate si interpretano poi con quella legenda. Per la profondità, decodifica e valutazione seguono convenzioni proprie. Gli autori indicano la formulazione del prompt, la codifica dei colori, l’adattamento dei parametri e la scelta dei compiti da combinare come parti decisive del metodo di addestramento. Il miglior modello per più compiti non è necessariamente quello che riunisce le scelte migliori prese separatamente.
Nella foto della stanza, una buona maschera permette di cambiare lo sfondo mantenendo il contorno della sedia. Le stime di profondità possono aiutare a controllare una composizione in cui un nuovo elemento deve stare dietro la sedia e davanti alla parete. I due esempi richiedono controlli di qualità diversi. Una mappa di profondità uniforme può essere inutilizzabile se colloca dalla parte sbagliata una pianta sovrapposta alla sedia. Un risultato gradevole che individua quasi tutta la sedia può comunque omettere le gambe sottili da conservare nel montaggio finale.
| Output | Cosa controllare nella foto della stanza | Errore che l’anteprima può nascondere |
|---|---|---|
| Maschera di classe | I pixel della sedia sono separati da pavimento e parete | Scompaiono gambe sottili o lo spazio sotto la sedia |
| Maschera guidata da descrizione o per istanza | La sedia richiesta è distinta dalle altre | La categoria è corretta anche se l’istanza è sbagliata |
| Stima della profondità | Primo piano e sfondo mantengono l’ordine utile | Una mappa uniforme sposta l’elemento che copre un oggetto dietro l’oggetto sbagliato |
La galleria rimanda ai risultati degli autori. Lo scenario qui sopra è illustrativo. Per capire se il metodo serve davvero, prova a scontornare una stanza in una tua foto. Un esempio scelto dal team di ricerca dice meno sul tuo flusso di lavoro.
Il punteggio alto dipende dal protocollo
Nella segmentazione semantica di Cityscapes gli autori riportano 73,9 mIoU per il modello da 9 miliardi in modalità zero-shot, contro il precedente 69,9 riportato per Vision Banana. L’intersezione media sull’unione misura la sovrapposizione tra regioni previste e di riferimento, calcolando la media secondo le regole del benchmark. Le note ufficiali di valutazione indicano che il risultato Cityscapes combina 20 passaggi con legende diverse. A ogni passaggio si associano colori diversi alle stesse categorie e poi si aggregano le risposte. Uno e venti passaggi hanno costi e tempi diversi.
Il paper riporta casi in cui il voto migliora i punteggi senza cambiare i pesi. È un risultato ottenuto con la configurazione adottata dagli autori. Per le tue foto, inizia dalla configurazione più semplice e verifica se i passaggi in più correggono il problema che ti interessa. Se tutti perdono un bordo sottile e trasparente, serve uno strumento più adatto. L’aggregazione dei risultati può aiutare quando l’instabilità viene dal modo in cui il modello interpreta il prompt o associa le classi ai colori, il problema per cui è stata progettata.
La documentazione distingue anche i mix di addestramento zero-shot e non zero-shot. Il secondo tipo può includere le partizioni di addestramento dei benchmark di valutazione. Secondo il progetto, il primo le esclude. Un titolo che mette a confronto i numeri apparentemente più vicini rischia di perdere la distinzione. Allo stesso modo, alcune esecuzioni di segmentazione per istanze usano un altro modello per verificare la presenza dell’oggetto e ReasonSeg usa riscritture delle richieste. Il paper rileva che nella segmentazione per istanze i risultati restano più distanti da quelli di Vision Banana. Leggi il benchmark alla luce dei protocolli specifici per ogni prova.
Anche i dati di profondità vanno letti nel loro contesto. Nella valutazione su NYUv2 il progetto allinea la disparità per ogni immagine. Così si possono confrontare aspetti rilevanti della profondità relativa secondo il protocollo. Un punteggio alto dopo l’allineamento non fornisce misure reali. Un team di progettazione può verificare quale oggetto viene prima, mentre misure assolute, spazio necessario a un robot e sicurezza fisica richiedono evidenze da sistemi progettati e verificati per quelle decisioni.
Un buon risultato visivo richiede comunque controlli specifici sui bordi e nelle zone di sovrapposizione.
Un editor condiviso può ridurre il codice di integrazione e introdurre altri costi
Ci sono ragioni per provare l’approccio anche se un modello specializzato continua a prevalere in un compito. Potresti riuscire a richiedere una maschera di regione, un’immagine di profondità e un ritocco in modi simili, usando una sola famiglia di modelli per il progetto di ricerca. Secondo il paper, i modelli adattati mantengono in gran parte la capacità di editing della base. Questo permette di sperimentare con un unico sistema che produca una maschera e una bozza di modifica a partire da input collegati. Controlla entrambi i risultati prima di sostituire uno strumento che svolge già bene uno dei due compiti.
Confronta un’esecuzione con il generatore e un modello specializzato in maschere sullo stesso soggetto. Verifica se l’output si converte senza problemi nella maschera alfa attesa dall’editor. Conta separatamente gli errori su capelli, vetro, interstizi e ombre e quelli sulle superfici ampie e opache. Per una foto di una scrivania può bastare un passaggio. Per un catalogo di mobili riflettenti, il tempo per controllare e ripulire i risultati potrebbe superare il vantaggio di condividere un modello.
Le famiglie di checkpoint da 4 e 9 miliardi includono entrambe versioni zero-shot e non zero-shot. Un checkpoint più piccolo è un candidato ragionevole per una valutazione limitata. Verifica il consumo effettivo di memoria. L’uso delle risorse dipende da pipeline, risoluzione, precisione, ambiente di esecuzione e numero di passaggi. Annota i fattori per distinguere un cambio di modello da un cambio di impostazioni. Confronta il tempo totale necessario per ottenere un risultato accettabile, includendo anche il lavoro dopo la previsione più rapida.
Il team pubblica codice e istruzioni di configurazione e una galleria di risultati. Il repository indica la licenza Apache 2.0 per il codice e la FLUX Non-Commercial License per i pesi distribuiti. I dati mantengono le licenze originarie. Poter scaricare i pesi aiuta la ricerca. Per un progetto di catalogo commerciale servono diritti adeguati. Usa la prova qui sotto per capire il metodo e ottieni le autorizzazioni applicabili prima di adottarlo.
Inizia da immagini in cui gli errori sono visibili
Un confronto esplorativo può essere piccolo. Usa foto che hai scattato o che hai il permesso di elaborare. Scegli immagini in cui puoi riconoscere l’oggetto cercato e l’ordine approssimativo in primo piano senza chiedere al modello. Includi profili facili da distinguere e sovrapposizioni ambigue. Usa le stesse dimensioni e lo stesso prompt per tutte le esecuzioni comparabili. Cerca di capire quale compito fallisce e come, prima di ampliare un flusso che potrebbe apparire affidabile solo su esempi selezionati.
- Annota a mano un piccolo insieme di oggetti e occlusioni. Includi un oggetto assente, così un falso positivo dall’aspetto plausibile salterà all’occhio.
- Seleziona e registra il checkpoint, il prompt, le dimensioni dell’immagine e il numero di passaggi. Confronta modello specializzato e modello condiviso su immagini identiche.
- Controlla l’output finale di maschera o profondità nell’operazione a cui serve. Prova uno scontorno su uno sfondo a contrasto per valutare la qualità del risultato nel montaggio.
- Registra il tempo delle correzioni e le categorie di errori più frequenti. Tieni lo strumento specializzato attuale se il modello condiviso aumenta il lavoro di editing o nasconde un errore importante.
Quando un candidato produce una maschera scadente ma modifica in modo convincente l’immagine originale, annota entrambi i fatti. Rispondono a domande diverse. In un progetto con più compiti, il punteggio medio può nascondere l’unico output debole che obbliga una persona a rifare l’operazione successiva. Il primo obiettivo di un progetto pilota è capire quali poche decisioni il nuovo modello possa supportare con affidabilità. Il numero di funzioni elencate in una slide conta meno.
Quantifica i casi che interessano a chi modifica le immagini. Conta, per esempio, quante sedie selezionate hanno richiesto una correzione manuale alle gambe o alla struttura e quante scene mantengono l’ordine delle sovrapposizioni nel confronto. Dieci foto tue producono un campione troppo piccolo per stabilire la precisione generale. Possono comunque farti risparmiare tempo se una foto realistica rivela sistematicamente un errore che si perderebbe nella media di una classifica pubblica.
Il confronto dovrebbe coprire anche il processo di esportazione. Una maschera salvata come visualizzazione RGB può richiedere una conversione prima di poter essere usata come trasparenza. Verifica se la conversione conserva la legenda di classi richiesta e se l’immagine salvata introduce pixel ambigui. Tieni separate l’immagine generata e la maschera derivata per individuare eventuali errori di conversione. Se provi una nuova legenda dei colori, registrala insieme al risultato, così potrai interpretare correttamente il file in seguito.
Un secondo esempio è una libreria di riferimenti visivi. Chi cerca «la lampada fra gli scaffali» può trarre vantaggio da una regione suggerita senza esigere la precisione a livello di pixel necessaria per la pubblicazione. In quel caso può essere più utile mostrare alcune corrispondenze possibili e lasciare la scelta al designer. La decisione sulla messa in produzione dipende dal compito. Saltare occasionalmente un elemento di una moodboard ha un costo diverso dal consegnare a chi fa il fotomontaggio un contorno appena incompleto.
Una bella immagine può nascondere una percezione sbagliata
L’esempio creativo funziona perché assegna un compito al risultato. Chi modifica la foto ha bisogno di una regione che si comporti correttamente in un fotomontaggio. L’aspetto della maschera da solo dice poco. Open Vision Banana raccoglie più funzioni nella stessa famiglia di modelli e pubblica quanto serve per metterle alla prova. Il test può essere semplice: quando cambia lo sfondo, la sedia conserva tutte e quattro le gambe?
Fonti
- Preprint di Open Vision Banana, prima versione dell’11 novembre 2026
- Progetto del team di ricerca e galleria dei risultati
- Codice ufficiale, checkpoint, protocollo di valutazione e note sulle licenze
Tieni in ordine foto di prova, prompt e appunti del confronto mentre valuti un flusso di visione. Crea la tua prima nota con Telli.sh.