Un générateur d’images peut-il repérer la chaise qu’il saurait dessiner ?
Open Vision Banana formule la segmentation et l’estimation de profondeur comme des retouches d’image. Comparez ses modèles de recherche, leur protocole d’évaluation et une façon de les essayer.
Un vendeur de meubles veut changer l’arrière-plan d’une photo d’intérieur. Pour réussir le montage, il faut savoir où s’arrête la chaise, quelle partie de la plante passe devant elle et si le tapis passe derrière ses pieds. Un générateur sait peindre une nouvelle pièce de façon convaincante. Cela ne garantit pas que le masque qu’il produit isolera correctement la chaise déjà présente.
Dans une prépublication du 11 novembre 2026, les auteurs d’Open Vision Banana abordent ces tâches de perception comme des retouches d’image. Ils adaptent les générateurs FLUX.2 [klein] Base de 4 et 9 milliards de paramètres pour exprimer plusieurs types de réponse sous forme d’image RVB. Un masque indique les régions. Une carte de profondeur encode les relations de distance entre les surfaces selon la représentation du modèle. Le format est commun. La tâche et la manière de mesurer les erreurs changent.
Une même base peut assurer plusieurs tâches de vision, à condition que chaque résultat satisfasse aux critères de sa tâche. En retouche, il s’agit de vérifier qu’un masque tient la route une fois intégré au montage et qu’une carte de profondeur approximative respecte l’ordre des plans nécessaire à l’image finale. Prenons une photo d’intérieur pour illustrer cette comparaison.
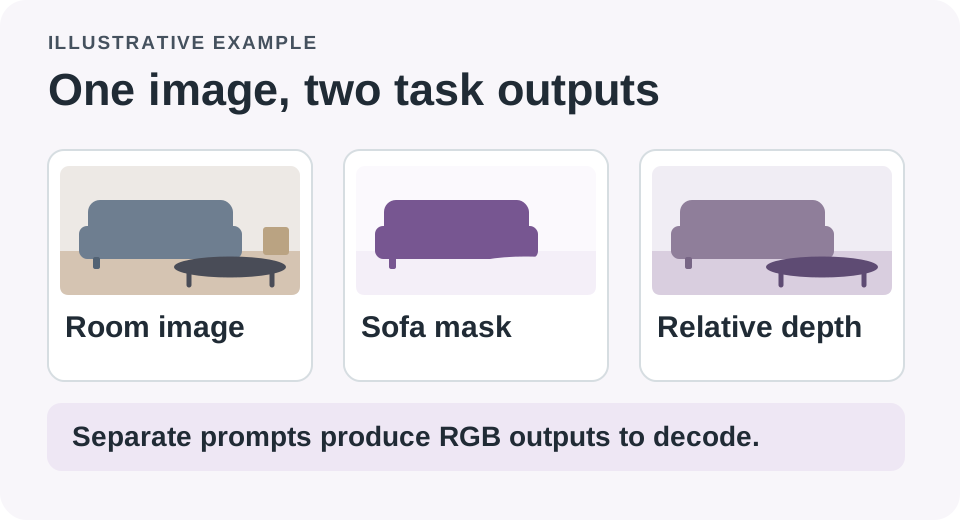
La segmentation et la profondeur peuvent utiliser le même format pour répondre à des questions différentes sur une image.
Une image peut répondre à plusieurs questions
La segmentation sémantique attribue une catégorie à chaque pixel, par exemple chaise ou sol. La segmentation d’instances cherche à séparer les objets d’une même catégorie. La chaise de gauche se distingue ainsi de celle de droite, presque identique. La segmentation référentielle part d’une description, comme « la chaise à côté de la fenêtre », et recherche la région correspondante. Une carte de profondeur exprime les distances apparentes dans la scène. Les normales aux surfaces décrivent leur orientation. Le projet prend également en charge cette tâche.
Open Vision Banana prend une image et une consigne pour produire une version retouchée qui porte la réponse. Pour une segmentation, le prompt peut donner une légende qui associe une couleur à chaque catégorie. On interprète ensuite les étiquettes produites à l’aide de cette légende. La sortie de profondeur est décodée et évaluée selon ses propres conventions. Pour les auteurs, la formulation du prompt, le codage couleur, l’adaptation des paramètres et le mélange des tâches influent sur l’entraînement. Combiner des choix prometteurs pris séparément ne garantit pas le meilleur modèle multitâche.
Pour la photo d’intérieur, un masque exploitable permet de changer le décor tout en préservant les contours de la chaise. Une estimation de profondeur peut aider à vérifier un montage dans lequel un nouvel élément doit passer derrière la chaise et devant le mur. Ces deux usages demandent des contrôles différents. Une carte lisse peut être inadaptée si elle place une plante qui masque la chaise du mauvais côté. Un masque visuellement satisfaisant peut couvrir la chaise en gros et pourtant oublier les pieds fins dont dépend le montage.
| Sortie | Ce qu’il faut examiner sur une photo d’intérieur | Défaut que l’aperçu peut masquer |
|---|---|---|
| Masque de catégories | Les pixels de la chaise sont séparés du sol et du mur | Les pieds fins ou l’espace sous la chaise disparaissent |
| Masque référentiel ou d’instance | La chaise demandée se distingue des autres | La catégorie est juste, mais l’instance ne l’est pas |
| Estimation de profondeur | Le premier plan et l’arrière-plan restent dans le bon ordre | Une carte lisse place un élément occultant derrière le mauvais objet |
La galerie présente les sorties des auteurs. La scène décrite ici est un exemple. Un détourage réalisé sur vos propres images vous renseignera mieux sur l’adéquation à votre travail qu’un bel exemple choisi par l’équipe de recherche.
Le score dépend du protocole
En segmentation sémantique sur Cityscapes, les auteurs rapportent 73,9 de mIoU pour le modèle à 9 milliards de paramètres en zero-shot, contre les 69,9 précédemment rapportés pour Vision Banana. La mIoU, ou moyenne du rapport entre l’intersection et l’union, mesure le recouvrement entre les régions prédites et celles de référence, agrégé selon le protocole du benchmark. Le résultat Cityscapes repose sur 20 passes qui font varier la légende des couleurs. Elles associent des couleurs différentes aux mêmes catégories puis combinent les sorties. Une seule passe et vingt passes n’ont ni la même latence ni le même coût. Les notes d’évaluation officielles précisent ces conditions.
L’article présente des cas où ce vote améliore les scores sans toucher aux poids du modèle. Cela renseigne sur le protocole des auteurs. Vos photos peuvent donner d’autres résultats. Essayez d’abord la configuration la plus simple, puis vérifiez si les passes supplémentaires corrigent l’erreur qui vous importe. Si un contour fin et transparent manque systématiquement, le vote majoritaire ne remplace pas un outil mieux adapté. Il peut aider quand l’instabilité vient du prompt ou de l’association des catégories aux couleurs, le problème visé par cette technique.
La documentation distingue aussi les mélanges de données d’entraînement avec et sans protocole zero-shot. Selon le projet, le mélange non zero-shot peut inclure les partitions d’entraînement des benchmarks d’évaluation, tandis que le mélange zero-shot les exclut. Comparer les chiffres les plus proches dans un titre peut effacer cette distinction. Certaines évaluations de segmentation d’instances utilisent aussi un autre modèle pour décider si l’objet est présent, et ReasonSeg utilise des reformulations de requêtes. D’après l’article, les résultats de segmentation d’instances restent plus éloignés de ceux de Vision Banana. Lisez ce tableau comme un ensemble de protocoles, dont aucun ne désigne à lui seul le meilleur modèle pour tous les usages.
Les scores de profondeur ont leurs propres conditions. Sur NYUv2, le projet aligne la disparité pour chaque image. Cela permet de comparer des aspects importants de la profondeur relative dans le cadre du protocole. Même un très bon score après alignement ne donne pas une distance absolue. Une équipe de création peut vérifier quel objet est devant l’autre. Pour les mesures absolues, les distances de sécurité d’un robot ou la sécurité physique, il faut des systèmes conçus et validés pour ces décisions.
Même une belle sortie doit être vérifiée aux bords et dans les zones de recouvrement, selon la tâche.
Un même outil peut simplifier l’intégration et déplacer le coût
L’approche mérite un essai même si un modèle spécialisé reste meilleur sur une tâche. Elle permet d’envisager la demande d’un masque, d’une carte de profondeur et d’une retouche avec des méthodes voisines, au sein d’une seule famille de modèles. L’article indique que les variantes adaptées conservent largement la capacité de retouche de leur modèle de base. On peut donc essayer de faire produire le masque et une première retouche au même système à partir d’entrées apparentées. Vérifiez les deux résultats avant de retirer les outils qui font déjà bien ces tâches.
Comparez un essai avec le générateur et un modèle de masquage dédié sur le même objet demandé. Notez si la sortie se convertit proprement en masque alpha au format de votre logiciel de retouche. Comptez séparément les erreurs sur les cheveux, le verre, les ajours et les ombres, et celles sur les grandes surfaces opaques. Une seule passe peut suffire sur une photo de bureau. Pour un catalogue de meubles brillants, le temps passé à vérifier et à corriger peut annuler l’avantage d’un modèle commun.
Les variantes à 4 et 9 milliards de paramètres sont toutes deux disponibles en versions zero-shot et non zero-shot. Un modèle plus petit se prête à un essai limité. Le budget mémoire doit encore être vérifié. Au total, les ressources nécessaires dépendent du pipeline, de la résolution, de la précision, du moteur d’exécution et du nombre de passes. Consignez ces paramètres pour pouvoir distinguer l’effet du modèle de celui des réglages. Comparez le temps total nécessaire pour obtenir un résultat acceptable.
L’équipe publie le code et les instructions d’installation ainsi qu’une galerie des résultats. Le dépôt indique une licence Apache 2.0 pour le code et la FLUX Non-Commercial License pour les poids diffusés. Les données conservent leurs licences d’origine. Le téléchargement public facilite la recherche. Pour utiliser les mêmes fichiers dans un catalogue commercial, il faut vérifier que les droits couvrent cet usage. Procédez à l’essai ci-dessous pour comprendre la méthode, puis obtenez les autorisations correspondant à votre projet.
Commencez par des images sur lesquelles vous savez repérer un échec
Une première comparaison peut rester modeste. Utilisez des photos que vous avez prises ou que vous pouvez traiter, où vous savez identifier l’objet visé et l’ordre approximatif des plans sans demander au modèle. Choisissez à la fois une silhouette simple et une superposition ambiguë. Conservez la même taille d’image et le même prompt pour les essais comparables. Cherchez à savoir quelle tâche échoue et de quelle façon avant de généraliser un procédé qui pourrait sembler fiable uniquement sur des exemples sélectionnés.
- Annotez à la main quelques objets et zones d’occultation. Ajoutez une cible absente pour repérer un faux positif qui paraît plausible.
- Choisissez et notez le modèle, le prompt, la taille d’image et le nombre de passes. Comparez l’outil spécialisé et le modèle commun sur les mêmes images.
- Vérifiez la sortie de masque ou de profondeur dans l’opération qu’elle doit permettre. Pour un détourage, essayez-le sur un fond contrasté afin de juger le rendu.
- Mesurez le temps de correction et relevez les catégories d’erreur fréquentes. Gardez l’outil spécialisé si le modèle commun augmente le travail de retouche ou masque une erreur importante.
Si un essai donne un mauvais masque et une retouche convaincante de la photo initiale, notez les deux observations. Elles répondent à des questions différentes. Dans un projet multitâche, la moyenne peut cacher la seule sortie défaillante qui oblige quelqu’un à recommencer l’étape suivante. Le pilote sert d’abord à sélectionner les décisions qu’un nouveau modèle peut aider à prendre de façon fiable.
Quantifiez les cas qui comptent pour la personne chargée de la retouche. Comptez, par exemple, les chaises dont les pieds ou le cadre ont nécessité une correction manuelle, puis les scènes qui conservent le bon ordre de recouvrement. Dix photos à vous ne suffisent pas à établir une précision générale. Elles peuvent vous faire gagner du temps en révélant qu’une photo réaliste déclenche régulièrement la même erreur, alors qu’un classement public la dilue dans sa moyenne.
Vérifiez aussi ce qui sort du pipeline. Un masque visualisé en RVB peut demander une conversion avant de servir de transparence. Regardez si la conversion conserve la légende des catégories et si l’image enregistrée introduit des pixels ambigus. Séparez l’image générée et le masque dérivé pour éviter de confondre un défaut de conversion avec un défaut du modèle. Si vous essayez une autre légende, consignez-la avec le résultat pour interpréter correctement les couleurs plus tard.
Une bibliothèque de références visuelles offre un deuxième exemple. Une personne qui cherche « la lampe entre les étagères » peut trouver utile une suggestion de région sans avoir besoin d’une précision au pixel près. Dans ce cas, quelques correspondances soumises à son choix valent parfois mieux qu’un détourage proposé d’office. Les exigences tiennent au travail à accomplir. Un objet manquant dans une planche d’inspiration n’a pas le même coût qu’une silhouette discrètement incomplète remise à une personne chargée du montage.
Une sortie convaincante peut tirer les mauvaises conclusions de l’image
Le cas d’usage créatif donne une fonction au résultat. Il faut une région qui se comporte correctement dans le montage, jusque dans les détails de son contour. Open Vision Banana mérite qu’on suive ses progrès parce qu’il rend plusieurs tâches accessibles à une même famille de modèles et publie assez de détails pour vérifier la méthode. L’essai peut tenir en une question simple. La chaise conserve-t-elle ses quatre pieds quand on change le fond ?
Sources
- Prépublication d’Open Vision Banana, première soumission le 11 novembre 2026
- Site du projet et galerie des résultats de l’équipe
- Code officiel, modèles, protocole d’évaluation et licences
Rassemblez les photos d’essai, les prompts et les notes de comparaison au fil de votre évaluation. Créez votre première note avec Telli.sh.