¿Puede un generador de imágenes localizar la silla que sabría dibujar?
Open Vision Banana plantea la segmentación y la estimación de profundidad como tareas de edición. Compara sus modelos de investigación, las condiciones de evaluación y una forma práctica de ponerlos a prueba.
Una tienda de muebles quiere cambiar el fondo de una foto de interior. Para hacer el montaje, hay que saber dónde termina la silla, qué parte de la planta queda por delante y si la alfombra pasa por detrás de las patas. Un generador puede dibujar una habitación nueva que resulte convincente. Eso no garantiza que separe bien la silla que ya está en la foto.
En un preprint del 11 de noviembre de 2026, los autores de Open Vision Banana abordan estas tareas de percepción como edición de imágenes. Adaptan los generadores FLUX.2 [klein] Base de 4.000 y 9.000 millones de parámetros para expresar varios tipos de respuesta como una imagen RGB. Una máscara identifica regiones. Una estimación de profundidad codifica las relaciones de distancia entre superficies según la representación del modelo. El formato es común. La tarea y la forma de medir los errores cambian.
Una misma base puede ocuparse de varias tareas visuales, siempre que los resultados superen las pruebas propias de cada una. Para un equipo de edición, eso significa comprobar que la máscara funciona en el montaje y que una profundidad aproximada conserva el orden de planos que necesita la edición. Aquí usaremos una foto de interior para ilustrar la comparación.
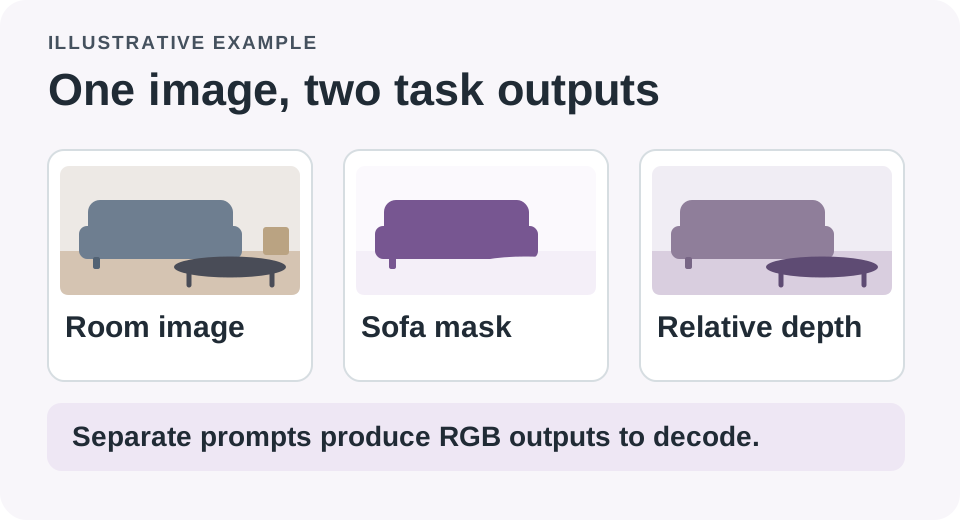
La segmentación y la profundidad pueden compartir un formato y responder preguntas distintas sobre la misma imagen.
Una imagen puede responder a varias preguntas
La segmentación semántica asigna píxeles a categorías como silla o suelo. La segmentación por instancias intenta separar objetos de la misma categoría: la silla de la izquierda es distinta de la casi idéntica que hay a la derecha. La segmentación guiada por una referencia parte de una descripción, como «la silla junto a la ventana», y busca la región correspondiente. Un mapa de profundidad representa las distancias aparentes de la escena. Las normales a las superficies describen la orientación, otra tarea que admite el proyecto.
Open Vision Banana recibe una imagen y una instrucción para producir una edición que contiene la respuesta. En segmentación, el prompt puede incluir una leyenda que asigna un color a cada clase. Las etiquetas generadas se interpretan según esa leyenda. Una salida de profundidad se decodifica y evalúa con sus propias convenciones. Los autores señalan que el diseño del prompt, la codificación en colores, la adaptación de parámetros y la selección de tareas tienen consecuencias en el entrenamiento. Combinar decisiones prometedoras por separado no garantiza el mejor modelo multitarea.
En la foto de interior, una máscara útil permite cambiar el fondo sin perder el contorno de la silla. La profundidad puede ayudar a comprobar un montaje en el que un elemento nuevo tiene que pasar por detrás de la silla y por delante de la pared. Son controles distintos. Un mapa uniforme puede resultar inútil si coloca una planta que tapa la silla en el plano equivocado. Una máscara bonita que acierta aproximadamente con la silla puede omitir las patas finas que necesita el montaje.
| Salida | Qué mirar en una foto de interior | Fallo que puede ocultar la vista previa |
|---|---|---|
| Máscara de clases | Los píxeles de la silla quedan separados del suelo y la pared | Desaparecen las patas finas o el hueco bajo la silla |
| Máscara de referencia o de instancia | La silla pedida se distingue de las demás | La categoría es correcta, pero la instancia no |
| Estimación de profundidad | Primer plano y fondo mantienen el orden que hace falta | Un mapa uniforme coloca un elemento que tapa a otro detrás del objeto equivocado |
La galería muestra resultados de los autores. El caso descrito aquí sirve como ejemplo. Hacer un recorte con tu propia foto da una idea más clara de si el método sirve para tu trabajo que una imagen atractiva seleccionada por el equipo de investigación.
La puntuación depende del protocolo
Para segmentación semántica en Cityscapes, los autores indican 73,9 mIoU con su modelo de 9.000 millones en zero-shot, frente al 69,9 publicado anteriormente para Vision Banana. La mIoU, o media de la intersección sobre la unión, mide cuánto se solapan las regiones predichas con las de referencia y promedia los resultados según el protocolo. La cifra de Cityscapes usa 20 pasadas que combinan salidas de distintas leyendas de colores. Las mismas categorías reciben distintos colores en cada pasada y después se concilian los resultados. Hacer una pasada y hacer veinte tiene latencias y costes distintos. Las notas oficiales de evaluación especifican las condiciones.
El artículo recoge casos en los que esa votación mejora las puntuaciones sin cambiar los pesos del modelo. Es evidencia sobre el entorno de evaluación de los autores. Tus fotos pueden dar otros resultados. Empieza con la configuración sencilla y comprueba si las pasadas extra ayudan con el fallo que quieres corregir. Si todas pierden un borde fino y transparente, la votación por mayoría no sustituye una herramienta mejor. Puede ayudar cuando la inestabilidad proviene de la instrucción o de la asignación de clases a colores, el problema para el que se diseñó la técnica.
La documentación también distingue las mezclas de entrenamiento zero-shot y no zero-shot. La segunda puede incluir las particiones de entrenamiento de los conjuntos usados para evaluar. Según el proyecto, la primera las excluye. Un titular que solo compare las cifras más parecidas puede borrar esa distinción. Algunas evaluaciones de segmentación por instancias también recurren a otro modelo para comprobar si el objeto está presente, y ReasonSeg usa reformulaciones de las consultas. Según el artículo, los resultados en segmentación por instancias siguen más alejados de los de Vision Banana. Cada resultado debe leerse con su protocolo antes de sacar conclusiones sobre el conjunto de tareas.
La profundidad tiene su propio contexto. En NYUv2, el proyecto aplica una alineación de disparidad por imagen. Así se pueden comparar aspectos importantes de la profundidad relativa dentro del protocolo. Una puntuación alta tras el ajuste no te da una medida absoluta. Un equipo de diseño puede comprobar qué objeto queda delante, pero medir distancias, determinar la holgura de un robot o tomar decisiones de seguridad física requiere sistemas diseñados y verificados para esos fines.
Un buen resultado visual sigue necesitando controles en los bordes y las zonas de solapamiento, según la tarea.
Un editor compartido puede simplificar la integración y trasladar el coste
Hay motivos para probar el enfoque aunque un modelo especializado siga ganando en alguna tarea. Se podría pedir una máscara, una imagen de profundidad y una edición de maneras parecidas, usando una sola familia de modelos en un proyecto de investigación. El artículo indica que las versiones adaptadas conservan en buena medida la capacidad de edición del modelo de base. Así se puede ensayar con un único sistema para generar una máscara y proponer una edición a partir de entradas relacionadas. Comprueba ambas salidas antes de retirar las herramientas que ya cumplen bien alguna de las funciones.
Compara el generador con un modelo de máscaras dedicado sobre el mismo elemento. Apunta si la salida puede convertirse sin problemas en la máscara alfa que espera el editor. Cuenta los errores en pelo, vidrio, huecos y sombras por separado de los que aparecen en grandes superficies opacas. En una foto de escritorio puede bastar una pasada. Para un catálogo lleno de muebles reflectantes, el tiempo de inspección y retoque puede superar la comodidad de compartir el modelo.
Las familias de 4.000 y 9.000 millones de parámetros incluyen versiones zero-shot y no zero-shot. El modelo más pequeño puede servir para una evaluación acotada. El presupuesto de memoria se tiene que comprobar. Los recursos totales dependen del flujo de ejecución, la resolución, la precisión, el motor de inferencia y el número de pasadas. Anota esos factores para poder distinguir un cambio de modelo de un cambio de ajustes. Compara el tiempo total hasta obtener un resultado aceptable.
El equipo publica el código y las instrucciones de instalación y una galería de resultados. El repositorio indica la licencia Apache 2.0 para el código y FLUX Non-Commercial License para los pesos publicados. Los datos conservan sus licencias originales. La descarga pública facilita la investigación. Para usar los mismos archivos en un catálogo comercial hay que comprobar los permisos aplicables. Prueba el método con el ejercicio siguiente y obtén los permisos para el uso que planeas.
Empieza con imágenes en las que puedas ver cuándo falla
Para una primera comparación basta un conjunto pequeño. Usa fotos que hayas hecho o puedas tratar, en las que sepas identificar el objeto pedido y el orden aproximado de los planos sin preguntarle al modelo. Incluye una silueta sencilla y un solapamiento ambiguo. Mantén constantes el tamaño de la imagen y el prompt en las pruebas comparables. Averigua primero qué tarea falla y cómo, antes de extender un proceso que quizá solo parezca fiable con ejemplos seleccionados.
- Etiqueta a mano unos cuantos objetos y oclusiones. Incluye un objeto ausente para detectar un falso positivo que parezca convincente.
- Elige y anota el modelo, el prompt, el tamaño de imagen y el número de pasadas. Compara el especialista y el modelo compartido con las mismas imágenes.
- Comprueba la máscara o la profundidad en la operación para la que la necesitas. Para un recorte, pruébalo sobre un fondo de contraste y observa cómo queda.
- Registra el tiempo de corrección y las clases de fallos frecuentes. Conserva la herramienta especializada si el modelo compartido añade trabajo o esconde un error importante.
Cuando un candidato produce una máscara deficiente y una edición convincente de la imagen original, conserva las dos observaciones. Responden a preguntas distintas. En un proyecto multitarea, la media puede ocultar la salida débil que obliga a alguien a repetir la etapa siguiente. Un piloto sirve para elegir qué decisiones puede respaldar de forma fiable el modelo nuevo.
Cuantifica los casos que importan a quien edita. Por ejemplo, cuenta cuántas sillas seleccionadas requirieron retoques en las patas o en el marco y cuántas escenas mantuvieron el orden de los solapamientos. Diez imágenes propias no permiten establecer una precisión general. Pueden ahorrar tiempo si muestran que una foto realista revela el mismo fallo una y otra vez, aunque una clasificación pública lo diluya en la media.
Compara también lo que sale del otro extremo del proceso. Una máscara representada como imagen RGB puede requerir una conversión antes de servir como transparencia. Comprueba si la conversión conserva la leyenda de clases y si la imagen guardada introduce píxeles ambiguos. Guarda por separado la imagen generada y la máscara derivada para distinguir un fallo de conversión de un fallo del modelo. Si pruebas otra leyenda de colores, guárdala con el resultado para poder interpretarlo bien después.
Una biblioteca de referencias visuales ofrece un segundo ejemplo. A quien busque «la lámpara entre las estanterías» le puede servir una región sugerida sin la precisión píxel a píxel que exige una publicación. En ese caso, mostrar unas pocas coincidencias para que elija la persona puede ser más útil que devolver automáticamente un recorte con mucha confianza. Las exigencias dependen del trabajo. Omitir de vez en cuando un objeto en un tablero de inspiración tiene un coste distinto de entregar una silueta discretamente incompleta a quien hace el montaje.
Una imagen convincente puede describir mal lo que hay en ella
El caso creativo da una función a la salida. Para el montaje hace falta una región que se comporte como debe, incluidos los detalles del contorno. Open Vision Banana merece atención porque pone varias tareas al alcance de una misma familia de modelos y publica suficientes detalles para comprobar la idea. La prueba puede ser muy sencilla. ¿Conserva la silla las cuatro patas al cambiar el fondo?
Fuentes
- Preprint de Open Vision Banana, presentado por primera vez el 11 de noviembre de 2026
- Página del proyecto y galería de resultados del equipo
- Código oficial, modelos, protocolo de evaluación y licencias
Organiza las fotos de prueba, los prompts y tus apuntes de comparación mientras evalúas el flujo de visión artificial. Crea tu primera nota con Telli.sh.