Lokalna AI potrafi już mówić: co naprawdę otwiera Phonon w Ollamie
Ollama dodaje lokalne generowanie mowy modelami Phonon firmy Gradium. Przydatne procesy słuchania, obecna granica macOS i znaczenie licencji najmniejszego modelu.
Odpowiedź lokalnego modelu językowego zwykle nadal kończy jako tekst w terminalu lub czacie. Możesz zadawać następne pytania, ale musisz patrzeć na ekran. Odczyt odpowiedzi na głos wymaga kolejnej aplikacji, innego API lub dodatkowego kroku.
Ogłoszenie Ollamy z 24 października 2026 r. wprowadza generowanie mowy do tego lokalnego procesu. Pierwszą obsługiwaną rodziną jest Phonon firmy Gradium. Tekst może stać się dźwiękiem przez wiersz poleceń lub endpoint zgodny z OpenAI, a odpowiedź modelu językowego można przekazać wprost do modelu syntezy mowy. Oficjalne ogłoszenie.
Dla nieznających narzędzia Ollama służy do pobierania i uruchamiania modeli na własnym komputerze oraz udostępniania ich przez lokalne API. Aktualizacja ma znaczenie, bo mowa staje się kolejną zdolnością modelu w tym środowisku. Lokalna AI może odpowiadać głosem, ale z ważnymi ograniczeniami: zapowiedziana obsługa dotyczy obecnie macOS, a modele Phonon mają różne licencje.
 Oficjalny znak Ollama z repozytorium projektu, licencja MIT. Proporcjonalnie zrasteryzowany na białym tle. To oznaczenie produktu, nie zrzut ekranu ani wygenerowana mowa.

Przydatny głos zaczyna się od skromnej obietnicy
Bezpośrednia funkcja to zamiana tekstu na mowę. Dostarczasz słowa i otrzymujesz syntetyczny dźwięk. Pozwala to łatwiej słuchać odpowiedzi, stworzyć prywatną wersję dokumentu do odsłuchu lub prototypować mówiony interfejs bez rozpoczynania od usługi chmurowej.
Samo to nie tworzy pełnego asystenta głosowego. Słuchanie mikrofonu, wykrywanie końca wypowiedzi, rozpoznawanie mowy, przerywanie odtwarzania i ustalanie dozwolonych działań są osobnymi częściami aplikacji. Płynny głos może sprawić, że niedokończony system wydaje się kompletniejszy.
To rozróżnienie pomaga wybrać pierwszy projekt. Przeczytanie zatwierdzonego akapitu jest ograniczonym zadaniem. System słuchający prośby, przeszukujący prywatne materiały, wybierający narzędzie i wypowiadający wynik ma dużo więcej obowiązków. Phonon dostarcza mu głos, lecz nie potwierdza dokładności ani umocowania wcześniejszych kroków.
Dlatego najlepsze początki mają zrozumiałą granicę tekstu. Można sprawdzić słowa, ocenić ich stosowność i dopiero wygenerować dźwięk. Taki prosty układ ułatwia ustalenie, czy głos poprawia konkretne zadanie.
Premiera ma granice platformy i języka
Instrukcja startowa wymaga Maca z Apple Silicon i Ollamą 0.40.11 lub nowszą; Windows i Linux mają być obsługiwane później. Użytkownik innego systemu nie powinien zakładać, że istniejąca instalacja wspiera już nowy proces. Widoczność biblioteki modelu w sieci to co innego niż dostępność funkcji wykonawczej na każdej platformie.
Wpis Phonon w bibliotece rozróżnia warianty. Podstawowy Phonon przedstawiono dla angielskiego. Rodzina 40M ma wersje dla angielskiego, francuskiego, niemieckiego, hiszpańskiego i portugalskiego oraz wariant wielojęzyczny obejmujący te pięć języków.
Lista nie oznacza uniwersalnej wielojęzycznej mowy. Nie zawiera koreańskiego, więc ta premiera nie potwierdza koreańskiej opcji głosu.
Angielski proces odsłuchu i produkt wielojęzyczny wymagają innej oceny. Pierwszemu może wystarczyć wyraźny odczyt własnych angielskich notatek. Drugi musi sprawdzić języki konkretnego modelu, nazwy, wymowę i zachowanie przy zmianie języka w zdaniu. Etykieta językowa nie dowodzi jakości wszystkich tych przypadków.
Mały model może mieć inne uprawnienia
W rodzinie modeli istnieje różnica licencyjna łatwa do przeoczenia przy wyborze rozmiaru. Podstawowy Phonon jest opisany jako Apache 2.0. Warianty 40M mają CC BY-NC 4.0, czyli ograniczenie do użytku niekomercyjnego. Informacje o modelach i licencjach.
Najmniejszy plik nie jest więc automatycznie najprostszym wyborem dla komercyjnego produktu. Kompaktowy model zachęca do eksperymentów na skromnym komputerze, ale jego prawa użytkowania mogą nie pasować do płatnej usługi lub produkcyjnej aplikacji klienta.
| Opcja do rozważenia | Co się zmienia | Co sprawdzić przed przyjęciem |
|---|---|---|
| Podstawowy Phonon | Angielska mowa z oznaczeniem Apache 2.0 | Dokładny pobrany model, informacje licencyjne i dodatkowe zasoby głosowe |
| Wariant 40M dla jednego języka | Kompaktowy model jednej wymienionej mowy | Ograniczenia niekomercyjne i wymowę własnych materiałów |
| Wielojęzyczny 40M | Jedna mała opcja dla pięciu języków | Tę samą licencję oraz przełączanie i mieszanie języków |
To praktyczna decyzja produktowa, nie argument, że konkretna licencja poprawia mowę. Oddzielnie porównuj jakość, koszt uruchomienia i dozwolone zastosowanie. Zapisuj dokładny testowany wariant, zamiast zostawiać w notatce wdrożenia samo „Phonon”.
Wiersz poleceń pokazuje nową drogę
Na obsługiwanym macOS oficjalne ogłoszenie pokazuje bezpośrednie polecenie:
ollama run phonon "Hello from Ollama."
Demonstruje też przekazywanie tekstu modelu do syntezy mowy:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
To przykłady zapowiedzianego procesu, nie wyniki własnego testu sprzętu. Interesujący jest potok: jeden model tworzy słowa, drugi głos. Krótka odpowiedź i pominięcie ukrytego rozumowania w czytanym wejściu ułatwiają zrozumienie przekazania.
Ogłoszenie pokazuje również zapis mowy do WAV:
ollama run phonon "Save this to a file." > speech.wav
Użyj dokumentowanego polecenia we wspieranym środowisku i sprawdź plik przed budową przetwarzania wsadowego. Istnienie audio nie mówi, czy odczytano każde zdanie, czy początek nie został ucięty i czy ważna liczba brzmi poprawnie.
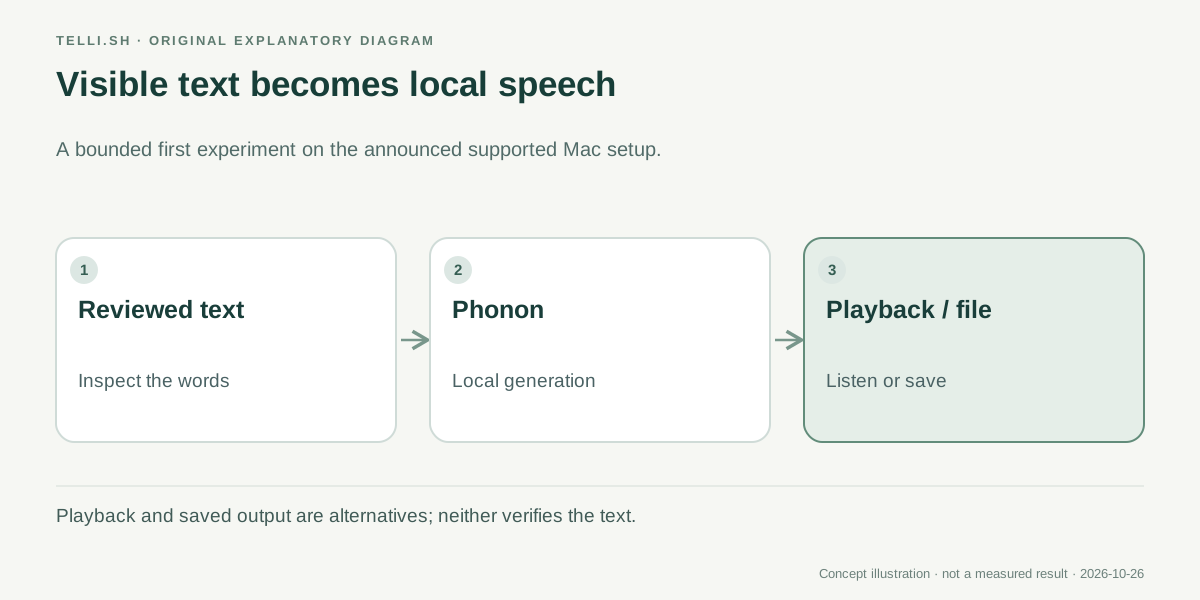 Pierwszą użyteczną granicą jest widoczny tekst. Mowa zmienia sposób dostarczenia odpowiedzi, nie weryfikuje jej niezależnie.
Przykład pierwszy: posłuchaj dokumentu przed wysłaniem
Wyobraźmy sobie konsultanta sprawdzającego angielskie podsumowanie projektu. Dokument gęsto wyjaśnia zmiany, niepewności i kwestie do zatwierdzenia. Na ekranie czyta się przyzwoicie, ale odsłuch ujawnia za długie zdanie lub trudne przejście.
Lokalny model mowy może zmienić zatwierdzony tekst w wersję do słuchania. Konsultant słyszy rzeczywiste brzmienie i poprawia oryginalny dokument. Model nie musi wymyślać streszczenia ani wybierać ważnych stwierdzeń.
Korzyść jest konkretna: dodatkowy sposób kontroli tekstu. Może też pomóc osobie wolącej słuchać lub zmieniającej pracę wizualną na dźwiękową. Nie dowodzi to pełnego rozwiązania dostępności, a głos generowany nie powinien zastępować kontroli potrzeb konkretnego odbiorcy.
Ten przykład ułatwia też rozumienie prywatności. Jeśli generowanie pozostaje lokalne, ten etap nie wymaga wysłania dokumentu do chmurowego dostawcy mowy. Całość nadal może obejmować edytor w chmurze, zdalny model, telemetrię lub współdzielony folder. „Lokalna mowa” opisuje jedną granicę przetwarzania, nie wszystkie otaczające aplikacje.
Przykład drugi: mówiona odpowiedź z widocznym zapisem
Programista może tworzyć mały prototyp nauki języka lub kiosku informacyjnego. Aplikacja generuje krótką odpowiedź, pokazuje słowa i przycisk odsłuchu. Użytkownicy porównują wzrok i słuch, a twórca bada błędy bez zgadywania, co trafiło do modelu mowy.
Znaczenie ma endpoint Ollamy /v1/audio/speech, zgodny z OpenAI i udostępniany lokalnie. Ogłoszenie opisuje go jako drogę integracji syntezy z aplikacjami. Zgodność zmniejsza pracę przy oprogramowaniu opartym już na API mowy, lecz nie dowodzi identycznej lokalnej implementacji każdej opcji dostawcy zdalnego.
Zacznij od udokumentowanego modelu, głosu i zachowania odpowiedzi. Jeśli aplikacja wymaga formatu strumieniowego, anulowania lub kodowania audio, sprawdź dokładnie ten kontrakt. Udane pojedyncze żądanie nie potwierdza poprawności długiej interaktywnej sesji.
W nauce języka zacznij od jednej wspieranej mowy i małego zbioru sprawdzonych zdań. Oddzielnie testuj nazwy i nieznane słowa. Jeśli użytkownik wpisuje dowolny tekst, ustal też obsługę niewspieranych alfabetów, bardzo długiego wejścia i treści, których nie należy wypowiadać w przestrzeni wspólnej.
Jak uzyskać wiedzę z pierwszej próby
Eksperyment pomaga najbardziej, gdy odpowiada na pytanie prowadzące do działania. „Czy wydaje dźwięk?” jest dobrą kontrolą instalacji, ale słabym kryterium przyjęcia. Narzędzie pisarskie potrzebuje zrozumiałych akapitów, prototyp interaktywny także rozsądnego oczekiwania i niezawodnego zatrzymania.
- Potwierdź platformę i środowisko. Sprawdź aktualną dokumentację mowy Ollamy. Instrukcja startowa podaje Maca Apple Silicon i Ollamę 0.40.11 lub nowszą. Przyszłe platformy traktuj jako przyszłą dostępność.
- Wybierz dokładny model i sprawdź licencję. Zapisz tag, język i cel przed porównaniem rozmiaru czy szybkości.
- Przygotuj reprezentatywny tekst. Dodaj zdanie, akapit, liczby, nazwy i trudny dla rzeczywistego procesu przypadek. Zachowaj każde wejście.
- Odsłuchaj cały wynik. Sprawdź pominięcia, wymowę, nienaturalne pauzy, powtórzenia i zakończenie. Oceń plik i bezpośrednie odtwarzanie.
- Zmierz doświadczenie na własnym komputerze. Zapisz sprzęt, model, długość wejścia i czas do użytecznego audio. Porównuj opcje na tym samym materiale.
- Oddziel kontrolę od odtwarzania. Niech człowiek oceni wrażliwe lub istotne słowa przed ich wypowiedzeniem lub rozesłaniem w pliku.
Proces nie wymaga wielkiego benchmarku. Daje małemu zespołowi powtarzalny sposób oceny lokalnej mowy w wąskim zadaniu i wyboru następnego ograniczenia do zbadania.
Deklaracje szybkości potrzebują warunków testu
Ogłoszenie Ollamy zawiera porównania wydajności i jakości mowy. To wyniki dostawcy przy podanych modelach, sprzęcie i warunkach oceny. Wskazują, co zbadać, lecz nie obiecują identycznego opóźnienia na innym komputerze, z innym głosem lub językiem.
Oddziel przepustowość od czasu do pierwszego słyszalnego dźwięku. Model może szybko generować długi fragment, a początek krótkiej interakcji nadal będzie odczuwany jako wolny. Wsadowy szkic audiobooka i odpowiedź rozmowna inaczej ważą te miary.
Pomiary jakości też wymagają kontekstu. Rozpoznawanie słów z generowanej mowy pomaga wykryć problemy zrozumiałości, ale niski błąd nie ocenia w pełni tempa, ekspresji i właściwej wymowy nazwy dla odbiorców. Ludzki odsłuch nadal pomaga na rzeczywistym materiale produktu.
Nie wykonaliśmy niezależnego porównania komputerów na potrzeby artykułu. Praktyczne oczekiwanie to więc nowa lokalna opcja do oceny, nie ogłoszony zwycięzca nad wszystkimi usługami lokalnymi i chmurowymi.
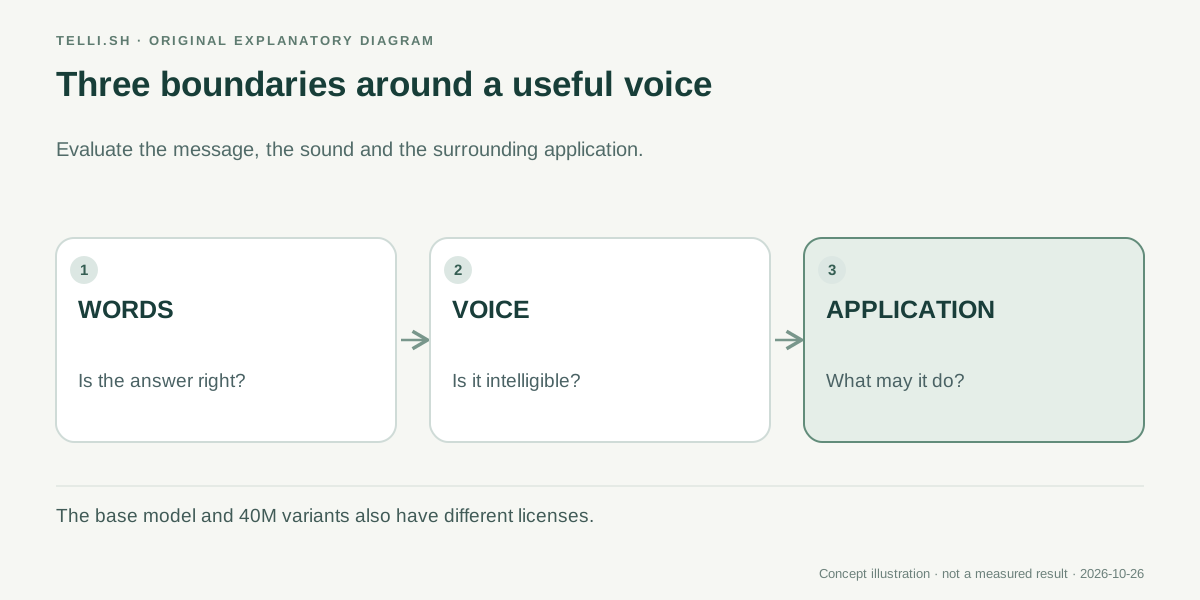 Sprawdzaj oddzielnie słowa, głos i aplikację. Wyraźny głos dostarczy błędną odpowiedź tak samo wyraźnie jak poprawną.
Co lokalna mowa może zmienić dalej
Obiecująca jest zwyczajność tego połączenia. Lokalny model pisze krótkie wyjaśnienie, drugi je czyta, a aplikacja zachowuje widoczny tekst. Mowa staje się składaną zdolnością wyjściową, zamiast osobnym miejscem wklejania tekstu.
Może to ułatwić lokalną kontrolę pisania, prywatne wersje do odsłuchu i małe mówione interfejsy. Może też sprzyjać aplikacjom łączącym specjalizowane modele: jeden rozumie wejście, drugi podejmuje ograniczoną decyzję, trzeci wypowiada sprawdzony wynik.
Następne sprawdziany są konkretne. Więcej systemów operacyjnych rozszerzy grono eksperymentujących. Więcej języków zmieni odbiorców. Lepsze anulowanie, obsługa głosów i integracja wpłyną na naturalność aplikacji. Każde ulepszenie jest inne i wymaga oceny, gdy faktycznie się pojawi.
Na razie wsparcie Phonon w Ollamie daje użyteczny pierwszy krok: pozwól lokalnej AI wypowiedzieć krótki, sprawdzalny tekst i oceń, czy słuchanie poprawia właśnie tę pracę. Niech licencja i granice platformy będą równie widoczne jak głos modelu.
Źródła
- Ollama: Speech models, 24 października 2026 r.
- Ollama: biblioteka Phonon i licencje, sprawdzone 26 października 2026 r.
Chcesz zachować przeszukiwalny zapis tekstów, uwag z odsłuchu i wyborów modeli? Zbierz materiał w Telli.sh i utwórz notatkę, do której wrócisz.