로컬 AI도 말을 한다: Ollama Phonon이 여는 활용
Ollama가 Gradium의 Phonon으로 로컬 음성 생성을 지원합니다. 들어볼 만한 실용 작업과 현재 macOS 조건, 작은 모델의 라이선스를 확인해야 하는 이유를 살펴봅니다.
로컬 언어 모델의 답변은 대개 터미널이나 채팅창의 글자로 끝납니다. 계속 질문할 수는 있지만 화면도 계속 봐야 합니다. 소리 내어 읽으려면 다른 앱이나 API, 추가 단계가 필요합니다.
Ollama의 2026년 10월 24일 발표는 이 로컬 흐름에 음성 생성을 더합니다. 처음 지원하는 음성 모델 계열은 Gradium이 개발한 Phonon입니다. 명령줄이나 OpenAI 호환 음성 엔드포인트로 글을 오디오로 바꾸고, 언어 모델의 답변을 음성 모델에 바로 넘길 수 있습니다. 공식 발표.
Ollama가 낯설다면 모델을 내려받아 자기 컴퓨터에서 실행하고 로컬 API로 제공하는 도구라고 이해하면 됩니다. 이번 업데이트는 그 환경에 음성이라는 모델 기능이 들어온다는 점에서 의미가 있습니다. 로컬 AI가 말로 답할 수 있게 되지만 중요한 제한도 있습니다. 발표된 음성 지원은 현재 macOS 대상이며 Phonon 계열 안에서도 라이선스가 다릅니다.
 Ollama 저장소에서 제공하는 공식 마크입니다. MIT 라이선스. 흰 배경에 비율을 유지해 래스터 이미지로 변환했습니다. 제품 식별 이미지이며 화면 캡처나 생성 음성 결과가 아닙니다.

유용한 목소리는 작은 약속에서 시작한다
당장 제공하는 기능은 텍스트 음성 변환입니다. 글을 주면 합성 오디오를 받습니다. 생성 답변을 듣기 쉽게 만들고, 문서를 개인 청취용 초안으로 바꾸고, 개발자가 호스팅 음성 서비스부터 붙이지 않고 음성 인터페이스를 시도하는 데 쓸 수 있습니다.
이것만으로 완전한 음성 비서가 생기지는 않습니다. 마이크 입력, 말이 끝난 시점 판단, 음성 인식, 재생 중단, 허용 행동 결정은 별도 앱 구성 요소입니다. 자연스러운 목소리는 미완성 시스템을 실제보다 완성도 높게 느끼게 할 수 있습니다.
무엇부터 만들지 정할 때 이 구분이 유용합니다. 승인된 문단을 읽는 일은 범위가 명확합니다. 요청을 듣고 비공개 자료를 찾고 도구를 고른 뒤 결과를 말하는 시스템에는 더 많은 책임이 있습니다. Phonon은 출력 목소리를 제공할 수 있지만 앞선 단계의 정확성이나 권한까지 보장하지는 않습니다.
따라서 좋은 첫 활용처에는 이해할 수 있는 텍스트 경계가 있습니다. 말할 내용을 확인하고 적절한 표현인지 판단한 다음 오디오를 생성합니다. 단순한 구성 덕분에 실제 작업이 음성으로 더 나아지는지 알아보기 쉽습니다.
출시는 플랫폼과 언어의 경계를 갖는다
출시 안내의 요구 조건은 Apple Silicon Mac과 Ollama 0.40.11 이상이며, Windows와 Linux는 이후 지원 예정입니다. 다른 운영체제에서 Ollama를 쓰고 있어도 기존 설치만으로 발표된 음성 흐름이 지원된다고 가정해서는 안 됩니다. 웹에서 모델 목록을 볼 수 있다는 것과 모든 플랫폼에서 실행 기능을 쓸 수 있다는 것은 다릅니다.
Phonon 모델 목록은 모델 선택도 구분합니다. 기본 Phonon은 영어용으로 소개됩니다. 40M 계열에는 영어, 프랑스어, 독일어, 스페인어, 포르투갈어의 언어별 모델과 이 다섯 언어를 다루는 다국어 모델이 있습니다.
이는 모든 언어의 음성을 지원한다는 뜻이 아닙니다. 한국어는 다섯 언어에 포함되지 않으므로 이번 출시만으로 한국어 음성 옵션이 생겼다고 볼 수는 없습니다.
영어 청취 작업과 다국어 제품은 평가가 달라야 합니다. 전자는 영어 노트를 명료하게 읽는 목소리만 필요할 수 있습니다. 후자는 정확히 선택한 모델의 지원 언어, 이름 발음, 문장 안에서 언어가 바뀔 때의 동작을 확인해야 합니다. 언어 표시만으로 이런 사례가 모두 잘된다고 알 수는 없습니다.
작은 모델에는 다른 사용 조건이 붙는다
크기만 보고 고를 때 놓치기 쉬운 라이선스 차이가 있습니다. 기본 Phonon은 Apache 2.0으로 표시됩니다. 40M 모델은 CC BY-NC 4.0으로, 비상업적 이용 제한을 포함합니다. 모델과 라이선스 정보.
따라서 다운로드 크기만으로 상용 제품에 가장 간단한 선택을 할 수는 없습니다. 가벼운 모델은 사양이 낮은 컴퓨터에서 시험하기 매력적이지만 해당 모델의 이용 조건이 유료 서비스나 고객 운영 앱에 맞지 않을 수 있습니다.
| 검토할 선택 | 달라지는 것 | 도입 전에 확인할 것 |
|---|---|---|
| 기본 Phonon | Apache 2.0으로 표시된 영어 음성 옵션 | 실제 내려받은 모델, 고지, 추가 음성 자산 |
| 언어별 40M 모델 | 목록의 한 언어를 위한 소형 모델 | 비상업적 이용 제한과 실제 자료의 발음 |
| 40M 다국어 모델 | 다섯 언어를 위한 소형 옵션 하나 | 같은 라이선스 제한과 언어 전환·혼합 동작 |
라이선스 하나가 음성 품질을 더 좋게 만든다는 주장이 아니라 실용적인 제품 선택 문제입니다. 품질, 실행 비용, 허용 용도를 따로 비교하세요. 배포 기록에 “Phonon”만 쓰지 말고 시험한 정확한 모델을 남기는 편이 좋습니다.
명령줄에서 새로운 연결 경로가 잘 보인다
지원되는 macOS 설치 환경에서 공식 발표는 다음 명령을 보여줍니다.
ollama run phonon "Hello from Ollama."
텍스트 모델의 출력을 음성으로 넘기는 예도 있습니다.
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
발표된 작업 흐름의 예이며 저희 하드웨어 시험 결과는 아닙니다. 핵심은 파이프 연결입니다. 한 모델이 문구를 만들고 다른 모델이 목소리를 만듭니다. 답을 짧게 유지하고 숨은 추론을 음성 입력에서 제외하면 전달 관계도 이해하기 쉽습니다.
생성 음성을 WAV 파일로 저장하는 예도 소개합니다.
ollama run phonon "Save this to a file." > speech.wav
지원 환경에서 문서의 명령을 사용하고, 일괄 처리로 확장하기 전에 결과 파일을 확인하세요. 오디오 파일이 있다는 사실만으로 모든 문장이 읽혔는지, 앞부분이 잘리지 않았는지, 중요한 숫자를 바르게 발음했는지 알 수는 없습니다.
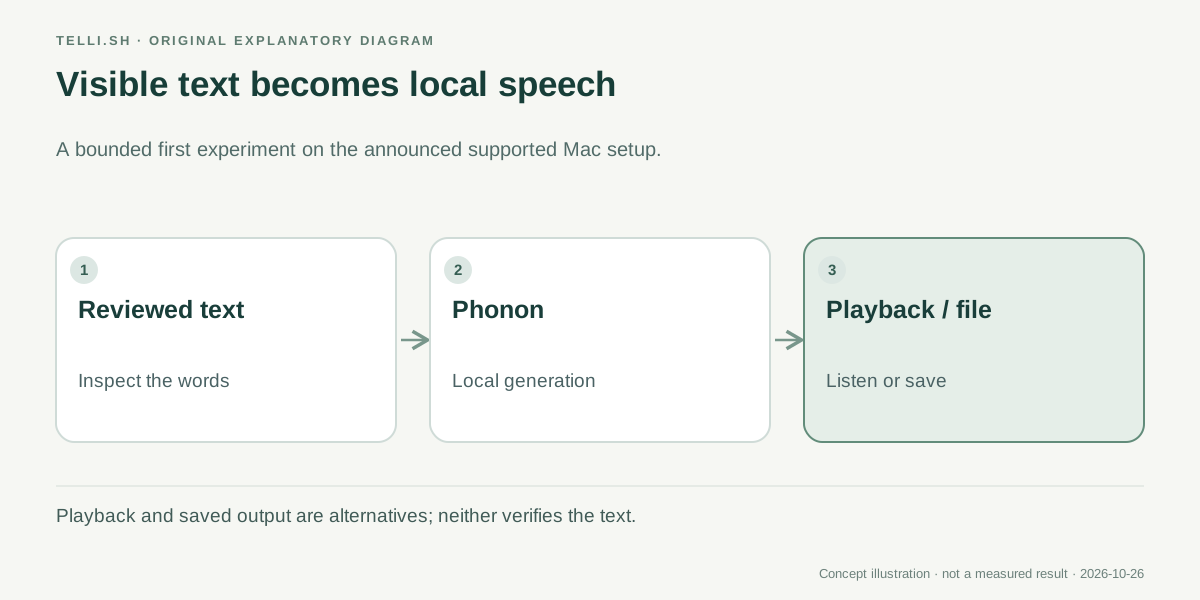 첫 번째 유용한 경계는 눈으로 확인할 수 있는 글입니다. 음성은 전달 방식을 바꾸지만 답변을 독립적으로 검증하지는 않습니다.
첫 번째 예는 보내기 전 문서를 들어보는 일이다
컨설턴트가 영어 프로젝트 업데이트를 검토한다고 생각해 보겠습니다. 문서에는 변경 사항, 남은 불확실성, 고객이 승인해야 할 내용이 빽빽하게 담겼습니다. 화면에서는 괜찮아 보여도 들어보면 지나치게 긴 문장이나 이해하기 어려운 전환을 발견할 수 있습니다.
로컬 음성 모델로 승인된 문구를 청취용 초안으로 바꿀 수 있습니다. 컨설턴트는 실제 문구를 들으면서 원문을 고칩니다. 음성 모델이 요약을 새로 만들거나 중요한 진술을 골라낼 필요는 없습니다.
이점은 글을 검토할 방법이 하나 더 생긴다는 데 있습니다. 듣기를 선호하거나 시각 작업과 청취를 번갈아 하고 싶은 사람에게도 도움이 될 수 있습니다. 완전한 접근성 해결책을 제공한다는 증거는 아니며, 독자의 구체적 요구에 필요한 확인을 생성 음성으로 대체해서는 안 됩니다.
이 예에서는 개인정보 처리 경계도 이해하기 쉽습니다. 생성이 실제로 로컬 프로세스에 머문다면 그 단계에서 문서를 호스팅 음성 제공자에게 보낼 필요가 없습니다. 다만 전체 흐름에는 클라우드 편집기, 원격 언어 모델, 텔레메트리, 공유 저장 폴더가 들어갈 수 있습니다. “로컬 음성”은 처리 경계 하나를 설명하며 주변 앱 전체를 뜻하지는 않습니다.
두 번째 예는 글이 보이는 음성 답변 시제품이다
개발자가 작은 언어 학습 도구나 안내 키오스크 시제품을 만든다고 생각해 보겠습니다. 앱은 짧은 답변을 생성해 글로 보여주고 듣기 버튼을 제공합니다. 사용자는 보고 듣는 내용을 비교하고, 개발자는 음성 모델에 어떤 글이 들어갔는지 추측하지 않고 실패를 살필 수 있습니다.
이때 로컬 실행 환경으로 제공하는 OpenAI 호환 /v1/audio/speech 엔드포인트가 관련됩니다. 공식 발표는 앱에 음성 생성을 통합하는 경로로 설명합니다. 이미 음성 API를 중심으로 만든 소프트웨어라면 호환성이 통합 노력을 줄일 수 있지만, 원격 제공자의 모든 옵션이 로컬에서 똑같이 구현됐다는 뜻은 아닙니다.
문서에 나온 모델, 목소리, 응답 동작부터 시작하세요. 앱이 특정 스트리밍 형식, 취소 동작, 오디오 인코딩을 기대한다면 그 계약을 정확히 시험해야 합니다. 한 줄 요청 성공으로 긴 대화 세션도 제대로 동작한다고 볼 수는 없습니다.
언어 학습 예에서는 지원 언어 하나와 검토한 문장 소수로 시작하세요. 이름과 익숙하지 않은 단어는 따로 시험하면 좋습니다. 사용자가 임의의 글을 입력할 수 있다면 지원하지 않는 문자, 지나치게 긴 입력, 공공장소에서 읽으면 안 되는 내용을 어떻게 다룰지도 결정해야 합니다.
첫 시험은 판단할 수 있는 질문에 답해야 한다
실험은 결과를 보고 행동을 정할 수 있는 질문에 답할 때 유용합니다. “소리가 나나요?”는 좋은 설치 점검이지만 도입 기준으로는 약합니다. 글쓰기 도구에는 이해되는 문단이 필요하고 대화형 시제품에는 적절한 대기 시간과 확실한 중단도 필요합니다.
- 플랫폼과 실행 환경을 확인합니다. 현재 Ollama 음성 문서를 확인하세요. 출시 안내는 Apple Silicon Mac과 Ollama 0.40.11 이상을 제시합니다. 향후 플랫폼은 예정된 지원으로 다룹니다.
- 정확한 모델과 라이선스를 고릅니다. 크기나 속도를 비교하기 전에 태그, 언어, 용도를 기록합니다.
- 대표 텍스트를 준비합니다. 짧은 문장, 문단, 숫자, 이름과 실제 업무에서 어려운 사례를 넣습니다. 입력별 사본을 남깁니다.
- 출력 전체를 듣습니다. 누락, 발음, 부자연스러운 쉼, 반복 단어, 끝부분 존재를 확인합니다. 즉시 재생과 저장 파일을 모두 시험합니다.
- 자기 컴퓨터에서 경험을 측정합니다. 기기, 모델, 입력 길이, 쓸 만한 오디오가 나오기까지의 시간을 기록합니다. 같은 자료로 옵션을 비교합니다.
- 검토와 재생을 분리합니다. 앱이 말하거나 오디오를 배포하기 전에 민감하거나 중요한 문구를 사람이 확인하게 합니다.
큰 벤치마크가 필요한 과정은 아닙니다. 작은 팀이 좁게 정의한 작업에 로컬 음성이 충분한지, 다음으로 어느 제한을 조사할지 반복 가능한 방식으로 판단할 수 있습니다.
속도 주장에는 시험 조건이 따라야 한다
Ollama 발표에는 성능과 음성 품질 비교가 있습니다. 명시된 모델, 하드웨어, 평가 조건에서 업체가 보고한 결과입니다. 무엇을 살펴볼지 알려주는 단서이지, 다른 컴퓨터나 목소리·언어에서도 같은 지연 시간을 보장하는 것은 아닙니다.
처리량과 처음 들을 수 있는 출력까지의 시간을 나눠 보세요. 긴 문장을 전체적으로 빨리 생성해도 짧은 상호작용의 시작은 느리게 느껴질 수 있습니다. 오디오북 초안 일괄 생성과 대화 답변은 두 지표의 중요도가 다릅니다.
품질 지표에도 맥락이 필요합니다. 생성 음성을 다시 인식하는 방법은 명료성 문제를 찾는 데 도움이 될 수 있습니다. 하지만 오류율이 낮다고 속도감, 표현력, 이름의 자연스러운 발음을 모두 평가한 것은 아닙니다. 실제 제품이 말할 자료를 사람이 들어보는 일은 여전히 유용합니다.
이 글에서 독립적인 여러 기기 비교를 실행하지는 않았습니다. 따라서 기대할 것은 모든 호스팅·로컬 음성 시스템을 이긴 승자가 아니라 평가할 새 로컬 옵션입니다.
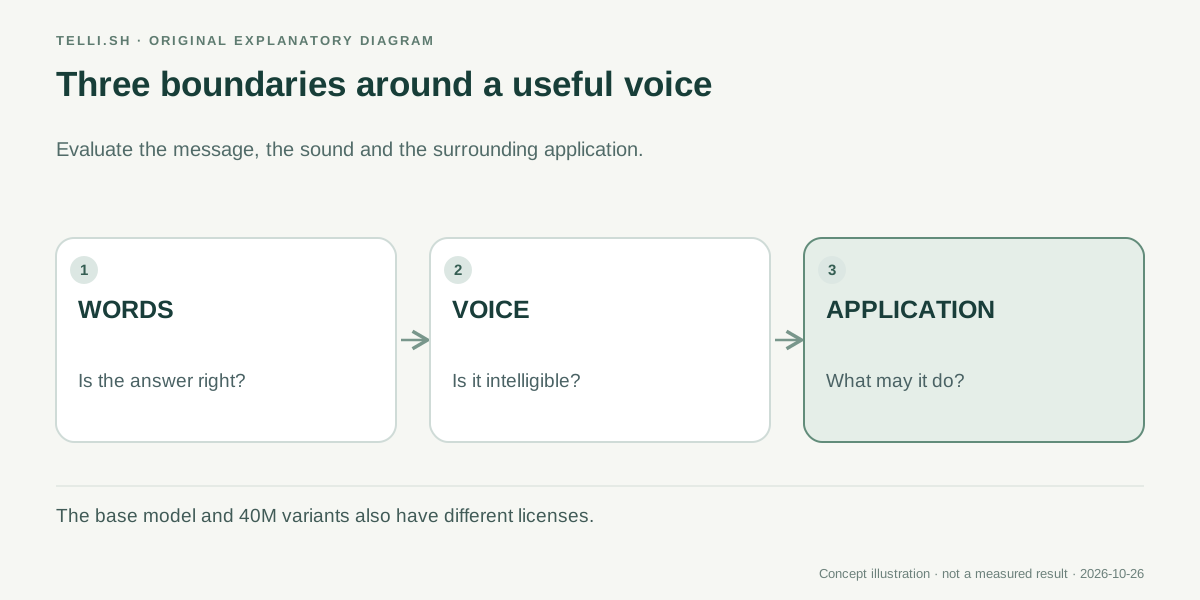 문구, 목소리, 앱을 각각 확인하세요. 명료한 목소리는 틀린 답도 맞는 답만큼 또렷하게 전달할 수 있습니다.
로컬 음성의 다음 변화는 연결의 일상화다
유망한 부분은 연결이 얼마나 평범해질 수 있는지입니다. 로컬 모델이 짧은 설명을 쓰고, 다른 모델이 읽고, 앱은 글을 화면에 남깁니다. 음성이 복사한 글을 보내는 별도 목적지보다 조합 가능한 출력 기능에 가까워집니다.
로컬 글 검토, 개인 청취용 초안, 작은 음성 인터페이스를 더 쉽게 시도할 수 있습니다. 입력 이해, 제한된 결정, 검토된 결과 발화를 각각 다른 전문 모델에 맡기는 앱도 늘어날 수 있습니다.
다음 시험 항목은 구체적입니다. 운영체제 지원이 넓어지면 시도할 사람이 늘어납니다. 언어가 늘면 대상 독자가 달라집니다. 취소, 목소리 처리, 통합이 좋아지면 대화형 앱이 더 자연스러워집니다. 서로 다른 개선이며 실제 제공될 때 평가해야 합니다.
현재 Ollama의 Phonon 지원은 유용한 첫걸음을 제공합니다. 로컬 AI가 짧고 확인 가능한 글을 읽게 한 다음, 그 작업이 듣기로 더 나아지는지 판단하세요. 목소리만큼 모델 라이선스와 플랫폼 제한도 분명하게 남겨두는 편이 좋습니다.
출처
- Ollama: 음성 모델, 2026년 10월 24일.
- Ollama: Phonon 모델 목록과 라이선스, 2026년 10월 26일 확인.
실험에 쓴 텍스트, 청취 노트, 모델 선택을 검색 가능한 기록으로 남기고 싶으신가요? 자료를 Telli.sh에 모아 다시 찾아볼 노트를 만들어 보세요.