La tua IA locale può parlare: che cosa apre davvero Phonon in Ollama
Ollama aggiunge la generazione vocale locale con Phonon di Gradium. Flussi di ascolto utili, l'attuale limite macOS e perché conta la licenza del modello più piccolo.
La risposta di un modello linguistico locale termina ancora spesso come testo nel terminale o nella chat. Puoi continuare a chiedere, ma devi continuare a guardare lo schermo. Leggerla ad alta voce richiede un'altra applicazione, un'altra API o un altro passaggio.
L'annuncio Ollama del 24 ottobre 2026 porta la generazione vocale nel flusso locale. La prima famiglia supportata è Phonon, sviluppata da Gradium. Il testo diventa audio dalla riga di comando o da un endpoint vocale compatibile con OpenAI, e la risposta del modello linguistico può passare direttamente al modello vocale. Annuncio ufficiale.
Per chi non lo ha usato, Ollama scarica ed esegue modelli sul proprio computer, esponendoli con un'API locale. La novità conta perché la voce diventa un'altra capacità in quell'ambiente. L'IA locale può rispondere parlando, con limiti importanti: il supporto annunciato è per macOS e le licenze cambiano nella famiglia Phonon.
 Marchio ufficiale dal repository Ollama, licenza MIT. Rasterizzato proporzionalmente su bianco. È un'immagine identificativa, non una schermata o voce generata.

Una voce utile parte da una promessa modesta
La capacità immediata è la sintesi da testo a voce. Fornisci parole e ricevi audio. Può rendere più facile ascoltare una risposta, trasformare un documento in una bozza privata da ascoltare o permettere un prototipo vocale senza un servizio remoto.
Da sola non crea un assistente completo. Ascoltare il microfono, rilevare la fine di una frase, riconoscere il parlato, interrompere l'audio e stabilire le azioni consentite sono parti separate dell'applicazione. Una voce fluida può far sembrare completo un sistema che non lo è.
La distinzione aiuta a scegliere cosa costruire per primo. Leggere un paragrafo approvato è un compito circoscritto. Ascoltare richieste, cercare materiale privato, scegliere strumenti e pronunciare risultati comporta molte più responsabilità. Phonon fornisce la voce in uscita; non stabilisce correttezza e autorità dei passaggi precedenti.
I primi usi migliori hanno quindi un confine testuale comprensibile. Puoi ispezionare le parole, valutarne l'adeguatezza e solo dopo generare l'audio. Questa semplicità aiuta a verificare se la voce migliori il compito reale.
Il lancio ha confini di piattaforma e lingua
Le istruzioni richiedono un Mac Apple Silicon con Ollama 0.40.11 o successivo, mentre Windows e Linux arriveranno più avanti. Chi usa un altro sistema non deve presumere che l'installazione corrente supporti già il flusso vocale annunciato. La visibilità della libreria sul web è diversa dalla disponibilità del runtime su ogni piattaforma.
La pagina Phonon della libreria distingue anche i modelli. Quello base è presentato per l'inglese. La famiglia 40M include varianti per inglese, francese, tedesco, spagnolo e portoghese, oltre a una variante multilingue per queste cinque lingue.
L'elenco non promette sintesi multilingue universale. Il coreano non è tra le cinque lingue, quindi il lancio non stabilisce un'opzione vocale coreana.
Un flusso di ascolto inglese e un prodotto multilingue richiedono prove diverse. Il primo può aver bisogno solo di leggere bene le note. Il secondo deve verificare lingue del modello preciso, nomi, pronuncia e comportamento nei cambi di lingua. Una semplice etichetta non dimostra che tutto funzioni bene.
Modello piccolo, permessi diversi
La famiglia ha una distinzione di licenza facile da perdere cercando per dimensione. Il modello base è indicato sotto Apache 2.0. Le varianti 40M sono indicate sotto CC BY-NC 4.0, con restrizione non commerciale. Modelli e licenze.
Il download minore non è automaticamente la scelta più semplice per un prodotto commerciale. Un modello compatto può aiutare su un computer modesto, ma i suoi permessi potrebbero non adattarsi a un servizio a pagamento o alla produzione del cliente.
| Opzione da esaminare | Che cosa cambia | Che cosa controllare prima dell'adozione |
|---|---|---|
| Phonon base | Voce inglese con indicazione Apache 2.0 | Modello esatto, avvisi ed eventuali risorse vocali aggiuntive |
| Variante 40M specifica | Modello compatto per una lingua elencata | Restrizioni non commerciali e pronuncia del tuo materiale |
| Variante 40M multilingue | Opzione compatta per le cinque lingue | Stessa restrizione e comportamento con lingue miste o alternate |
È una decisione pratica di prodotto, non l'idea che una licenza migliori la voce. Confronta separatamente qualità, costo di esecuzione e usi permessi. Registra la variante precisa anziché scrivere soltanto «Phonon» nelle note del rilascio.
La riga di comando rende visibile il nuovo percorso
Su un'installazione macOS supportata, l'annuncio mostra il comando diretto:
ollama run phonon "Hello from Ollama."
Mostra anche come passare alla voce l'uscita di un modello testuale:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
Sono esempi del flusso annunciato, non risultati di nostri test hardware. La parte interessante è la pipe: un modello produce le parole, l'altro la voce. Mantenere breve la risposta ed escludere il ragionamento nascosto dall'ingresso parlato rende il passaggio più comprensibile.
L'annuncio mostra anche il salvataggio in un file WAV:
ollama run phonon "Save this to a file." > speech.wav
Usa il comando documentato nell'ambiente supportato e verifica il file prima di costruire un processo in batch. L'esistenza del file non dice se tutte le frasi siano presenti, se l'inizio sia tagliato o se un numero importante sia pronunciato correttamente.
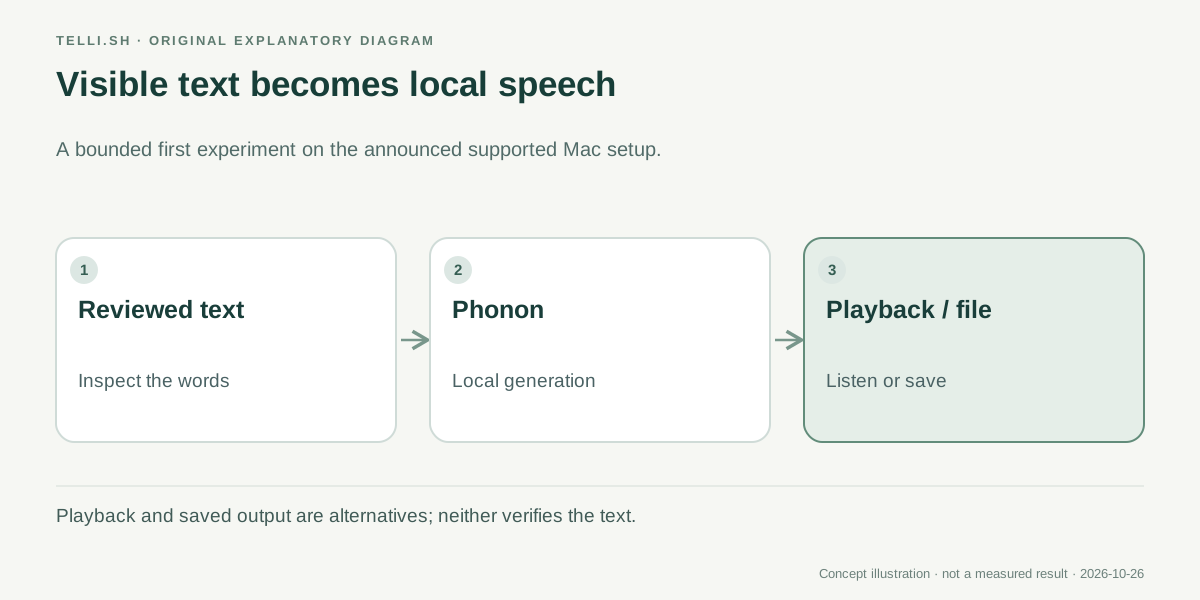 Il primo confine utile è il testo visibile. La voce cambia la consegna, non verifica indipendentemente la risposta.
Primo esempio: ascoltare un documento prima di inviarlo
Immagina un consulente che rivede un aggiornamento di progetto in inglese. Il documento spiega densamente modifiche, incertezze e approvazioni richieste al cliente. Sullo schermo sembra accettabile; all'ascolto può emergere una frase troppo lunga o un passaggio difficile.
Il modello locale trasforma il testo approvato in una bozza da ascoltare. Il consulente sente le parole effettive mentre modifica l'originale. Non serve che il modello inventi riepiloghi o scelga cosa sia importante.
Il vantaggio è specifico: un altro modo di rivedere la scrittura. Può aiutare chi preferisce ascoltare o alternare modalità visiva e sonora. Non dimostra una soluzione completa di accessibilità, e la voce generata non sostituisce le verifiche per i bisogni specifici del pubblico.
Anche la privacy è più facile da delimitare. Se la generazione resta davvero locale, quel passaggio non deve inviare il documento a un fornitore remoto. Il flusso può comunque includere editor cloud, modelli remoti, telemetria o cartelle condivise. «Voce locale» descrive un confine, non tutte le applicazioni circostanti.
Secondo esempio: una risposta parlata con trascrizione visibile
Considera un piccolo prototipo per le lingue o un chiosco informativo. L'applicazione genera una risposta breve, mostra le parole e offre un pulsante per ascoltare. L'utente confronta testo e suono, mentre lo sviluppatore indaga senza indovinare l'ingresso del modello vocale.
È pertinente l'endpoint locale /v1/audio/speech, compatibile con OpenAI. L'annuncio lo propone per integrare la generazione nelle applicazioni. La compatibilità può ridurre il lavoro per software già basati su un'API vocale, ma non dimostra che ogni opzione remota abbia una realizzazione locale identica.
Parti da modello, voce e risposta documentati. Se servono uno streaming preciso, una cancellazione o una codifica, prova quel contratto esatto. Una richiesta di una riga riuscita non stabilisce il comportamento di una lunga sessione interattiva.
Nell'esempio linguistico, inizia con una lingua supportata e poche frasi riviste. Prova a parte nomi e parole insolite. Con testo libero, decidi come trattare scritture non supportate, ingressi molto lunghi e contenuti da non pronunciare in uno spazio condiviso.
Come rendere informativa la prima prova
Un esperimento serve se risponde a una domanda su cui agire. «Produce suono?» verifica l'installazione, ma è un debole criterio di adozione. La scrittura richiede paragrafi comprensibili; un prototipo interattivo anche attesa accettabile e arresto affidabile.
- Conferma piattaforma e runtime. Consulta la documentazione attuale. Il lancio richiede Apple Silicon e Ollama 0.40.11 o successivo. Le piattaforme annunciate per dopo restano future.
- Scegli il modello e la licenza esatti. Registra tag, lingua e uso prima di confrontare dimensione e velocità.
- Prepara testi rappresentativi. Includi frase, paragrafo, numeri, nomi e un caso difficile del flusso reale. Conserva ogni ingresso.
- Ascolta tutto. Controlla omissioni, pronuncia, pause, ripetizioni e finale. Prova file e ascolto immediato.
- Misura sul tuo computer. Registra macchina, modello, lunghezza e attesa fino all'audio utile. Confronta lo stesso materiale.
- Separa revisione e riproduzione. Una persona controlla parole sensibili o rilevanti prima che vengano pronunciate o distribuite.
Non serve un grande benchmark. È un metodo ripetibile per decidere se la voce locale basti a un compito circoscritto e quale limite investigare dopo.
Le promesse di velocità richiedono le condizioni di test
Ollama pubblica confronti di prestazioni e qualità. Sono risultati del fornitore con modelli, hardware e condizioni specifici. Indicano cosa provare, non garantiscono la stessa latenza su un altro computer, con un'altra voce o lingua.
Separa velocità complessiva di generazione e tempo al primo audio udibile. Un modello può produrre velocemente un brano lungo ma far percepire lenta una breve interazione. Un audiolibro in batch e una risposta conversazionale pesano diversamente le misure.
Anche la qualità richiede contesto. Riconoscere parole nell'audio può rilevare problemi di intelligibilità, ma un basso errore non giudica interamente ritmo, espressività o adeguatezza di un nome al pubblico. L'ascolto umano rimane utile sul materiale reale.
Non abbiamo svolto un confronto indipendente tra macchine per questo articolo. L'aspettativa pratica è una nuova opzione locale da valutare, non un vincitore universale sui sistemi locali o remoti.
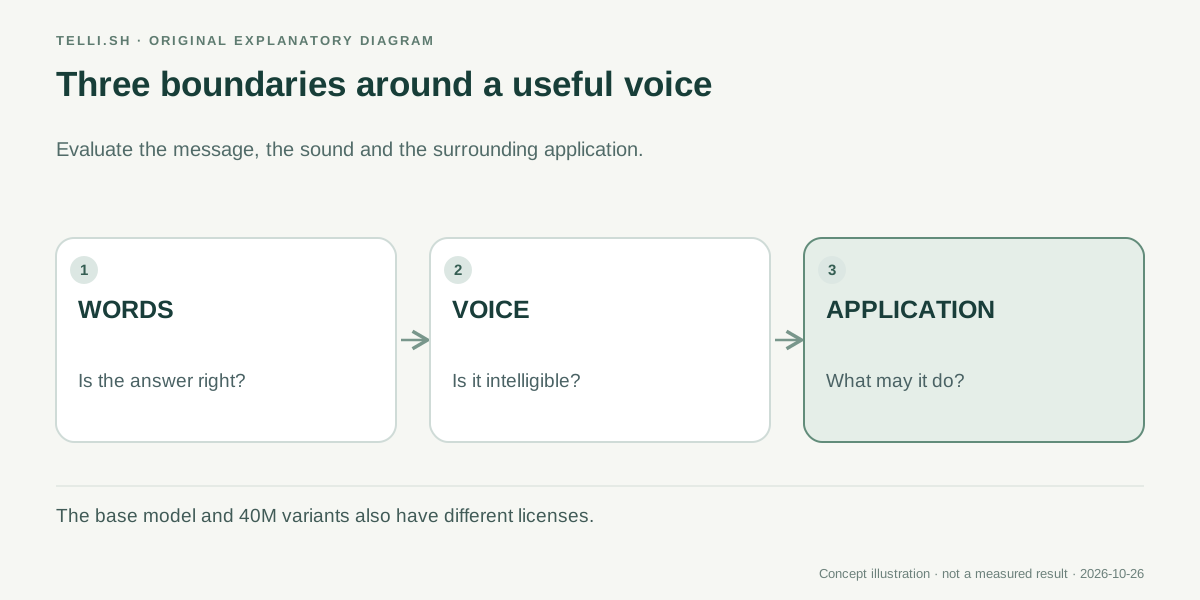 Controlla separatamente parole, voce e applicazione. Una voce chiara pronuncia una risposta errata chiaramente quanto una corretta.
Che cosa potrebbe cambiare la voce locale
La promessa è quanto ordinaria possa diventare la connessione. Un modello locale scrive una breve spiegazione, un altro la legge e l'applicazione conserva il testo. La voce sembra una capacità di uscita componibile, non un altro posto dove copiare parole.
Può facilitare revisione locale, bozze private da ascoltare e piccole interfacce vocali. Può incoraggiare più modelli specializzati: uno comprende l'ingresso, uno decide in un ambito definito e uno pronuncia il risultato rivisto.
Le prossime prove sono concrete. Più sistemi operativi ampliano i possibili utenti; più lingue cambiano il pubblico. Migliori cancellazione, gestione delle voci e integrazione cambiano la naturalezza dell'interazione. Ogni miglioramento va giudicato quando disponibile.
Per ora, Phonon offre un primo passo utile: fai leggere un testo breve e ispezionabile e decidi se l'ascolto migliori il compito. Mantieni licenza e piattaforme visibili quanto la voce.
Fonti
- Ollama: Modelli vocali, 24 ottobre 2026.
- Ollama: Libreria Phonon e licenze, consultate il 26 ottobre 2026.
Vuoi un archivio ricercabile di testi, note di ascolto e modelli provati? Porta il materiale in Telli.sh e crea una nota da ritrovare.