Votre IA locale peut parler : ce que Phonon ouvre réellement dans Ollama
Ollama ajoute la synthèse vocale locale avec les modèles Phonon de Gradium. Parcours d'écoute utiles, limite actuelle à macOS et importance de la licence du plus petit modèle.
La réponse d'un modèle de langage local finit encore généralement sous forme de texte dans un terminal ou une fenêtre de chat. On peut continuer à poser des questions, mais il faut continuer à regarder l'écran. Lire la réponse à voix haute ajoute une application, une API ou une étape.
L'annonce d'Ollama du 24 octobre 2026 introduit la synthèse vocale dans ce parcours local. La première famille vocale prise en charge est Phonon, développée par Gradium. Le texte devient de l'audio en ligne de commande ou par un point d'accès vocal compatible avec OpenAI ; la réponse d'un modèle de langage peut être transmise directement au modèle vocal. Annonce officielle.
Pour les lecteurs qui ne l'ont pas utilisé, Ollama permet de télécharger et d'exécuter des modèles sur son propre ordinateur, puis de les exposer par une API locale. La mise à jour compte parce que la parole devient une capacité supplémentaire dans cet environnement. L'IA locale peut ainsi répondre oralement, avec des limites importantes : la prise en charge annoncée concerne actuellement macOS, et les licences diffèrent au sein de la famille Phonon.
 Marque officielle Ollama, issue du dépôt Ollama, sous licence MIT. Convertie en image matricielle proportionnellement sur fond blanc. Il s'agit d'une image d'identification du produit, pas d'une capture ni de parole générée.

Une voix utile commence par une promesse modeste
La capacité immédiate est la synthèse vocale : on fournit des mots et l'on reçoit de l'audio synthétisé. Cela peut faciliter l'écoute d'une réponse générée, transformer un document en brouillon audio privé ou permettre de prototyper une interface parlante sans commencer par un service vocal hébergé.
Cela ne crée pas, à soi seul, un assistant vocal complet. Écouter un microphone, décider quand quelqu'un a fini de parler, reconnaître la parole, interrompre la lecture et déterminer les actions permises sont des parties distinctes de l'application. Une voix fluide peut donner à un système inachevé une impression de maturité excessive.
La distinction aide à choisir quoi construire d'abord. Lire un paragraphe approuvé est une tâche délimitée. Un système qui entend une demande, cherche dans des données privées, choisit un outil et prononce son résultat a des responsabilités bien plus larges. Phonon peut fournir sa voix de sortie ; il n'établit ni l'exactitude ni l'autorité des étapes précédentes.
Les meilleurs premiers usages ont donc une frontière textuelle compréhensible. On peut examiner ce qui sera dit, juger si la formulation convient puis générer l'audio. Cet agencement simple aide à déterminer si la voix améliore une tâche réelle.
Le lancement a des limites de plateforme et de langue
Les instructions de lancement exigent un Mac Apple Silicon avec Ollama 0.40.11 ou ultérieur ; la prise en charge de Windows et Linux est annoncée pour plus tard. Utiliser déjà Ollama sur un autre système ne signifie pas que l'installation prend en charge ce nouveau parcours vocal. Voir la bibliothèque de modèles sur le web est un fait différent de la disponibilité de la fonction sur toutes les plateformes.
La fiche Phonon de la bibliothèque distingue aussi les modèles. Le modèle Phonon de base est présenté pour l'anglais. La famille 40M comprend des variantes pour l'anglais, le français, l'allemand, l'espagnol et le portugais, ainsi qu'une variante multilingue couvrant ces cinq langues.
Cette liste n'affirme pas une couverture multilingue universelle. Le coréen n'y figure pas : ce lancement n'établit donc pas une option de synthèse vocale en coréen.
Un parcours d'écoute en anglais et un produit multilingue demandent des évaluations différentes. Le premier peut seulement exiger une voix lisant clairement vos notes anglaises. Le second doit vérifier les langues du modèle exact, les noms, la prononciation et le comportement quand une phrase change de langue. Une étiquette linguistique ne prouve pas que tous ces cas fonctionnent bien.
Petit modèle, permissions différentes
Une distinction de licence passe facilement inaperçue lorsqu'on parcourt les modèles par taille. Phonon de base est présenté sous Apache 2.0. Les variantes 40M sont sous CC BY-NC 4.0, avec une restriction aux usages non commerciaux. Informations sur les modèles et licences.
Le plus petit téléchargement n'est donc pas automatiquement le choix le plus simple pour un produit commercial. Un modèle compact peut séduire pour des essais sur une machine modeste, tandis que les permissions de ce modèle précis peuvent ne pas convenir à un service payant ou à une application de production d'un client.
| Choix à examiner | Ce qui change | Vérifications avant adoption |
|---|---|---|
| Phonon de base | Option vocale anglaise annoncée sous Apache 2.0 | Modèle exact téléchargé, mentions et éventuelles ressources vocales supplémentaires |
| Variante 40M pour une langue | Modèle compact pour l'une des langues indiquées | Restriction non commerciale et prononciation de votre contenu |
| Variante 40M multilingue | Option compacte unique pour les cinq langues indiquées | Même restriction de licence, plus alternance et mélange des langues |
C'est une décision produit pratique, pas un argument selon lequel une licence améliorerait la voix. Comparez séparément qualité, coût d'exécution et usages autorisés. Gardez la trace de la variante exacte testée plutôt que d'écrire simplement « Phonon » dans une note de déploiement.
La ligne de commande rend le nouveau chemin visible
Sur une installation macOS compatible, l'annonce officielle montre une commande directe :
ollama run phonon "Hello from Ollama."
Elle montre aussi comment transmettre la sortie d'un modèle textuel à la synthèse vocale :
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
Ce sont des exemples du parcours annoncé, pas les résultats d'un test sur notre matériel. Le tube est la partie intéressante : un modèle produit les mots, un autre la voix. Garder une réponse courte et exclure le raisonnement caché du texte à prononcer rend la transmission plus compréhensible.
L'annonce montre également comment enregistrer la parole générée dans un fichier WAV :
ollama run phonon "Save this to a file." > speech.wav
Utilisez la commande documentée dans l'environnement pris en charge et vérifiez le fichier avant d'en faire un traitement par lots. L'existence d'un fichier audio ne dit pas si toutes les phrases ont été prononcées, si le début a été tronqué ou si un nombre important a été correctement lu.
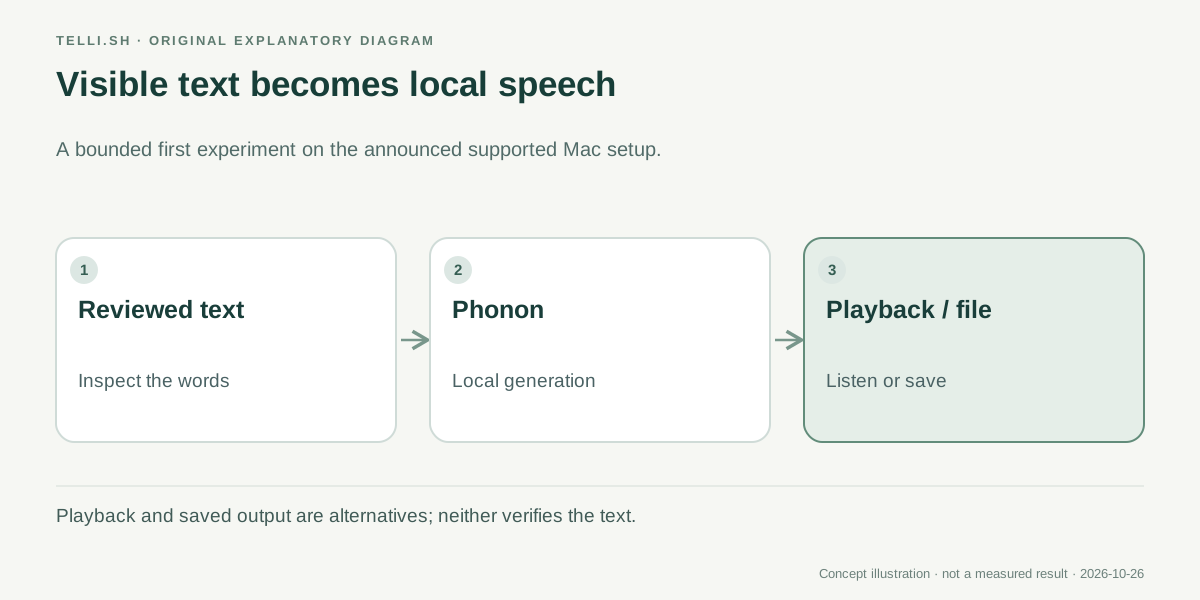 La première frontière utile est le texte visible. La voix change la façon de délivrer la réponse ; elle ne la vérifie pas de manière indépendante.
Premier exemple : écouter un document avant de l'envoyer
Imaginons un consultant qui relit un point projet en anglais. Le document explique de façon dense ce qui a changé, les incertitudes et ce que le client doit approuver. Il paraît acceptable à l'écran, mais l'écoute peut révéler une phrase trop longue ou une transition difficile à suivre.
Un modèle vocal local peut transformer ce texte validé en brouillon d'écoute. Le consultant entend les formulations réelles en modifiant le document d'origine. Le modèle vocal n'a pas besoin d'inventer un résumé ou de décider quelles affirmations comptent.
Le bénéfice est précis : une manière supplémentaire de relire un texte. Cela peut aussi aider une personne qui préfère écouter ou souhaite alterner travail visuel et audio. Ce n'est pas la preuve d'une solution complète d'accessibilité ; une voix générée ne doit pas remplacer les vérifications qu'exigent les besoins particuliers d'un public.
Cet exemple facilite aussi le raisonnement sur la confidentialité. Si la génération reste réellement dans le processus local, cette étape n'a pas à envoyer le document à un fournisseur vocal hébergé. Le parcours complet peut néanmoins comprendre un éditeur cloud, un modèle distant, de la télémétrie ou un dossier partagé. « Voix locale » décrit une frontière de traitement, pas toutes les applications environnantes.
Deuxième exemple : prototyper une réponse parlée avec transcription visible
Prenons un développeur qui réalise un petit prototype d'apprentissage linguistique ou de borne d'information. L'application génère une réponse courte, affiche les mots et propose un bouton pour les écouter. L'utilisateur peut comparer le visible et l'audible ; le développeur peut examiner les échecs sans deviner le texte reçu par le modèle vocal.
Le point d'accès /v1/audio/speech d'Ollama, compatible avec OpenAI et servi par l'environnement local, est pertinent ici. L'annonce le présente comme un moyen d'intégrer la génération vocale aux applications. La compatibilité peut réduire l'intégration pour un logiciel déjà organisé autour d'une API vocale, mais elle ne prouve pas que chaque option d'un fournisseur distant possède une implémentation locale identique.
Commencez par le modèle, la voix et le comportement de réponse documentés. Si l'application attend un format de flux, un mécanisme d'annulation ou un encodage audio précis, testez ce contrat exact. Une requête d'une ligne réussie ne garantit pas le bon fonctionnement d'une longue session interactive.
Pour l'exemple linguistique, commencez par une langue prise en charge et un petit ensemble de phrases vérifiées. Testez séparément noms et mots inhabituels. Si la saisie est libre, décidez aussi comment traiter les écritures non prises en charge, les entrées très longues et le contenu qui ne devrait jamais être prononcé dans un espace partagé.
Comment rendre le premier essai instructif
Une expérience est utile lorsqu'elle répond à une question sur laquelle on peut agir. « Est-ce que cela produit du son ? » est un bon contrôle d'installation, mais un faible critère d'adoption. Un outil d'écriture demande des paragraphes intelligibles ; un prototype interactif demande aussi une attente acceptable et un arrêt fiable.
- Confirmez la plateforme et l'environnement. Consultez la documentation vocale actuelle d'Ollama. Les instructions de lancement précisent un Mac Apple Silicon et Ollama 0.40.11 ou ultérieur. Traitez les plateformes futures comme une disponibilité future.
- Choisissez le modèle exact et examinez sa licence. Notez le tag, la langue et l'usage prévu avant de comparer taille et vitesse.
- Préparez un texte représentatif. Incluez une phrase courte, un paragraphe, des nombres, des noms et un cas difficile de votre vrai parcours. Conservez chaque entrée.
- Écoutez le résultat en entier. Vérifiez omissions, prononciation, pauses artificielles, répétitions et présence de la fin. Testez le fichier enregistré autant que la lecture immédiate.
- Mesurez l'expérience sur votre ordinateur. Notez machine, modèle, longueur d'entrée et délai avant un audio utile. Comparez les options sur le même contenu.
- Séparez vérification et lecture. Laissez une personne examiner les formulations sensibles ou lourdes de conséquences avant que l'application les prononce ou distribue un fichier.
Ce processus n'exige pas un vaste benchmark. Il donne à une petite équipe une manière répétable de juger si la synthèse locale suffit pour une tâche précise et quelle limite mérite l'enquête suivante.
Les promesses de vitesse demandent leurs conditions de test
L'annonce d'Ollama comprend des comparaisons de performance et de qualité vocale. Ce sont des résultats rapportés par le fournisseur selon les modèles, matériels et conditions indiqués. Ils donnent des pistes à examiner, pas une promesse de latence identique sur un autre ordinateur, avec une autre voix ou une autre langue.
Séparez le débit du délai avant le premier son audible. Un modèle peut produire rapidement un long passage au total, tout en donnant une impression de lenteur au début d'une interaction courte. Un brouillon de livre audio par lots et une réponse conversationnelle n'accordent pas la même importance aux deux mesures.
Les mesures de qualité ont aussi besoin de contexte. La reconnaissance de mots dans la parole générée peut révéler des problèmes d'intelligibilité, mais un faible taux d'erreur ne juge pas entièrement le rythme, l'expressivité ou l'adéquation de la prononciation d'un nom au public. L'écoute humaine reste utile pour les contenus réellement prononcés par votre produit.
Nous n'avons pas mené de comparaison indépendante entre machines pour cet article. L'attente pratique est donc une nouvelle option locale à évaluer, plutôt qu'un vainqueur déclaré sur tous les systèmes vocaux locaux ou hébergés.
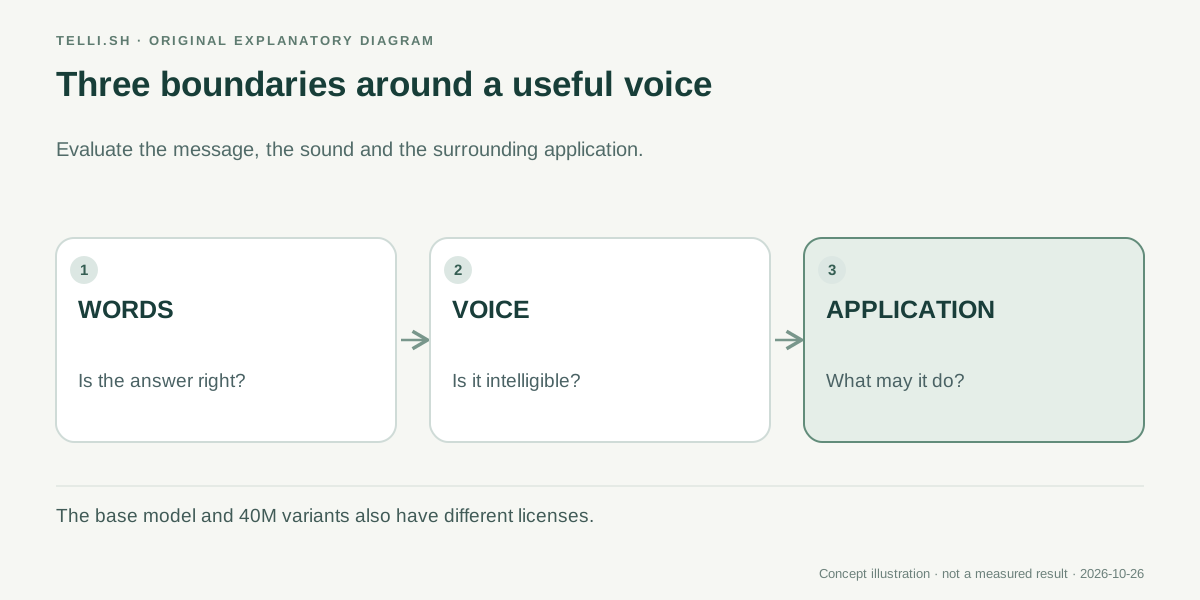 Vérifiez séparément les mots, la voix et l'application. Une voix claire peut livrer une mauvaise réponse aussi clairement qu'une bonne.
Ce que la voix locale pourrait changer ensuite
La partie prometteuse de cette mise à jour est la simplicité que peut prendre la connexion. Un modèle local écrit une courte explication, un autre la lit, et l'application conserve une transcription visible. La voix devient une capacité de sortie composable plutôt qu'une destination séparée où copier du texte.
Cela pourrait faciliter la relecture locale, les brouillons d'écoute privés et les petites interfaces parlantes. Cela pourrait aussi encourager des applications associant plusieurs modèles spécialisés : un pour comprendre l'entrée, un pour une décision délimitée et un pour prononcer le résultat vérifié.
Les prochains tests sont concrets. Davantage de systèmes d'exploitation élargirait le public capable d'essayer le parcours. Davantage de langues changerait les publics servis. De meilleurs mécanismes d'annulation, de gestion des voix et d'intégration rendraient l'interaction plus naturelle. Ce sont des progrès différents, à juger lorsqu'ils sont réellement disponibles.
Pour l'instant, Phonon dans Ollama offre une première étape utile : faire prononcer à l'IA locale un texte court et vérifiable, puis décider si l'écoute améliore cette tâche précise. Gardez la licence et les limites de plateforme aussi visibles que la voix.
Sources
- Ollama : Speech models, 24 octobre 2026.
- Ollama : bibliothèque Phonon et licences, consultée le 26 octobre 2026.
Vous souhaitez garder une trace interrogeable des textes, notes d'écoute et choix de modèles d'une expérience ? Rassemblez les éléments dans Telli.sh pour créer une note que vous pourrez retrouver.