Tu IA local ya puede hablar: qué abre la actualización Phonon de Ollama
Ollama incorpora generación local de voz con los modelos Phonon de Gradium. Casos útiles de escucha, el límite actual de macOS y por qué importa la licencia del modelo más pequeño.
La respuesta de un modelo de lenguaje local suele terminar como texto en una terminal o ventana de chat. Puedes seguir preguntando, pero tienes que seguir mirando la pantalla. Leerla en voz alta añade otra aplicación, otra API o un paso más.
El anuncio de Ollama del 24 de octubre de 2026 incorpora la generación de voz a ese proceso local. La primera familia compatible es Phonon, desarrollada por Gradium. El texto puede convertirse en audio mediante la línea de comandos o un endpoint de voz compatible con OpenAI, y la respuesta de un modelo de lenguaje puede pasar directamente al modelo de voz. Anuncio oficial.
Para quien no lo haya utilizado, Ollama permite descargar y ejecutar modelos en tu propio ordenador y exponerlos mediante una API local. La actualización importa porque la voz se convierte en otra capacidad de los modelos de ese entorno. Permite que la IA local responda hablando, con límites importantes: el soporte anunciado es actualmente para macOS y las licencias varían dentro de la familia Phonon.
 Marca oficial de Ollama, procedente del repositorio de Ollama, licencia MIT. Rasterizada proporcionalmente sobre blanco. Identifica el producto; no es una captura ni voz generada.

Una voz útil empieza con una promesa modesta
La capacidad inmediata es convertir texto en voz. Proporcionas palabras y recibes audio sintetizado. Puede facilitar escuchar una respuesta, convertir un documento en una versión privada de escucha o permitir a un desarrollador prototipar una interfaz hablada sin empezar por un servicio alojado.
Esto no crea por sí solo un asistente de voz completo. Escuchar un micrófono, detectar cuándo alguien termina de hablar, reconocer la voz, interrumpir la reproducción y decidir qué acciones están permitidas son partes distintas de una aplicación. Una voz fluida puede hacer que un sistema incompleto parezca más terminado de lo que está.
La distinción ayuda a decidir qué construir primero. Leer un párrafo aprobado es una tarea acotada. Un sistema que escucha, busca material privado, elige una herramienta y pronuncia el resultado tiene muchas más responsabilidades. Phonon puede aportar la voz de salida; no establece la precisión ni la autoridad de los pasos anteriores.
Por eso los primeros usos más sólidos tienen un límite textual comprensible. Puedes inspeccionar lo que se va a pronunciar, decidir si la redacción es adecuada y generar después el audio. Esa estructura sencilla permite comprobar si la voz mejora una tarea real.
El lanzamiento tiene límites de plataforma e idioma
Las instrucciones del lanzamiento requieren un Mac con Apple Silicon y Ollama 0.40.11 o posterior; el soporte para Windows y Linux llegará más adelante. Quien utilice Ollama en otro sistema no debe asumir que su instalación actual ya admite el proceso anunciado. Que la biblioteca del modelo sea visible en la web no significa que la función esté disponible en todas las plataformas.
La entrada de Phonon en la biblioteca también distingue opciones. El modelo base se presenta para inglés. La familia 40M incluye variantes específicas de inglés, francés, alemán, español y portugués, además de una variante multilingüe para esos cinco idiomas.
La lista no promete voz multilingüe universal. El coreano no está entre los cinco idiomas indicados, por lo que este lanzamiento no establece una opción de voz en coreano.
Un proceso para escuchar inglés y un producto multilingüe necesitan evaluaciones diferentes. El primero quizá solo necesite leer con claridad tus notas en inglés. El segundo debe comprobar los idiomas del modelo concreto, los nombres, la pronunciación y su comportamiento cuando una frase cambia de idioma. La etiqueta del idioma no demuestra que todos esos casos funcionen bien.
Un modelo pequeño puede tener permisos diferentes
La familia tiene una distinción de licencias fácil de pasar por alto al comparar tamaños. Phonon base figura bajo Apache 2.0. Las variantes 40M figuran bajo CC BY-NC 4.0, que incluye una restricción de uso no comercial. Información de modelos y licencias.
La descarga más pequeña no es automáticamente la opción más sencilla para un producto comercial. Un modelo compacto puede resultar atractivo para experimentar en un equipo modesto, mientras que sus permisos pueden no encajar con un servicio de pago o una aplicación de producción de un cliente.
| Opción que examinar | Qué cambia | Qué comprobar antes de adoptarla |
|---|---|---|
| Phonon base | Voz en inglés con licencia indicada Apache 2.0 | Modelo exacto descargado, avisos y recursos adicionales de voces |
| Variante 40M de un idioma | Modelo compacto para un idioma de la lista | Restricciones no comerciales y pronunciación de tu material |
| Variante 40M multilingüe | Una opción compacta para los cinco idiomas | La misma restricción y el comportamiento al alternar o mezclar idiomas |
Es una decisión práctica de producto, no un argumento de que una licencia mejore la voz. Compara por separado calidad, coste de ejecución y uso permitido. Registra la variante exacta probada en lugar de escribir solo «Phonon» en una nota de despliegue.
La línea de comandos permite ver fácilmente el nuevo recorrido
En una instalación compatible de macOS, el anuncio muestra un comando directo:
ollama run phonon "Hello from Ollama."
También demuestra cómo pasar la salida de un modelo de texto a voz:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
Son ejemplos del proceso anunciado, no resultados de una prueba en nuestro equipo. Lo interesante es la tubería: un modelo produce las palabras y otro la voz. Mantener breve la respuesta y excluir el razonamiento oculto de la entrada hablada facilita entender el traspaso.
El anuncio también muestra cómo guardar la voz generada en un archivo WAV:
ollama run phonon "Save this to a file." > speech.wav
Utiliza el comando documentado en el entorno compatible y comprueba el archivo antes de construir un procesamiento por lotes. Que exista un archivo de audio no indica si se pronunciaron todas las frases, si se cortó el principio o si un número importante se dijo correctamente.
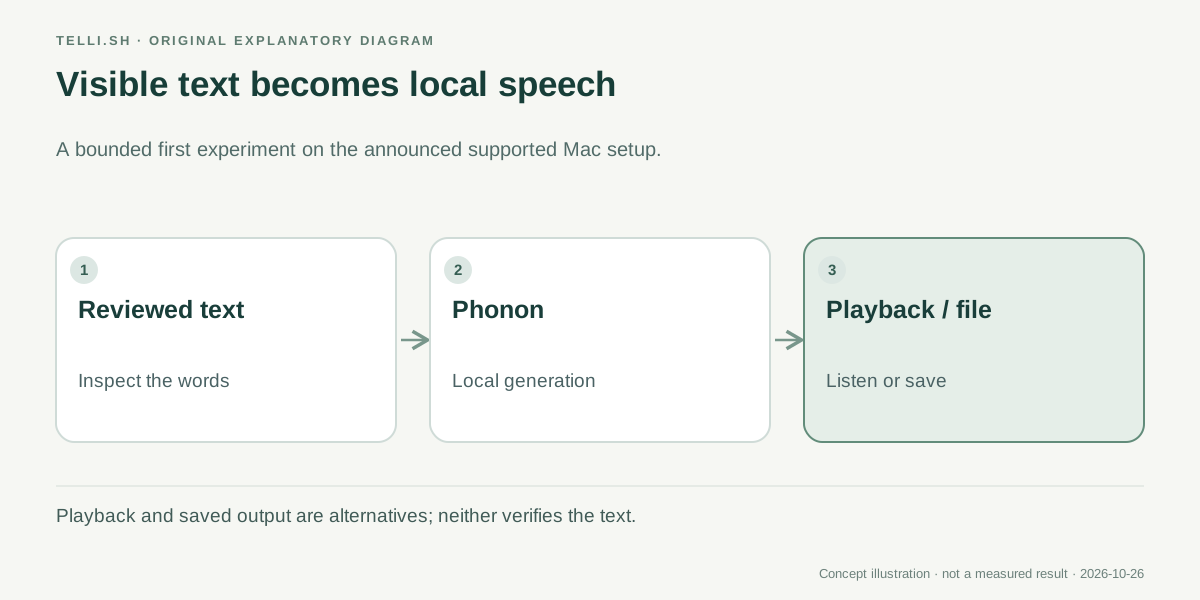 El primer límite útil es el texto visible. La voz cambia la entrega de la respuesta; no verifica su contenido de forma independiente.
Primer ejemplo: escucha un documento antes de enviarlo
Imagina a un consultor revisando una actualización de proyecto en inglés. El documento explica de forma densa qué cambió, qué sigue siendo incierto y qué necesita aprobar el cliente. En pantalla se lee aceptablemente, pero escucharlo puede revelar una frase demasiado larga o una transición difícil de seguir.
Un modelo local puede convertir ese texto aprobado en una versión de escucha. El consultor oye la redacción real mientras modifica el original. No hace falta que el modelo de voz invente un resumen ni decida qué afirmaciones importan.
El beneficio es concreto: otra forma de revisar un escrito. También puede ayudar a quien prefiere escuchar o alternar trabajo visual y sonoro. No demuestra que el modelo sea una solución completa de accesibilidad; una voz generada no debe sustituir las comprobaciones que requieren las necesidades particulares del público.
Este ejemplo también aclara la privacidad. Si la generación se mantiene realmente en el proceso local, ese paso no necesita enviar el documento a un proveedor de voz alojado. El proceso completo aún puede incluir un editor en la nube, un modelo remoto, telemetría o una carpeta compartida. «Voz local» describe un límite de procesamiento, no todas las aplicaciones de alrededor.
Segundo ejemplo: prototipa una respuesta hablada con transcripción visible
Pensemos en un desarrollador que crea un pequeño prototipo para aprender idiomas o un quiosco informativo. La aplicación genera una respuesta breve, muestra las palabras y ofrece un botón para escucharlas. El usuario compara lo que ve con lo que oye y el desarrollador inspecciona los fallos sin adivinar qué texto entró en el modelo.
Aquí resulta relevante el endpoint /v1/audio/speech, compatible con OpenAI y servido por el entorno local de Ollama. El anuncio lo presenta como una forma de integrar la voz en aplicaciones. La compatibilidad puede reducir trabajo de integración en software ya organizado alrededor de una API de voz, pero no demuestra que todas las opciones de proveedores remotos tengan una implementación local idéntica.
Empieza con el modelo, la voz y el comportamiento de respuesta documentados. Si la aplicación espera un formato concreto de transmisión, cancelación o codificación de audio, prueba ese contrato exacto. Una solicitud de una línea que funciona no demuestra que una sesión interactiva larga vaya a comportarse correctamente.
Para aprender idiomas, comienza con uno compatible y unas pocas frases revisadas. Prueba nombres y palabras desconocidas por separado. Si el usuario puede introducir cualquier texto, decide también cómo gestionar escrituras no compatibles, entradas muy largas y material que nunca debería pronunciarse en un espacio compartido.
Cómo conseguir que la primera prueba aporte información
Un experimento sirve más cuando responde una pregunta sobre la que puedes actuar. «¿Produce sonido?» comprueba la instalación, pero es un criterio débil de adopción. Una herramienta de escritura necesita párrafos inteligibles; un prototipo interactivo también necesita esperas aceptables y una detención fiable.
- Confirma plataforma y entorno. Consulta la documentación actual de voz de Ollama. El lanzamiento especifica Mac con Apple Silicon y Ollama 0.40.11 o posterior. Considera futuras las plataformas anunciadas para más adelante.
- Elige el modelo exacto e inspecciona su licencia. Registra etiqueta, idioma y uso previsto antes de comparar tamaño o velocidad.
- Prepara texto representativo. Incluye una frase breve, un párrafo, números, nombres y un caso difícil de tu proceso real. Conserva cada entrada.
- Escucha el resultado completo. Comprueba omisiones, pronunciación, pausas poco naturales, repeticiones y que aparezca el final. Prueba el archivo guardado y la reproducción inmediata.
- Mide la experiencia en tu ordenador. Registra equipo, modelo, longitud y tiempo hasta obtener audio útil. Compara el mismo material entre opciones.
- Separa revisión y reproducción. Deja que una persona inspeccione textos sensibles o con consecuencias antes de pronunciarlos o distribuir un archivo.
No hace falta una gran batería de pruebas. Esto proporciona a un equipo pequeño una forma repetible de decidir si la voz local basta para una tarea acotada y qué limitación conviene investigar después.
Las cifras de velocidad necesitan sus condiciones de prueba
El anuncio de Ollama incluye comparaciones de rendimiento y calidad de voz. Son resultados comunicados por el proveedor bajo modelos, equipos y condiciones de evaluación concretos. Orientan qué investigar; no prometen la misma latencia en otro ordenador o con otra voz e idioma.
Separa rendimiento de generación de tiempo hasta el primer audio audible. Un modelo puede producir rápido un pasaje largo y, aun así, hacer que una interacción breve parezca lenta al principio. Un borrador de audiolibro por lotes y una respuesta conversacional valoran esas medidas de manera diferente.
La calidad también necesita contexto. Reconocer palabras en la voz generada puede detectar problemas de inteligibilidad, pero una tasa baja de error no juzga por completo el ritmo, la expresividad o si un nombre suena apropiado al público. La escucha humana sigue siendo útil con el material real del producto.
No hemos hecho una comparación independiente entre ordenadores para este artículo. La expectativa práctica es una nueva opción local que evaluar, no un ganador declarado sobre todos los sistemas locales o alojados.
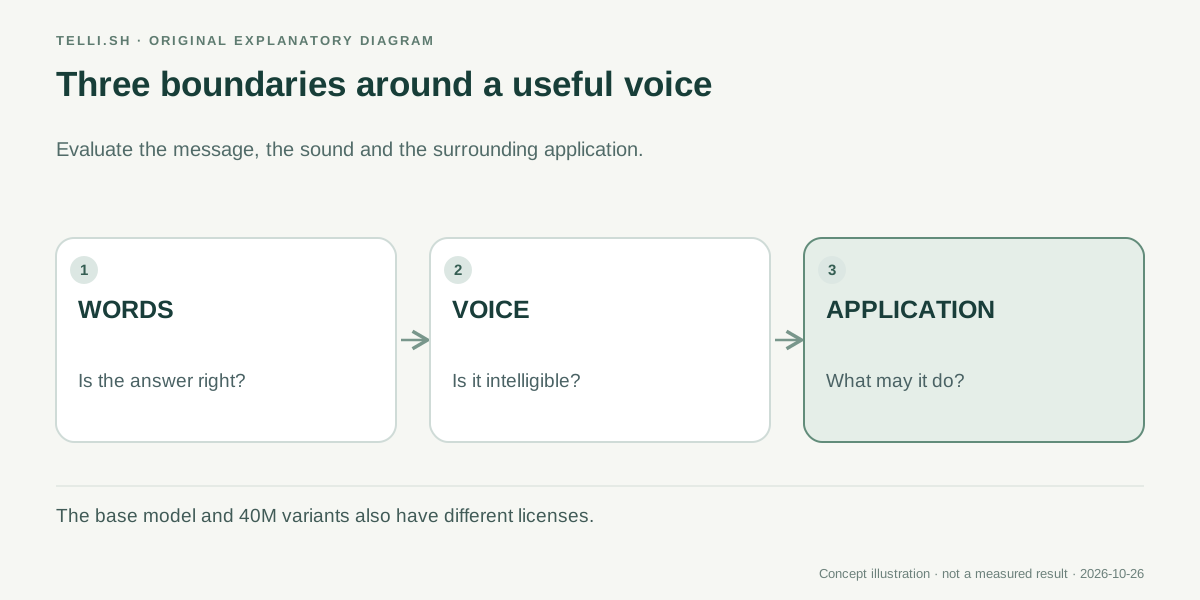 Comprueba las palabras, la voz y la aplicación por separado. Una voz clara puede transmitir una respuesta incorrecta con la misma claridad que una correcta.
Qué podría cambiar después la voz local
Lo prometedor es lo habitual que puede volverse esta conexión. Un modelo local escribe una explicación breve, otro la lee y la aplicación conserva la transcripción visible. La voz empieza a parecer una capacidad de salida combinable, en lugar de otro destino al que copiar texto.
Esto podría facilitar explorar la revisión local de escritos, versiones privadas de escucha e interfaces habladas pequeñas. También puede animar a combinar modelos especializados: uno para comprender la entrada, otro para una decisión acotada y otro para pronunciar el resultado revisado.
Las próximas pruebas son concretas. Más sistemas operativos ampliarían quién puede probarlo. Más idiomas cambiarían a qué públicos llega. Mejor cancelación, gestión de voces e integración modificarían la naturalidad de una aplicación interactiva. Cada mejora es distinta y debe juzgarse cuando esté disponible.
Por ahora, Phonon en Ollama ofrece un primer paso útil: deja que la IA local pronuncie un texto breve e inspeccionable y decide si escuchar mejora esa tarea. Mantén tan visibles la licencia y los límites de plataforma como su voz.
Fuentes
- Ollama: Modelos de voz, 24 de octubre de 2026.
- Ollama: biblioteca y licencias de Phonon, consultadas el 26 de octubre de 2026.
¿Quieres conservar un registro consultable del texto, las notas de escucha y los modelos elegidos en un experimento? Lleva el material a Telli.sh y crea una nota a la que puedas volver.