NVIDIA Speech Skills: pokaż procesowi ASR, gdzie myli specjalistyczne słowa
Wprowadzenie do umiejętności adaptacji mowy NVIDIA: jak agent programistyczny pomaga analizować terminologię, przygotowywać dane, wybierać trening i oceniać poprawę.
Transkrypcja zachowuje budowę zdania, ale myli ważną nazwę. Specjalista od razu rozpoznaje zamierzone wyrażenie, tymczasem model wstawia zwykłe słowo. Poprawa wymaga pytania konkretniejszego niż „który model jest najlepszy?”.
Poradnik NVIDIA o Speech Agent Skills z 13 października 2026 r. przedstawia adaptację automatycznego rozpoznawania mowy, czyli ASR, do dziedziny. Umiejętność nadrzędna określa problem i koordynuje pracę, a specjalista NeMo obsługuje zgodny trening i ocenę. Przykładem w poradniku jest mowa kontrolerów ruchu lotniczego. Poradnik NVIDIA
Wyjaśnimy, co wnoszą umiejętności, kiedy warto rozważyć trening i jak zaplanować eksperyment. Nie trzeba zaczynać od dużego przebiegu treningowego. Pierwszym użytecznym wynikiem może być jasny opis mylonych słów, ich znaczenia i interwencji wartej sprawdzenia.
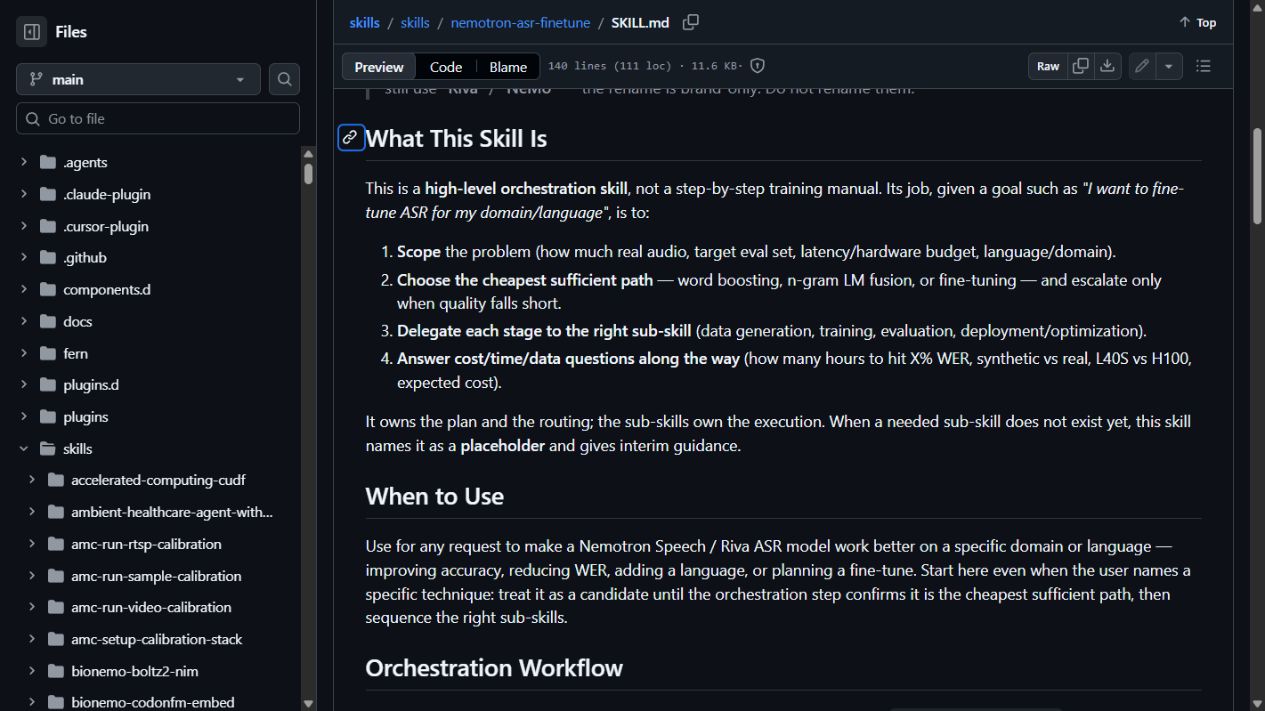 Publiczna dokumentacja umiejętności NVIDIA, zrzut z 20 października 2026 r. Dokumentacja © NVIDIA, atrybucja według CC BY 4.0. Widać instrukcje umiejętności, nie przebieg treningu.
Umiejętność organizuje pracę wokół modelu
Model zawiera wyuczone parametry. Framework treningowy dostarcza mechanizmy ich aktualizacji. Umiejętność agenta dostarcza instrukcje pomagające asystentowi wybrać i przeprowadzić pracę. Instalacja instrukcji nie instaluje wszystkich frameworków, nie pobiera wszystkich punktów kontrolnych ani nie potwierdza możliwości GPU.
NVIDIA oddziela koordynującą umiejętność nemotron-asr-finetune od specjalistycznej nemo-speech-asr-finetune. Pierwsza określa cel i kieruje pracą. Druga obsługuje wykonanie właściwe NeMo, gdy odpowiedni jest trening lub ocena offline. Opis przepływu
Podział pomaga, bo „poprawić rozpoznawanie” obejmuje różne zadania. Problem słownictwa może wymagać wsparcia dekodowania. Różnice stylu mówienia lub warunków nagrania mogą uzasadnić adaptację. Błędne przygotowanie danych może wymagać naprawy przed obiema ścieżkami.
Traktuj umiejętność jak koordynatora eksperymentu. Pomaga uzgodnić cel, wejścia i porównanie, lecz człowiek nadal definiuje sukces. Końcowym artefaktem powinny być sprawdzalne dowody, a nie sam komunikat asystenta o ukończeniu treningu.
Zacznij od błędu zmieniającego znaczenie
Załóżmy, że firma uczy pracowników wypowiadać kody produktów podczas kontroli. Model dobrze zapisuje zwykłą rozmowę, ale regularnie myli dwa podobne kody. Pierwszy przydatny zbiór to takie pomyłki z oryginalnym dźwiękiem i sprawdzoną transkrypcją wzorcową.
Drugi przypadek to archiwum wywiadów z nazwiskami i specjalistyczną terminologią. Trudność może zależeć od mówcy, mikrofonu i tematu. Oddziel konwencje pisowni od błędów akustycznych: dwie formy zapisu tego samego skrótu nie powinny automatycznie oznaczać różnych pomyłek rozpoznawania.
Trzeci przypadek to nagrania wsparcia technicznego z zaszumionego kanału. Lista słów może pomóc terminom, nie przywracając brakujących sylab. Projekt adaptacji zyskuje, gdy rozróżnia oczekiwania językowe od dźwięku rzeczywiście dostępnego modelowi.
To proponowane zastosowania, nie opisane wdrożenia. Pokazują, dlaczego wejście powinno zawierać przykłady zamiast samego celu. Kilkanaście zrozumianych błędów ujawni, czy następny krok to czyszczenie danych, wsparcie słownictwa czy szersze badanie adaptacji.
Wybierz najmniej wymagającą interwencję usuwającą błąd
Publiczna umiejętność koordynacji opisuje przejście przez wzmacnianie słów, wsparcie modelu językowego i dostrajanie, wybierając wystarczającą ścieżkę przed eskalacją. To zasada planowania, nie gwarancja identycznych mechanizmów każdego modelu i środowiska. Dokumentacja umiejętności
| Zaobserwowany problem | Możliwa interwencja | Co porównać |
|---|---|---|
| Znany termin przegrywa ze zwykłym słowem | Obsługiwany mechanizm słownika lub wzmacniania słów | Trafność terminów i niechciane wstawienia |
| Branżowe frazy stale są mało prawdopodobne | Zgodny model językowy lub wsparcie dekodowania | Trafność dziedzinowa i zwykła mowa |
| Model nie radzi sobie z mową lub kanałem dziedziny | Adaptacja modelu akustycznego | Odłożone nagrania dziedzinowe i zbiór ogólny |
| Trafność nagle spada po zmianie konfiguracji | Przywrócenie i walidacja zgodności przygotowania danych | Ten sam punkt kontrolny i dźwięk przy obu konfiguracjach |
Tabela pomaga zdecydować, nie diagnozuje. Dodanie słowa może wprowadzić błędy, jeśli podobne zwykłe wyrazy są częste. Dostrojenie może poprawić zadanie specjalistyczne kosztem innej mowy. Mierz oczekiwany efekt i skutki uboczne, których trzeba uniknąć.
Warto też oddzielić transkrypcję od późniejszego wygładzania. Model językowy może przepisać nieprawdopodobną frazę w rozsądnie brzmiący tekst, ale to nie dowód odzyskania wypowiedzianych słów. Zachowaj oryginalne rozpoznanie, by niezależnie ocenić zadanie akustyczne.
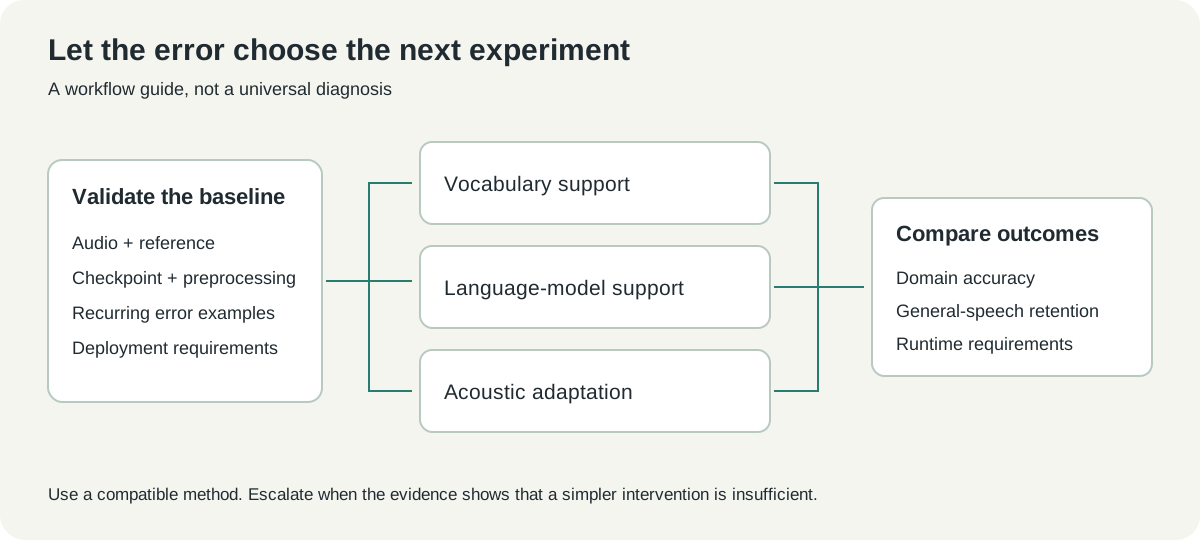 Autorski schemat oparty na udokumentowanym przepływie. Wprowadza możliwe drogi, nie twierdzi, że jedna pasuje do każdego systemu rozpoznawania.
Raportowana poprawa ma dokładny mianownik
W przykładzie NVIDIA poradnik podaje spadek współczynnika błędów słów Nemotron z 77.00% do 22.46% na dwugodzinnym, ręcznie opisanym zbiorze testowym ATCO2, czyli 70.8% względnej redukcji. Ogólny angielski WER zmienia się jednocześnie z 3.50% do 3.63%. To wyniki wydawcy w warunkach tego badania. Poradnik z 13 października
WER liczy podstawienia, usunięcia i wstawienia względem słów wzorca. Nie jest odsetkiem zdań z choćby jednym błędem, a względna redukcja nie jest zmianą w punktach procentowych. Rozdzielenie tych wielkości ułatwia uczciwe porównanie.
Przykład jest wartościowy, bo pokazuje dziedzinę docelową i inną. Sam wynik specjalistyczny nie powie, czy zachowano potrzebną umiejętność zwykłej mowy. Nawet niewielką zmianę domeny ogólnej należy czytać obok poprawy, zamiast pomijać ją w opisie.
Inny mikrofon, język lub konwencja zapisu może dać zupełnie inny rezultat. Nagłówek powinien więc zachęcać do metody: zmierz punkt odniesienia, adaptuj w kontrolowanych warunkach i oceń odłożony zbiór. Nie obiecuje firmie usunięcia takiej samej części błędów jej rozmów.
Oddziel materiał uczący od materiału oceniającego
Dane adaptacji potrzebują różnych ról. Przykłady treningowe zmieniają model. Rozwojowe pomagają wybierać punkty kontrolne i ustawienia dekodowania. Testowe oceniają wybrany system po dokonaniu tych wyborów.
Losowy podział krótkich fragmentów może pozorować niezależność. Dwa wycinki tego samego nagrania dzielą mówcę, kanał, frazę i tło. Jeśli to możliwe, dziel według jednostki ważnej dla wdrożenia: nagrań, mówców lub sesji zbierania danych.
Jawnie ustal konwencję wzorca. Zdecyduj przed oceną, jak zapisywać liczby, skróty, interpunkcję i zawahania. Gdy wyjście zapisze „twenty one”, a wzorzec „21”, normalizacja może zmienić wynik bez zmiany treści rozumianej przez słuchacza.
Na początek przygotuj mały inwentarz zamiast ścigać duży korpus. Zapisz pochodzenie audio, dozwolone użycie, osobę sprawdzającą transkrypcję i rolę elementu. Jasny spis łatwiej ocenić niż folder, którego jedynym śladem pochodzenia są nazwy plików.
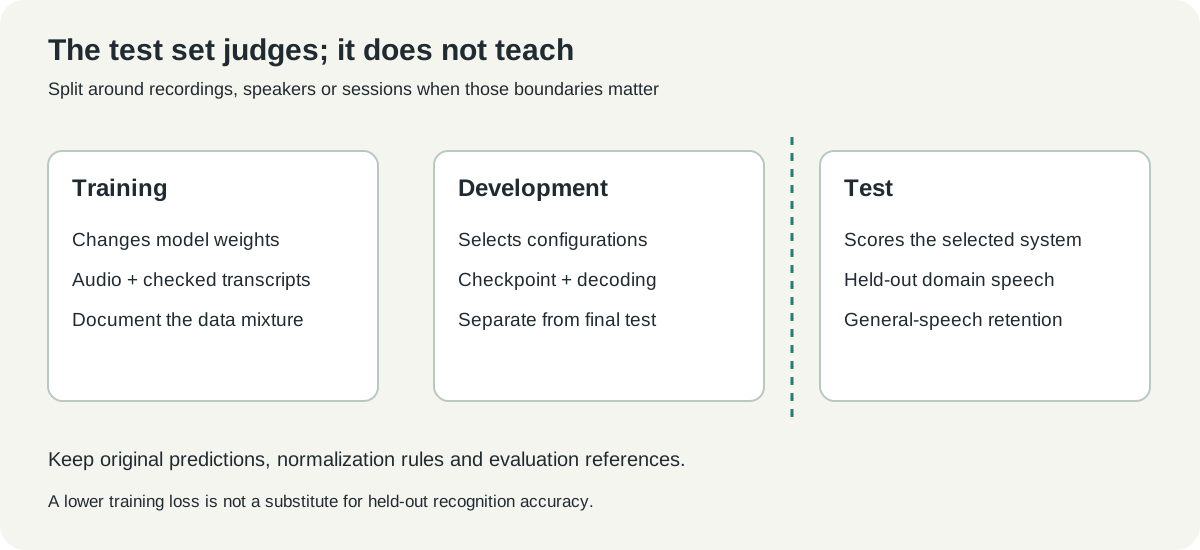 Autorski schemat. Ścieżka testowa pozostaje poza treningiem i wyborem punktu kontrolnego; zachowanie zwykłej mowy ocenia się obok zadania dziedzinowego.
Pierwsza prośba powinna dotyczyć planu i punktu odniesienia
Umiejętność pracuje użyteczniej, gdy prośba zawiera obserwowalny cel. „Pomóż z transkrypcjami kontroli” to początek, ale nie określa modelu, języka, trybu wdrożenia ani kosztu błędu. Dodaj te informacje i poproś o ograniczony etap pierwszy.
Proponowana prośba może brzmieć:
Przejrzyj mały, licencjonowany zbiór naszych nagrań kontroli i wzorcowych transkrypcji. Znajdź powtarzalne pomyłki terminów, sprawdź obecny model i przygotowanie danych oraz zmierz punkt odniesienia. Porównaj wsparcie słownictwa z propozycją treningu. Zachowaj odłożony zbiór testowy i przed dłuższym uruchomieniem podaj trafność dziedzinową, zachowanie zwykłej mowy oraz wymagania zasobów.
Przykład określa dowody, które agent ma zwrócić. Metoda pozostaje otwarta, dopóki dane nie uzasadnią wyboru. To zwykle produktywniejsze niż polecenie dostrojenia konkretnego modelu przez dowolnie wybraną liczbę kroków.
Użyteczny raport początkowy identyfikuje dokładny punkt kontrolny, konfigurację wykonawczą, zbiór oceny i powracające błędy. Wyjaśnia też, co ogranicza postęp. Zła transkrypcja przez błędne próbkowanie wymaga innej naprawy niż przez naprawdę nieznany rodzaj mowy.
Świadomie instaluj instrukcje i zależności wykonawcze
Poradnik NVIDIA podaje osobne polecenia dla umiejętności koordynującej i specjalistycznej. Druga nie instaluje się automatycznie, gdy pierwsza do niej odsyła. Polecenia poniżej odtwarzają wybór umiejętności z poradnika; przejrzyj repozytoria i wybierz zamierzony zakres instalacji po wyświetleniu pytania.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Po instalacji otwórz nową sesję agenta i potwierdź dostępność umiejętności. To dowodzi odnajdywania instrukcji, nie możliwości załadowania modelu ani treningu na komputerze.
Poradnik używa hosta GPU z Linux i przypiętego kontenera NeMo Speech 26.07.00. Sprawdź wymagania sterownika, GPU i frameworka bieżącego obrazu przed przygotowaniem hosta. Umiejętność na laptopie nie zastępuje środowiska wykonawczego. Przygotowanie środowiska
Ogranicz pierwszy test środowiska. Sprawdź importy, widoczność GPU, ładowanie modelu i krótki przebieg wnioskowania przed rezerwacją budżetu treningowego. Zapisz wersje i kontener, by połączyć późniejszy wynik z użytym oprogramowaniem.
Rozpoznawanie strumieniowe i offline wymagają oddzielnych porównań
Model strumieniowy tworzy wynik w czasie napływu audio. Offline może użyć innego sposobu wykonania po otrzymaniu nagrania. Oba rozpoznają mowę, ale opóźnienie, kontekst i dekodowanie różnią się na tyle, że jeden wynik nie wystarcza.
Dla aplikacji na żywo zapisuj pojawienie się częściowych wyników, ich stabilizację i dostarczenie tekstu końcowego. Trafniejsza, lecz spóźniona transkrypcja może nie służyć napisom na żywo. W archiwum wolniejszy proces offline bywa akceptowalny, jeśli daje lepszy zapis końcowy.
W głównym porównaniu zachowaj ten sam tryb przed adaptacją i po niej. Jednoczesna zmiana podziału, dekodowania, modelu i normalizacji ukryje przyczynę poprawy. Osobno eksperymentuj z całym alternatywnym przepływem.
Ta dyscyplina pomaga też późniejszej ocenie. Etykiety mówców, znaczniki czasu i rozpoznane słowa to różne wyniki. Dobry WER może współistnieć z przypisaniem ważnej wypowiedzi niewłaściwej osobie, dlatego oceniaj je oddzielnie, gdy są potrzebne.
Oceniony punkt kontrolny to więcej niż udany dziennik treningu
Malejąca strata treningowa pokazuje dopasowanie do funkcji celu. Nie dowodzi trafniejszego rozpoznania nowego mówcy. Użyteczny artefakt to wybrany punkt kontrolny wraz z konfiguracją, przewidywaniami i oceną.
Zachowaj oryginalny model i oceń według tego samego protokołu. Dołącz reprezentatywne błędy, aby ekspert zrozumiał pozostałą lukę. Tabela średnich powinna prowadzić do przykładów, nie je zasłaniać.
Wdrożenie dodaje pytania. Czy docelowa maszyna ładuje artefakt? Czy serwer obsługuje architekturę i tokenizer? Czy wyjście zachowuje konwencje oczekiwane przez dalsze oprogramowanie? Środowiska treningu i aplikacji mogą się różnić mimo wspólnej obsługi „rozpoznawania mowy”.
Poradnik NVIDIA rozróżnia wydane narzędzia i opisane jako nadchodzące punkty kontrolne Gold-refined. Dostępność kodu, przykładowe wyniki i wagi po adaptacji traktuj jako osobne stany wydania. Publiczny poradnik wystarcza do planowania, nie oznacza gotowego pakietu każdego pokazanego artefaktu.
Lepsza adaptacja zaczyna się od mniejszego, jaśniejszego pytania
Naszym zdaniem Speech Skills najlepiej służy sprawdzalności specjalistycznej pracy ASR. Zamienia otwartą prośbę o trafność w decyzje o błędach, danych, zgodnych metodach i ocenie. Może to uchronić eksperyment przed długim treningiem bez uzgodnionej mety.
Zacznij od ważnych słów i nagrań dowodzących problemu. Sprawdź prostszą interwencję, potem eskaluj na podstawie dowodów. Model jest wartościowy, gdy poprawia zapis w warunkach rzeczywistych odbiorców.
Źródła i materiały graficzne
Sprawdzono 20 października 2026 r. Liczby pochodzą z badania NVIDIA; nie odtworzono treningu, wnioskowania ani demonstracji. Autor wykonał zrzut publicznej dokumentacji NVIDIA z atrybucją CC BY 4.0. Schematy są autorskie. Zobacz rejestr materiałów.
- Poradnik NVIDIA z 13 października 2026 r.
- Umiejętność koordynująca
- Specjalistyczna umiejętność NeMo
- Framework NeMo Speech
- Licencje dokumentacji i źródeł NVIDIA
Przechowuj dowody audio obok przeglądu
Zachowaj razem odnośniki do źródeł, decyzje terminologiczne i notatki oceny, aby kolejny eksperyment startował od jasnego zapisu. Telli.sh pomaga porządkować takie badania. Utwórz konto Telli.sh