NVIDIA Speech Skills: insegna a un flusso ASR dove sbaglia il gergo
Un'introduzione alle skill NVIDIA per adattare il riconoscimento vocale: come un agente di programmazione può aiutare a indagare il lessico specialistico, preparare i dati, addestrare in modo selettivo e valutare i miglioramenti.
La trascrizione riconosce la struttura della frase e sbaglia il nome importante. Uno specialista capisce subito l'espressione voluta, ma il modello vocale la sostituisce con una parola comune. Per migliorare il risultato si parte da una domanda più specifica di «qual è il modello migliore?».
Il tutorial NVIDIA del 13 ottobre 2026 sulle Speech Agent Skills presenta un flusso per adattare il riconoscimento automatico del parlato, o ASR, a un dominio. Una skill di alto livello aiuta a delimitare il problema e coordinare il lavoro; una specialista NeMo gestisce addestramento e valutazione compatibili. Il tutorial usa le comunicazioni del controllo del traffico aereo come esempio completo. Tutorial NVIDIA
Questa introduzione spiega cosa aggiungono le skill, quando conviene considerare l'addestramento e come pianificare un primo esperimento. Non serve iniziare con una lunga sessione di training. Un primo risultato utile può essere una spiegazione chiara di quali parole vengono sbagliate, perché contano e quale intervento merita una prova.
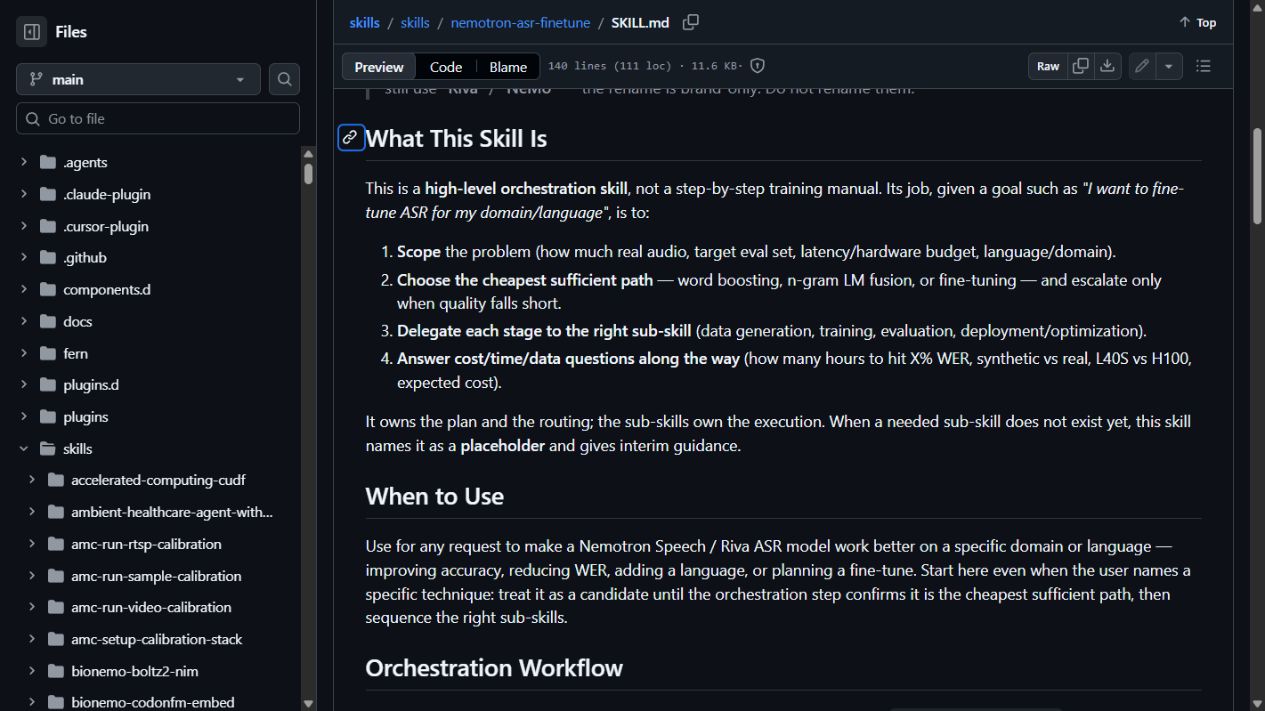 La documentazione pubblica della skill NVIDIA, acquisita il 20 ottobre 2026. Documentazione © NVIDIA, attribuita secondo CC BY 4.0. Mostra le istruzioni della skill, non un'esecuzione di addestramento.
Una skill organizza il lavoro attorno a un modello
Un modello contiene parametri appresi. Un framework di addestramento fornisce i meccanismi per aggiornarli. Una skill agente fornisce istruzioni che aiutano un assistente di programmazione a scegliere ed eseguire un flusso di lavoro. Installare le istruzioni non installa tutti i framework, non scarica tutti i checkpoint e non dimostra che una GPU possa eseguire l'esperimento.
Nel tutorial NVIDIA distingue una skill di orchestrazione, nemotron-asr-finetune, da una specialista, nemo-speech-asr-finetune. La prima inquadra l'obiettivo e instrada il lavoro. La seconda gestisce l'esecuzione specifica di NeMo quando sono appropriati addestramento o valutazione offline. Descrizione del flusso
Questa divisione è utile perché «migliorare il riconoscimento» comprende lavori diversi. Un problema di vocabolario può richiedere supporto alla decodifica. Una discrepanza nello stile di parlato o nelle condizioni audio può giustificare un adattamento. Un'impostazione errata di pretrattamento può richiedere una correzione prima che entrambe le altre strade abbiano senso.
Pensa alla skill come a un coordinatore dell'esperimento. Può aiutare ad allineare obiettivo, ingressi e confronto, ma serve ancora una persona che definisca cosa significa riuscire. L'artefatto finale dovrebbe essere una prova ispezionabile, non soltanto un assistente che afferma di aver terminato l'addestramento.
Parti dall'errore che cambia il significato
Supponiamo che un'azienda insegni al personale a pronunciare un piccolo insieme di codici prodotto durante le ispezioni. Il riconoscitore trascrive bene la conversazione ordinaria, ma confonde ripetutamente due codici simili. Il primo dataset utile è una raccolta di queste confusioni con l'audio originale e una trascrizione di riferimento verificata.
Un secondo caso è un archivio di interviste contenente nomi e terminologia specialistica. Qui la difficoltà può variare con parlante, microfono e argomento. Separa le convenzioni ortografiche dagli errori acustici: due forme scritte della stessa abbreviazione non dovrebbero diventare automaticamente due errori distinti di riconoscimento.
Un terzo caso è audio di assistenza alle apparecchiature registrato su un canale rumoroso. Aggiungere un elenco di parole può aiutare alcuni termini lasciando irrisolte le sillabe mancanti. Un progetto di adattamento diventa più utile quando distingue le aspettative linguistiche dal suono effettivamente disponibile al modello.
Sono applicazioni proposte del flusso, non distribuzioni già documentate. Mostrano perché l'ingresso dovrebbe contenere esempi oltre a una frase con l'obiettivo. Una dozzina di errori ben compresi può rivelare se il passo successivo sia pulizia dei dati, supporto del vocabolario o uno studio di adattamento più sostanziale.
Usa l'intervento meno impegnativo che affronta il problema
La skill pubblica di orchestrazione descrive una progressione attraverso potenziamento delle parole, supporto di modelli linguistici e fine-tuning, scegliendo una strada sufficiente prima di aumentare l'impegno. È un principio di pianificazione, non la garanzia che tutti i modelli o runtime espongano controlli identici. Documentazione della skill
| Problema osservato | Intervento candidato | Cosa confrontare |
|---|---|---|
| Un termine noto perde contro una parola comune | Meccanismo supportato di vocabolario o potenziamento delle parole | Accuratezza dei termini obiettivo e inserimenti indesiderati |
| Gli schemi delle frasi di dominio risultano sistematicamente improbabili | Supporto compatibile di modello linguistico o decodifica | Accuratezza nel dominio insieme al parlato ordinario |
| Il modello fatica con il parlato o il canale del dominio | Adattamento del modello acustico | Audio di dominio tenuto da parte e un insieme di parlato generale |
| L'accuratezza crolla dopo una modifica di configurazione | Ripristinare e convalidare la compatibilità del pretrattamento | Stesso checkpoint e audio nelle due configurazioni |
La tabella aiuta a decidere, non è una diagnosi. Aggiungere vocabolario può creare nuovi errori quando parole comuni simili sono frequenti. Il fine-tuning può migliorare un'attività specialistica peggiorando un altro tipo di parlato. Misura l'effetto desiderato e gli effetti collaterali da evitare.
Aiuta anche separare la trascrizione dalla pulizia successiva. Un modello linguistico può riscrivere una frase improbabile in qualcosa che suona ragionevole, ma non dimostra di aver recuperato le parole pronunciate. Mantieni l'output originale del riconoscimento per valutare indipendentemente il compito acustico.
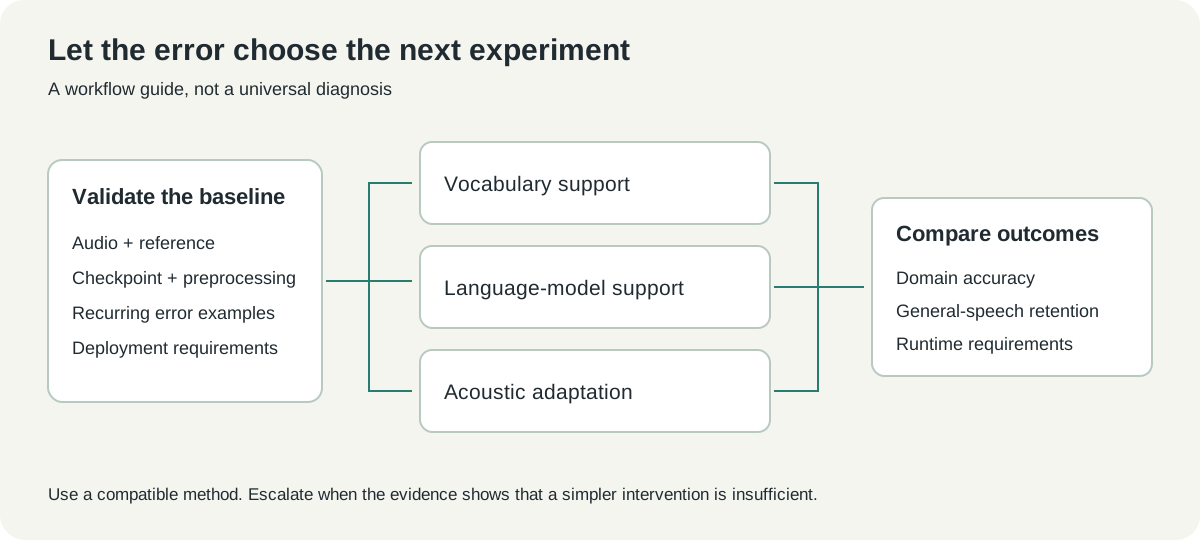 Diagramma decisionale originale basato sul flusso documentato. Introduce percorsi possibili, senza affermare che uno valga per tutti i riconoscitori.
Il miglioramento pubblicato ha un denominatore preciso
Nello studio completo NVIDIA, il tutorial riporta una riduzione del tasso di errore sulle parole di Nemotron da 77.00% a 22.46% su un test set ATCO2 di due ore annotato da persone, una riduzione relativa del 70.8%. Riporta anche un cambiamento della WER sull'inglese generale da 3.50% a 3.63%. Sono i risultati dell'editore nelle condizioni di quello studio. Tutorial del 13 ottobre
Il tasso di errore sulle parole conta sostituzioni, cancellazioni e inserimenti rispetto alle parole di riferimento. Non è la percentuale di frasi con almeno un errore, e la riduzione relativa riportata non è una variazione in punti percentuali. Tenere separate queste quantità rende più corretto il confronto.
L'esempio è utile perché mostra sia il dominio obiettivo sia un altro dominio. Un risultato specialistico da solo non dice se il riconoscitore conserva la capacità sul parlato comune ancora necessaria. Anche una piccola variazione nel dominio generale merita di essere letta accanto al miglioramento, invece di essere omessa.
Un microfono, una lingua o una convenzione di trascrizione diversi possono produrre un risultato molto differente. Il dato principale dovrebbe quindi motivare un metodo: misurare un riferimento, adattare in condizioni controllate e valutare un insieme tenuto da parte. Non dovrebbe diventare la promessa che un'azienda eliminerà la stessa proporzione di errori dalle proprie chiamate.
Separa il materiale che insegna da quello che giudica
Un dataset di adattamento richiede ruoli distinti. Gli esempi di addestramento cambiano il modello. Quelli di sviluppo guidano scelte come checkpoint e impostazioni di decodifica. Quelli di test giudicano il sistema selezionato dopo che tali scelte sono state fatte.
Una suddivisione casuale per brevi segmenti può creare un'indipendenza ingannevole. Due clip della stessa registrazione possono condividere parlante, canale, frase e suono di fondo. Quando possibile, progetta le suddivisioni intorno all'unità rilevante per la distribuzione: registrazioni, parlanti o sessioni di raccolta.
Esplicita la convenzione di riferimento. Decidi come rappresentare numeri, abbreviazioni, punteggiatura ed esitazioni prima della valutazione. Se un output scrive «ventuno» e il riferimento scrive «21», la normalizzazione scelta può cambiare il punteggio senza cambiare ciò che un ascoltatore ha capito.
Per iniziare, prepara un piccolo inventario invece di correre a raccogliere un corpus enorme. Registra l'origine dell'audio, gli usi permessi, chi ha controllato la trascrizione e il ruolo di ogni elemento. Un inventario chiaro è molto più facile da revisionare di una cartella in cui la provenienza è affidata ai nomi dei file.
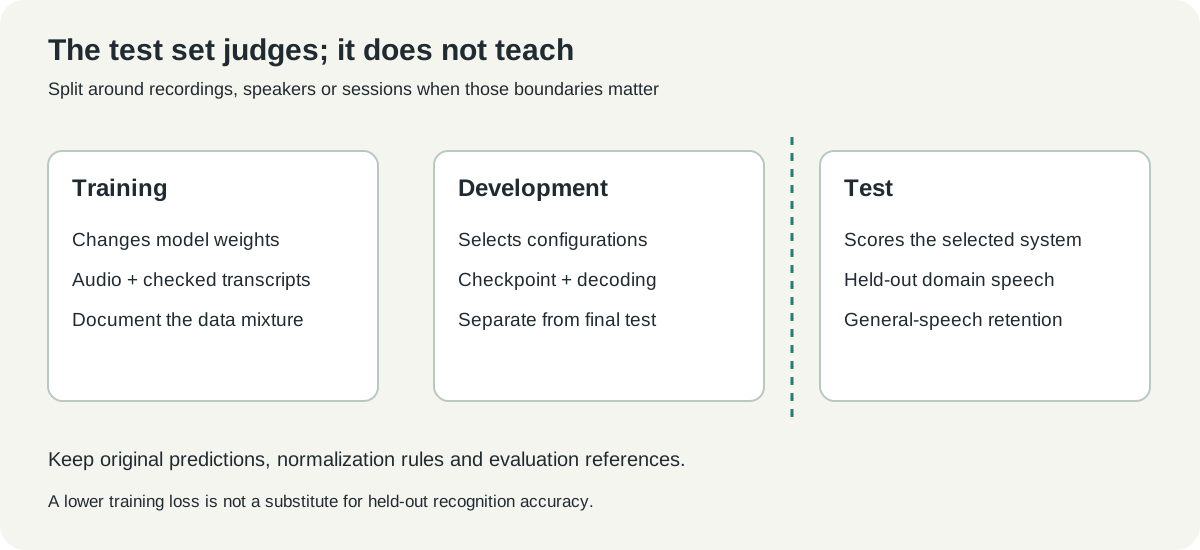 Diagramma esplicativo originale. La corsia di test resta fuori dall'addestramento e dalla selezione dei checkpoint; il mantenimento del parlato ordinario si valuta insieme all'attività di dominio.
La prima richiesta dovrebbe chiedere un piano e un riferimento
La skill può fare un lavoro più utile quando la richiesta contiene un obiettivo osservabile. «Aiutaci con le trascrizioni delle ispezioni» è un inizio, ma lascia ambigui riconoscitore, lingua, modalità di distribuzione e costo dell'errore. Aggiungi questi dettagli e chiedi una prima fase delimitata.
Per esempio, una richiesta proposta potrebbe essere:
Esamina un piccolo insieme autorizzato delle nostre registrazioni di ispezione e delle trascrizioni di riferimento. Identifica confusioni terminologiche ripetute, convalida il riconoscitore e il pretrattamento attuali e misura un riferimento. Confronta il supporto del vocabolario con una proposta di addestramento. Conserva un test set separato e riporta accuratezza nel dominio, mantenimento del parlato ordinario e requisiti di risorse prima di una prova più lunga.
L'esempio definisce le prove che l'agente dovrebbe restituire. Lascia anche aperto il metodo finché i dati non sostengono una scelta. Di solito è più produttivo che partire dal comando di affinare un checkpoint specifico per un numero arbitrario di passi.
Un rapporto iniziale utile dovrebbe identificare checkpoint esatto, configurazione di esecuzione, insieme di valutazione ed errori ricorrenti. Dovrebbe anche spiegare quale parte del processo limita attualmente i progressi. Una trascrizione scadente dovuta a un campionamento errato richiede una correzione diversa da una causata da parlato realmente sconosciuto.
Installa consapevolmente istruzioni e dipendenze di esecuzione
Il tutorial NVIDIA documenta comandi di installazione separati per la skill di orchestrazione e quella specialista. La seconda non viene installata automaticamente soltanto perché la prima la menziona. I comandi seguenti riproducono il percorso di selezione del tutorial; esamina i repository e scegli l'ambito di installazione desiderato quando richiesto.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Avvia una nuova sessione dell'agente di programmazione dopo l'installazione e verifica che le skill attese siano disponibili. Questo stabilisce che l'agente può trovare le istruzioni. Non dice ancora se la macchina possa caricare un checkpoint o eseguire l'addestramento.
Il tutorial usa un host Linux con GPU e un container NeMo Speech fissato alla versione 26.07.00 per la configurazione documentata. Controlla i requisiti di driver, GPU e framework dell'immagine attuale prima di preparare un host. Una skill installata su un portatile non sostituisce quell'ambiente di esecuzione. Preparazione dell'ambiente
Mantieni circoscritto il primo controllo dell'ambiente. Verifica importazioni, visibilità della GPU, caricamento del checkpoint e una breve inferenza prima di assegnare un budget di addestramento. Registra versioni e identità del container per collegare un risultato successivo al software che l'ha prodotto.
Riconoscimento streaming e offline richiedono confronti separati
Un riconoscitore streaming deve produrre output mentre arriva l'audio. Uno offline può usare uno schema diverso quando la registrazione è già disponibile. Entrambi trascrivono il parlato, ma latenza, contesto e scelte di decodifica possono differire abbastanza da rendere insufficiente un solo punteggio.
Per un'applicazione dal vivo, registra quando appaiono i risultati parziali, quando si stabilizzano e come viene consegnato il testo finale. Una trascrizione più accurata che arriva troppo tardi può non servire ai sottotitoli dal vivo. Per un archivio, un processo offline più lento può essere accettabile se produce un documento finale migliore.
Usa la stessa modalità prima e dopo l'adattamento nel confronto principale. Se cambi anche suddivisione, decodifica, checkpoint e normalizzazione, un punteggio migliore non dirà quale modifica abbia contato. Aggiungi un esperimento separato quando vuoi confrontare l'intero flusso alternativo.
La stessa disciplina aiuta nella valutazione a valle. Etichette dei parlanti, timestamp e parole riconosciute sono output distinti. Una trascrizione può avere una buona WER assegnando una dichiarazione importante alla persona sbagliata: valuta separatamente queste capacità se l'applicazione ne ha bisogno.
Un checkpoint valutato è più di un log di addestramento riuscito
Una loss di addestramento in calo indica che l'ottimizzazione sta adattandosi al proprio obiettivo. Non dimostra che un nuovo parlante sarà riconosciuto meglio. L'artefatto utile è un checkpoint selezionato insieme a configurazione, previsioni e risultati di valutazione.
Mantieni disponibile il modello originale e valutalo con lo stesso protocollo. Includi diversi errori rappresentativi nel rapporto, così un revisore del dominio può capire il divario restante. Una tabella di medie dovrebbe portare agli esempi, anziché nasconderli.
La distribuzione aggiunge altre domande. La macchina di destinazione può caricare l'artefatto? Il runtime di servizio supporta architettura e tokenizer? L'output conserva le convenzioni attese dal software successivo? Un ambiente di addestramento e uno applicativo possono non coincidere anche quando entrambi supportano il «riconoscimento vocale».
Il tutorial NVIDIA distingue gli strumenti rilasciati dai checkpoint rifiniti con Gold che descrive come in arrivo. Considera disponibilità del codice, risultati di esempio e pesi adattati scaricabili come stati di rilascio separati. Un tutorial pubblico basta per iniziare a pianificare; non significa che ogni artefatto mostrato sia già pronto per la tua distribuzione.
Un adattamento migliore comincia con una domanda più piccola e chiara
La nostra opinione è che Speech Skills sia soprattutto utile per rendere ispezionabile il lavoro ASR specialistico. Trasforma una richiesta aperta di maggiore accuratezza in una sequenza di decisioni su errori, dati, metodi compatibili e valutazione. Questo può evitare che un esperimento diventi un lungo addestramento senza un traguardo condiviso.
Parti dalle parole che contano e dalle registrazioni che dimostrano il problema. Chiedi se funziona un intervento più semplice, poi aumenta l'impegno sulla base delle prove. Il checkpoint ha valore quando migliora la trascrizione nelle condizioni reali di lettori o ascoltatori.
Fonti e materiali visivi
Consultato il 20 ottobre 2026. I risultati numerici sono attribuiti allo studio NVIDIA; non sono stati riprodotti addestramenti, inferenze o dimostrazioni per questo articolo. La schermata mostra documentazione pubblica NVIDIA, acquisita dall'autore, con attribuzione CC BY 4.0. I diagrammi sono originali. Consulta il registro dei media.
- Tutorial NVIDIA, 13 ottobre 2026
- Skill di orchestrazione
- Skill specialista NeMo
- Framework NeMo Speech
- Licenze della documentazione e dei sorgenti NVIDIA
Conserva le prove audio accanto alla revisione
Tieni insieme riferimenti alle fonti, decisioni terminologiche e note di valutazione, così il prossimo esperimento partirà da un registro chiaro. Telli.sh può aiutarti a organizzare questa ricerca. Crea un account Telli.sh