NVIDIA Speech Skills : adapter un parcours ASR là où le jargon fait défaut
Une introduction aux skills d'adaptation vocale de NVIDIA : comment un agent de développement peut examiner le vocabulaire spécialisé, préparer les données, entraîner à bon escient et évaluer les progrès.
La transcription respecte la structure de la phrase et se trompe sur le nom important. Un spécialiste comprend immédiatement l'expression visée, mais le modèle remplace le terme par un mot courant. Pour améliorer ce résultat, il faut commencer par une question plus précise que « quel est le meilleur modèle ? ».
Le tutoriel NVIDIA du 13 octobre 2026 sur Speech Agent Skills présente une méthode d'adaptation de la reconnaissance automatique de la parole, ou ASR, à un domaine. Un skill de haut niveau aide à cadrer le problème et à coordonner le travail ; un spécialiste NeMo prend en charge l'entraînement et l'évaluation compatibles. L'exemple développé concerne les communications du contrôle aérien. Tutoriel NVIDIA
Cette introduction explique l'apport des skills, les situations où envisager l'entraînement et la préparation d'un premier essai. Il n'est pas nécessaire de démarrer par un gros entraînement. Un premier résultat utile peut simplement préciser les mots qui échouent, leur importance et l'intervention à tester.
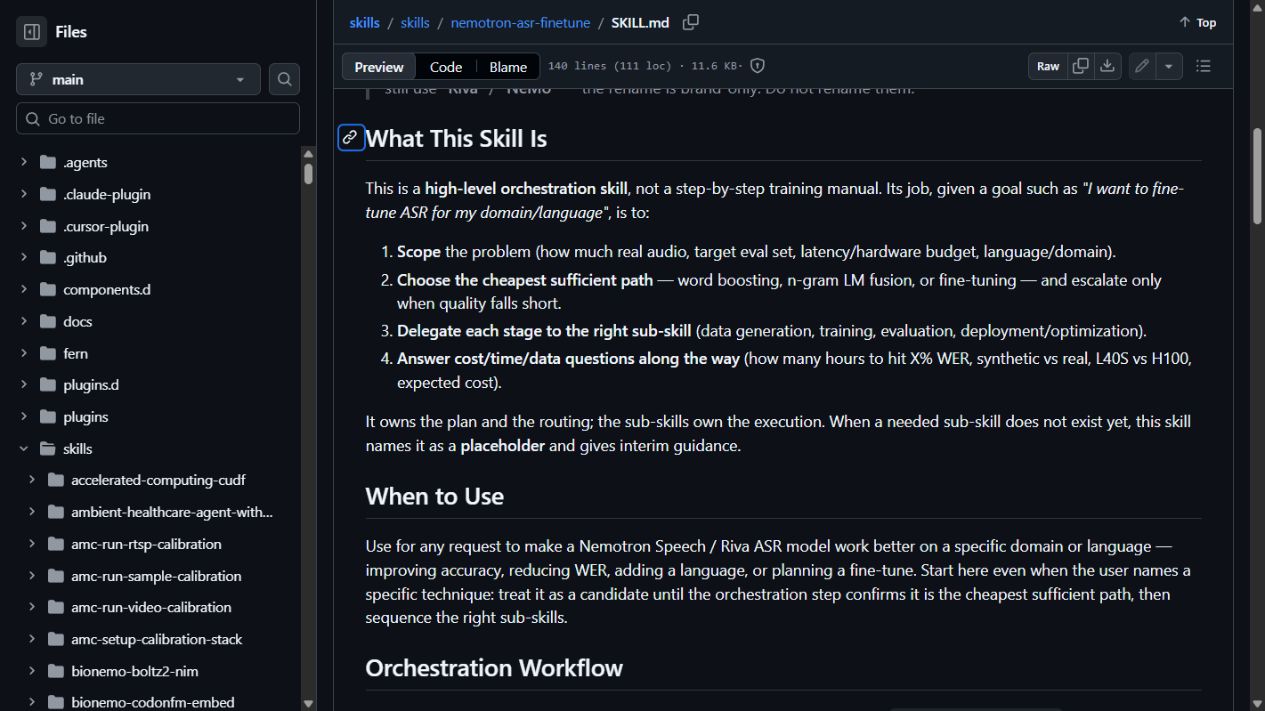 La documentation publique du skill de NVIDIA, capturée le 20 octobre 2026. Documentation © NVIDIA, avec attribution sous CC BY 4.0. L'image présente les instructions du skill, pas une exécution d'entraînement.
Un skill organise le travail autour d'un modèle
Un modèle contient des paramètres appris. Un framework d'entraînement fournit la mécanique permettant de les mettre à jour. Un skill d'agent fournit des instructions qui aident un assistant de développement à choisir et exécuter un parcours. Installer ces instructions n'installe pas tous les frameworks, ne télécharge pas tous les checkpoints et ne prouve pas qu'un GPU peut mener l'expérience.
Dans le tutoriel, NVIDIA sépare le skill de coordination nemotron-asr-finetune du spécialiste nemo-speech-asr-finetune. Le premier définit l'objectif et oriente le travail. Le second réalise l'exécution propre à NeMo lorsque l'entraînement ou l'évaluation hors ligne est pertinent. Description du parcours
Cette division est utile parce qu'« améliorer la reconnaissance » recouvre plusieurs tâches. Un problème de vocabulaire peut demander une aide au décodage. Un décalage de style oral ou de conditions audio peut justifier une adaptation. Une mauvaise configuration de prétraitement peut devoir être corrigée avant que l'une ou l'autre voie ait un sens.
Voyez le skill comme un coordinateur d'expérience. Il aide à aligner objectif, entrées et comparaison, mais une personne doit toujours définir la réussite. Le livrable final doit être une preuve inspectable, pas seulement un assistant affirmant que l'entraînement est terminé.
Commencez par l'erreur qui change le sens
Supposons qu'une entreprise apprenne à son personnel à prononcer un petit ensemble de codes produits pendant des inspections. Le système transcrit bien la conversation ordinaire, mais confond régulièrement deux codes proches. Le premier jeu utile réunit ces confusions, l'audio original et une transcription de référence vérifiée.
Un deuxième cas est une archive d'entretiens contenant des noms et des termes spécialisés. La difficulté peut varier selon l'orateur, le microphone et le sujet. Séparez les conventions orthographiques des erreurs acoustiques : deux écritures d'une même abréviation ne doivent pas automatiquement devenir deux échecs de reconnaissance différents.
Un troisième cas est de l'audio de support technique transmis par un canal bruyant. Une liste de vocabulaire peut aider certains termes sans résoudre les syllabes manquantes. Un projet d'adaptation devient plus utile quand il distingue les attentes linguistiques du son réellement disponible pour le modèle.
Ces usages sont proposés, pas rapportés comme déploiements. Ils montrent pourquoi l'entrée doit comporter des exemples, et pas seulement un objectif. Une douzaine d'erreurs bien comprises peut révéler si l'étape suivante est un nettoyage des données, une aide au vocabulaire ou une étude d'adaptation plus lourde.
Choisissez l'intervention la moins exigeante qui traite l'échec
Le skill public de coordination décrit une progression entre renforcement de mots, aide par modèle de langue et fine-tuning, en choisissant une voie suffisante avant d'escalader. C'est un principe de planification, pas la garantie que tous les modèles ou runtimes exposent les mêmes réglages. Documentation du skill
| Problème observé | Intervention candidate | Ce qu'il faut comparer |
|---|---|---|
| Un terme connu perd face à un mot courant | Vocabulaire pris en charge ou mécanisme de renforcement de mots | Exactitude des termes cibles et insertions indésirables |
| Les tournures du domaine restent systématiquement improbables | Modèle de langue ou aide au décodage compatible | Exactitude du domaine et parole ordinaire |
| Le modèle peine avec la parole ou le canal du domaine | Adaptation du modèle acoustique | Audio métier réservé et ensemble de parole générale |
| La précision s'effondre après un changement de configuration | Restaurer et valider la compatibilité du prétraitement | Même checkpoint et même audio sous les deux configurations |
Le tableau aide à décider, il ne pose pas de diagnostic. Ajouter du vocabulaire peut créer des erreurs lorsque des mots ordinaires proches sont fréquents. Un fine-tuning peut améliorer une spécialité tout en dégradant un autre type de parole. Mesurez l'effet désiré et les effets secondaires à éviter.
Il est aussi utile de distinguer transcription et réécriture ultérieure. Un modèle de langue peut transformer une formule invraisemblable en texte raisonnable, sans prouver qu'il a retrouvé les mots prononcés. Conservez la reconnaissance d'origine pour juger séparément la tâche acoustique.
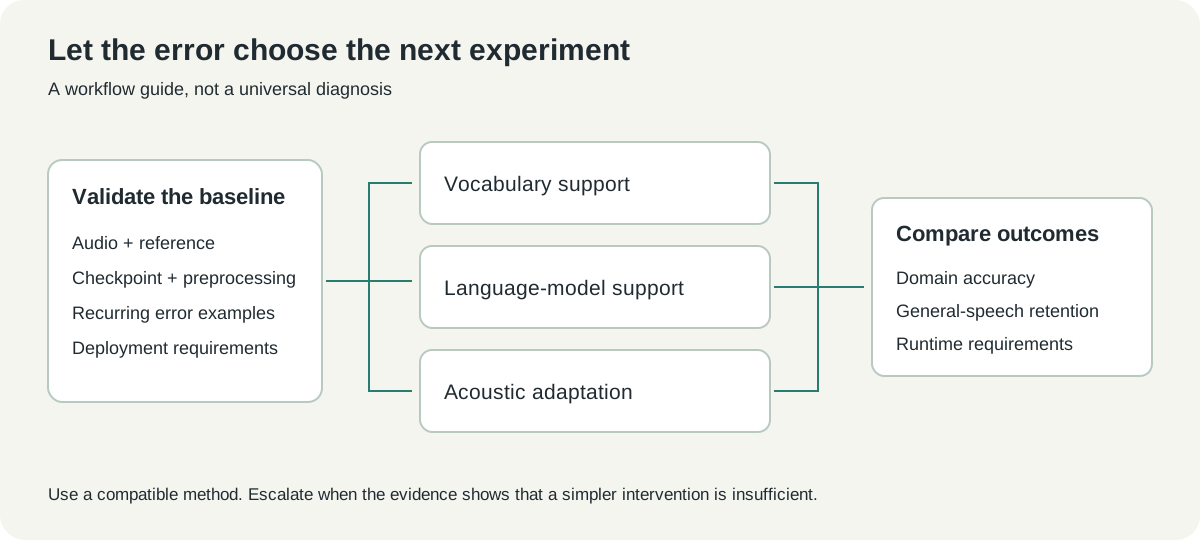 Schéma de décision original fondé sur le parcours documenté. Il présente des voies possibles, sans affirmer qu'une seule convient à tous les systèmes de reconnaissance.
Le progrès annoncé possède un dénominateur précis
Dans l'étude NVIDIA, le tutoriel annonce un taux d'erreur sur les mots de Nemotron passant de 77.00% à 22.46% sur un ensemble de test ATCO2 de deux heures annoté par des humains, soit une réduction relative de 70.8%. Il indique aussi un WER en anglais général passant de 3.50% à 3.63%. Ce sont les résultats de l'éditeur dans les conditions de cette étude. Tutoriel du 13 octobre
Le taux d'erreur sur les mots compte substitutions, suppressions et insertions par rapport aux mots de référence. Ce n'est pas le pourcentage de phrases comportant au moins une erreur, et la réduction relative annoncée n'est pas une variation en points de pourcentage. Distinguer ces grandeurs facilite une comparaison honnête.
L'exemple est utile parce qu'il montre le domaine cible et un autre domaine. Un résultat spécialisé ne suffit pas à savoir si le système conserve les capacités de parole ordinaire dont vous avez besoin. Même un faible changement général doit accompagner l'amélioration dans le récit plutôt qu'être omis.
Un autre microphone, une autre langue ou une autre convention de transcription peuvent produire un résultat très différent. Le chiffre doit donc motiver une méthode : établir une référence, adapter dans des conditions contrôlées et évaluer un ensemble réservé. Il ne doit pas promettre à une entreprise d'éliminer la même proportion d'erreurs dans ses appels.
Séparez les données qui enseignent de celles qui jugent
Un jeu d'adaptation doit distinguer les rôles. Les exemples d'entraînement modifient le modèle. Les exemples de développement orientent les choix de checkpoints et de décodage. Les exemples de test jugent le système retenu une fois ces choix arrêtés.
Un découpage aléatoire de petits segments peut donner une indépendance trompeuse. Deux extraits du même enregistrement partagent parfois voix, canal, tournures et fond sonore. Si possible, découpez selon l'unité importante en déploiement, comme les enregistrements, les locuteurs ou les sessions de collecte.
Explicitez la convention de référence. Décidez avant le calcul comment représenter nombres, abréviations, ponctuation et hésitations. Si une sortie écrit « twenty one » et la référence « 21 », la normalisation choisie peut modifier le score sans changer ce qu'un auditeur comprend.
Pour commencer, préparez un petit inventaire au lieu de courir après un vaste corpus. Notez la provenance de l'audio, les usages autorisés, la personne qui a vérifié le texte et le rôle de chaque élément. Cet inventaire est bien plus facile à examiner qu'un dossier dont les noms de fichiers sont la seule provenance.
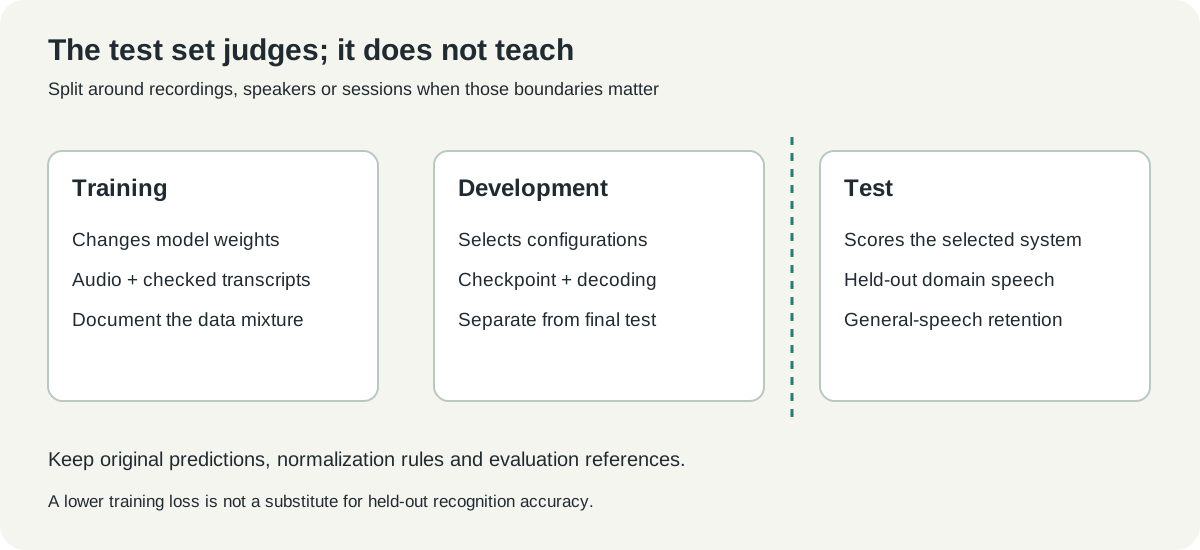 Schéma explicatif original. La voie de test reste hors entraînement et sélection des checkpoints ; le maintien de la parole ordinaire est évalué avec la tâche métier.
La première demande devrait porter sur un plan et une référence
Le skill travaille mieux quand la demande contient une cible observable. « Aidez nos transcriptions d'inspection » est un début, mais laisse flous le système, la langue, le mode de déploiement et le coût des erreurs. Ajoutez ces détails et demandez une première phase bornée.
Une demande proposée pourrait être :
Examinez un petit ensemble sous licence de nos enregistrements d'inspection et de leurs références. Identifiez les confusions récurrentes, validez le système et le prétraitement actuels, puis mesurez une référence. Comparez l'aide au vocabulaire à une proposition d'entraînement. Préservez un test réservé et rapportez l'exactitude métier, le maintien de la parole ordinaire et les ressources nécessaires avant un entraînement plus long.
Cet exemple définit les preuves attendues de l'agent. Il laisse aussi la méthode ouverte jusqu'à ce que les données étayent le choix. C'est généralement plus productif que de demander d'emblée un fine-tuning d'un checkpoint précis pendant un nombre arbitraire d'étapes.
Un premier rapport utile identifie exactement le checkpoint, la configuration, le jeu d'évaluation et les erreurs récurrentes. Il explique aussi quelle partie du processus limite actuellement la progression. Une mauvaise transcription due à l'échantillonnage appelle une autre correction qu'une parole réellement inhabituelle.
Installez délibérément instructions et dépendances d'exécution
Le tutoriel NVIDIA donne des commandes séparées pour les skills de coordination et de spécialité. Le second n'est pas installé automatiquement parce que le premier le cite. Les commandes suivantes reproduisent la sélection du tutoriel ; examinez les dépôts et choisissez la portée d'installation voulue à l'invite.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Ouvrez une nouvelle session de l'agent après installation et confirmez la disponibilité des skills attendus. Cela établit que l'agent peut découvrir les instructions, sans encore dire si la machine charge un checkpoint ou entraîne un modèle.
Le tutoriel utilise un hôte GPU Linux et un conteneur NeMo Speech figé, 26.07.00, pour sa configuration. Vérifiez les exigences actuelles de pilote, GPU et framework avant de préparer l'hôte. Un skill installé sur un portable ne remplace pas cet environnement. Préparation de l'environnement
Limitez la première vérification. Validez les imports, la visibilité du GPU, le chargement du checkpoint et une courte inférence avant d'engager un budget d'entraînement. Notez versions et identité du conteneur pour relier les résultats ultérieurs au logiciel qui les a produits.
Le streaming et la reconnaissance hors ligne exigent des comparaisons séparées
Un système en streaming doit produire du texte pendant l'arrivée de l'audio. Un système hors ligne peut fonctionner autrement une fois l'enregistrement disponible. Tous deux transcrivent la parole, mais latence, contexte et décodage peuvent différer assez pour qu'un score unique ne suffise pas.
Pour une application en direct, notez l'apparition des résultats partiels, leur stabilisation et la livraison du texte final. Une transcription plus exacte mais trop tardive peut être inutile pour les sous-titres en direct. Pour une archive, un traitement plus lent peut convenir s'il améliore le document final.
Gardez le même mode avant et après adaptation pour la comparaison centrale. Si vous changez aussi le découpage, le décodage, le checkpoint et la normalisation, un meilleur score ne dira pas quelle modification compte. Ajoutez une expérience distincte pour comparer le parcours alternatif complet.
La même discipline aide en aval. Étiquettes de locuteurs, horodatages et mots reconnus sont des sorties distinctes. Une transcription peut avoir un bon WER tout en attribuant une déclaration importante à la mauvaise personne ; jugez séparément ces capacités si l'application en dépend.
Un checkpoint évalué vaut plus qu'un journal d'entraînement réussi
Une perte d'entraînement qui baisse indique que l'optimisation ajuste son objectif. Elle ne prouve pas qu'un nouveau locuteur sera mieux reconnu. Le livrable utile est un checkpoint sélectionné, sa configuration, ses prédictions et ses résultats d'évaluation.
Gardez le modèle d'origine disponible et évaluez-le selon le même protocole. Ajoutez des échecs représentatifs pour qu'un spécialiste comprenne l'écart restant. Un tableau de moyennes doit conduire aux exemples, pas les masquer.
Le déploiement ajoute d'autres questions. La machine cible peut-elle charger l'artefact ? Le runtime de service prend-il en charge l'architecture et le tokenizer ? La sortie conserve-t-elle les conventions attendues en aval ? Environnement d'entraînement et runtime applicatif peuvent diverger même si les deux annoncent de la « reconnaissance vocale ».
Le tutoriel distingue les outils publiés et les checkpoints Gold-refined décrits comme à venir. Traitez la disponibilité du code, les résultats d'exemple et les poids adaptés téléchargeables comme des états distincts. Le tutoriel public suffit pour commencer à planifier ; il ne signifie pas que chaque artefact montré est déjà prêt pour votre déploiement.
Une meilleure adaptation commence par une question plus petite et plus claire
À notre avis, Speech Skills sert surtout à rendre le travail ASR spécialisé inspectable. Il transforme une demande ouverte d'exactitude accrue en décisions sur les erreurs, les données, les méthodes compatibles et l'évaluation. Cela peut éviter un long entraînement sans ligne d'arrivée convenue.
Commencez avec les mots importants et les enregistrements qui prouvent le problème. Demandez si une intervention plus simple fonctionne, puis augmentez l'effort avec des preuves. Le checkpoint a de la valeur quand il améliore la transcription dans les conditions réellement vécues par vos lecteurs ou auditeurs.
Sources et médias
Vérifié le 20 octobre 2026. Les chiffres sont attribués à l'étude NVIDIA ; aucun entraînement, aucune inférence ni démonstration n'ont été reproduits pour cet article. La capture montre la documentation publique de NVIDIA, réalisée par l'auteur et créditée sous CC BY 4.0. Les schémas sont originaux. Voir le registre des médias.
- Tutoriel NVIDIA du 13 octobre 2026
- Skill de coordination
- Skill spécialiste NeMo
- Framework NeMo Speech
- Licences de la documentation et du code NVIDIA
Gardez la preuve audio à côté de la revue
Réunissez références, choix terminologiques et notes d'évaluation pour que l'essai suivant parte d'un dossier clair. Telli.sh peut vous aider à organiser cette recherche. Créer un compte Telli.sh