NVIDIA Speech Skills: enseña a un flujo de ASR dónde falla la jerga
Una introducción a las habilidades de adaptación de voz de NVIDIA: cómo un agente de programación puede ayudar a investigar vocabulario especializado, preparar datos, entrenar de forma selectiva y evaluar las mejoras.
La transcripción acierta la estructura de la frase y falla el nombre importante. Un especialista reconoce de inmediato la expresión buscada, pero el modelo de voz la sustituye por una palabra corriente. Mejorar ese resultado empieza con una pregunta más concreta que «¿qué modelo es el mejor?».
El tutorial de NVIDIA del 13 de octubre de 2026 sobre Speech Agent Skills presenta un flujo para adaptar el reconocimiento automático del habla, o ASR, a un dominio. Una habilidad de alto nivel ayuda a delimitar el problema y coordinar el trabajo; un especialista de NeMo se encarga del entrenamiento y la evaluación compatibles. El tutorial utiliza como ejemplo desarrollado las comunicaciones de control del tráfico aéreo. Tutorial de NVIDIA
Esta introducción explica qué aportan las habilidades, cuándo merece la pena considerar el entrenamiento y cómo planificar un primer experimento. No hace falta empezar con un entrenamiento grande. Un primer resultado útil puede ser una explicación clara de qué palabras fallan, por qué importan y qué intervención merece ponerse a prueba.
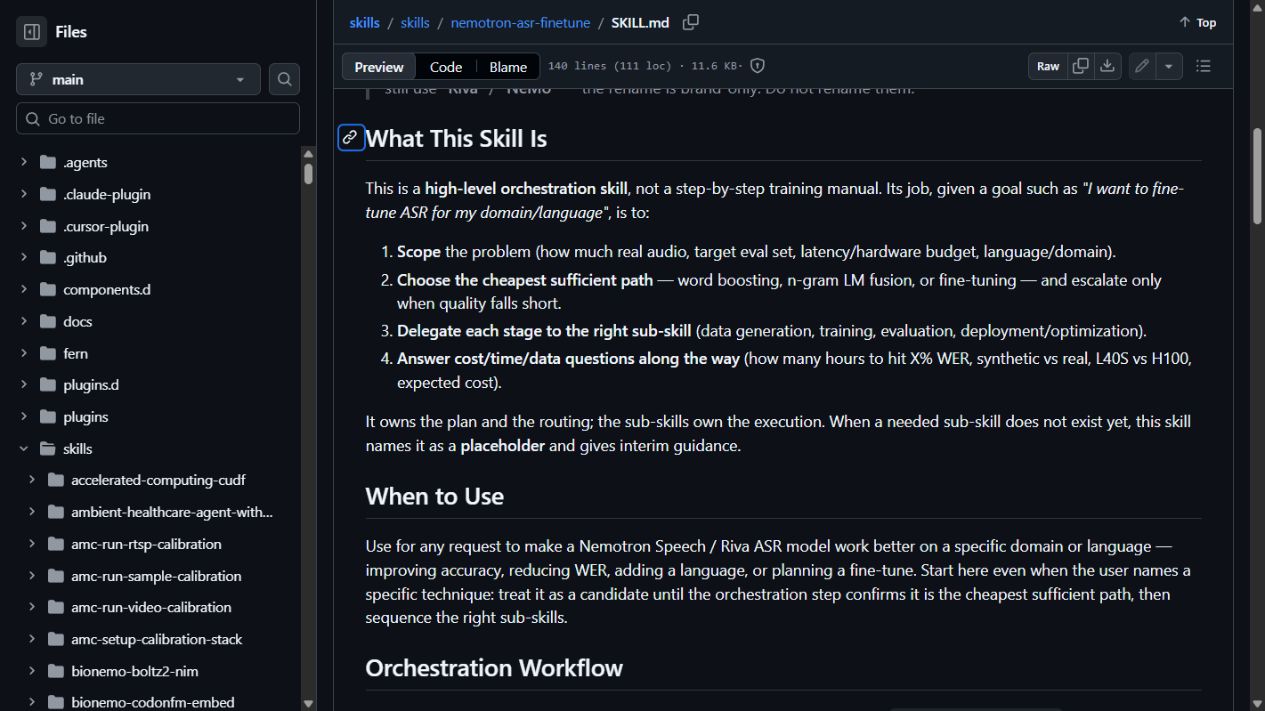 La documentación pública de la habilidad de NVIDIA, capturada el 20 de octubre de 2026. Documentación © NVIDIA, con atribución bajo CC BY 4.0. Muestra las instrucciones de la habilidad, no una ejecución de entrenamiento.
Una habilidad organiza el trabajo alrededor de un modelo
Un modelo contiene parámetros aprendidos. Un framework de entrenamiento proporciona los mecanismos para actualizarlos. Una habilidad de agente aporta instrucciones que ayudan a un asistente de programación a elegir y realizar un flujo de trabajo. Instalar las instrucciones no instala todos los frameworks, descarga todos los checkpoints ni demuestra que una GPU pueda ejecutar el experimento.
En el tutorial, NVIDIA separa una habilidad de coordinación, nemotron-asr-finetune, de una especialista, nemo-speech-asr-finetune. La primera plantea el objetivo y encamina el trabajo. La segunda gestiona la ejecución específica de NeMo cuando procede entrenar o evaluar sin conexión. Descripción del flujo
Esta división puede ser útil porque «mejorar el reconocimiento» engloba trabajos diferentes. Un problema de vocabulario puede necesitar apoyo en la decodificación. Un desajuste en el estilo de habla o las condiciones de audio puede justificar una adaptación. Una configuración de preprocesamiento errónea puede necesitar corregirse antes de que cualquiera de las otras vías tenga sentido.
Piensa en la habilidad como coordinadora del experimento. Puede ayudar a alinear objetivo, entradas y comparación, pero el experimento sigue necesitando a una persona que defina qué significa el éxito. El resultado final deberían ser pruebas inspeccionables, no simplemente un asistente que diga que el entrenamiento terminó.
Empieza por el error que cambia el significado
Supongamos que una empresa enseña al personal a pronunciar un pequeño conjunto de códigos de producto durante las inspecciones. El reconocedor transcribe bien la conversación ordinaria, pero confunde repetidamente dos códigos parecidos. El primer conjunto de datos útil es una colección de esas confusiones con el audio original y una transcripción de referencia comprobada.
Un segundo caso es un archivo de entrevistas con nombres y terminología especializada. Aquí la dificultad puede variar según el hablante, el micrófono y el tema. Separa las convenciones ortográficas de los errores acústicos: dos formas escritas de una misma abreviatura no deberían tratarse automáticamente como fallos distintos de reconocimiento.
Un tercer caso es audio de soporte de equipos grabado a través de un canal ruidoso. Añadir una lista de vocabulario puede ayudar con algunos términos y dejar sin resolver las sílabas ausentes. Un proyecto de adaptación resulta más útil cuando distingue las expectativas lingüísticas del sonido realmente disponible para el modelo.
Son aplicaciones propuestas del flujo, no despliegues comunicados. Muestran por qué la entrada debe incluir ejemplos y no solo una frase con el objetivo. Una docena de errores bien comprendidos puede revelar si el siguiente paso es limpiar datos, apoyar el vocabulario o estudiar una adaptación más sustancial.
Usa la intervención menos exigente que aborde el fallo
La habilidad pública de coordinación describe una progresión por refuerzo de palabras, apoyo de modelos de lenguaje y ajuste fino, eligiendo una vía suficiente antes de escalar. Es un principio de planificación, no una garantía de que todos los modelos o entornos expongan controles idénticos. Documentación de la habilidad
| Problema observado | Intervención candidata | Qué comparar |
|---|---|---|
| Un término conocido pierde frente a una palabra común | Mecanismo compatible de vocabulario o refuerzo de palabras | Exactitud de los términos objetivo e inserciones no deseadas |
| Los patrones de frases del dominio resultan sistemáticamente improbables | Apoyo compatible de modelo de lenguaje o decodificación | Exactitud del dominio junto a habla corriente |
| El modelo tiene dificultades con el habla o canal del dominio | Adaptación del modelo acústico | Audio del dominio reservado y un conjunto de habla general |
| La exactitud se desploma tras cambiar una configuración | Restaurar y validar la compatibilidad del preprocesamiento | El mismo checkpoint y audio bajo ambas configuraciones |
La tabla ayuda a decidir, no diagnostica. Añadir vocabulario puede crear errores nuevos cuando abundan palabras comunes parecidas. El ajuste fino puede mejorar una tarea especializada y degradar otro tipo de habla. Mide el efecto buscado y los efectos secundarios que necesitas evitar.
También conviene separar la transcripción de la limpieza posterior. Un modelo de lenguaje puede reescribir una expresión improbable en algo razonable, pero eso no demuestra que haya recuperado las palabras pronunciadas. Conserva la salida original del reconocimiento para evaluar de forma independiente la tarea acústica.
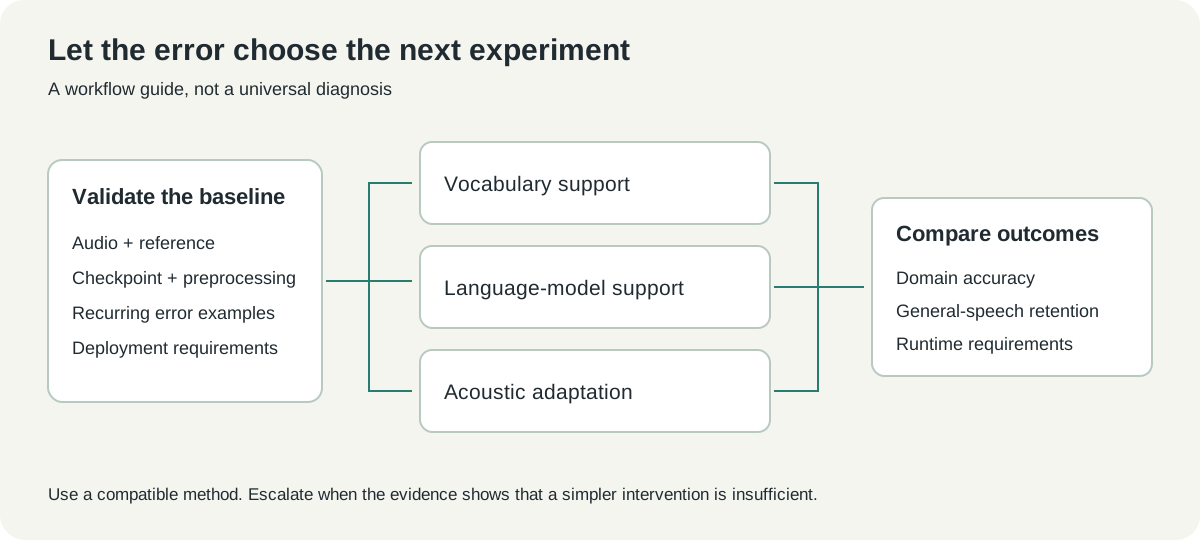 Diagrama de decisión original basado en el flujo documentado. Introduce vías posibles; no afirma que una sola sirva para todos los reconocedores.
La mejora publicada tiene un denominador preciso
En el estudio desarrollado por NVIDIA, el tutorial informa de una caída de la tasa de error de palabras de Nemotron del 77.00% al 22.46% sobre un conjunto de prueba ATCO2 de dos horas anotado por personas, una reducción relativa del 70.8%. También informa de un cambio de WER en inglés general del 3.50% al 3.63%. Son resultados del editor bajo las condiciones de aquel estudio. Tutorial del 13 de octubre
La tasa de error de palabras cuenta sustituciones, eliminaciones e inserciones con respecto a las palabras de referencia. No es el porcentaje de frases con al menos un error, y la reducción relativa publicada no es un cambio en puntos porcentuales. Separar esas cantidades facilita comparar un resultado honestamente.
El ejemplo es útil porque muestra tanto el dominio objetivo como otro dominio. Un resultado especializado por sí solo no dice si el reconocedor conserva la capacidad de habla ordinaria que aún necesitas. Incluso un pequeño cambio en el dominio general merece aparecer junto a la mejora, en lugar de desaparecer del relato.
Otro micrófono, idioma o convención de transcripción puede producir un resultado muy distinto. Por tanto, el titular debería motivar un método: medir una referencia, adaptar bajo condiciones controladas y puntuar un conjunto reservado. No debería convertirse en la promesa de que una empresa eliminará la misma proporción de errores de sus llamadas.
Separa el material que enseña del material que juzga
Un conjunto de adaptación necesita funciones diferenciadas. Los ejemplos de entrenamiento cambian el modelo. Los de desarrollo orientan decisiones como los checkpoints y ajustes de decodificación. Los de prueba evalúan el sistema elegido después de tomar esas decisiones.
Dividir al azar por segmentos cortos puede crear una independencia engañosa. Dos clips de una misma grabación pueden compartir hablante, canal, expresión y sonido de fondo. Cuando sea posible, diseña las divisiones alrededor de la unidad que importe para el despliegue, como grabaciones, hablantes o sesiones de recogida.
Explicita la convención de referencia. Decide cómo representar números, abreviaturas, puntuación y vacilaciones antes de puntuar. Si una salida escribe «veintiuno» y la referencia escribe «21», la normalización elegida puede cambiar la puntuación sin cambiar lo que entendió una persona.
Para empezar, prepara un inventario pequeño en lugar de lanzarte a reunir un corpus enorme. Registra de dónde procede el audio, qué uso está permitido, quién comprobó la transcripción y qué función tiene cada elemento. Un inventario claro es mucho más fácil de revisar que una carpeta cuya única procedencia son los nombres de archivo.
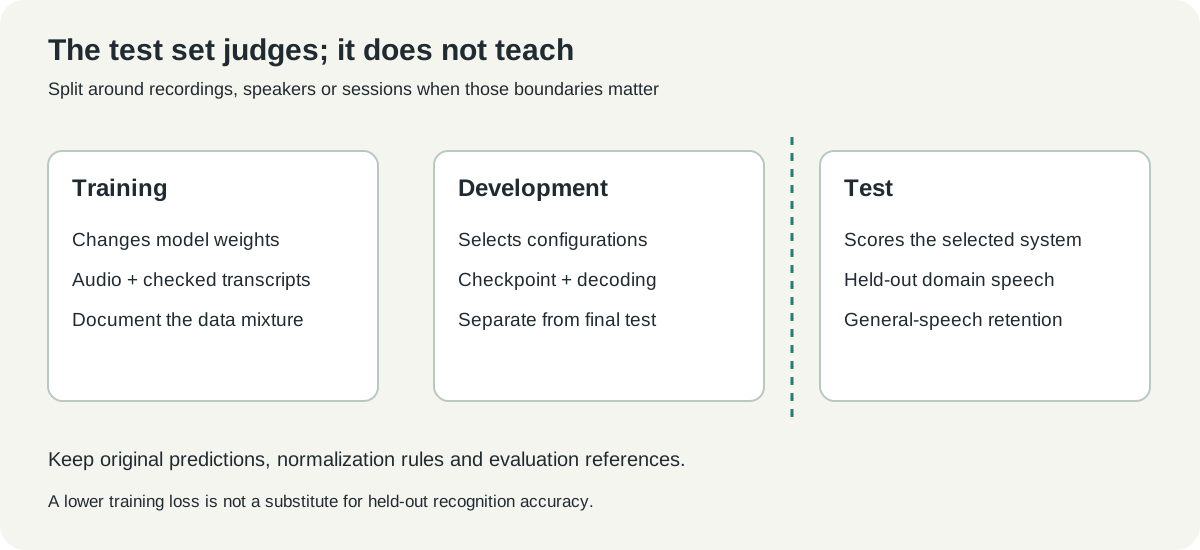 Diagrama explicativo original. La vía de prueba permanece fuera del entrenamiento y la selección de checkpoints; la conservación del habla corriente se evalúa junto a la tarea del dominio.
Una primera petición debería solicitar un plan y una referencia
La habilidad puede hacer un trabajo más útil cuando la petición contiene un objetivo observable. «Ayuda con nuestras transcripciones de inspecciones» es un comienzo, pero deja ambiguos el reconocedor, el idioma, el modo de despliegue y el coste del error. Añade esos detalles y pide una primera fase delimitada.
Por ejemplo, una petición propuesta podría decir:
Inspecciona un conjunto pequeño y autorizado de nuestras grabaciones de inspección y transcripciones de referencia. Identifica confusiones terminológicas repetidas, valida el reconocedor y el preprocesamiento actuales y mide una referencia. Compara el apoyo de vocabulario con una propuesta de entrenamiento. Conserva un conjunto de prueba reservado e informa de la exactitud del dominio, la conservación del habla corriente y los requisitos de recursos antes de una ejecución más larga.
El ejemplo define las pruebas que debe devolver el agente. También deja abierto el método hasta que los datos apoyen una elección. Eso suele ser más productivo que empezar ordenando ajustar un checkpoint concreto durante un número arbitrario de pasos.
Un informe inicial útil debe identificar el checkpoint exacto, la configuración de ejecución, el conjunto de evaluación y los errores recurrentes. También debe explicar qué parte del proceso limita el progreso en ese momento. Una transcripción deficiente por una frecuencia de muestreo incorrecta necesita una reparación distinta de otra causada por habla realmente desconocida.
Instala deliberadamente tanto las instrucciones como las dependencias de ejecución
El tutorial de NVIDIA documenta comandos de instalación separados para las habilidades de coordinación y especialista. La segunda no se instala automáticamente porque la primera la mencione. Los siguientes comandos reproducen la vía de selección del tutorial; inspecciona los repositorios y elige el alcance de instalación previsto cuando se solicite.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
Inicia una sesión nueva del agente de programación después de instalar y confirma que las habilidades esperadas estén disponibles. Esto demuestra que el agente puede descubrir las instrucciones. Todavía no dice si el equipo puede cargar un checkpoint o realizar entrenamiento.
El tutorial utiliza un host Linux con GPU y un contenedor fijado de NeMo Speech, 26.07.00, en su configuración documentada. Comprueba los requisitos de controlador, GPU y framework de la imagen actual antes de preparar un host. Una habilidad instalada en un portátil no sustituye a ese entorno de ejecución. Preparación del entorno
Mantén acotada la primera comprobación del entorno. Verifica importaciones, visibilidad de la GPU, carga del checkpoint y una pasada breve de inferencia antes de asignar presupuesto de entrenamiento. Registra las versiones y la identidad del contenedor para relacionar un resultado posterior con el software que lo produjo.
El reconocimiento en streaming y el reconocimiento sin conexión necesitan comparaciones separadas
Un reconocedor en streaming debe producir salida mientras llega el audio. Uno sin conexión puede utilizar otro patrón de ejecución después de disponer de la grabación. Ambos transcriben voz, pero la latencia, el contexto y las decisiones de decodificación pueden diferir lo suficiente como para que una sola puntuación no permita compararlos por completo.
Para una aplicación en directo, registra cuándo aparecen los resultados parciales, cuándo se estabilizan y cómo se entrega el texto final. Una transcripción más precisa que llega demasiado tarde puede no servir para subtítulos en directo. Para un archivo, un proceso más lento sin conexión puede ser aceptable si produce un registro final mejor.
Utiliza el mismo modo antes y después de adaptar en la comparación principal. Si también cambias fragmentación, decodificación, checkpoint y normalización del texto, una puntuación mejor no dirá qué cambio importó. Añade un experimento independiente cuando quieras comparar todo el flujo alternativo.
La misma disciplina ayuda con la evaluación posterior. Las etiquetas de hablante, las marcas de tiempo y las palabras reconocidas son resultados distintos. Una transcripción puede tener buena WER y atribuir una afirmación importante a la persona equivocada; evalúa esas capacidades por separado cuando la aplicación las necesite.
Un checkpoint evaluado es más que un registro de entrenamiento satisfactorio
Una pérdida de entrenamiento decreciente indica que la optimización se ajusta a su objetivo. No demuestra que se vaya a reconocer con más precisión a un hablante nuevo. El resultado útil es un checkpoint seleccionado junto con su configuración, predicciones y resultados de evaluación.
Conserva disponible el modelo original y puntúalo con el mismo protocolo. Incluye varios fallos representativos en el informe para que un revisor del dominio comprenda la brecha restante. Una tabla de promedios debe conducir a ejemplos, no ocultarlos.
El despliegue añade otra serie de preguntas. ¿Puede el equipo de destino cargar el artefacto? ¿El entorno de servicio admite su arquitectura y tokenizador? ¿La salida conserva las convenciones que espera el software posterior? Un entorno de entrenamiento y uno de aplicación pueden no coincidir aunque ambos admitan «reconocimiento de voz».
El tutorial de NVIDIA distingue las herramientas publicadas de los checkpoints refinados con Gold que allí se describen como futuros. Considera la disponibilidad del código, los resultados de ejemplo y los pesos adaptados descargables como estados de lanzamiento separados. Un tutorial público basta para empezar a planificar; no significa que todos los artefactos mostrados estén ya empaquetados para tu despliegue.
Una mejor adaptación empieza por una pregunta más pequeña y clara
En nuestra opinión, Speech Skills resulta especialmente útil para hacer inspeccionable el trabajo especializado de ASR. Convierte una petición abierta de mayor exactitud en una secuencia de decisiones sobre errores, datos, métodos compatibles y evaluación. Eso puede evitar que un experimento se convierta en un entrenamiento largo sin una meta acordada.
Empieza por las palabras que importan y las grabaciones que demuestran el problema. Pregunta si funciona una intervención más sencilla y después escala con pruebas. El checkpoint tiene valor cuando mejora la transcripción en las condiciones reales de tus lectores u oyentes.
Fuentes y recursos visuales
Consultado el 20 de octubre de 2026. Los resultados numéricos se atribuyen al estudio de NVIDIA; no se reprodujo ningún entrenamiento, inferencia ni demostración para este artículo. La captura muestra documentación pública de NVIDIA, capturada por el autor, con atribución CC BY 4.0. Los diagramas son originales. Consulta el registro de medios.
- Tutorial de NVIDIA, 13 de octubre de 2026
- Habilidad de coordinación
- Habilidad especialista de NeMo
- Framework NeMo Speech
- Licencias de documentación y código fuente de NVIDIA
Conserva las pruebas de audio junto a la revisión
Mantén juntas las referencias originales, las decisiones terminológicas y las notas de evaluación para que el siguiente experimento parta de un registro claro. Telli.sh puede ayudarte a organizar esa investigación. Crea una cuenta en Telli.sh