Model 24GB to nie komputer 24GB: budżet pamięci Nemotron Bolt
Poznaj łącznie 74B i aktywne 9B parametrów Nemotron Bolt, natywne wagi 2-bitowe oraz wymagania pamięciowe kontekstu, wizji, modelu roboczego i środowiska lokalnego.
Masz kartę graficzną z 24GB pamięci. Nowy model ma „24GB” w nazwie. Czy te dwie liczby rozstrzygają zakup?
Nie w przypadku kompletnego lokalnego obciążenia AI. W ogłoszeniu z 15 października NVIDIA przedstawiła Nemotron 3.5 Bolt 74B-A9B 24GB jako lokalnie wdrażany model wizyjno-językowy wykorzystujący natywną kwantyzację 2-bitową. Nazwa opisuje cel optymalizacji, a nie obietnicę, że każdy rozmiar kontekstu, żądanie obrazu i układ agenta zmieści się na karcie graficznej 24GB. Ogłoszenie NVIDIA, 15 października 2026 r..
Przydatniejsze pytanie brzmi: ile pamięci zostaje po załadowaniu modelu? Ten poradnik oddziela zapisane parametry od aktywnych obliczeń, wyjaśnia pozostałych użytkowników pamięci i przedstawia konfigurację działającą wyłącznie na interfejsie loopback, opartą na rzeczywistym przepisie z karty modelu. Najpierw określ obciążenie, potem sprawdź, czy komputer je utrzyma.
Grafika otwierająca: oryginalne objaśnienie redakcyjne budżetu całego obciążenia, nieoficjalny zrzut ekranu ani zmierzony podział pamięci. Rozmiary składników nie są przedstawione.
Mniejsza liczba aktywnych parametrów nie oznacza pobrania modelu 9B
Bolt ma 74 miliardy parametrów łącznie i około 9 miliardów aktywnych na token. Router mixture-of-experts wybiera część zapisanej sieci. To skompresowany potomek modelu 120B-A12B Super VL, a nie gęsty model 9B. Przegląd badań NVIDIA Bolt, 15 października 2026 r..
Zapamiętaj różnicę: liczba aktywnych parametrów pomaga wyjaśnić obliczenia wykonywane dla tokenu; liczba wszystkich parametrów pomaga oszacować, co trzeba przechowywać. Żadna z nich sama nie określa szybkości aplikacji. Wpływają na nią również rozmieszczenie, przepustowość pamięci, kernele, długość wejścia i aplikacja, która otacza model.
Agent analizujący kod nadal potrzebuje dostępu do ekspertów, których nie wybrano dla poprzedniego tokenu. Przenoszenie danych między pamięcią masową, systemową i pamięcią GPU nie jest tym samym co dostępność wszystkich danych w akceleratorze. Mniejsza liczba aktywnych parametrów nie uprawnia więc do obliczania wymagań sprzętowych tak, jakby pozostałe parametry nie istniały.
Nazwy rodziny również wymagają precyzyjnego porównania:
| Model | Co oznacza nazwa | Status na 16 października |
|---|---|---|
| Nemotron 3.5 Super VL | Osobny model 120B | Wydany |
| Nemotron 3.5 Bolt 74B-A9B 24GB | Omawiana tutaj skompresowana opcja lokalna | Wydany |
| Nemotron 3.5 Bolt E4B 4GB | Osobna, mniejsza oferta brzegowa/konwersacyjna | Zapowiedziany na 23 października |
Statusy wydania pochodzą z ogłoszenia z 15 października. E4B jest przyszłą dostępnością na datę tego artykułu, a nie dostępnym zamiennikiem pokazanym w poniższych poleceniach. Wyników wdrożeń Super VL w przedsiębiorstwach nie należy też traktować jak wyniku desktopowego modelu Bolt.
Natywne wagi 2-bitowe rozwiązują tylko część problemu pamięci
Określenie „natywne 2-bitowe” ma znaczenie, ponieważ agresywna kompresja jest częścią procesu tworzenia modelu, a nie tylko wyborem użytkownika przy późniejszym eksporcie mniejszej wersji. NVIDIA wykorzystuje destylację ze świadomością kwantyzacji, aby odzyskać możliwości po obniżeniu precyzji. Wagi ekspertów używają IQ2_XXS o wartości 2.0625 bitów na element, podczas gdy inne składniki zachowują odmienne formaty. Sieć ma mieszaną precyzję, a nie jednolite dwa bity wszędzie. Objaśnienie kompresji i kwantyzacji NVIDIA, 15 października 2026 r..
Jako celowo nierealistyczny test rachunkowy: 74 miliardy wartości zapisanych dokładnie na dwóch bitach zajęłyby 18.5 miliarda bajtów. To ilustracja, nie rozmiar pliku Bolt ani wymaganie uruchomienia: pomija rzeczywisty miks precyzji, metadane i stan wykonywania. Mnożenie głównej liczby parametrów przez główną liczbę bitów nie zastępuje sprawdzenia konkretnego checkpointu.
GGUF odpowiada na inne pytanie. To format pliku modelu używany w ekosystemie llama.cpp, przechowujący tensory i powiązane informacje. Nie stanowi drugiej obietnicy kompresji nałożonej na „2-bitowy” model, a pobranie GGUF samo nie dowodzi, że konkretne środowisko go obsługuje. Dokumentacja narzędzi GGUF llama.cpp, sprawdzona 16 października 2026 r..
Szacunkowe zestawienie pamięci NVIDIA konkretyzuje tę różnicę: w tabeli 2 podano 22.01GB na wagi, 23.83GB łącznie bez wizji i dodatkowe 1.68GB na enkoder obrazu oraz projektor. To szacunki dostawcy dla konfiguracji z raportu, nie pomiary z tego artykułu. Raport opisuje też cel poniżej 24GB przy batch size jeden i kontekście 128K. Raport techniczny Bolt, tabela 2 i sekcja 2.3, podlinkowany 15 października 2026 r..
Wniosek nie brzmi: nazwa marketingowa potajemnie podaje rozmiar samych wag. Chodzi o to, że cel wdrożeniowy zakłada określone warunki. Zmiana tych założeń zmienia też wymagania pamięciowe.
Planuj cały zestaw roboczy, nie tylko wagi
Pomyśl o wdrożeniu jak o podatku od kontekstu doliczanym do zapisanego modelu: miejsce zajmuje również praca, którą każesz systemowi pamiętać i przetwarzać. W planowaniu rozdziel wagi, stan sekwencji, przetwarzanie wizji, dekodowanie spekulacyjne i przestrzeń roboczą środowiska. Zostaw dodatkowy zapas dla pulpitu i aplikacji, które mają pozostać otwarte.
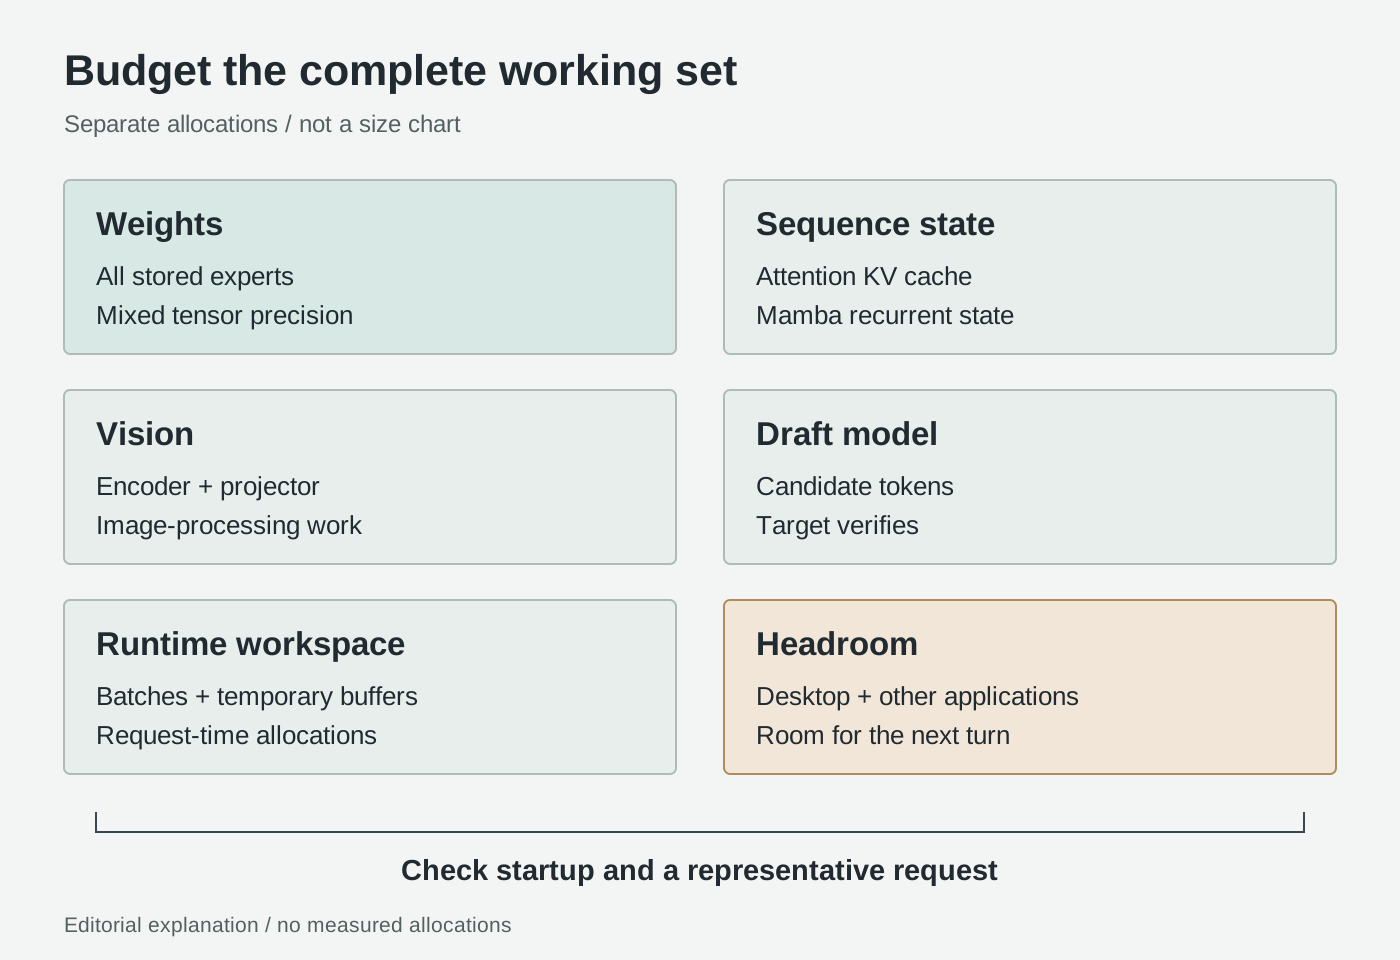
Oryginalne objaśnienie redakcyjne, nie zmierzone proporcje. Mechanizmy: dokumentacja cache Hugging Face, przewodnik multimodalny llama.cpp i raport NVIDIA Bolt, sprawdzone 16 października 2026 r.
Stan sekwencji nie jest kolejną kopią wag. Autoregresyjny model uwagi zapisuje klucze i wartości wcześniejszych tokenów w cache, aby wykorzystać je ponownie podczas generowania. Dłuższe zachowywane sekwencje wymagają większego cache uwagi; szczegóły zależą od architektury i reprezentacji cache. Hugging Face, „How caching works”, sprawdzone 16 października 2026 r..
Bolt to model hybrydowy z warstwami Mamba i uwagi, dlatego ogólny szacunek cache dla modelu wyłącznie Transformerowego nie wystarcza do jego obliczenia. Stan rekurencyjny i cache uwagi to osobne alokacje; sprawdź, co rzeczywiście tworzy środowisko. Rozróżnienie architektury opisuje tabela 1 raportu Bolt, sprawdzona 16 października 2026 r.
Dla agenta zachowany kontekst oznacza więcej niż wpisane pytanie. Instrukcje systemowe, schematy narzędzi, historia rozmowy, pobrane fragmenty i odpowiedzi narzędzi konkurują o pamięć z odpowiedzią. Transkrypcja z powtarzanymi listami plików repozytorium może wyczerpać użyteczny budżet, nie dodając przydatnych dowodów. Zwięzły stan zadania to decyzja o przepływie pracy, a nie tylko obejście sprzętowe.
Wizja wprowadza osobną ścieżkę przetwarzania. llama.cpp łączy model językowy z plikiem projektora multimodalnego za pomocą --mmproj; dokumentacja podaje, że ten składnik jest domyślnie przenoszony na GPU. Przewodnik multimodalny llama.cpp, sprawdzony 16 października 2026 r.. Sam plik modelu językowego nie tworzy więc kompletnej konfiguracji zdolnej do obsługi obrazów.
Przy zadaniu na dokumencie rozróżnij odczytywanie wyodrębnionego tekstu od interpretowania wyrenderowanej strony. Zwykły akapit nie zachowuje wizualnej relacji między nagłówkiem kolumny a komórkami. Z kolei wysyłanie obrazów stron, których układ nie ma znaczenia, dokłada pracy bez pewności, że poprawi odpowiedź. Wybierz reprezentację zachowującą dowody potrzebne do odpowiedzi.
Model roboczy dekodowania spekulacyjnego to kolejny model. Drafter LiLiCorr Bolt proponuje tokeny, które model docelowy weryfikuje. Ma przyspieszać dekodowanie, lecz dodatkowy checkpoint i jego stan wykonania również potrzebują pamięci. Objaśnienie LiLiCorr NVIDIA, 15 października 2026 r.. Obecność draftera nie gwarantuje szybszego ukończenia twoich zadań.
Przestrzeń robocza środowiska to kolejny składnik. Partie przetwarzania promptu i tymczasowe bufory obliczeniowe należą do budżetu razem ze stanem trwałym. Serwer udostępnia logiczny batch size i fizyczny microbatch size; nie są one tym samym co liczba równoległych rozmów. Dokumentacja opcji serwera llama.cpp, sprawdzona 16 października 2026 r.. Konfigurację, która się uruchamia, trzeba jeszcze przetestować na reprezentatywnym żądaniu.
Oficjalna tabela sprzętu jest przydatniejsza niż przyrostek w nazwie produktu
Opublikowane konfiguracje NVIDIA:
| Przepis | Sprzęt | Kontekst | Sekwencje |
|---|---|---|---|
| 28GB | RTX Spark 64GB albo dyskretna karta RTX 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB albo dyskretna karta RTX 48GB+ | 262,144 | 1 |
Źródło: Szybki start NVIDIA, sprawdzony 16 października 2026 r..
Te wiersze nie obejmują dyskretnej karty GPU 24GB ani nie potwierdzają obsługi Maca. Pamięć RAM hosta nie jest dodatkową pamięcią VRAM karty dyskretnej.
Nasza ocena: wybierz powtarzalną konfigurację, nie zrzut ekranu z udanym ładowaniem. Jeśli zakup zależy od tego modelu, wymagaj demonstracji z planowanymi danymi wejściowymi i zwykłymi aplikacjami działającymi w tle. To szczególnie ważne przy obrazach dokumentów i agentach działających długo, których pierwsze żądanie może być znacznie mniejsze od kolejnych.
Dobieraj kontekst do zadania, nie do maksimum
Rozważ trzy przykładowe zadania początkowe, a nie zgłoszone próby.
Programista prosi o wyjaśnienie nieudanego testu i podaje błąd, odpowiednią funkcję oraz jedną pobliską zależność. Użyteczny wynik to diagnoza powiązana z konkretnymi wierszami, a potem proponowana zmiana. Zanim dodasz całe repozytorium, sprawdź, czy brakuje konkretnego interfejsu albo kolejnej ramki stosu. Dzięki temu pytanie pozostaje możliwe do sprawdzenia, a błędne założenia łatwiej wykryć.
Badacz porównuje tabelę na dwóch stronach dokumentu. Test polega na tym, czy model prawidłowo łączy nagłówki, jednostki, przypisy i wartości. Użyj obrazów stron, jeśli liczą się te relacje, poproś o dowody dla konkretnych stron i zweryfikuj próbkę komórek z oryginałem. Płynne podsumowanie, które zamienia dwie kolumny, jest nieudanym wynikiem, nawet jeśli powstało szybko.
Lokalny asystent przeszukuje zatwierdzony folder i przygotowuje raport roboczy. Zużycie pamięci może wzrastać przez pobrane materiały i powtarzane odpowiedzi narzędzi. Najpierw zleć mu zadanie tylko do odczytu, ogranicz zakres wyszukiwania i wymagaj podania plików potwierdzających każdy wniosek. Nie dawaj uprawnień do zapisu ani powłoki tylko po to, by zobaczyć, czy model potrafi stworzyć użyteczny plan.
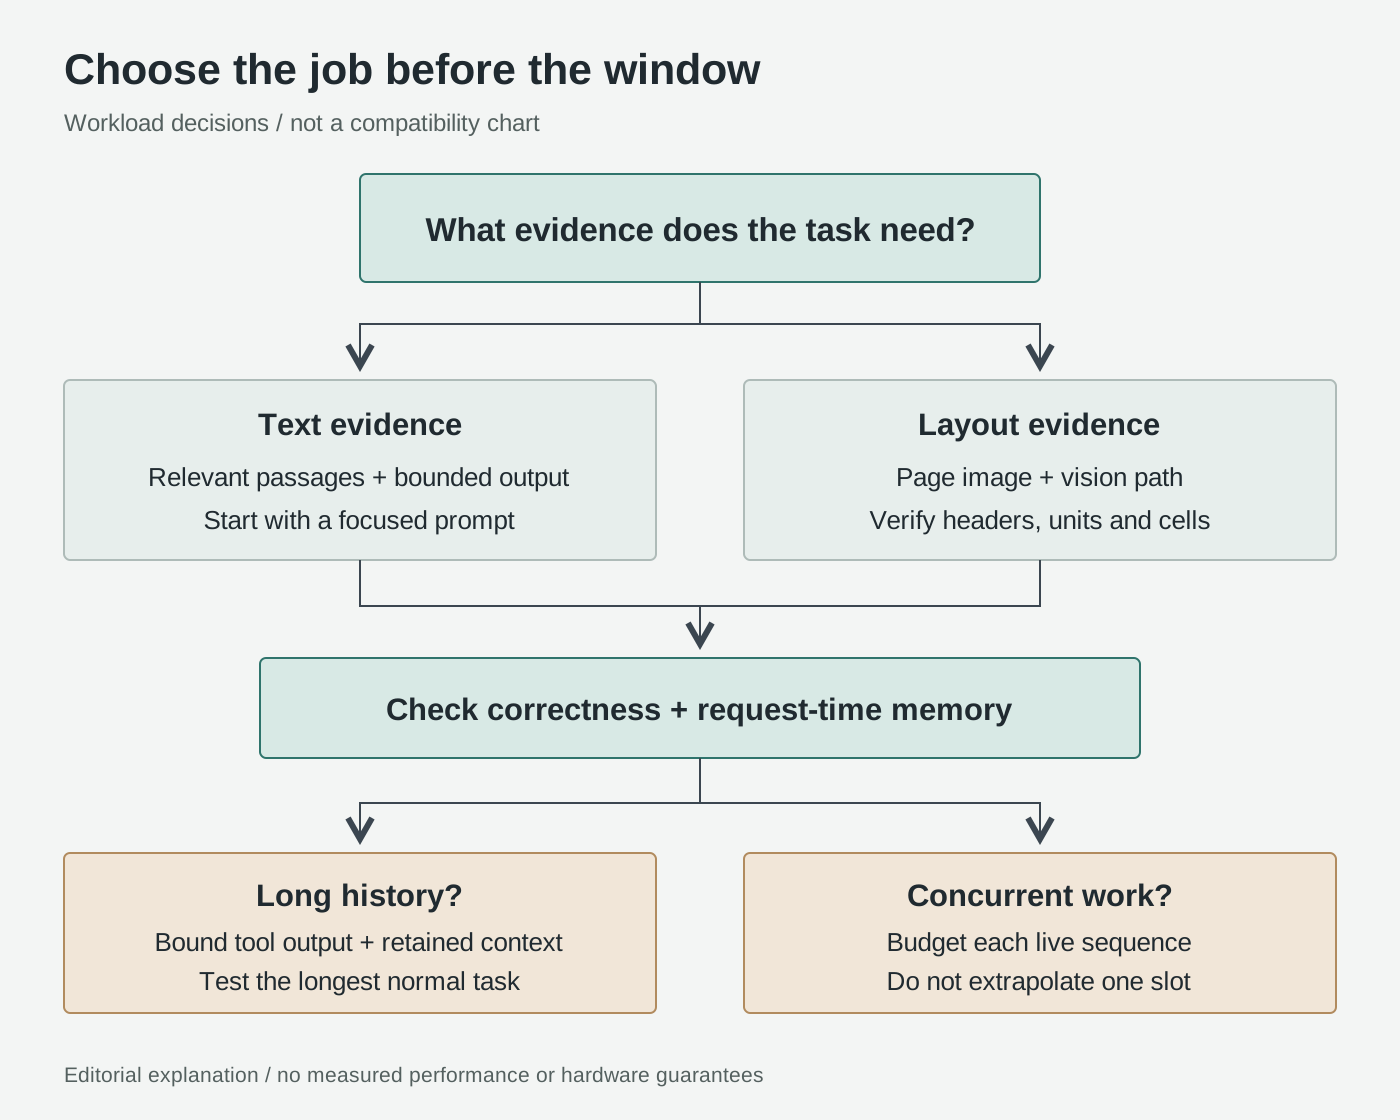
Oryginalne objaśnienie redakcyjne wyboru obciążenia, nie benchmark ani tabela zgodności. Zobacz strategie cache Hugging Face i obsługę multimodalną llama.cpp, sprawdzone 16 października 2026 r.
Skwantyzowane cache mogą zmniejszyć wymagania względem cache o wyższej precyzji, a przeniesienie danych poza GPU przesuwa obciążenie do innego poziomu pamięci i może wymienić przepustowość na pojemność. To ogólne kompromisy, a nie dowód, że każda strategia cache Transformers jest dostępna w tym wdrożeniu GGUF. Strategie cache Hugging Face, sprawdzone 16 października 2026 r..
Praktycznym priorytetem jest gęstość dowodów: zachowaj materiał potrzebny do odpowiedzi, oddzielnie przechowuj oryginały i usuwaj powtarzające się elementy pomocnicze. Zostaw też miejsce na odpowiedź. Większe skonfigurowane okno nie sprawia, że nieistotna historia staje się użyteczna.
Uruchom lokalnie, a potem przetestuj rzeczywiste obciążenie
Poniższy przykład Bash dla Linuksa dotyczy obsługiwanej konfiguracji z dyskretną kartą NVIDIA. Zakłada, że Git, Python, CMake, kompilator C++, zgodny sterownik NVIDIA i CUDA Toolkit są już zainstalowane. To procedura do wykonania na własnym komputerze, a nie opis zakończonej instalacji.
- Zbuduj odpowiednie środowisko i sprawdź jego opcje. Skorzystaj ze ścieżki budowania ze źródeł, nie z uniwersalnej komendy ze strony modelu. Postępuj zgodnie z przewodnikiem budowania CUDA llama.cpp, sprawdzonym 16 października 2026 r.. Zapisz commit i wersję pliku binarnego przy konfiguracji.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Sprawdź, czy pomoc zawiera draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn i --jinja. Sama etykieta wersji pakietu nie potwierdza obsługi. Jeśli plik binarny odrzuca te opcje, napraw niedopasowanie kompilacji przed pobraniem dużych checkpointów; nie zastępuj po cichu przepisu starymi flagami dekodowania spekulacyjnego. Nazwy opcji opisuje aktualna dokumentacja serwera, sprawdzona 16 października 2026 r..
- Pobierz trzy pliki z Szybkiego startu NVIDIA, sprawdzonego 16 października 2026 r.. Składnia pobierania jest zgodna z przewodnikiem Hugging Face CLI, sprawdzonym 16 października 2026 r.. Najpierw sprawdź wolne miejsce.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Zapisz rewizje repozytoriów i lokalne sumy kontrolne plików, zanim użyjesz tej konfiguracji jako punktu odniesienia. Późniejsza zmiana pliku lub środowiska powinna być świadoma, a nie stanowić niewyjaśnioną różnicę między dwoma uruchomieniami.
- Użyj przepisu NVIDIA 28GB z jawnym powiązaniem do loopback.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
W razie potrzeby użyj wolnego portu i odpowiednio zmień poniższe sprawdzenie. Nie konfiguruj przekierowania routera, publicznego tunelu ani nasłuchiwania na zewnętrznym interfejsie przy pierwszym uruchomieniu. Loopback ogranicza zasięg sieciowy, ale nie czyni narzędzi podłączonego agenta nieszkodliwymi.
- Sprawdź gotowość przed podłączeniem czegokolwiek innego. W drugim terminalu uruchom:
curl --fail http://127.0.0.1:8080/health
Serwer osobno dokumentuje stan ładowania i gotowość. Gdy będzie gotowy, otwórz lokalnie http://127.0.0.1:8080 i wypróbuj krótkie pytanie tekstowe przed żądaniem obrazu. Dokumentacja gotowości i interfejsu WWW serwera llama.cpp, sprawdzona 16 października 2026 r.. Do czasu sprawdzenia podstawowych odpowiedzi pozostaw narzędzia zewnętrzne odłączone.
- Zmierz całe zadanie przed jego rozszerzeniem. Na komputerze z dyskretnym GPU sprawdź pamięć przed uruchomieniem i podczas reprezentatywnych promptów:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
To obserwacje urządzenia, nie pełny szczytowy pomiar procesu ani metoda rozliczania pamięci zunifikowanej. NVIDIA opisuje zależne od platformy raportowanie pamięci w dokumentacji NVIDIA System Management Interface, sprawdzonej 16 października 2026 r.. Zachowaj też logi alokacji środowiska i osobno sprawdź pamięć hosta.
Porównaj krótki prompt, najdłuższy typowy prompt i reprezentatywny obraz dokumentu. Zapisz poprawność, czas wykonania, obserwacje pamięci oraz błędy alokacji. Powtórz test z otwartym zwykłym edytorem i przeglądarką. Konfiguracja działająca wyłącznie po zamknięciu reszty środowiska nie spełnia pierwotnego wymagania.
W razie awarii zmieniaj po jednym czynniku i nazwij nową konfigurację. Zmniejszenie kontekstu, microbatch size lub ilości historii narzędzi odpowiada na różne pytania; usunięcie draftera to kolejny eksperyment, a nie opublikowany przepis. Zachowaj awarię i wywołujące ją wejście, aby późniejszy sukces krótkiego promptu nie wymazał nierozwiązanego obciążenia.
Konkluzja: kupuj z myślą o zestawie roboczym
Ciekawą propozycją Bolt jest duży, rzadko aktywowany model skompresowany do lokalnej pracy. Jego praktyczna wartość zależy od tego, co zmieści się obok niego: dowody, obrazy, stan sekwencji i aplikacje potrzebne do ukończenia zadania.
Właściwe kryterium akceptacji nie brzmi „Czy model 24GB się załadował?”, lecz „Czy ten konkretny komputer wykona moje typowe zadanie, udzieli wiarygodnej odpowiedzi i pozostawi miejsce na kolejną turę?”. Taki budżet pamięci warto kupić.
Źródła
Informacje o premierze pochodzą z 15 października 2026 r.; karty modeli i aktualizowaną dokumentację sprawdzono 16 października 2026 r. Procedury to zaadaptowane instrukcje, a nie wyniki praktycznych testów. Oryginalne diagramy są schematami objaśniającymi, nie oficjalnymi materiałami ani wykresami wydajności.
- Ogłoszenie NVIDIA dotyczące trzech nazw modeli i terminów ich wydania.
- Przegląd badań NVIDIA Bolt oraz raport techniczny o kompresji, precyzji i szacunkowym zestawieniu pamięci.
- Karta modelu GGUF NVIDIA z tabelą sprzętu, nazwami checkpointów i przepisem uruchomienia.
- Dokumentacja budowania llama.cpp, serwera, multimodalności i narzędzi GGUF opisująca zachowanie środowiska.
- Wyjaśnienie cache Hugging Face, strategie cache, przewodnik CLI i referencja NVIDIA SMI o konkretnych mechanizmach i poleceniach diagnostycznych.
Opcjonalna rekomendacja Telli.sh: zachowaj źródła decyzji
Porównywanie agentów jest łatwiejsze, gdy oryginalne źródła, własne notatki i wyniki prób pozostają razem. Utwórz konto Telli.sh, aby uporządkować materiały i opracowania w bazę, do której można wrócić, gdy produkty się zmienią.