24GB 모델이 24GB 컴퓨터는 아니다: Nemotron Bolt의 메모리 예산
Nemotron Bolt의 총 74B 및 활성 9B 매개변수, 네이티브 2비트 가중치, 그리고 로컬 실행 레시피에 필요한 컨텍스트·비전·초안 모델·런타임 메모리를 알아봅니다.
GPU 메모리가 24GB입니다. 새 모델 이름에도 “24GB”가 들어 있습니다. 이 두 숫자면 구매 결정을 내리기에 충분할까요?
전체 로컬 AI 작업을 생각하면 그렇지 않습니다. NVIDIA는 10월 15일 네이티브 2비트 양자화를 사용해 로컬 배포할 수 있는 비전-언어 모델 Nemotron 3.5 Bolt 74B-A9B 24GB를 발표했습니다. 이름은 최적화 목표를 나타내며, 모든 컨텍스트 길이, 이미지 요청, 에이전트 구성이 24GB 그래픽 카드에 들어간다는 약속은 아닙니다. NVIDIA 발표, 2026년 10월 15일.
유용한 질문은 모델이 로드된 뒤 무엇이 남느냐입니다. 이 글에서는 저장되는 매개변수와 활성 계산을 구분하고, 다른 메모리 사용 요소를 설명하며, 실제 모델 카드의 레시피를 바탕으로 루프백 전용 설정을 안내합니다. 필요한 작업부터 정한 뒤 기기가 이를 지속적으로 처리할 수 있는지 판단하세요.
대표 이미지: 전체 작업의 예산을 설명하는 편집용 원본 도식으로, 공식 스크린샷이나 측정된 할당량이 아닙니다. 구성 요소의 크기는 표현하지 않습니다.
활성 매개변수가 적다고 다운로드가 9B가 되는 것은 아니다
Bolt는 총 74 billion 매개변수와 토큰당 약 9 billion 활성 매개변수를 갖습니다. 전문가 혼합 라우터가 저장된 네트워크의 일부를 선택합니다. 이 모델은 밀집형 9B 모델이 아니라 120B-A12B Super VL을 압축한 후속 모델입니다. NVIDIA Bolt 연구 개요, 2026년 10월 15일.
기억해 둘 차이는 이렇습니다. 활성 매개변수는 토큰을 계산할 때 수행하는 작업량을 설명하고, 전체 매개변수는 저장해야 하는 대상을 설명합니다. 어느 수치 하나만으로 애플리케이션 속도를 결정할 수는 없습니다. 배치, 메모리 대역폭, 커널, 입력 길이, 주변 애플리케이션이 모두 결과에 영향을 줍니다.
코드를 검토하는 에이전트도 직전 토큰에서 선택하지 않았던 전문가에 접근해야 합니다. 저장 장치, 시스템 메모리, GPU 메모리 사이에서 데이터를 옮기는 것은 가속기에 모든 것을 올려 두는 것과 같지 않습니다. 따라서 활성 수가 작다는 이유로 나머지 매개변수는 존재하지 않는 것처럼 하드웨어 요구량을 계산해도 된다는 뜻은 아닙니다.
모델 계열 이름도 정확히 비교해야 합니다.
| 모델 | 이름이 가리키는 것 | 10월 16일 기준 상태 |
|---|---|---|
| Nemotron 3.5 Super VL | 별도의 120B 모델 | 출시됨 |
| Nemotron 3.5 Bolt 74B-A9B 24GB | 여기서 다루는 압축형 로컬 모델 선택지 | 출시됨 |
| Nemotron 3.5 Bolt E4B 4GB | 별도의 더 작은 엣지/대화형 제품 | 10월 23일 출시 예정 |
출시 상태는 10월 15일 발표를 기준으로 합니다. 이 글의 날짜에는 E4B가 향후 출시 예정이며, 아래 명령으로 시연한 사용 가능한 대체 모델이 아닙니다. Super VL의 엔터프라이즈 배포 결과를 데스크톱 Bolt 결과로 해석해서도 안 됩니다.
네이티브 2비트 가중치는 예산의 한 부분만 해결한다
“네이티브 2비트”가 의미 있는 이유는 사용자가 나중에 더 작은 내보내기를 고르는 데 그치지 않고 모델 개발부터 공격적인 압축을 적용했기 때문입니다. NVIDIA는 정밀도를 낮춘 뒤 양자화 인식 증류로 성능을 보완합니다. 전문가 가중치에는 원소당 2.0625비트의 IQ2_XXS를 사용하고, 다른 구성 요소는 각기 다른 형식을 유지합니다. 네트워크는 혼합 정밀도이며 모든 부분이 일률적으로 2비트인 것은 아닙니다. NVIDIA의 압축 및 양자화 설명, 2026년 10월 15일.
의도적으로 비현실적인 산술 점검을 해보면, 740억 개 값을 정확히 2비트씩 저장할 경우 185억 바이트가 됩니다. 이는 설명을 위한 예시이지 Bolt의 파일 크기나 실행 요구량이 아닙니다. 실제 정밀도 혼합, 메타데이터, 실행 상태를 무시한 계산입니다. 제목의 매개변수 수에 제목의 비트 수를 곱하는 것만으로 특정 체크포인트를 확인할 수는 없습니다.
GGUF는 다른 질문에 답합니다. llama.cpp 생태계에서 사용하는 모델 파일 형식으로, 텐서와 관련 정보를 담습니다. “2비트” 위에 별도의 압축을 약속하는 형식이 아니며 GGUF를 내려받았다고 특정 런타임이 모델을 지원한다는 보장도 없습니다. llama.cpp GGUF 도구 문서, 2026년 10월 16일 확인.
NVIDIA의 자체 메모리 추정 내역은 차이를 구체적으로 보여줍니다. 표 2는 가중치에 22.01GB, 비전 제외 총량에 23.83GB, 비전 인코더와 프로젝터에 추가 1.68GB를 기재합니다. 이는 보고서 구성에 대한 공급업체의 추정치이지 이 글에서 측정한 메모리가 아닙니다. 같은 보고서는 배치 크기 1, 컨텍스트 128K에서 24GB 미만 설계 목표를 설명합니다. 10월 15일 연결된 Bolt 기술 보고서의 표 2 및 2.3절.
핵심은 브랜드 이름이 사실은 가중치만 가리킨다는 것이 아닙니다. 배포 목표에는 전제 조건이 있다는 점입니다. 그 조건을 바꾸면 메모리 요구량도 달라집니다.
가중치만이 아니라 전체 작업 집합의 용량을 계산하자
배포 환경에 저장된 모델 외에 더해지는 컨텍스트 비용을 생각해 보세요. 시스템에 유지하고 처리하라고 요청한 작업도 공간을 차지합니다. 계획을 세울 때는 가중치, 시퀀스 상태, 비전 처리, 추측 디코딩, 런타임 작업 공간을 구분하세요. 실제로 열어 둘 데스크톱과 애플리케이션을 위해 여유 공간도 남겨 두세요.
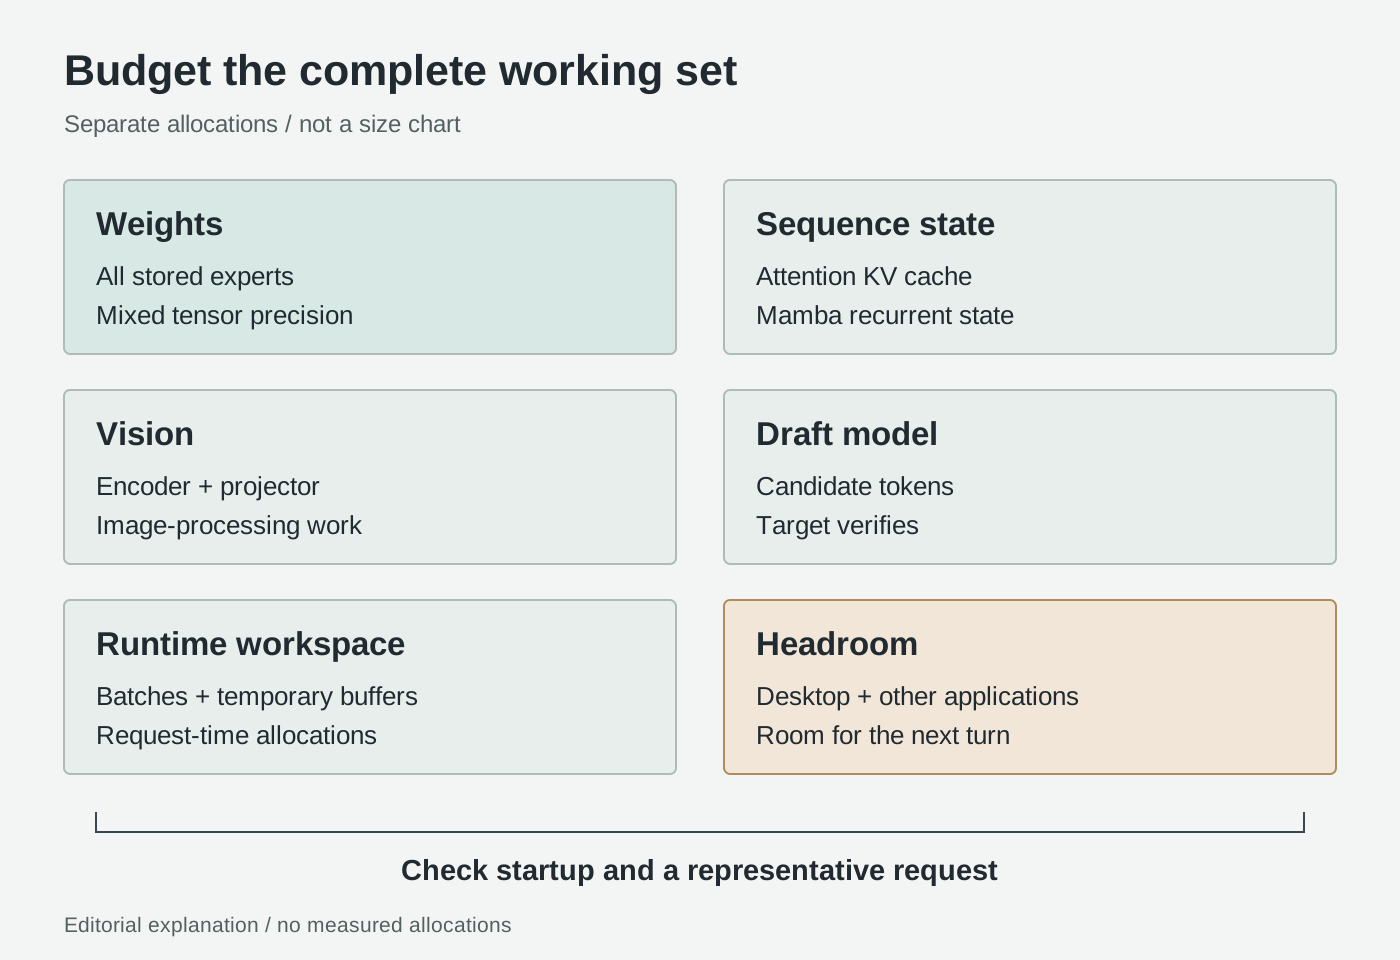
실측 비율이 아닌 개념 설명용 원본 도식입니다. 메커니즘 출처: Hugging Face 캐싱 문서, llama.cpp 멀티모달 안내, NVIDIA Bolt 보고서, 2026년 10월 16일 확인.
시퀀스 상태는 가중치의 복사본이 아닙니다. 자기회귀 어텐션 모델은 생성 중 앞선 토큰을 재사용할 수 있도록 키와 값을 캐시에 저장합니다. 더 긴 시퀀스를 유지하면 어텐션 캐시 저장 공간이 늘어나며, 세부 사항은 아키텍처와 캐시 표현 방식에 따라 다릅니다. Hugging Face, “캐싱 작동 방식”, 2026년 10월 16일 확인.
Bolt는 Mamba와 어텐션 레이어를 결합한 하이브리드이므로, 일반적인 전체 Transformer 캐시 추정만으로는 완전한 계산이 되지 않습니다. 순환 상태와 어텐션 캐시는 별도로 할당됩니다. 런타임이 실제로 무엇을 만드는지 확인하세요. 아키텍처 차이는 2026년 10월 16일 확인한 Bolt 보고서 표 1에 설명되어 있습니다.
에이전트에서 유지되는 컨텍스트는 사용자가 입력한 질문만 뜻하지 않습니다. 시스템 지침, 도구 스키마, 대화 기록, 검색된 구절, 도구 응답도 모두 답변 공간을 두고 경쟁합니다. 저장소 목록이 반복되는 대화 기록은 유용한 증거를 추가하지 않으면서 쓸 만한 예산을 소진할 수 있습니다. 간결한 작업 상태를 유지하는 것은 하드웨어 편법만이 아니라 워크플로 선택입니다.
비전에는 별도의 처리 경로가 필요합니다. llama.cpp는 --mmproj를 통해 언어 모델과 멀티모달 프로젝터 파일을 함께 사용합니다. 문서에 따르면 이 구성 요소는 기본적으로 GPU 오프로딩됩니다. llama.cpp 멀티모달 안내, 2026년 10월 16일 확인. 따라서 언어 모델 파일만 로드하는 것은 이미지 처리 구성을 완성하는 것과 다릅니다.
문서 작업에서는 추출한 텍스트를 읽는 일과 렌더링된 페이지를 해석하는 일을 구분하세요. 일반 텍스트 문단에는 열 제목과 셀 사이의 시각적 관계가 담겨 있지 않습니다. 반대로 페이지 레이아웃이 중요하지 않은데 이미지로 보내면 답변을 개선하지 못한 채 처리량만 늘어납니다. 질문에 필요한 증거를 어떤 표현이 가장 잘 보존하는지 정하세요.
추측 생성 초안기는 추가 모델입니다. Bolt의 LiLiCorr 초안기는 대상 모델이 확인하도록 후보 토큰을 제안합니다. 디코딩 속도 향상을 목표로 하지만 추가 체크포인트와 실행 상태에도 메모리가 필요합니다. NVIDIA의 LiLiCorr 설명, 2026년 10월 15일. 초안기가 있다고 해서 사용자의 작업이 반드시 더 빨리 완료되는 것은 아닙니다.
런타임 작업 공간도 별도입니다. 프롬프트 처리 배치와 임시 계산 버퍼도 지속 상태와 함께 예산에 포함해야 합니다. 서버에는 논리 배치 크기와 물리 마이크로배치 크기가 따로 노출되며, 어느 쪽도 동시 대화 수와 같지 않습니다. llama.cpp 서버 옵션 참고 문서, 2026년 10월 16일 확인. 설정이 시작되더라도 대표 요청으로 시험해야 합니다.
제품 이름보다 공식 하드웨어 표를 먼저 보자
NVIDIA가 공개한 구성은 다음과 같습니다.
| 레시피 | 하드웨어 | 컨텍스트 | 시퀀스 |
|---|---|---|---|
| 28GB | RTX Spark 64GB 또는 개별 RTX 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB 또는 개별 RTX 48GB+ | 262,144 | 1 |
출처: NVIDIA Quick Start, 2026년 10월 16일 확인.
이 행들은 개별 24GB GPU를 다루지 않으며 Mac 지원을 입증하지도 않습니다. 호스트 RAM은 개별 GPU 메모리에 추가되는 VRAM이 아닙니다.
저희의 관점은 성공적으로 로드된 스크린샷이 아니라 재현 가능한 구성을 고르는 것입니다. 구매 여부가 이 모델에 달려 있다면 실제로 사용할 입력과 평소 실행하는 백그라운드 앱을 포함한 시연을 요구하세요. 첫 요청보다 나중 요청이 더 커질 수 있는 문서 이미지와 장시간 에이전트에서는 특히 중요합니다.
최대치가 아니라 작업에 맞춰 컨텍스트를 정하자
다음은 보고된 시험 결과가 아니라 시작점으로 삼을 만한 세 가지 예시입니다.
개발자가 실패한 테스트를 설명해 달라며 오류, 관련 함수, 인접한 종속성 하나를 제공합니다. 유용한 결과는 특정 행에 근거한 진단과 수정 제안입니다. 저장소 전체를 추가하기 전에 실제로 부족한 정보가 특정 인터페이스인지 다른 스택 프레임인지 확인하세요. 질문의 범위를 점검 가능하게 유지하면 잘못된 가정을 더 쉽게 발견할 수 있습니다.
연구자가 문서 두 페이지의 표를 비교합니다. 이때 확인할 것은 모델이 머리글, 단위, 각주, 값을 올바르게 연결하는지입니다. 관계가 중요하다면 실제 페이지 이미지를 사용하고 페이지별 근거를 요청한 뒤 일부 셀을 원본과 대조하세요. 두 열의 값을 바꿔 놓은 유창한 요약은 빨리 나와도 실패한 결과입니다.
로컬 보조 도구가 승인된 폴더를 검색하고 보고서 초안을 작성합니다. 검색 결과와 반복되는 도구 응답 때문에 메모리 압박이 커질 수 있습니다. 먼저 읽기 전용 작업을 주고 검색 범위를 제한하며 각 결론을 뒷받침하는 파일을 명시하게 하세요. 모델이 쓸 만한 계획을 내는지 보려고 쓰기나 셸 권한까지 허용하지 마세요.
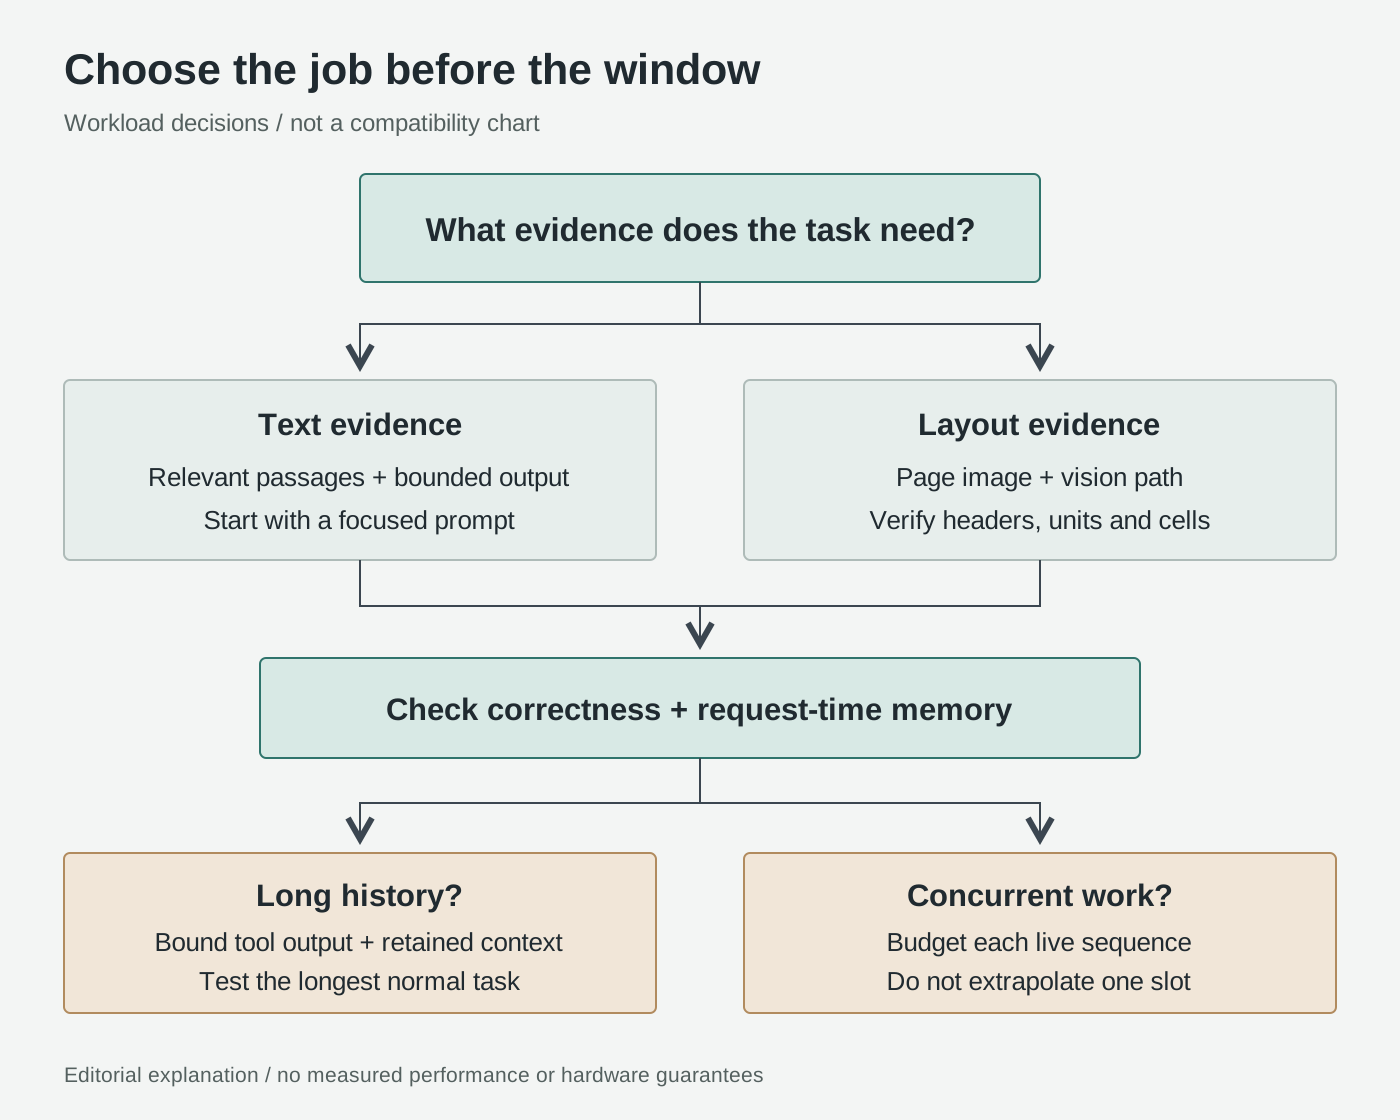
워크로드 선택을 설명하는 원본 도식이며 벤치마크나 호환성 표가 아닙니다. Hugging Face 캐시 전략 및 llama.cpp 멀티모달 처리를 참조하세요. 2026년 10월 16일 확인.
양자화 캐시는 높은 정밀도의 캐시보다 저장 공간을 줄일 수 있고, 오프로딩은 압박을 다른 메모리 계층으로 옮겨 처리량과 용량 사이의 절충을 만들 수 있습니다. 이는 일반적인 절충 관계이지 Transformers의 모든 캐시 전략을 이 GGUF 배포에서 사용할 수 있다는 증거는 아닙니다. Hugging Face 캐시 전략, 2026년 10월 16일 확인.
실용적인 우선순위는 증거 밀도입니다. 질문에 답하는 데 필요한 자료를 유지하고 원본을 별도로 보존하며 반복되는 틀은 덜어내세요. 답변을 위한 공간도 남겨 두세요. 설정한 창이 더 크다고 해서 관련 없는 기록이 유용해지는 것은 아닙니다.
로컬에서 시작한 뒤 필요한 실제 워크로드를 시험하자
아래 Linux Bash 예시는 지원되는 NVIDIA 개별 GPU 구성을 대상으로 합니다. Git, Python, CMake, C++ 툴체인, 호환 NVIDIA 드라이버와 CUDA 툴킷이 이미 설치되어 있다고 가정합니다. 완료된 설치를 보고하는 것이 아니라 사용자의 기기에서 실행할 절차입니다.
- 관련 런타임을 빌드하고 옵션을 확인합니다. 모델 페이지의 일반적인 한 줄 명령 대신 소스 빌드 경로를 사용하세요. llama.cpp CUDA 빌드 안내, 2026년 10월 16일 확인를 따르세요. 보고된 커밋과 바이너리 버전을 구성 정보와 함께 보관합니다.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
도움말에 draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn, --jinja가 포함되는지 확인하세요. 패키지 버전 표시만으로 지원 여부를 입증할 수 없습니다. 바이너리가 옵션을 거부한다면 큰 체크포인트를 내려받기 전에 빌드 불일치를 해결하세요. 예전 추측 디코딩 옵션으로 레시피를 조용히 대체하지 마세요. 옵션 이름은 현재 서버 참고 문서, 2026년 10월 16일 확인에 나와 있습니다.
- NVIDIA Quick Start, 2026년 10월 16일 확인에 나온 세 파일을 내려받습니다. 다운로드 구문은 Hugging Face CLI 안내, 2026년 10월 16일 확인을 따릅니다. 먼저 디스크 공간을 확인하세요.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
이 설정을 비교 기준으로 삼기 전에 저장소 리비전과 로컬 파일 해시를 기록하세요. 이후 파일이나 런타임 업데이트는 두 실행 사이에 이유를 알 수 없는 차이가 생기지 않도록 의도적으로 적용해야 합니다.
- 명시적으로 루프백에 바인딩하는 NVIDIA 28GB 레시피를 사용합니다.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
필요하면 사용하지 않는 포트를 선택하고 아래 확인 명령도 같은 포트로 바꾸세요. 첫 실행을 위해 라우터 포트 전달 규칙, 공개 터널, 외부 바인딩 리스너를 만들지 마세요. 루프백은 네트워크 접근을 제한하지만 연결된 에이전트의 도구까지 무해하게 만들지는 않습니다.
- 다른 것을 연결하기 전에 준비 상태를 확인합니다. 다른 터미널에서 실행합니다.
curl --fail http://127.0.0.1:8080/health
서버 문서는 로딩 응답과 준비 완료 응답을 따로 설명합니다. 준비가 끝나면 로컬에서 http://127.0.0.1:8080을 열고 이미지 요청보다 짧은 텍스트 질문부터 시도하세요. llama.cpp 서버 상태 확인 및 웹 인터페이스 문서, 2026년 10월 16일 확인. 기본 응답이 동작할 때까지 외부 도구 연결은 끊어 두세요.
- 작업 범위를 넓히기 전에 전체 작업을 측정합니다. 개별 GPU 시스템에서는 실행 전과 대표 프롬프트 처리 중 메모리를 확인합니다.
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
이 값은 기기 관측치이지 프로세스 최대치 전체나 통합 메모리 계산 방식이 아닙니다. NVIDIA는 NVIDIA System Management Interface 참고 문서, 2026년 10월 16일 확인에서 플랫폼별 메모리 보고 차이를 설명합니다. 런타임 할당 로그도 보관하고 호스트 메모리도 별도로 확인하세요.
짧은 프롬프트, 평소 사용하는 가장 긴 프롬프트, 대표 문서 이미지를 비교하세요. 정확도, 완료 시간, 메모리 관측값, 할당 실패를 기록합니다. 평소 사용하는 편집기와 브라우저를 연 상태에서도 반복하세요. 나머지 작업 환경을 닫아야만 되는 설정은 원래 요구 사항을 충족하지 못합니다.
실패하면 한 번에 한 요소만 바꾸고 새 구성을 명시하세요. 컨텍스트, 마이크로배치 크기, 도구 기록량을 줄이는 것은 각각 다른 질문에 답합니다. 초안기를 제거하는 것도 공개 레시피가 아닌 별도의 실험입니다. 실패와 그 원인이 된 입력을 보존해 나중에 짧은 프롬프트가 성공했다고 해결되지 않은 워크로드를 잊지 않도록 하세요.
결론: 작업 집합에 맞춰 구매하자
Bolt의 흥미로운 점은 로컬 작업을 위해 압축한 대형 희소 활성 모델이라는 제안입니다. 실제 가치는 작업을 끝내는 데 필요한 증거, 시각 입력, 시퀀스 상태, 애플리케이션이 함께 들어가는지에 달려 있습니다.
인수 기준은 “24GB 모델이 로드됐나?”가 아닙니다. “이 정확한 기기가 믿을 만한 답을 내고 다음 차례를 위한 여유도 남기면서 내 평소 워크로드를 끝낼 수 있나?”입니다. 구매할 가치가 있는 메모리 예산은 그것입니다.
출처
출시 정보는 2026년 10월 15일 기준이며, 연결된 모델 카드와 변경될 수 있는 문서는 2026년 10월 16일 확인했습니다. 절차는 적용 가능한 안내를 옮긴 것으로 직접 설치 시험 결과가 아닙니다. 원본 도식은 설명용이며 공식 자료나 성능 그래프가 아닙니다.
- 세 모델 이름과 출시 시점은 NVIDIA 출시 발표를 참조하세요.
- 압축, 정밀도, 추정 메모리 내역은 NVIDIA Bolt 연구 개요와 기술 보고서를 참조하세요.
- 실제 하드웨어 표, 체크포인트 파일 이름, 실행 레시피는 NVIDIA GGUF 모델 카드를 참조하세요.
- 런타임 동작은 llama.cpp 빌드, 서버, 멀티모달, GGUF 도구 문서를 참조하세요.
- 구체적인 메커니즘과 확인 명령은 Hugging Face 캐시 설명, 캐시 전략, CLI 안내, NVIDIA SMI 참고 문서를 참조하세요.
판단 근거가 된 자료를 보관하는 또 하나의 방법, Telli.sh
에이전트를 비교할 때 원본 출처, 메모, 직접 시험한 결과를 함께 보관하면 편리합니다. Telli.sh 계정 만들기로 자료를 정리해 제품이 바뀌어도 다시 참고할 수 있습니다.