Un modello da 24GB non è un computer da 24GB: il budget di memoria di Nemotron Bolt
Scopri i 74B parametri totali e i 9B attivi di Nemotron Bolt, i pesi nativi a 2 bit e la memoria richiesta dalle ricette locali per contesto, visione, modello draft e runtime.
Hai una GPU con 24GB di memoria. Un nuovo modello ha «24GB» nel nome. Davvero questi due numeri bastano per decidere l'acquisto?
Non per un carico di lavoro IA locale completo. L'annuncio di NVIDIA del 15 ottobre ha presentato Nemotron 3.5 Bolt 74B-A9B 24GB come modello visivo-linguistico distribuibile localmente che usa quantizzazione nativa a 2 bit. Il nome descrive un obiettivo di ottimizzazione, non promette che qualsiasi lunghezza di contesto, richiesta con immagini e configurazione agent rientri in una scheda grafica da 24GB. Annuncio NVIDIA, 15 ottobre 2026.
La domanda utile è cosa rimane dopo il caricamento del modello. Questa guida distingue i parametri archiviati dal calcolo attivo, spiega gli altri consumi di memoria e illustra una configurazione solo loopback basata sulla ricetta effettiva della scheda del modello. Parti dal carico che ti serve, poi decidi se la macchina può sostenerlo.
Hero: spiegazione editoriale originale di un budget per l'intero carico, non screenshot ufficiale né allocazione misurata. Le dimensioni dei componenti non sono rappresentate.
Il conteggio attivo più piccolo non fa di questo un download da 9B
Bolt ha 74 miliardi di parametri totali e circa 9 miliardi attivi per token. Il router mixture-of-experts seleziona una parte della rete archiviata. È un discendente compresso di Super VL 120B-A12B, non un modello denso da 9B. Panoramica di ricerca NVIDIA su Bolt, 15 ottobre 2026.
La distinzione da tenere a mente è questa: i parametri attivi aiutano a spiegare il lavoro svolto per un token; i parametri totali aiutano a spiegare cosa va archiviato. Nessuno dei due numeri, da solo, determina la velocità dell'applicazione. Posizionamento, banda di memoria, kernel, lunghezza dell'input e applicazione circostante influiscono tutti sul risultato.
Un agent che revisiona codice ha comunque bisogno di accedere agli esperti non selezionati per il token precedente. Spostare dati tra archiviazione, memoria di sistema e memoria GPU non equivale ad avere tutto disponibile sull'acceleratore. Un conteggio attivo più piccolo non autorizza quindi a calcolare il requisito hardware come se i parametri restanti non esistessero.
Anche i nomi della famiglia meritano un confronto preciso:
| Modello | A cosa si riferisce il nome | Stato al 16 ottobre |
|---|---|---|
| Nemotron 3.5 Super VL | Il modello distinto da 120B | Rilasciato |
| Nemotron 3.5 Bolt 74B-A9B 24GB | L'opzione di modello locale compresso discussa qui | Rilasciato |
| Nemotron 3.5 Bolt E4B 4GB | Un'offerta distinta e più piccola per edge/conversazione | Annunciato per il 23 ottobre |
Gli stati di rilascio provengono dall'annuncio del 15 ottobre. E4B sarà disponibile in futuro alla data di questo articolo: non è un sostituto già disponibile dimostrato da questi comandi. Né i risultati di distribuzione enterprise di Super VL vanno interpretati come risultati desktop di Bolt.
I pesi nativi a 2 bit risolvono solo una parte del budget
«Nativo a 2 bit» è significativo perché la compressione aggressiva fa parte dello sviluppo del modello, non è soltanto una scelta dell'utente che esporta in seguito una versione più piccola. NVIDIA usa distillazione con consapevolezza della quantizzazione per recuperare capacità dopo aver ridotto la precisione. I pesi degli esperti usano IQ2_XXS a 2.0625 bit per elemento, mentre altri componenti mantengono formati diversi. La rete è a precisione mista, non uniformemente a due bit. Spiegazione NVIDIA su compressione e quantizzazione, 15 ottobre 2026.
Come esercizio aritmetico volutamente irrealistico, 74 miliardi di valori archiviati esattamente a due bit occuperebbero 18.5 miliardi di byte. È un'illustrazione, non la dimensione del file Bolt o il requisito di avvio: ignora la miscela effettiva di precisioni, i metadati e lo stato di esecuzione. Moltiplicare il numero di parametri del titolo per la profondità in bit del titolo non sostituisce l'ispezione di un checkpoint specifico.
GGUF risponde a un'altra domanda. È il formato file del modello usato dall'ecosistema llama.cpp e contiene tensori e informazioni associate. Non è una seconda promessa di compressione aggiunta a «2 bit», e scaricare un GGUF non dimostra di per sé che un runtime specifico capisca il modello. Documentazione degli strumenti GGUF di llama.cpp, consultata il 16 ottobre 2026.
La stima della memoria di NVIDIA rende concreta la distinzione: la Tabella 2 indica 22.01GB per i pesi, 23.83GB complessivi esclusa la visione e altri 1.68GB per encoder e proiettore visivi. Sono stime del fornitore per la configurazione del rapporto, non misurazioni di memoria svolte per questo articolo. Lo stesso rapporto descrive un obiettivo progettuale inferiore a 24GB con batch size uno e contesto 128K. Rapporto tecnico Bolt, Tabella 2 e Sezione 2.3, collegato il 15 ottobre 2026.
La conclusione non è che il branding nasconda una misura riferita solo ai pesi. È che un obiettivo di distribuzione presuppone determinate condizioni. Cambiando tali condizioni, cambia anche il requisito di memoria.
Prevedi l'intero working set, non solo i pesi
Considera la distribuzione come una tassa di contesto che si aggiunge al modello archiviato: anche il lavoro che chiedi al sistema di conservare ed elaborare richiede spazio. Per la pianificazione, separa pesi, stato delle sequenze, elaborazione visiva, decodifica speculativa e spazio di lavoro del runtime. Lascia ulteriore margine per il desktop e per le applicazioni che intendi tenere aperte.
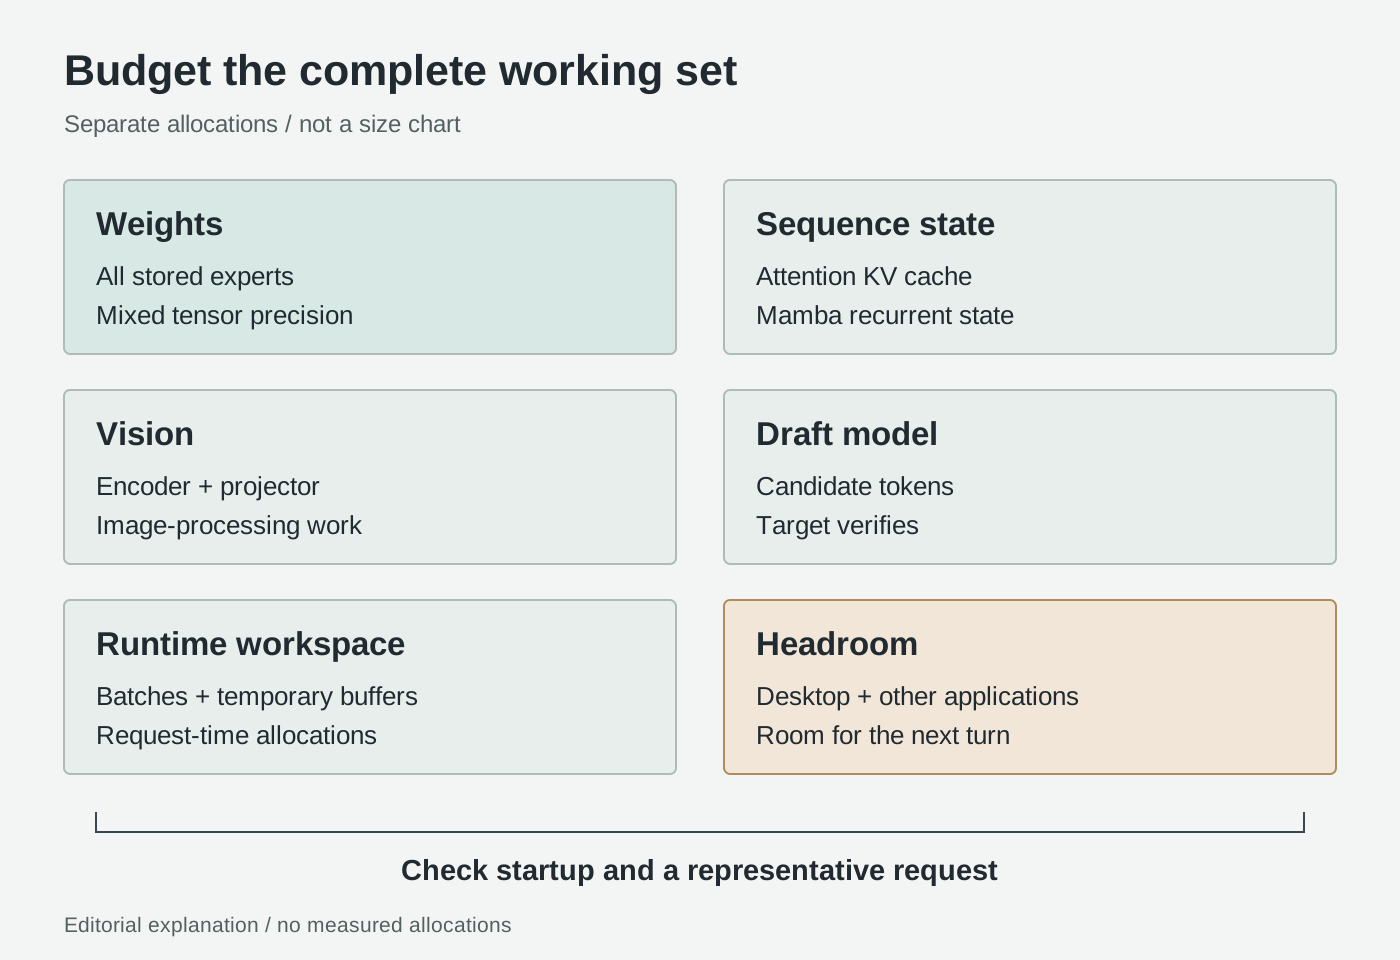
Spiegazione editoriale originale, non proporzioni misurate. Meccanismi: documentazione cache di Hugging Face, guida multimodale llama.cpp e rapporto Bolt di NVIDIA, consultati il 16 ottobre 2026.
Lo stato delle sequenze non è un'altra copia dei pesi. Un modello autoregressivo con attenzione memorizza chiavi e valori dei token precedenti, così da riutilizzarli durante la generazione. Sequenze conservate più lunghe richiedono più spazio per la cache di attenzione; i dettagli dipendono dall'architettura e dalla rappresentazione della cache. Hugging Face, «Come funziona la cache», consultato il 16 ottobre 2026.
Bolt è un ibrido con livelli Mamba e di attenzione, quindi una stima generica della cache per un modello interamente Transformer non basta a calcolarla. Stato ricorrente e cache di attenzione sono allocazioni distinte: verifica cosa crea davvero il runtime. La distinzione architetturale è documentata nella Tabella 1 del rapporto Bolt, consultata il 16 ottobre 2026.
Per un agent, il contesto conservato è più della domanda che hai digitato. Istruzioni di sistema, schemi degli strumenti, cronologia della conversazione, passaggi recuperati e risposte degli strumenti competono tutti con lo spazio per la risposta. Una trascrizione con elenchi ripetuti del repository può esaurire un budget utile senza aggiungere prove utili. Mantenere conciso lo stato dell'attività è una decisione sul flusso di lavoro, non solo un espediente hardware.
La visione introduce un percorso di elaborazione separato. llama.cpp abbina il modello linguistico a un file di proiettore multimodale tramite --mmproj; la documentazione dice che questo componente viene scaricato sulla GPU per impostazione predefinita. Guida multimodale llama.cpp, consultata il 16 ottobre 2026. Caricare soltanto il file del modello linguistico non equivale quindi a una configurazione completa capace di elaborare immagini.
Per un'attività su documenti, distingui tra la lettura del testo estratto e l'interpretazione di una pagina renderizzata. Un paragrafo di testo semplice non contiene il rapporto visivo tra l'intestazione di una colonna e le sue celle. Viceversa, inviare immagini di pagine in cui l'impaginazione non conta aggiunge lavoro senza necessariamente migliorare la risposta. Decidi quale rappresentazione conserva le prove necessarie per la tua domanda.
Un modello draft speculativo è un modello aggiuntivo. Il draft LiLiCorr di Bolt propone token candidati che il modello obiettivo verifica. È pensato per accelerare la decodifica, ma anche il checkpoint aggiuntivo e il suo stato di esecuzione richiedono memoria. Spiegazione NVIDIA di LiLiCorr, 15 ottobre 2026. La presenza di un draft non garantisce che le tue attività terminino più in fretta.
Anche lo spazio di lavoro del runtime va conteggiato separatamente. I batch di elaborazione dei prompt e i buffer temporanei di calcolo fanno parte del budget insieme allo stato persistente. Il server espone sia la dimensione logica del batch sia quella del microbatch fisico: non sono intercambiabili con il numero di conversazioni simultanee. Riferimento alle opzioni del server llama.cpp, consultato il 16 ottobre 2026. Una configurazione che si avvia correttamente va comunque testata durante una richiesta rappresentativa.
La tabella hardware ufficiale è più utile del suffisso del prodotto
Configurazioni pubblicate da NVIDIA:
| Ricetta | Hardware | Contesto | Sequenze |
|---|---|---|---|
| 28GB | RTX Spark 64GB o RTX discreta da 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB o RTX discreta da 48GB+ | 262,144 | 1 |
Fonte: Guida rapida NVIDIA, consultata il 16 ottobre 2026.
Queste righe non coprono una GPU discreta da 24GB e non dimostrano il supporto Mac. La RAM host non è VRAM discreta aggiuntiva.
Il nostro punto di vista: scegli una configurazione ripetibile, non uno screenshot del caricamento riuscito. Se un acquisto dipende da questo modello, chiedi una dimostrazione con i tuoi input e le normali applicazioni in background. È particolarmente importante per immagini di documenti e agent di lunga durata, le cui prime richieste possono essere molto più piccole di quelle successive.
Scegli il contesto in base all'attività, non al massimo
Considera tre attività illustrative per iniziare, non test riportati.
Uno sviluppatore chiede di spiegare un test non riuscito, fornendo l'errore, la funzione pertinente e una dipendenza vicina. L'output utile è una diagnosi collegata a righe specifiche, seguita da una modifica proposta. Prima di aggiungere l'intero repository, verifica se manca una specifica interfaccia o un altro frame dello stack. Così la domanda resta ispezionabile ed è più facile individuare supposizioni errate.
Un ricercatore confronta una tabella su due pagine di un documento. Il test consiste nel verificare se il modello associa correttamente intestazioni, unità, note a piè di pagina e valori. Usa le immagini effettive delle pagine quando contano i rapporti visivi, chiedi prove riferite alle singole pagine e verifica un campione di celle sull'originale. Un riepilogo fluente che scambia due colonne è un risultato fallito, anche se arriva rapidamente.
Un assistente locale cerca in una cartella autorizzata e prepara una bozza di rapporto. La pressione sulla memoria può crescere con il materiale recuperato e le risposte ripetute degli strumenti. Assegnagli prima un'attività in sola lettura, limita la ricerca e chiedigli di indicare i file che supportano ogni conclusione. Non concedere permessi di scrittura o shell solo per vedere se il modello sa produrre un piano utile.
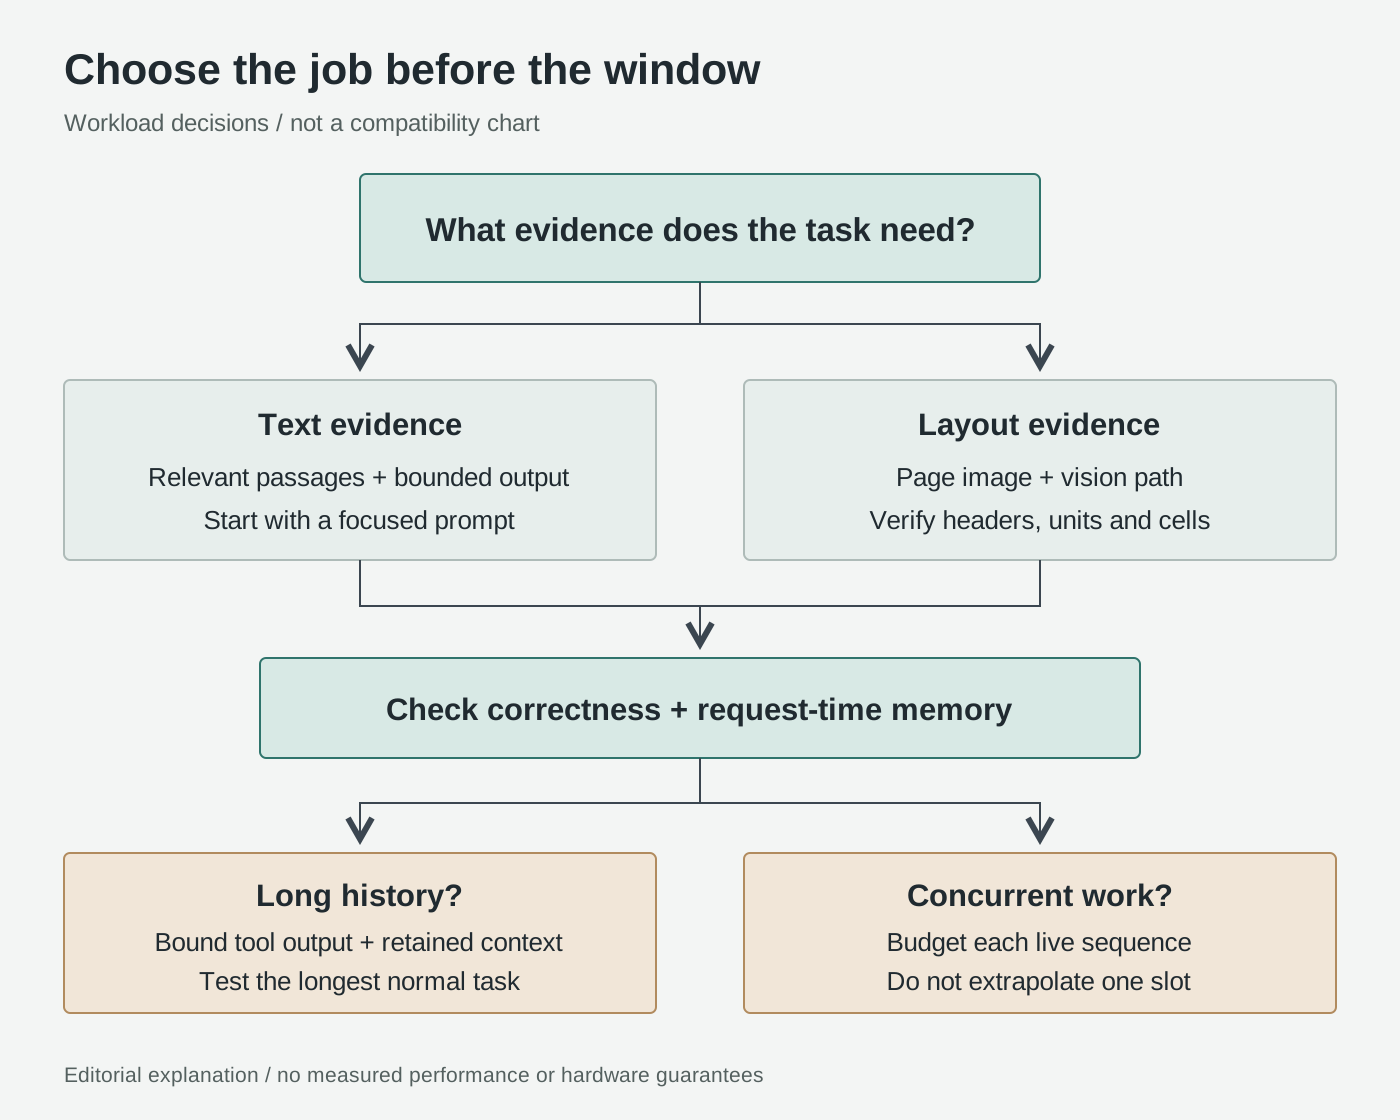
Spiegazione editoriale originale della scelta del carico, non benchmark né tabella di compatibilità. Vedi le strategie di cache di Hugging Face e la gestione multimodale llama.cpp, consultate il 16 ottobre 2026.
Le cache quantizzate possono ridurre lo spazio rispetto a cache a precisione più alta, mentre l'offloading sposta la pressione su un altro livello di memoria e può scambiare throughput con capacità. Sono compromessi generali, non prove che ogni strategia di cache in Transformers sia disponibile per questa distribuzione GGUF. Strategie di cache Hugging Face, consultate il 16 ottobre 2026.
La priorità pratica è la densità delle prove: conserva il materiale necessario per rispondere alla domanda, preserva gli originali a parte e rimuovi gli elementi ripetitivi di contorno. Riserva spazio anche alla risposta. Una finestra configurata più ampia non rende utile una cronologia irrilevante.
Inizia in locale, poi prova il carico che ti serve davvero
L'esempio Bash Linux qui sotto è destinato a una configurazione supportata con GPU NVIDIA discreta. Presuppone che Git, Python, CMake, una toolchain C++, un driver NVIDIA compatibile e il toolkit CUDA siano già installati. È una procedura da eseguire sulla tua macchina, non il resoconto di un'installazione completata.
- Compila il runtime pertinente e controllane le opzioni. Usa il percorso di compilazione dai sorgenti, non una riga generica copiata dalla pagina del modello. Segui la guida di compilazione CUDA di llama.cpp, consultata il 16 ottobre 2026. Conserva il commit e la versione del binario riportati nella tua configurazione.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Verifica che l'help includa draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn e --jinja. La sola etichetta della versione di un pacchetto non dimostra il supporto. Se il binario rifiuta le opzioni, risolvi la discrepanza di compilazione prima di scaricare checkpoint grandi; non sostituire silenziosamente la ricetta con vecchi flag di decodifica speculativa. I nomi delle opzioni sono documentati nel riferimento corrente al server, consultato il 16 ottobre 2026.
- Scarica i tre file della Guida rapida NVIDIA, consultata il 16 ottobre 2026. La sintassi di download segue la guida CLI di Hugging Face, consultata il 16 ottobre 2026. Controlla prima lo spazio sul disco.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Registra le revisioni dei repository e gli hash dei file locali prima di usare questa configurazione come base di confronto. Un aggiornamento successivo del file o del runtime dovrebbe essere una modifica deliberata, non una differenza inspiegata tra due esecuzioni.
- Usa la ricetta NVIDIA da 28GB con binding esplicito su loopback.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Se serve, usa una porta libera e modifica di conseguenza il controllo qui sotto. Per questa prima esecuzione non creare regole di inoltro del router, tunnel pubblici o listener esposti all'esterno. Il loopback limita la portata di rete, ma non rende innocui gli strumenti di un agent collegato.
- Controlla la disponibilità prima di collegare qualsiasi altra cosa. In un altro terminale, esegui:
curl --fail http://127.0.0.1:8080/health
La documentazione del server distingue la risposta di caricamento dalla disponibilità. Quando è pronto, apri http://127.0.0.1:8080 in locale e prova una breve domanda testuale prima di una richiesta con immagini. Documentazione sulla verifica dello stato e sull'interfaccia web del server llama.cpp, consultata il 16 ottobre 2026. Tieni scollegati gli strumenti esterni finché le risposte di base non funzionano.
- Misura l'intera attività prima di ampliarla. Su un sistema con GPU discreta, controlla la memoria prima dell'avvio e durante prompt rappresentativi:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Sono osservazioni del dispositivo, non il picco completo del processo né un metodo di contabilizzazione della memoria unificata. NVIDIA documenta il reporting della memoria dipendente dalla piattaforma nel riferimento NVIDIA System Management Interface, consultato il 16 ottobre 2026. Conserva anche i log di allocazione del runtime e controlla separatamente la memoria host.
Confronta un prompt breve, il più lungo tra quelli che usi normalmente e un'immagine documentale rappresentativa. Registra correttezza, tempo totale, osservazioni sulla memoria ed eventuali errori di allocazione. Ripeti con editor e browser abituali aperti. Una configurazione che funziona solo dopo aver chiuso il resto dell'ambiente di lavoro non soddisfa il requisito iniziale.
Se non funziona, cambia un fattore alla volta e assegna un nome alla nuova configurazione. Ridurre il contesto, la dimensione del microbatch o il volume della cronologia degli strumenti risponde a domande diverse; rimuovere il draft è un altro esperimento, non la ricetta pubblicata. Conserva l'errore e l'input che lo ha causato affinché una successiva richiesta breve riuscita non cancelli il carico irrisolto.
In sintesi: acquista in base al working set
La proposta interessante di Bolt è un modello grande e attivato in modo sparso, compresso per il lavoro locale. Il valore pratico dipende da cosa ci sta insieme: prove, input visivi, stato delle sequenze e applicazioni necessarie per completare l'attività.
La domanda di accettazione corretta non è «Si è caricato il modello da 24GB?». È «Questa macchina precisa può completare il mio normale carico, fornire risposte affidabili e lasciare spazio al turno successivo?». È questo il budget di memoria per cui vale la pena acquistare.
Fonti
Le informazioni sul rilascio sono datate 15 ottobre 2026; le schede dei modelli e la documentazione aggiornata collegate sono state consultate il 16 ottobre 2026. Le procedure sono istruzioni adattate, non risultati di test pratici. I diagrammi originali sono schemi esplicativi, non risorse ufficiali o grafici prestazionali.
- Annuncio di rilascio NVIDIA per i tre nomi dei modelli e i tempi di rilascio.
- Panoramica di ricerca NVIDIA su Bolt e rapporto tecnico per compressione, precisione e stima dettagliata della memoria.
- Scheda del modello GGUF NVIDIA per tabella hardware effettiva, nomi dei checkpoint e ricetta di avvio.
- Compilazione llama.cpp, server, multimodale e documentazione degli strumenti GGUF per il comportamento del runtime.
- Documentazione cache di Hugging Face e strategie di cache.
- Guida CLI di Hugging Face.
- Riferimento NVIDIA System Management Interface.
Raccolta le fonti dietro le tue decisioni
Confrontare gli agent è più semplice quando fonti originali, note e risultati delle tue prove restano insieme. Crea un account Telli.sh per organizzare questo materiale in un riferimento a cui tornare quando i prodotti cambiano.