Un modèle de 24GB n’est pas un ordinateur de 24GB : le budget mémoire de Nemotron Bolt
Comprenez les 74B paramètres au total et les 9B actifs de Nemotron Bolt, ses poids natifs en 2 bits et la mémoire requise par le contexte, la vision, le modèle brouillon et l’environnement d’exécution.
Votre GPU dispose de 24GB de mémoire. Un nouveau modèle affiche « 24GB » dans son nom. Ces deux chiffres suffisent sûrement à décider de l’achat ?
Pas pour une charge IA locale complète. Dans son annonce du 15 octobre, NVIDIA a présenté Nemotron 3.5 Bolt 74B-A9B 24GB comme un modèle vision-langage déployable localement et utilisant une quantification native en 2 bits. Son nom décrit un objectif d’optimisation, pas la promesse que chaque longueur de contexte, requête d’image et configuration d’agent tiendra sur une carte graphique de 24GB. Annonce de NVIDIA, 15 octobre 2026.
La question utile est de savoir ce qu’il reste une fois le modèle chargé. Ce guide distingue les paramètres stockés du calcul actif, explique les autres consommateurs de mémoire et présente une configuration limitée à l’interface locale, basée sur la recette réelle de la fiche du modèle. Commencez par la charge dont vous avez besoin, puis déterminez si la machine peut la soutenir.
Visuel principal : explication éditoriale originale du budget de la charge entière, ni capture officielle ni mesure d’allocation. Les tailles des composants ne sont pas représentées.
Le nombre inférieur de paramètres actifs ne réduit pas le téléchargement à 9B
Bolt compte 74 milliards de paramètres au total et environ 9 milliards actifs par jeton. Son routeur à mélange d’experts sélectionne une partie du réseau stocké. C’est un descendant compressé de Super VL 120B-A12B, pas un modèle dense de 9B. Présentation de recherche de NVIDIA sur Bolt, 15 octobre 2026.
Retenons cette distinction : les paramètres actifs aident à comprendre le travail effectué pour un jeton ; le nombre total aide à comprendre ce qu’il faut stocker. Aucun des deux chiffres ne détermine seul la vitesse de l’application. Le placement, la bande passante mémoire, les noyaux, la longueur de l’entrée et l’application autour du modèle influent tous sur le résultat.
Un agent qui examine du code doit toujours pouvoir accéder aux experts qui n’ont pas été sélectionnés pour le jeton précédent. Déplacer des données entre stockage, mémoire système et mémoire GPU ne revient pas à disposer de tout sur l’accélérateur. Un nombre inférieur de paramètres actifs ne permet donc pas de calculer le besoin matériel comme si les autres paramètres n’existaient pas.
Les noms de la famille méritent également une comparaison précise :
| Modèle | Ce que désigne le nom | État au 16 octobre |
|---|---|---|
| Nemotron 3.5 Super VL | Le modèle distinct de 120B | Publié |
| Nemotron 3.5 Bolt 74B-A9B 24GB | L’option de modèle local compressé abordée ici | Publié |
| Nemotron 3.5 Bolt E4B 4GB | Une offre distincte, plus petite, pour la périphérie et les conversations | Annoncée pour le 23 octobre |
Les états de publication sont ceux de l’annonce du 15 octobre. E4B correspond à une disponibilité future à la date de cet article, pas à un substitut déjà disponible et démontré par ces commandes. Les résultats de déploiement en entreprise de Super VL ne doivent pas non plus être interprétés comme des résultats de Bolt sur ordinateur de bureau.
Les poids natifs en 2 bits ne résolvent qu’une partie du budget
« Natif en 2 bits » a un sens, car la compression agressive fait partie du développement du modèle, plutôt que de résulter uniquement du choix ultérieur d’un export plus petit par l’utilisateur. NVIDIA utilise une distillation tenant compte de la quantification pour récupérer des capacités après la réduction de précision. Les poids des experts utilisent IQ2_XXS à 2.0625 bits par élément, tandis que les autres composants gardent des formats différents. Le réseau est à précision mixte : tout n’est pas uniformément en deux bits. Explication de NVIDIA sur la compression et la quantification, 15 octobre 2026.
À titre de calcul volontairement irréaliste, 74 milliards de valeurs stockées exactement sur deux bits occuperaient 18.5 milliards d’octets. C’est une illustration, pas la taille du fichier Bolt ni son besoin au lancement : ce calcul ignore le mélange réel de précisions, les métadonnées et l’état d’exécution. Multiplier un nombre de paramètres accrocheur par une profondeur de bits tout aussi accrocheuse ne remplace pas l’examen d’un checkpoint précis.
GGUF répond à une autre question. C’est le format de fichier de modèle utilisé dans l’écosystème llama.cpp ; il contient les tenseurs et les informations associées. Il ne constitue pas une deuxième promesse de compression qui s’ajouterait aux « 2 bits », et télécharger un GGUF ne prouve pas en soi qu’un environnement d’exécution donné comprend le modèle. Documentation des outils GGUF de llama.cpp, consultée le 16 octobre 2026.
La propre estimation de NVIDIA de la répartition mémoire rend la distinction concrète : le tableau 2 indique 22.01GB pour les poids, 23.83GB au total hors vision, puis 1.68GB supplémentaires pour l’encodeur et le projecteur de vision. Ce sont des estimations du fournisseur pour la configuration de son rapport, pas des mesures mémoire effectuées pour cet article. Le même rapport décrit un objectif de conception inférieur à 24GB avec une taille de lot de un et un contexte de 128K. Rapport technique Bolt, tableau 2 et section 2.3, lié le 15 octobre 2026.
La conclusion n’est pas que le nom dissimule en réalité un chiffre réservé aux poids. C’est qu’un objectif de déploiement repose sur des hypothèses. Modifiez-les et le besoin mémoire change lui aussi.
Prévoyez toute la mémoire de travail, pas seulement les poids
Considérez le déploiement comme une taxe de contexte qui s’ajoute au modèle stocké : le travail que vous demandez au système de retenir et de traiter nécessite également de la place. Pour planifier, distinguez les poids, l’état des séquences, le traitement de la vision, le décodage spéculatif et l’espace de travail de l’environnement d’exécution. Gardez une marge supplémentaire pour le bureau et les applications que vous comptez réellement laisser ouvertes.
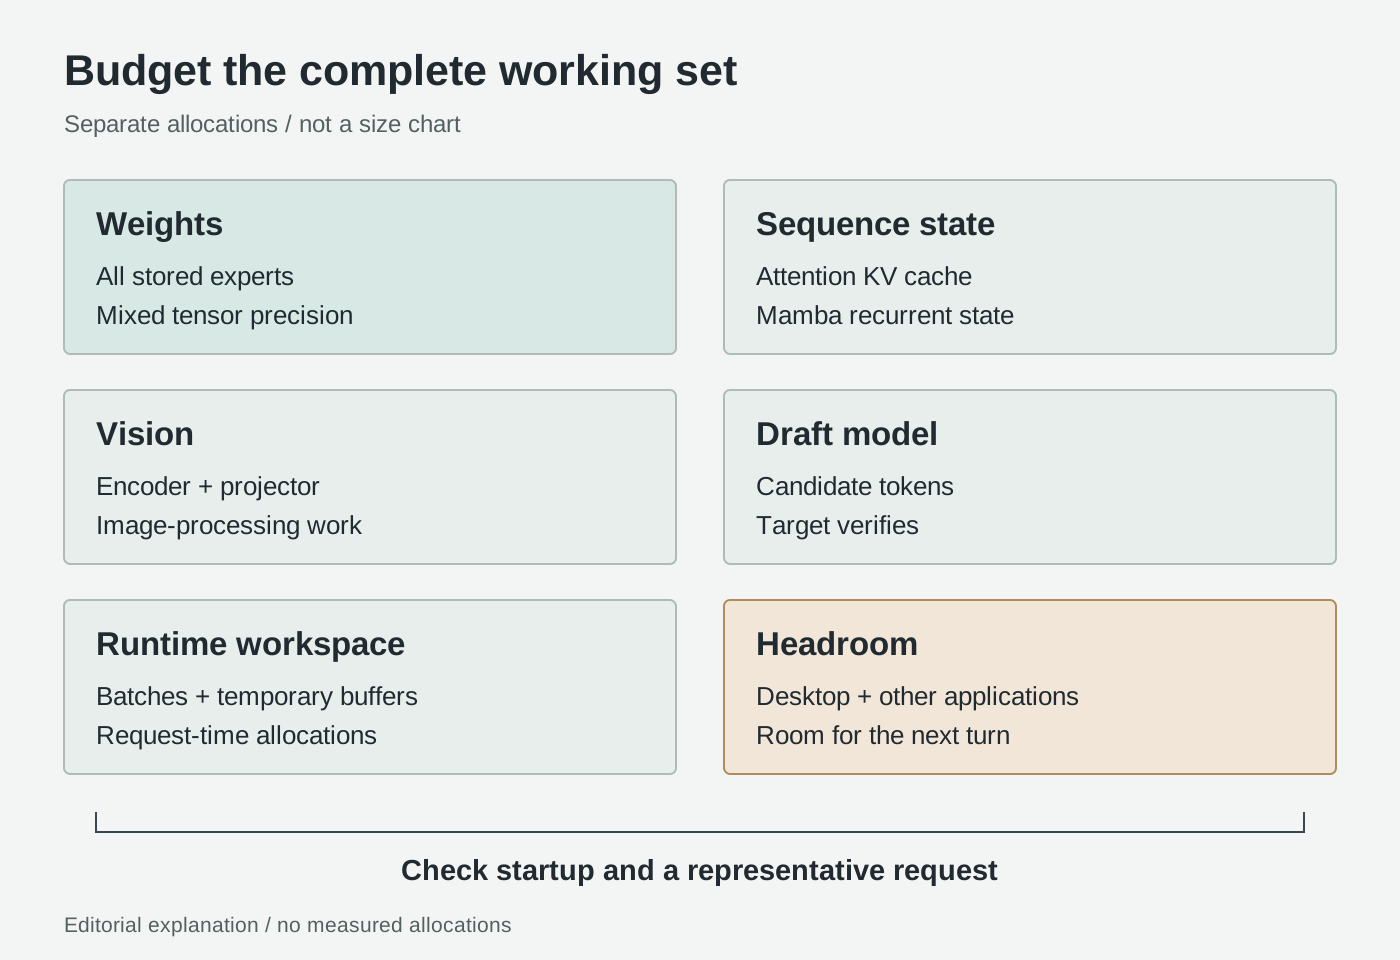
Explication éditoriale originale, sans proportions mesurées. Mécanismes : documentation de Hugging Face sur la mise en cache, guide multimodal de llama.cpp et rapport Bolt de NVIDIA, consultés le 16 octobre 2026.
L’état des séquences n’est pas une autre copie des poids. Un modèle autorégressif à attention met en cache les clés et valeurs des jetons précédents afin de les réutiliser lors de la génération. Plus les séquences conservées sont longues, plus le cache d’attention occupe de place ; les détails dépendent de l’architecture et de la représentation du cache. Hugging Face, « How caching works », consulté le 16 octobre 2026.
Bolt est un modèle hybride combinant des couches Mamba et attention ; une estimation générique d’un cache Transformer complet ne suffit donc pas à le calculer. L’état récurrent et les caches d’attention sont des allocations distinctes : examinez ce que crée réellement l’environnement d’exécution. Cette distinction architecturale est documentée dans le tableau 1 du rapport Bolt, consulté le 16 octobre 2026.
Pour un agent, le contexte conservé dépasse la question que vous avez saisie. Les instructions système, les schémas des outils, l’historique de conversation, les passages récupérés et les réponses des outils occupent tous une partie de la place disponible pour la réponse. Une transcription contenant des listes répétées de fichiers du dépôt peut épuiser un budget utile sans apporter de preuve pertinente. Maintenir un état de tâche concis relève du workflow, pas seulement d’une astuce matérielle.
La vision ajoute un parcours de traitement distinct. llama.cpp associe le modèle de langage à un fichier de projecteur multimodal au moyen de --mmproj ; sa documentation indique que ce composant est déchargé vers le GPU par défaut. Guide multimodal de llama.cpp, consulté le 16 octobre 2026. Charger uniquement le fichier du modèle de langage ne revient donc pas à configurer complètement la prise en charge des images.
Pour une tâche documentaire, distinguez l’extraction de texte de l’interprétation d’une page rendue. Un paragraphe en texte brut ne contient pas la relation visuelle entre l’en-tête d’une colonne et ses cellules. À l’inverse, envoyer des images de pages dont la mise en page est sans importance ajoute du travail sans nécessairement améliorer la réponse. Choisissez la représentation qui conserve les éléments nécessaires à votre question.
Un modèle brouillon spéculatif est un modèle supplémentaire. Le modèle brouillon LiLiCorr de Bolt propose des jetons candidats que le modèle cible vérifie. Il vise à accélérer le décodage, mais le checkpoint supplémentaire et son état d’exécution nécessitent toujours de la mémoire. Explication de LiLiCorr par NVIDIA, 15 octobre 2026. La présence d’un modèle brouillon ne garantit pas une exécution plus rapide de vos tâches.
L’espace de travail de l’environnement d’exécution s’ajoute encore au budget. Les lots de traitement des invites et les tampons de calcul temporaires doivent être comptés avec l’état persistant. Le serveur expose la taille logique des lots et la taille physique des micro-lots ; elles ne sont pas interchangeables avec le nombre de conversations simultanées. Référence des options du serveur llama.cpp, consultée le 16 octobre 2026. Une configuration qui démarre doit encore être testée sur une requête représentative.
Le tableau matériel officiel vaut mieux que le suffixe du produit
Configurations publiées par NVIDIA :
| Recette | Matériel | Contexte | Séquences |
|---|---|---|---|
| 28GB | RTX Spark 64GB ou RTX discrète de 32GB ou plus | 65,536 | 1 |
| 32GB | RTX Spark 128GB ou RTX discrète de 48GB ou plus | 262,144 | 1 |
Source : Guide de démarrage rapide NVIDIA, consulté le 16 octobre 2026.
Ces lignes ne couvrent pas un GPU discret de 24GB et ne confirment pas la prise en charge des Mac. La RAM hôte ne constitue pas de la VRAM discrète supplémentaire.
À notre avis, choisissez une configuration reproductible, pas une simple capture d’écran montrant que le modèle s’est chargé. Si un achat dépend de ce modèle, exigez une démonstration avec vos entrées et vos applications habituelles en arrière-plan. C’est particulièrement important pour les images de documents et les agents de longue durée, dont la première requête peut être bien plus petite que les suivantes.
Choisissez le contexte en fonction de la tâche, pas du maximum
Voici trois exemples de tâches de départ, donnés à titre illustratif et non comme des essais rapportés.
Un développeur demande l’explication d’un test en échec et fournit l’erreur, la fonction concernée et une dépendance proche. Le résultat utile est un diagnostic lié à des lignes précises, suivi d’une modification proposée. Avant d’ajouter tout un dépôt, vérifiez si l’information manquante concerne une interface particulière ou une autre trace de pile. La question reste ainsi vérifiable et les suppositions erronées plus faciles à repérer.
Une chercheuse compare un tableau réparti sur deux pages de document. Il faut vérifier que le modèle associe correctement en-têtes, unités, notes de bas de page et valeurs. Utilisez les images réelles des pages lorsque ces relations comptent, demandez des éléments justificatifs propres à chaque page et vérifiez un échantillon de cellules par rapport à l’original. Un résumé fluide qui permute deux colonnes reste un échec, même s’il arrive rapidement.
Un assistant local parcourt un dossier approuvé et prépare une ébauche de rapport. La pression mémoire peut croître avec les documents récupérés et les réponses répétées des outils. Commencez par une tâche en lecture seule, limitez la recherche et demandez-lui de nommer les fichiers qui étayent chaque conclusion. N’accordez pas de droits d’écriture ou de shell simplement pour voir si le modèle peut produire un plan utile.
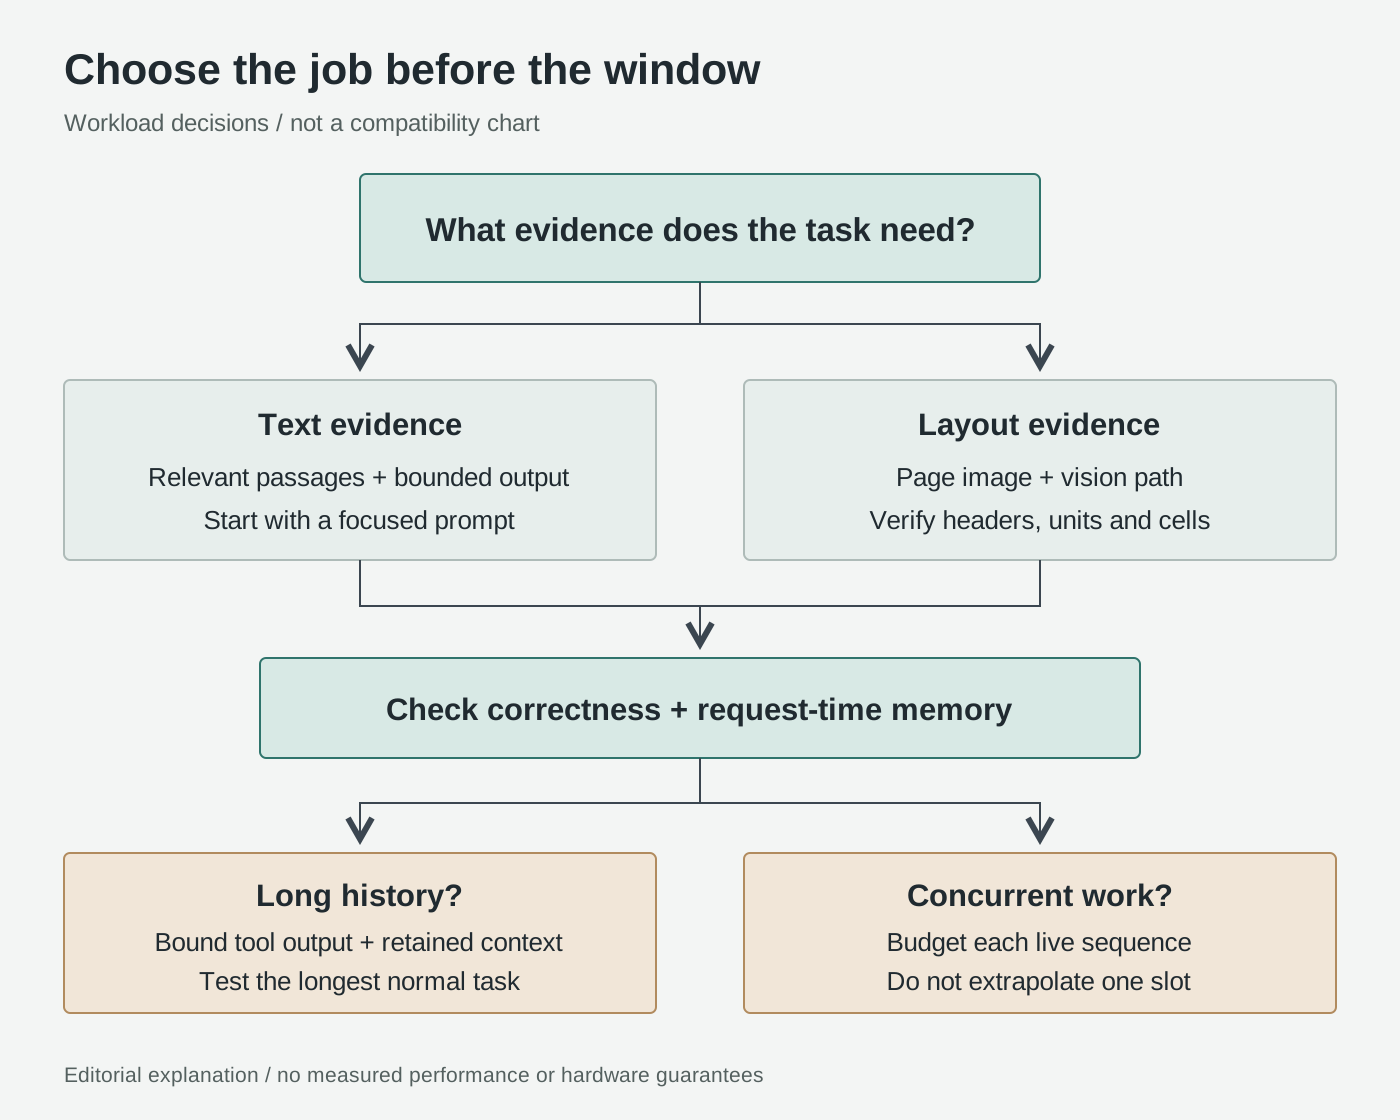
Explication éditoriale originale du choix de charge, pas un benchmark ni un tableau de compatibilité. Voir les stratégies de cache de Hugging Face et le traitement multimodal de llama.cpp, consultés le 16 octobre 2026.
Les caches quantifiés peuvent occuper moins de place que les caches de précision supérieure ; le déchargement déplace la pression vers un autre niveau de mémoire et peut échanger du débit contre de la capacité. Il s’agit de compromis généraux, pas de la preuve que chaque stratégie de cache de Transformers est disponible pour ce déploiement GGUF. Stratégies de cache de Hugging Face, consultées le 16 octobre 2026.
La priorité pratique est la densité des éléments utiles : conservez les informations nécessaires pour répondre, gardez les originaux séparément et supprimez les éléments de structure répétés. Réservez également de la place à la réponse. Une fenêtre configurée plus grande ne rend pas utile un historique hors sujet.
Commencez en local, puis testez votre véritable charge de travail
L’exemple Bash Linux suivant vise une configuration prise en charge avec GPU NVIDIA discret. Il suppose que Git, Python, CMake, une chaîne d’outils C++, un pilote NVIDIA compatible et le kit CUDA sont déjà installés. Il s’agit d’une procédure à exécuter sur votre machine, pas du compte rendu d’une installation réalisée.
- Compilez l’environnement d’exécution adapté et vérifiez ses options. Utilisez la compilation depuis les sources, pas une commande générique copiée depuis une page de modèle. Suivez le guide de compilation CUDA de llama.cpp, consulté le 16 octobre 2026. Conservez le commit et la version du binaire avec votre configuration.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Vérifiez que l’aide comprend draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn et --jinja. Une étiquette de version de paquet ne prouve pas la prise en charge. Si votre binaire rejette ces options, corrigez l’incompatibilité de compilation avant de télécharger de gros checkpoints ; ne remplacez pas silencieusement la recette par d’anciens paramètres de décodage spéculatif. Les noms des options figurent dans la référence actuelle du serveur, consultée le 16 octobre 2026.
- Téléchargez les trois fichiers du guide de démarrage rapide NVIDIA, consulté le 16 octobre 2026. La syntaxe de téléchargement suit le guide CLI de Hugging Face, consulté le 16 octobre 2026. Vérifiez d’abord l’espace disque.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Consignez les révisions des dépôts et les empreintes locales des fichiers avant d’utiliser cette configuration comme référence de comparaison. Toute mise à jour ultérieure de fichier ou de l’environnement d’exécution doit être délibérée, et non une différence inexpliquée entre deux exécutions.
- Utilisez la recette NVIDIA de 28GB avec une liaison explicite à l’interface locale.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Utilisez un port disponible si nécessaire et adaptez le contrôle ci-dessous. Pour ce premier lancement, ne créez ni règle de redirection de routeur, ni tunnel public, ni écouteur lié à une interface externe. Une liaison locale limite la portée réseau ; elle ne rend pas inoffensifs les outils d’un agent connecté.
- Vérifiez que le serveur est prêt avant de connecter quoi que ce soit d’autre. Dans un autre terminal, exécutez :
curl --fail http://127.0.0.1:8080/health
Le serveur documente séparément un état de chargement et l’état prêt. Une fois prêt, ouvrez localement http://127.0.0.1:8080 et essayez une courte question textuelle avant une requête d’image. Documentation de llama.cpp sur l’état de santé du serveur et son interface web, consultée le 16 octobre 2026. Laissez les outils externes déconnectés jusqu’à ce que les réponses de base fonctionnent.
- Mesurez toute la tâche avant de l’élargir. Sur un système à GPU discret, examinez la mémoire avant le lancement et pendant des invites représentatives :
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Ce sont des observations du périphérique, pas une mesure complète du pic d’un processus ni une méthode de comptabilisation de la mémoire unifiée. NVIDIA documente les variations du rapport mémoire selon la plateforme dans la référence NVIDIA System Management Interface, consultée le 16 octobre 2026. Conservez également les journaux d’allocation de l’environnement d’exécution et examinez séparément la mémoire hôte.
Comparez une courte invite, la plus longue invite habituelle et une image documentaire représentative. Notez l’exactitude, la durée totale, les observations mémoire et tout échec d’allocation. Recommencez avec votre éditeur et votre navigateur habituels ouverts. Une configuration qui ne fonctionne qu’après la fermeture du reste de votre environnement de travail ne répond pas au besoin initial.
En cas d’échec, modifiez un seul facteur à la fois et nommez la nouvelle configuration. Réduire le contexte, la taille des micro-lots ou le volume d’historique des outils répond à des questions différentes ; supprimer le modèle brouillon constitue une autre expérience, pas la recette publiée. Conservez l’échec et l’entrée qui l’a provoqué pour qu’une courte requête réussie ultérieure ne fasse pas oublier le problème de charge encore non résolu.
En bref : achetez pour la mémoire de travail
La proposition intéressante de Bolt est celle d’un grand modèle à activation parcimonieuse, compressé pour le travail local. Sa valeur pratique dépend de ce qui peut tenir avec lui : les éléments justificatifs, les entrées visuelles, l’état des séquences et les applications nécessaires pour terminer la tâche.
La bonne question d’acceptation n’est pas « Le modèle 24GB s’est-il chargé ? », mais « Cette machine précise peut-elle terminer ma tâche habituelle, avec des réponses fiables et assez de marge pour le tour suivant ? ». Voilà le budget mémoire qui mérite un achat.
Sources
Les informations de publication datent du 15 octobre 2026 ; les fiches de modèles liées et la documentation évolutive ont été consultées le 16 octobre 2026. Les procédures sont des instructions adaptées, pas le compte rendu d’essais pratiques. Les schémas originaux sont des explications, pas des ressources officielles ni des graphiques de performances.
- Annonce de sortie NVIDIA pour les trois noms de modèles et leur calendrier de publication.
- Présentation de recherche de NVIDIA sur Bolt et rapport technique pour la compression, la précision et la répartition mémoire estimée.
- Fiche GGUF de NVIDIA pour le tableau matériel réel, les noms de fichiers des checkpoints et la recette de lancement.
- Documentation de compilation llama.cpp, du serveur, du multimodal et des outils GGUF pour le comportement de l’environnement d’exécution.
- Explication du cache de Hugging Face, stratégies de cache, guide CLI et référence NVIDIA SMI pour les mécanismes et commandes d’inspection concernés.
Recommandation facultative de Telli.sh : conservez les sources qui étayent vos décisions
Comparer des agents est plus facile lorsque les sources originales, vos notes et les résultats de vos propres essais restent réunis. Créer un compte Telli.sh pour organiser ces éléments dans une référence que vous pourrez consulter à mesure que les produits évoluent.