Un modelo de 24GB no es un ordenador de 24GB: el presupuesto de memoria de Nemotron Bolt
Entiende los 74B parámetros totales y los 9B activos de Nemotron Bolt, los pesos nativos de 2 bits y la memoria que requieren el contexto, la visión, el modelo borrador y el entorno de ejecución en sus recetas locales.
Tienes una GPU con 24GB de memoria. Un modelo nuevo lleva «24GB» en el nombre. ¿Seguro que esos dos números bastan para decidir la compra?
No para una carga completa de IA local. El anuncio de NVIDIA del 15 de octubre presentó Nemotron 3.5 Bolt 74B-A9B 24GB como un modelo de visión y lenguaje desplegable localmente que utiliza cuantización nativa de 2 bits. Su nombre describe un objetivo de optimización, no promete que cualquier longitud de contexto, petición de imagen y configuración de agente quepa en una tarjeta gráfica de 24GB. Anuncio de NVIDIA, 15 de octubre de 2026.
La pregunta útil es qué queda una vez cargado el modelo. Esta guía separa los parámetros almacenados del cálculo activo, explica los demás consumidores de memoria y recorre una configuración limitada a la interfaz local basada en la receta real de la ficha del modelo. Empieza por la carga que necesitas y luego decide si la máquina puede sostenerla.
Imagen principal: explicación editorial original de un presupuesto para toda la carga; no es una captura oficial ni una asignación medida. No se representan tamaños de componentes.
El menor número de parámetros activos no convierte la descarga en un modelo de 9B
Bolt tiene 74.000 millones de parámetros totales y aproximadamente 9.000 millones activos por token. Su enrutador de mezcla de expertos selecciona parte de la red almacenada. Es un descendiente comprimido de Super VL 120B-A12B, no un modelo denso de 9B. Resumen de investigación de NVIDIA sobre Bolt, 15 de octubre de 2026.
Conviene recordar esta distinción: los parámetros activos ayudan a explicar el trabajo realizado para un token; los parámetros totales ayudan a explicar qué hay que almacenar. Ninguna cifra determina por sí sola la velocidad de la aplicación. La ubicación, el ancho de banda de memoria, los kernels, la longitud de entrada y la aplicación que lo rodea influyen en el resultado.
Un agente que revisa código sigue necesitando acceso a los expertos que no se seleccionaron para el token anterior. Mover datos entre el almacenamiento, la memoria del sistema y la memoria de la GPU no equivale a tenerlo todo disponible en el acelerador. Por eso, un menor número de parámetros activos no autoriza a calcular los requisitos de hardware como si los parámetros restantes no existieran.
Los nombres de la familia también merecen una comparación precisa:
| Modelo | A qué se refiere el nombre | Estado a 16 de octubre |
|---|---|---|
| Nemotron 3.5 Super VL | El modelo independiente de 120B | Publicado |
| Nemotron 3.5 Bolt 74B-A9B 24GB | La opción comprimida para uso local de este artículo | Publicado |
| Nemotron 3.5 Bolt E4B 4GB | Una oferta independiente más pequeña para dispositivos periféricos y conversaciones | Anunciado para el 23 de octubre |
Los estados de publicación proceden del anuncio del 15 de octubre. E4B representa disponibilidad futura en la fecha de este artículo, no un sustituto ya disponible y demostrado con estos comandos. Tampoco deben interpretarse los resultados de despliegue empresarial de Super VL como resultados de Bolt en un ordenador de escritorio.
Los pesos nativos de 2 bits solo resuelven una parte del presupuesto
«Nativo de 2 bits» es significativo porque la compresión agresiva forma parte del desarrollo del modelo; no es solo que el usuario elija después una exportación más pequeña. NVIDIA utiliza destilación consciente de la cuantización para recuperar capacidad tras reducir la precisión. Los pesos expertos usan IQ2_XXS a 2.0625 bits por elemento, mientras que otros componentes conservan formatos distintos. La red emplea precisión mixta; no todo tiene uniformemente dos bits. Explicación de NVIDIA sobre compresión y cuantización, 15 de octubre de 2026.
Como cálculo ilustrativo deliberadamente irreal, 74.000 millones de valores almacenados exactamente a dos bits ocuparían 18.500 millones de bytes. Es una ilustración, no el tamaño del archivo de Bolt ni el requisito para iniciarlo: ignora la mezcla real de precisión, los metadatos y el estado de ejecución. Multiplicar un número llamativo de parámetros por una profundidad de bits igualmente llamativa no sustituye la inspección de un checkpoint concreto.
GGUF responde a otra pregunta. Es el formato de archivo de modelo que utiliza el ecosistema llama.cpp, y contiene tensores e información asociada. No es una segunda promesa de compresión que se añada a «2 bits», y descargar un GGUF no demuestra por sí mismo que un entorno de ejecución determinado entienda el modelo. Documentación de las herramientas GGUF de llama.cpp, consultada el 16 de octubre de 2026.
El desglose de memoria estimado por la propia NVIDIA concreta la diferencia: la tabla 2 indica 22.01GB para los pesos, 23.83GB en total sin visión y otros 1.68GB para el codificador y el proyector visuales. Son estimaciones del proveedor para la configuración de su informe, no mediciones de memoria de este artículo. El mismo informe describe un objetivo de diseño inferior a 24GB con tamaño de lote uno y contexto de 128K. Informe técnico de Bolt, tabla 2 y sección 2.3, enlazado el 15 de octubre de 2026.
La conclusión no es que la marca oculte en realidad una cifra solo para los pesos. Es que un objetivo de despliegue depende de ciertas hipótesis. Si cambian esas hipótesis, también cambia la necesidad de memoria.
Presupuesta todo el conjunto de trabajo, no solo los pesos
Piensa en el despliegue como un impuesto de contexto añadido al modelo almacenado: el trabajo que pides al sistema que conserve y procese también necesita espacio. Para planificar, separa los pesos, el estado de las secuencias, el procesamiento visual, la decodificación especulativa y el espacio de trabajo del entorno de ejecución. Deja margen adicional para el escritorio y las aplicaciones que realmente quieras mantener abiertas.
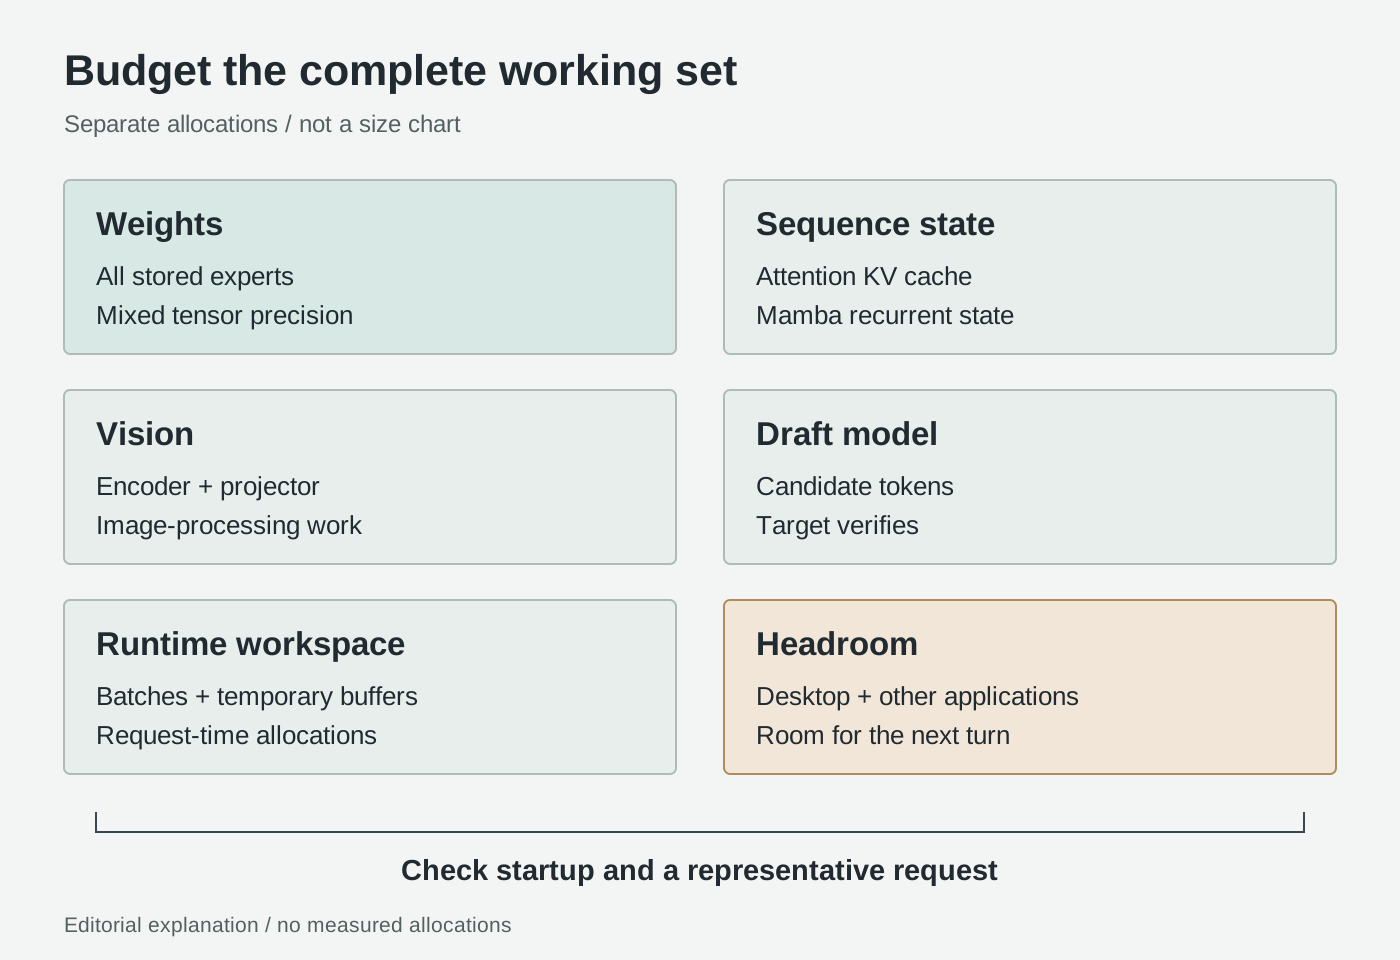
Explicación editorial original, sin proporciones medidas. Mecanismos: documentación de Hugging Face sobre caché, guía multimodal de llama.cpp e informe Bolt de NVIDIA, consultados el 16 de octubre de 2026.
El estado de las secuencias no es otra copia de los pesos. Un modelo de atención autorregresivo almacena en caché las claves y los valores de los tokens anteriores para reutilizarlos durante la generación. Cuanto más largas sean las secuencias conservadas, más espacio requerirá la caché de atención; los detalles dependen de la arquitectura y la representación de la caché. Hugging Face, «How caching works», consultado el 16 de octubre de 2026.
Bolt es un modelo híbrido con capas Mamba y de atención, por lo que una estimación genérica de caché para un Transformer completo no basta para calcularlo. El estado recurrente y las cachés de atención son asignaciones distintas; inspecciona qué crea realmente el entorno de ejecución. La distinción arquitectónica está documentada en la tabla 1 del informe Bolt, consultado el 16 de octubre de 2026.
En un agente, el contexto conservado incluye más que la pregunta que escribiste. Las instrucciones del sistema, los esquemas de herramientas, el historial de conversación, los pasajes recuperados y las respuestas de las herramientas compiten por el espacio disponible para la respuesta. Una transcripción con listados repetidos del repositorio puede agotar un presupuesto útil sin aportar pruebas relevantes. Mantener un estado de tarea conciso es una decisión de flujo de trabajo, no solo una solución de hardware.
La visión incorpora una ruta de procesamiento independiente. llama.cpp empareja el modelo de lenguaje con un archivo de proyector multimodal mediante --mmproj; su documentación indica que este componente se descarga a la GPU de forma predeterminada. Guía multimodal de llama.cpp, consultada el 16 de octubre de 2026. Cargar solo el archivo del modelo de lenguaje no equivale, por tanto, a tener una configuración completa con capacidad para imágenes.
Para una tarea con documentos, distingue entre leer el texto extraído e interpretar una página renderizada. Un párrafo de texto sin formato no contiene la relación visual entre el encabezado de una columna y sus celdas. A la inversa, enviar imágenes de páginas cuyo diseño no importa añade trabajo sin mejorar necesariamente la respuesta. Decide qué representación conserva las pruebas que necesita tu pregunta.
Un modelo borrador especulativo es un modelo adicional. El borrador LiLiCorr de Bolt propone tokens candidatos que el modelo objetivo verifica. Está pensado para acelerar la decodificación, pero el checkpoint adicional y su estado de ejecución también requieren memoria. Explicación de LiLiCorr de NVIDIA, 15 de octubre de 2026. La presencia de un borrador no garantiza que tus tareas se completen más rápido.
El espacio de trabajo del entorno de ejecución vuelve a ser independiente. Los lotes de procesamiento de solicitudes y los búferes de cálculo temporales forman parte del presupuesto junto con el estado persistente. El servidor expone tanto el tamaño lógico del lote como el tamaño físico del microlote; no son intercambiables con el número de conversaciones simultáneas. Referencia de opciones del servidor llama.cpp, consultada el 16 de octubre de 2026. Una configuración que arranca correctamente aún necesita probarse con una solicitud representativa.
La tabla oficial de hardware es más útil que el sufijo del producto
Configuraciones publicadas por NVIDIA:
| Receta | Hardware | Contexto | Secuencias |
|---|---|---|---|
| 28GB | RTX Spark de 64GB o RTX discreta de 32GB o más | 65,536 | 1 |
| 32GB | RTX Spark de 128GB o RTX discreta de 48GB o más | 262,144 | 1 |
Fuente: Guía de inicio rápido de NVIDIA, consultada el 16 de octubre de 2026.
Estas filas no cubren una GPU discreta de 24GB ni confirman compatibilidad con Mac. La RAM del equipo no se suma a la VRAM de una tarjeta discreta.
Nuestra recomendación: elige una configuración repetible, no una captura de pantalla que solo demuestre que el modelo se cargó. Si una compra depende de este modelo, exige una demostración con tus entradas y las aplicaciones que sueles tener abiertas en segundo plano. Esto importa especialmente para imágenes de documentos y agentes de larga duración, cuya primera petición puede ser mucho más pequeña que las posteriores.
Elige el contexto según el trabajo, no el máximo
Considera estos tres trabajos iniciales ilustrativos, no pruebas notificadas.
Un desarrollador pide una explicación de una prueba fallida y proporciona el error, la función pertinente y una dependencia cercana. El resultado útil es un diagnóstico vinculado a líneas concretas, seguido de un cambio propuesto. Antes de añadir todo el repositorio, comprueba si falta una interfaz específica u otro marco de la pila. Así la pregunta sigue siendo inspeccionable y resulta más fácil detectar suposiciones erróneas.
Una investigadora compara una tabla repartida en dos páginas de un documento. La prueba consiste en comprobar si el modelo relaciona correctamente encabezados, unidades, notas al pie y valores. Usa imágenes reales de las páginas cuando esas relaciones importen, pide pruebas específicas de cada página y verifica una muestra de celdas frente al original. Un resumen elocuente que intercambia dos columnas es un resultado fallido aunque llegue rápido.
Un asistente local busca en una carpeta autorizada y prepara un borrador de informe. La presión sobre la memoria puede crecer con el material recuperado y las respuestas repetidas de las herramientas. Asígnale primero una tarea de solo lectura, limita la búsqueda y pídele que identifique los archivos que respaldan cada conclusión. No concedas permisos de escritura o shell solo para comprobar si el modelo puede proponer un plan útil.
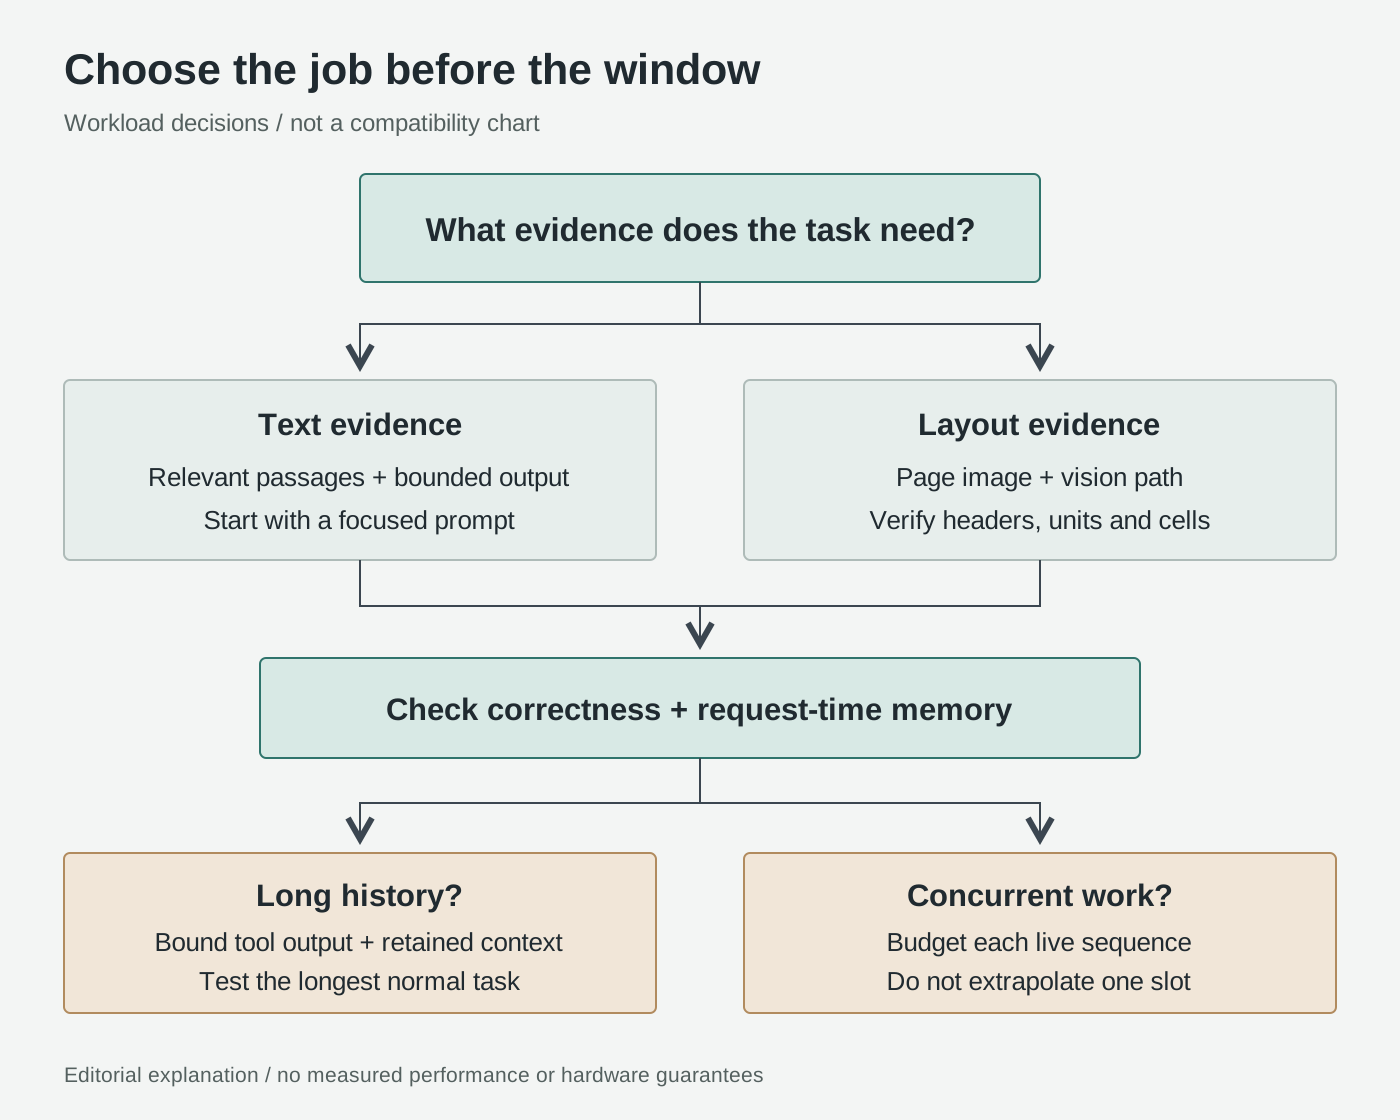
Explicación editorial original de la selección de carga, no un benchmark ni una tabla de compatibilidad. Consulta las estrategias de caché de Hugging Face y el tratamiento multimodal de llama.cpp, consultados el 16 de octubre de 2026.
Las cachés cuantizadas pueden reducir el almacenamiento frente a las de mayor precisión, mientras que descargar datos a otro nivel de memoria desplaza allí la presión y puede intercambiar rendimiento por capacidad. Son compromisos generales, no una prueba de que todas las estrategias de caché de Transformers estén disponibles en este despliegue GGUF. Estrategias de caché de Hugging Face, consultadas el 16 de octubre de 2026.
La prioridad práctica es la densidad de pruebas: conserva el material necesario para responder, guarda los originales por separado y elimina el contexto repetido que solo sirve de andamiaje. Reserva espacio también para la respuesta. Configurar una ventana mayor no convierte en útil el historial irrelevante.
Empieza localmente y prueba la carga que realmente necesitas
El siguiente ejemplo de Bash en Linux se dirige a una configuración compatible con GPU NVIDIA discreta. Da por hecho que Git, Python, CMake, una cadena de herramientas de C++, un controlador NVIDIA compatible y el kit de herramientas CUDA ya están instalados. Es un procedimiento para ejecutar en tu máquina, no el informe de una instalación completada.
- Compila el entorno de ejecución pertinente y comprueba sus opciones. Usa la ruta de compilación desde el código fuente, no una línea de comandos genérica de una página de modelos. Sigue la guía de compilación CUDA de llama.cpp, consultada el 16 de octubre de 2026. Guarda el commit y la versión del binario junto con la configuración.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Comprueba que la ayuda incluya draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn y --jinja. Una etiqueta de versión del paquete no demuestra que estén disponibles. Si tu binario rechaza las opciones, resuelve la incompatibilidad de compilación antes de descargar checkpoints grandes; no sustituyas silenciosamente la receta por antiguos indicadores de decodificación especulativa. Los nombres de las opciones están documentados en la referencia actual del servidor, consultada el 16 de octubre de 2026.
- Descarga los tres archivos de la guía de inicio rápido de NVIDIA, consultada el 16 de octubre de 2026. La sintaxis de descarga sigue la guía CLI de Hugging Face, consultada el 16 de octubre de 2026. Comprueba antes que haya espacio en disco.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Registra las revisiones de los repositorios y los hashes de los archivos locales antes de usar esta configuración como referencia de comparación. Cualquier actualización posterior del archivo o del entorno de ejecución debe ser deliberada, no una diferencia inexplicada entre dos ejecuciones.
- Usa la receta de 28GB de NVIDIA con vinculación explícita a la interfaz local.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Si hace falta, usa un puerto libre y adapta la comprobación que aparece a continuación. En esta primera ejecución, no crees una regla de reenvío en el router, un túnel público ni un listener enlazado a una interfaz externa. La vinculación a la interfaz local limita el alcance de red, pero no hace inofensivas las herramientas de un agente conectado.
- Comprueba que está listo antes de conectar cualquier otra cosa. En otra terminal, ejecuta:
curl --fail http://127.0.0.1:8080/health
El servidor documenta por separado el estado de carga y el de disponibilidad. Cuando esté listo, abre localmente http://127.0.0.1:8080 y prueba una pregunta de texto breve antes de una solicitud con imagen. Documentación de llama.cpp sobre el estado de salud del servidor y la interfaz web, consultada el 16 de octubre de 2026. Mantén desconectadas las herramientas externas hasta que funcionen las respuestas básicas.
- Mide el trabajo completo antes de ampliarlo. En un sistema con GPU discreta, inspecciona la memoria antes del lanzamiento y durante solicitudes representativas:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Son observaciones del dispositivo, no una medición completa del pico de un proceso ni un método para contabilizar la memoria unificada. NVIDIA documenta los informes de memoria dependientes de la plataforma en la referencia de NVIDIA System Management Interface, consultada el 16 de octubre de 2026. Conserva también los registros de asignación del entorno de ejecución e inspecciona por separado la memoria del equipo.
Compara una solicitud breve, la solicitud más larga que usas habitualmente y una imagen documental representativa. Registra la corrección, el tiempo total, las observaciones de memoria y cualquier fallo de asignación. Repite la prueba con el editor y el navegador habituales abiertos. Una configuración que solo funciona al cerrar el resto de tu entorno de trabajo no cumple el requisito inicial.
Si falla, cambia un solo factor cada vez y pon nombre a la nueva configuración. Reducir el contexto, el tamaño de microlote o el volumen del historial de herramientas responde a preguntas distintas; quitar el borrador es otro experimento, no la receta publicada. Conserva el fallo y la entrada que lo provocó para que una solicitud breve que luego funcione no oculte el problema de carga pendiente.
En resumen: compra para el conjunto de trabajo
La propuesta interesante de Bolt es un modelo grande de activación dispersa, comprimido para el trabajo local. Su valor práctico depende de lo que quepa junto a él: las pruebas, las entradas visuales, el estado de las secuencias y las aplicaciones necesarias para terminar la tarea.
La pregunta adecuada de aceptación no es «¿Se cargó el modelo de 24GB?», sino «¿Puede esta máquina exacta completar mi trabajo habitual, con respuestas fiables y espacio suficiente para el siguiente turno?». Ese es el presupuesto de memoria por el que merece la pena comprar.
Fuentes
La información de lanzamiento tiene fecha del 15 de octubre de 2026; las fichas de modelos enlazadas y la documentación vigente se consultaron el 16 de octubre de 2026. Los procedimientos son instrucciones adaptadas, no resultados de pruebas prácticas. Los diagramas originales son esquemas explicativos, no recursos oficiales ni gráficos de rendimiento.
- Anuncio de lanzamiento de NVIDIA para los nombres de los tres modelos y las fechas de lanzamiento.
- Resumen de investigación de NVIDIA sobre Bolt e informe técnico para la compresión, la precisión y el desglose de memoria estimado.
- Ficha GGUF de NVIDIA para la tabla real de hardware, los nombres de los archivos de checkpoint y la receta de lanzamiento.
- Documentación de llama.cpp sobre compilación, servidor, multimodalidad y herramientas GGUF para el comportamiento del entorno de ejecución.
- Explicación de caché de Hugging Face, estrategias de caché, guía CLI y referencia NVIDIA SMI para los mecanismos y comandos de inspección concretos.
Recomendación opcional de Telli.sh: conserva las fuentes que respaldan tus decisiones
Comparar agentes es más fácil cuando las fuentes originales, tus notas y los resultados de tus propias pruebas permanecen juntos. Crear una cuenta de Telli.sh para organizar ese material en una referencia que puedas consultar cuando cambien los productos.