816B na biurku Maca: co naprawdę umożliwia Muse Spark Open
Otwarty model wag Meta trafia na komputery Mac z dużą pamięcią. Porównaj pokaz na dwóch Mac Studio z mniejszym skwantyzowanym checkpointem, obejrzyj demonstracje i wybierz rozsądny pierwszy sposób uruchomienia.
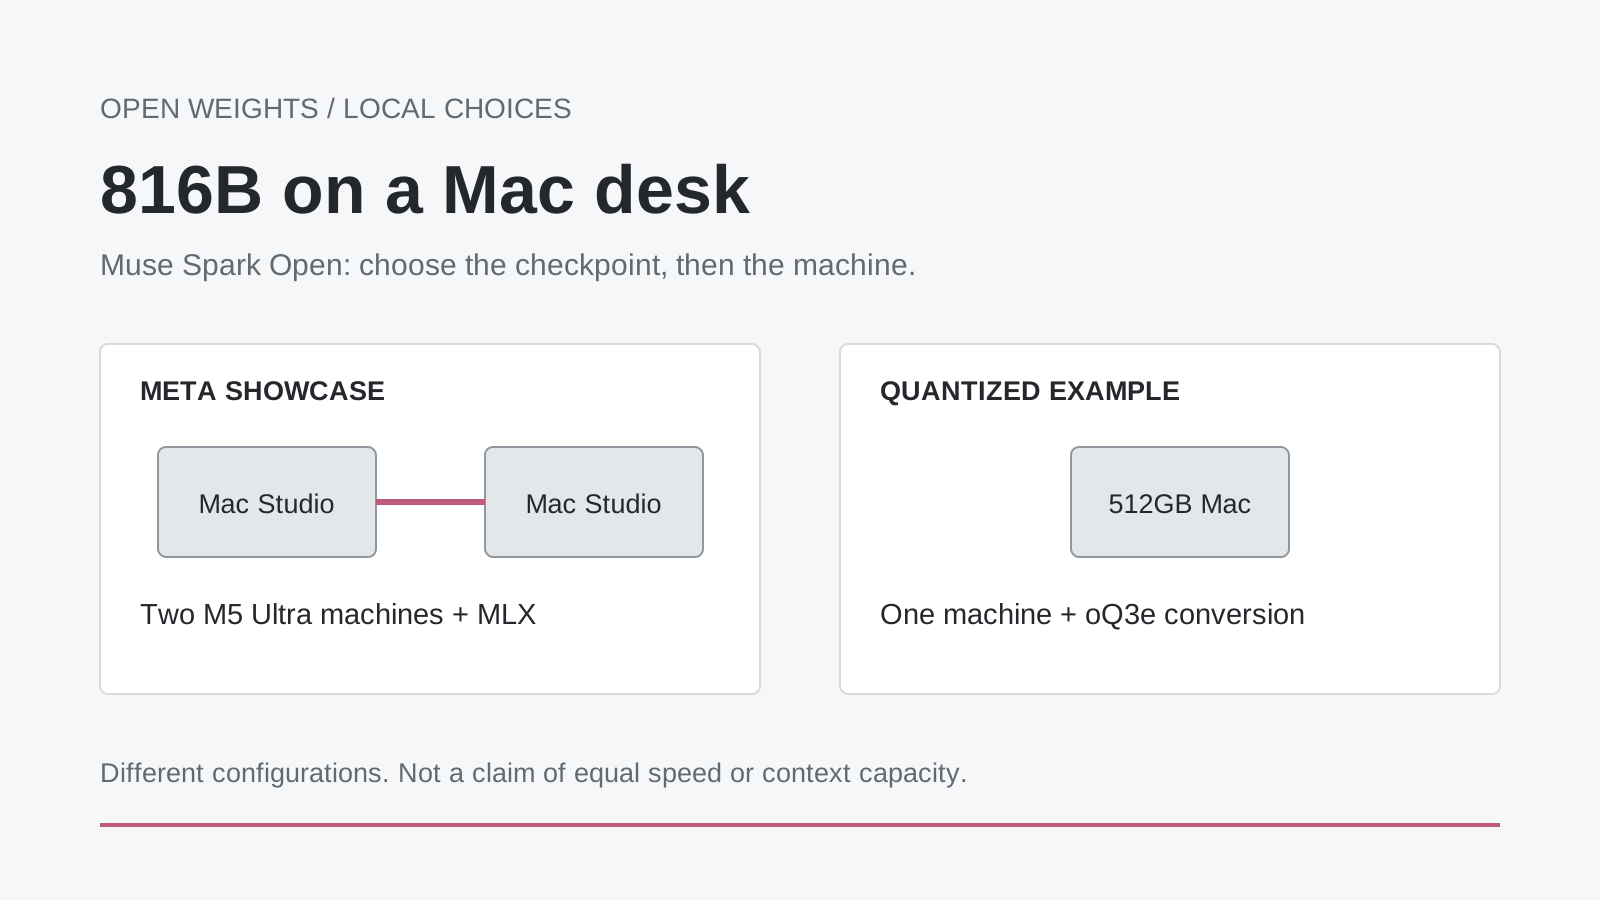
Oryginalna ilustracja objaśniająca. Pokaz na dwóch komputerach i przykład skwantyzowany na jednym urządzeniu wykorzystują różne konfiguracje; nie są porównywalnymi wynikami wydajności.
Model z 816 miliardami parametrów działający na biurku brzmi jak sprzeczność. W komputerze z ogłoszenia Meta z 15 października stoją jednak dwa Mac Studio, każdy z bardzo dużą pulą pamięci. To coś zupełnie innego niż uruchomienie tego samego modelu na posiadanym laptopie.
Ciekawsza zmiana kryje się tuż za tym nagłówkiem. Muse Spark Open daje programistom dostęp do wag modelu, a otaczające je narzędzia oferują kilka sposobów uruchomienia. Meta pokazuje konfigurację dwóch maszyn; Hugging Face opisuje też mocniej skwantyzowaną wersję na pojedynczym Macu z 512 GB pamięci. Lokalne AI coraz mniej zależy od tego, czy model można teoretycznie pobrać, a coraz bardziej od wyboru właściwej reprezentacji i zakresu działania.
Ten poradnik wyjaśnia możliwości modelu, przyczyny różnic w wymaganiach pamięciowych, opublikowane demonstracje warte obejrzenia oraz rozsądny pierwszy krok, który nie rozpoczyna przypadkiem pobierania pliku o rozmiarze setek gigabajtów. Nie chodzi o to, by każdy kupował stację roboczą. Celem jest ułatwienie wyboru między lokalnym komputerem, mniejszym modelem a usługą hostowaną.
Przełomem jest dostęp do modelu, a nie uniwersalne ulepszenie laptopów
Meta udostępniła Muse Spark Open 15 października 2026 r., opisując model mixture-of-experts o 816B parametrów, z około 42B parametrów aktywnych na token i kontekstem do miliona tokenów. Model jest przeznaczony do programowania i długotrwałej pracy z narzędziami. Wagi można wdrażać za pomocą różnych silników wnioskowania, a nie wyłącznie jednej obowiązkowej aplikacji czatu.
To zmienia, kto może podejmować decyzje wdrożeniowe. Programista może wybrać checkpoint, uruchomić odpowiedni stos serwerowy, zintegrować narzędzia i zdecydować, dokąd aplikacja wysyła informacje. Ma to znaczenie, gdy projekt wymaga odtwarzalnej wersji modelu lub konkretnego sposobu przetwarzania danych. Pojawia się jednak również odpowiedzialność, którą zwykle ukrywa zarządzana subskrypcja czatu: pamięć masowa, aktualizacje, zgodność, monitoring i odzyskiwanie działania.
Nasza ocena: to istotne rozszerzenie wyboru, a nie zniknięcie infrastruktury. Posiadanie wag przypomina posiadanie silnika. Pozwala zbudować inny pojazd, ale nie zapewnia hamulców, warsztatu ani drogi. Warto zapytać, które elementy takiego pojazdu naprawdę chcesz utrzymywać.
W projekcie hobbystycznym właśnie utrzymywanie może być częścią zabawy. Mała firma, która potrzebuje odpowiedzi przed spotkaniem, może uznać to za niepotrzebne rozproszenie. Obie reakcje na tę samą premierę są rozsądne. Model z otwartymi wagami udostępnia decyzję, ale nie podejmuje jej za Ciebie.
42B aktywnych parametrów nie zmienia 816B w mały plik do pobrania
Modele mixture-of-experts wybierają dla każdego tokenu tylko część dostępnych ekspertów. Pomaga to wyjaśnić, dlaczego liczba aktywnych parametrów jest znacznie mniejsza niż całkowita. Nie oznacza to, że niewykorzystywanych ekspertów można po prostu pominąć w zwykłym wdrożeniu pełnego modelu: kolejny token może wymagać innej ścieżki przez model.
Warto rozdzielić trzy budżety. Pierwszy to miejsce na checkpoint. Drugi to pamięć robocza na wagi i środowisko uruchomieniowe. Trzeci to dodatkowy stan rosnący wraz z obciążeniem, w tym cache uwagi i wejścia multimodalne. Spełnienie pierwszego warunku nie dowodzi, że zmieszczą się pozostałe.
Oficjalna karta modelu wymienia wejścia tekstowe, obrazowe, wideo i audio oraz wyjście tekstowe. Opisuje też różne formaty checkpointów i znaczne wymagania pamięciowe. To specyfikacje całej rodziny, a nie obietnica, że każda konwersja zawiera wszystkie enkodery lub osiąga maksymalny kontekst na każdej maszynie.
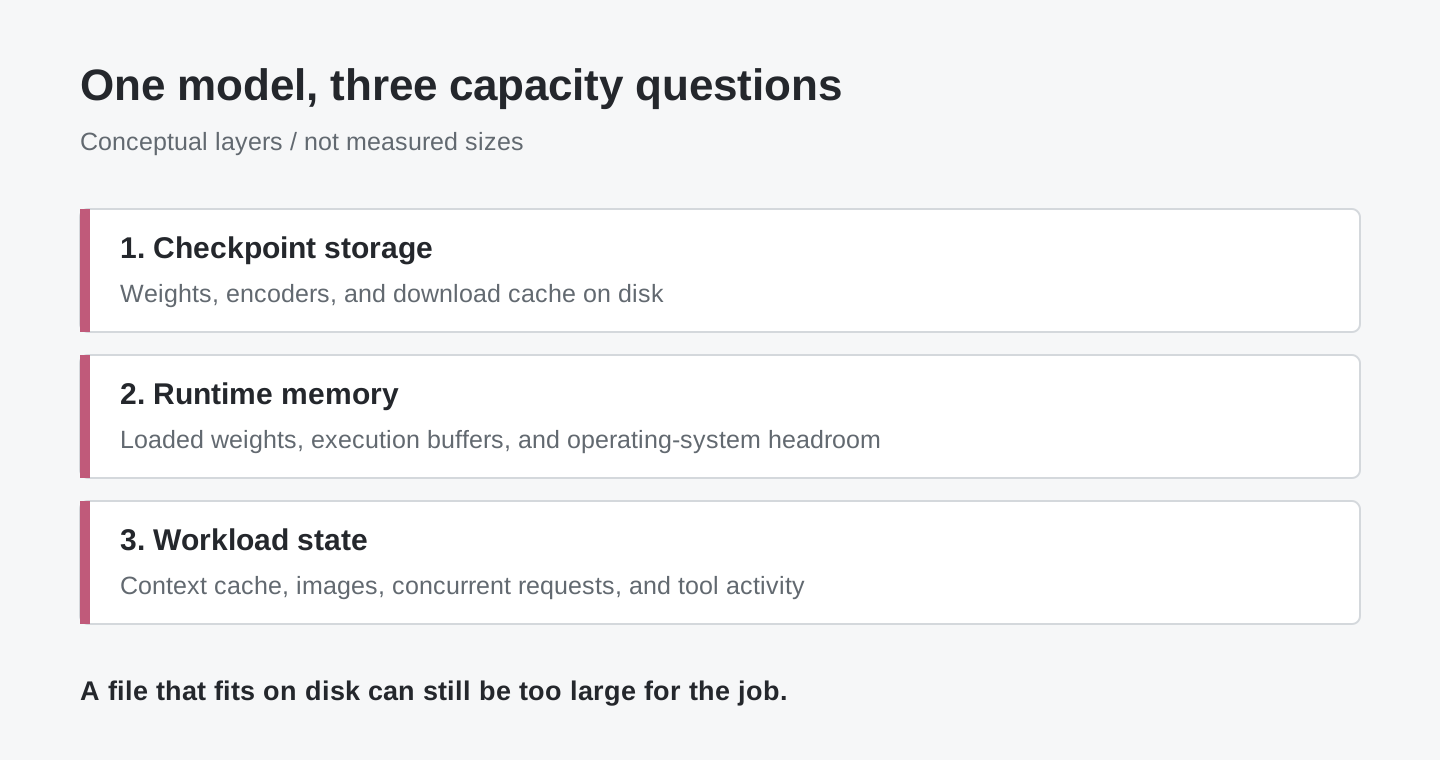
Oryginalny schemat pojęciowy. Pasma pokazują rodzaje wykorzystania pamięci, nie zmierzone proporcje. Sam rozmiar checkpointu nie wystarcza do oszacowania wymagań całego komputera.
Różnica jest szczególnie ważna przy wideo. Krótkie pytanie o obraz i długa analiza wielu klatek nie są tym samym żądaniem tylko dlatego, że oba wykorzystują model obsługujący obraz. Rozsądny pierwszy eksperyment ogranicza wejście i odpowiedź oraz ustala działającą konfigurację bazową przed dodaniem większego archiwum lub dłuższej pętli agenta.
Dwa Mac Studio i jeden Mac z 512 GB opowiadają różne historie
Pokaz Meta wykorzystuje dwa komputery M5 Ultra Mac Studio i MLX. Ogłoszenie mówi o maksymalnie 512 GB zunifikowanej pamięci na maszynę oraz przedstawia lokalne przepływy pracy obejmujące zmiany w aplikacji iOS Ice Cubes i edycję w DaVinci Resolve. To demonstracje Meta, nie pomiary z naszego biurka. Zobacz konfiguracje i przykłady we wpisie premierowym Meta.
Artykuł premierowy Hugging Face przedstawia inną drogę. Opisuje test skwantyzowanego checkpointu oQ3e na M3 Ultra z 512 GB pamięci. Przy promptcie o długości 1,024 tokenów i wygenerowaniu 128 tokenów autorzy podają około 225 tokenów na sekundę podczas prefill i 21 podczas generowania. Wyniki dotyczą tego krótkiego testu i tego checkpointu, nie każdego Maca ani pokazu na dwóch komputerach. Przeczytaj sekcję MLX w artykule technicznym.
Karta checkpointu oQ3e precyzuje jednostki: tensor zajmuje około 344.152 GiB, czyli 369.531 GB. Karta podaje około 370GB w oMLX. Nazywanie tego po prostu „modelem 344GB” zaciera różnicę między jednostkami binarnymi i dziesiętnymi dokładnie tam, gdzie liczy się pozostała pamięć.
| Opublikowana konfiguracja | Co pokazuje | Czego nie należy z niej wnioskować |
|---|---|---|
| Dwa M5 Ultra Mac Studio firmy Meta | Lokalny system z dużą pamięcią i demonstracje agenta | Każda konfiguracja Muse wymaga dokładnie dwóch Maców |
| Hugging Face: M3 Ultra 512GB z oQ3e | Mocniej skwantyzowany przykład na jednej maszynie | Zwykły MacBook ma wystarczającą pamięć |
| Wnioskowanie hostowane | Dostęp bez lokalnego utrzymywania pełnego checkpointu | Praca koniecznie pozostaje na własnym komputerze |
Istnieje jeszcze ważna granica. Konwersja oQ3e zawiera model językowy i enkoder obrazu, ale nie zawiera enkodera audio. Demonstracja głosu i przeglądarki wykorzystująca pełny model nie dowodzi zatem, że ten sam przepływ audio działa z konkretnym pobraniem. Sama nazwa modelu nie zastępuje lektury karty jego wariantu.
Karta oQ4e jeszcze wyraźniej pokazuje kompromis pojemności. Podaje około 475.886GB pamięci tensorów i ostrzega, że to zbyt dużo do niezawodnego używania na jednym Macu z 512GB. Większa liczba bitów może lepiej zachować inną reprezentację wag, jednocześnie pozostawiając mniej miejsca na właściwe zadanie. Zapełnienie pamięci nie jest równoznaczne z wykonaniem pracy.
Obserwuj pętlę narzędzi, nie tylko końcową odpowiedź
Jednym z atrakcyjnych zastosowań jest asystent programistyczny, który może sprawdzić wygląd wprowadzonych zmian. Przykład zasobu 3D od Hugging Face łączy model skwantyzowany, agenta kodującego, Three.js, renderowane widoki przeglądarki i informację zwrotną dotyczącą obrazu. Najciekawsza jest pętla: utwórz artefakt, obejrzyj go, znajdź defekt i popraw.
Wyobraź sobie zastosowanie tego wzorca do prototypu konfiguratora produktu. Agent powinien zauważyć zasłonięty element sterujący lub obiekt poza kadrem, a nie tylko wygenerować składniowo poprawny kod. To przykładowe zastosowanie wzorca, nie twierdzenie, że demonstracja dostarcza gotowy do produkcji konfigurator. Kryteria akceptacji nadal należą do projektu: właściwe kontrolki, wymiary i zachowanie na małym ekranie.
Drugi przykład to demonstracja „Call your Browser”, do której odsyła artykuł Hugging Face. Łączy wypowiedź użytkownika z wizualną interakcją w przeglądarce w celu wyszukania produktów pasujących do opisu. Artykuł Hugging Face zawiera także demonstrację hostowaną w artykule technicznym, która pokazuje interakcję, ale nie sugeruje, że samo zainstalowanie wag tworzy agenta przeglądarkowego. Dostęp do Space może być ograniczony; link na stronie premiery nie gwarantuje działającej, publicznej usługi. Przed użyciem wersji hostowanej sprawdź jej konfigurację i przetwarzanie danych, używając niesensytywnych przykładów.
Trzecim zastosowaniem jest asystent do przeglądu własnych dokumentów i zrzutów ekranu. Można poprosić go o porównanie wymagania tekstowego z obrazem interfejsu i wskazanie rozbieżności. Zadanie korzysta z rozumienia obrazu, ale nie wymaga od razu uprawnień do zmiany plików, wysyłania wiadomości ani dokonywania zakupów. Zacznij od zadania, w którym człowiek może sprawdzić zarówno wejście, jak i proponowaną odpowiedź.
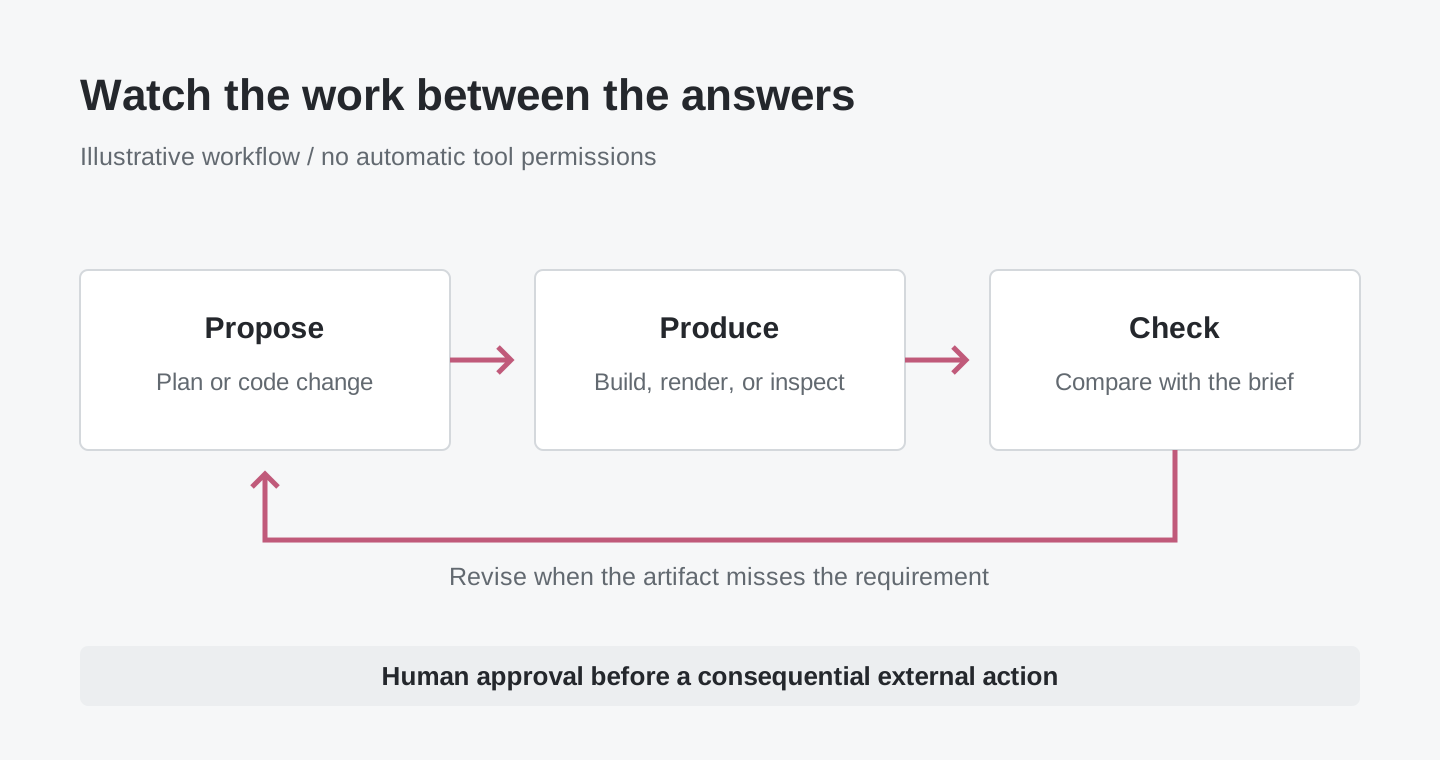
Oryginalna ilustracja przepływu pracy. Pętlę działania zapewniają framework agenta i jego narzędzia; pobranie wag samo w sobie nie daje dostępu do przeglądarki ani systemu plików.
W każdym z tych wzorców szukaj dowodów pośrednich. Czy zadanie kodowe się kompiluje? Czy wyrenderowana strona spełnia wymagania? Czy wybór produktu odpowiada ograniczeniom? Dopieszczony akapit końcowy słabo zastępuje artefakt, który zadanie miało utworzyć.
Zacznij na Macu, nie traktując pobierania jako pierwszego kroku
Najłatwiej najpierw wybrać największy model, a dopiero potem odkryć wymagania sprzętowe. Odwróć tę kolejność. Określ małe zadanie, znajdź obsługiwany checkpoint i sprawdź komputer, zanim przeznaczysz miejsce lub czas.
- Sprawdź pamięć Maca i wolne miejsce. W Terminalu poniższe polecenia pokazują wersję macOS, zainstalowaną pamięć w bajtach i wolne miejsce w woluminie domowym. Nie instalują oprogramowania ani nie pobierają wag.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Wybierz razem obsługiwaną aplikację i checkpoint. Projekt oMLX udostępnia aplikację macOS i dokumentację instalacji. Udokumentowane wymagania obejmują Apple Silicon i macOS 15 lub nowszy. W chwili pisania najnowszym wydaniem jest v0.7.1rc1, czyli kandydat do wydania: oddziel eksperymenty od stacji roboczej potrzebnej do terminowej pracy.
-
Przeczytaj kartę konkretnej konwersji przed wybraniem jej w interfejsie pobierania modeli. Identyfikator przykładu dla jednej maszyny powyżej to
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Uwzględnij checkpoint, pamięć podręczną pobierania, środowisko i planowaną pracę. Mac z 256GB nie spełnia opublikowanych wymagań tego wariantu; skrócenie odpowiedzi do jednego zdania nie zmniejsza miejsca potrzebnego na wagi. -
Zacznij od krótkiego, tymczasowego zadania. Wypróbuj krótkie pytanie tekstowe lub niesensytywny zrzut ekranu z krótką odpowiedzią. Sprawdź, czy model się ładuje i czy wynik jest przydatny, zanim zwiększysz kontekst lub dodasz narzędzia. Pomyślne załadowanie potwierdza zgodność, nie poprawność faktów.
-
Dodaj działania dopiero wtedy, gdy działa przepływ tylko do odczytu. Pracuj na kopii projektu. Ogranicz pliki i narzędzia dostępne agentowi, a przed działaniem zewnętrznym wymagaj potwierdzenia. Zachowuj możliwość przeglądu zmian i nie pozwalaj, by pierwszy eksperyment modyfikował jedyną kopię roboczą.
Preferuj obsługiwany przez aplikację sposób pobierania i wyboru modelu zamiast ogólnej komendy skopiowanej ze strony innego modelu. MLX LM oferuje także ścieżkę wiersza poleceń, ale obsługa modeli i opublikowane wersje mogą zmieniać się w różnym tempie. Pull request dodający obsługę Muse jest przydatnym punktem odniesienia przy sprawdzaniu zgodności wersji, a nie powodem do instalowania dowolnej gałęzi deweloperskiej.
Nie musisz kupować sprzętu, żeby sprawdzić przydatność modelu. Hostowany punkt końcowy może pokazać, jak radzi sobie z reprezentatywnym zadaniem, zanim zaczniesz rozważać lokalne wdrożenie. Najpierw sprawdź ceny dostawcy, przetwarzanie danych i limity wydatków. Publiczna demonstracja to pomoc w nauce, nie bezpłatny backend produkcyjny.
Mierz ukończone zadanie, nie tylko licznik tokenów
Tokeny na sekundę pomagają opisać konfigurację wnioskowania. Nie mówią, czy asystent oszczędził popołudnie, czy stworzył subtelny błąd. Szybsza błędna zmiana może kosztować więcej niż wolniejsza poprawna, zwłaszcza gdy długo działający agent powtarza własne błędne założenia.
Praktyczne porównanie wykorzystuje ten sam niewielki zestaw zadań dla różnych konfiguracji. Uwzględnij zmianę kodu z istniejącym testem, zrzut ekranu ze znanym problemem i pytanie o dokument, na które odpowiedź można powiązać z konkretnym fragmentem. Zachowaj ten sam prompt i kryteria akceptacji. Zapisuj poprawność, czas do uzyskania sprawdzonego wyniku, wymaganą interwencję oraz szczytowe zużycie zasobów, jeśli narzędzia je udostępniają.
Traktuj prefill i generowanie jako różne części oczekiwania. Długie wejście może opóźnić pierwszą odpowiedź, nawet jeśli kolejne tokeny pojawiają się szybko. Agent może też czekać na kompilację, przeglądanie sieci lub inne narzędzie. Uwzględnij ten czas przy porównaniu konfiguracji lokalnej z usługą hostowaną; należy do doświadczenia użytkownika, nawet jeśli przypada poza modelem.
Powtórz porównanie po istotnej aktualizacji checkpointu lub środowiska. Nie potrzeba wielkiego benchmarku, by wykryć, że zmiana zepsuła codzienny przepływ. Kilka reprezentatywnych zadań sprawdzanych konsekwentnie daje więcej niż zrzut ekranu jednej imponującej odpowiedzi.
Otwarte wagi dają wybór, nie gwarantują prywatności ani nieograniczonych praw
Model lokalny może utrzymywać wnioskowanie na twoim komputerze. Cała aplikacja nadal może korzystać z wyszukiwarki internetowej, telemetrii, narzędzi zewnętrznych, zdalnego przechowywania lub modeli awaryjnych hostowanych w chmurze. Zanim nazwiesz przepływ prywatnym, rozrysuj drogę danych w rzeczywistym zastosowaniu. Eksperyment tekstowy offline i agent zakupowy korzystający z przeglądarki mają różne granice, nawet jeśli zaczynają od tego samego checkpointu.
Licencja Muse Model również nakłada warunki. Wymaga przypisania autorstwa i dołączonej polityki użycia, a dla niektórych firm oferujących model jako usługę przewiduje osobne warunki. To niestandardowa licencja na otwarte wagi, a nie ogólna deklaracja nieograniczonej swobody. Sprawdź aktualną licencję pod kątem planowanej dystrybucji lub usługi.
W zespole własność modelu wymaga także odpowiedzi operacyjnych. Kto zatwierdza nową wersję? Kto może przywrócić poprzednią konfigurację? Dokąd trafiają prompty i wyniki narzędzi? Kto sprawdza zmianę przed udostępnieniem klientom? To nie argumenty przeciw lokalnemu wnioskowaniu. Dzięki nim lokalne wnioskowanie staje się niezawodną usługą, a nie jednodniową demonstracją.
Konkluzja: lokalne AI staje się wyborem konfiguracji
Prawdziwy przełom nie polega na tym, że każdy komputer może teraz uruchomić ogromny model. Coraz więcej decyzji wdrożeniowych staje się widocznych i dostępnych dla użytkownika: jakie wagi, jaka konwersja, jaka maszyna, jakie środowisko i jakie narzędzia.
Muse Spark Open konkretyzuje ten wybór. Dwa Maki z dużą pamięcią pokazują jedną drogę, mniejsza konwersja drugą, a wnioskowanie hostowane — kolejny kompromis. Wybierz najmniejszą konfigurację, która niezawodnie wykonuje ważne dla Ciebie zadanie. Następne przydatne pytanie nie brzmi „Czy uda się go załadować?”, lecz „Czy mogę zaufać otrzymanej pracy?”.
Źródła i demonstracje
- Meta: premiera Muse Spark Open, 15 października 2026 r..
- Karta modelu Meta i specyfikacje checkpointu.
- Hugging Face: przewodnik środowiska, warunki testu MLX i demonstracje agentów, 15 października 2026 r..
- Konwersja oQ3e: jednostki pamięci, zawarte enkodery i użycie.
- Konwersja oQ4e: pamięć i ostrzeżenie dotyczące jednej maszyny.
- Dokumentacja instalacji oMLX i wydanie v0.7.1rc1.
- Obsługa Muse w MLX LM.
- Licencja Muse Model.
Informacje o produkcie i zgodności sprawdzone 16 października 2026 r. Podane wartości wydajności pochodzą z pomiarów wydawców i zachowują określone przez nich warunki testu.
Zachowaj decyzję, nie tylko nazwę modelu
Dla osób gromadzących źródła, notatki o konfiguracji i decyzje z przeglądu Telli.sh jest jednym z opcjonalnych miejsc pracy. Utwórz notatkę badawczą.