816B su una scrivania Mac: cosa rende davvero possibile Muse Spark Open
Il modello open-weight di Meta arriva sui Mac con molta memoria. Confronta la configurazione dimostrativa a due Studio con un checkpoint quantizzato più piccolo, guarda le demo e scegli una prima configurazione sensata.
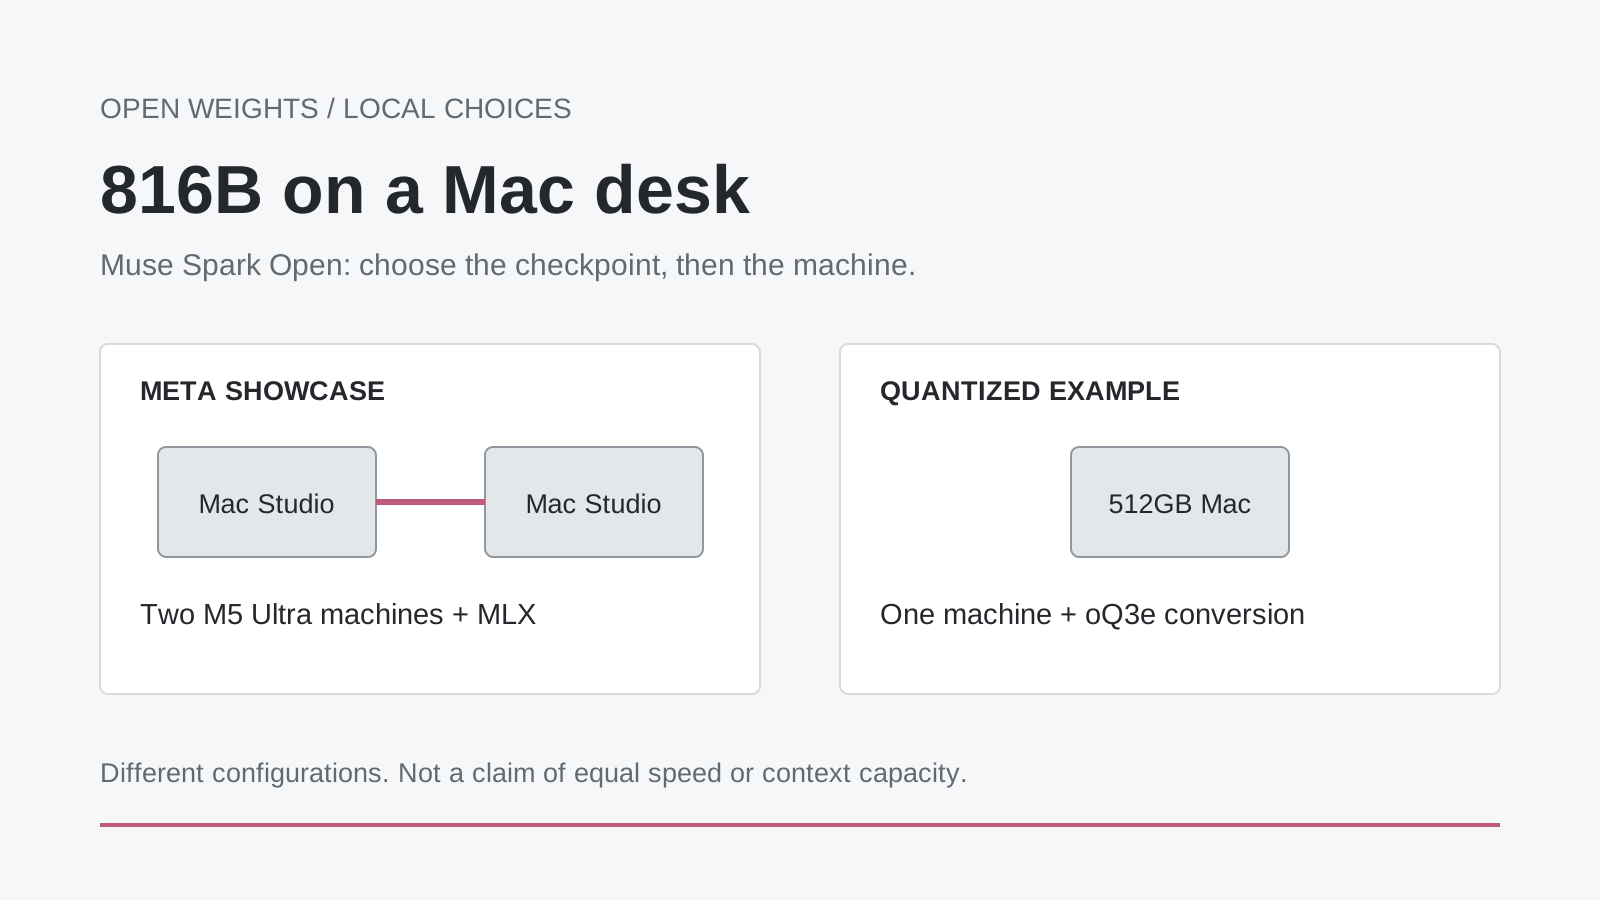
Illustrazione esplicativa originale. La configurazione dimostrativa a due macchine e l'esempio quantizzato su una singola macchina usano configurazioni diverse: non sono risultati prestazionali intercambiabili.
Un modello da 816 miliardi di parametri in esecuzione su una scrivania sembra una contraddizione. La scrivania dell'annuncio di Meta del 15 ottobre, però, ospita due Mac Studio, ciascuno con una dotazione di memoria molto ampia. È una prospettiva diversa dal far girare lo stesso modello sul portatile che possiedi già.
Lo sviluppo più interessante si trova appena sotto quel titolo. Muse Spark Open dà agli sviluppatori accesso ai pesi del modello, mentre gli strumenti circostanti offrono diversi modi per eseguirli. Meta mostra una configurazione a due macchine; Hugging Face descrive anche una versione quantizzata più aggressivamente su un singolo Mac da 512GB. L'IA locale riguarda sempre meno la possibilità teorica di scaricare un modello e sempre più la scelta della rappresentazione e dei limiti operativi giusti.
Questa guida spiega cosa può fare il modello, perché i valori di memoria differiscono, quali demo pubblicate vale la pena guardare e come iniziare in modo utile senza avviare per errore uno scaricamento di centinaia di gigabyte. L'obiettivo non è trasformare ogni lettore in un acquirente di workstation. È chiarire un po' la scelta tra macchina locale, modello più piccolo e servizio ospitato.
La svolta è l'accesso al modello, non un aggiornamento universale dei portatili
Meta ha rilasciato Muse Spark Open il 15 ottobre 2026, presentandolo come un modello mixture-of-experts da 816B parametri, con circa 42B parametri attivi per token e una finestra di contesto fino a un milione di token. Il rilascio è rivolto alla programmazione e alle attività prolungate con uso di strumenti. I pesi possono essere distribuiti tramite più motori di inferenza, invece che con un'unica applicazione di chat obbligatoria.
Questo cambia chi può decidere come distribuire il modello. Uno sviluppatore può scegliere un checkpoint, eseguire uno stack di serving adeguato, integrare strumenti e decidere dove l'applicazione invia i dati. Queste scelte possono essere importanti quando un progetto richiede una versione del modello riproducibile o una specifica gestione dei dati. Portano però anche responsabilità che un abbonamento a una chat gestita di solito nasconde: archiviazione, aggiornamenti, compatibilità, monitoraggio e ripristino.
Il nostro punto di vista è che si tratti di un ampliamento significativo delle possibilità, non della scomparsa dell'infrastruttura. Possedere i pesi somiglia a possedere un motore. Ti permette di costruire un veicolo diverso, ma non ti fornisce i freni, l'officina o la strada. La domanda utile è quali parti di quel veicolo vuoi davvero mantenere.
Per un progetto amatoriale, occuparsene può essere proprio lo scopo. Per una piccola impresa che ha bisogno di una risposta prima di una riunione, può essere una distrazione inutile. Sono entrambe reazioni ragionevoli allo stesso rilascio. Un modello open-weight rende possibile la scelta; non la decide al posto tuo.
42B parametri attivi non trasformano 816B in un piccolo download
I modelli mixture-of-experts selezionano solo una parte della capacità degli esperti per ogni token. Questo aiuta a spiegare perché il conteggio dei parametri attivi sia molto inferiore al totale. Non significa che in una normale distribuzione del modello completo si possano semplicemente omettere gli esperti inattivi: un altro token potrebbe aver bisogno di un percorso diverso nel modello.
È utile distinguere tre budget. Il primo è lo spazio per il checkpoint. Il secondo è la memoria di lavoro per i pesi e il runtime. Il terzo è lo stato aggiuntivo che cresce con il carico, inclusi la cache di attenzione e gli input multimodali. Superare il primo test non dimostra che gli altri due ci stiano.
La scheda ufficiale del modello elenca input di testo, immagini, video e audio, con output testuale. Riporta inoltre formati di checkpoint diversi e requisiti di memoria considerevoli. Sono specifiche per l'intera famiglia di modelli, non la promessa che ogni checkpoint convertito includa tutti gli encoder o raggiunga il contesto massimo su qualsiasi macchina.
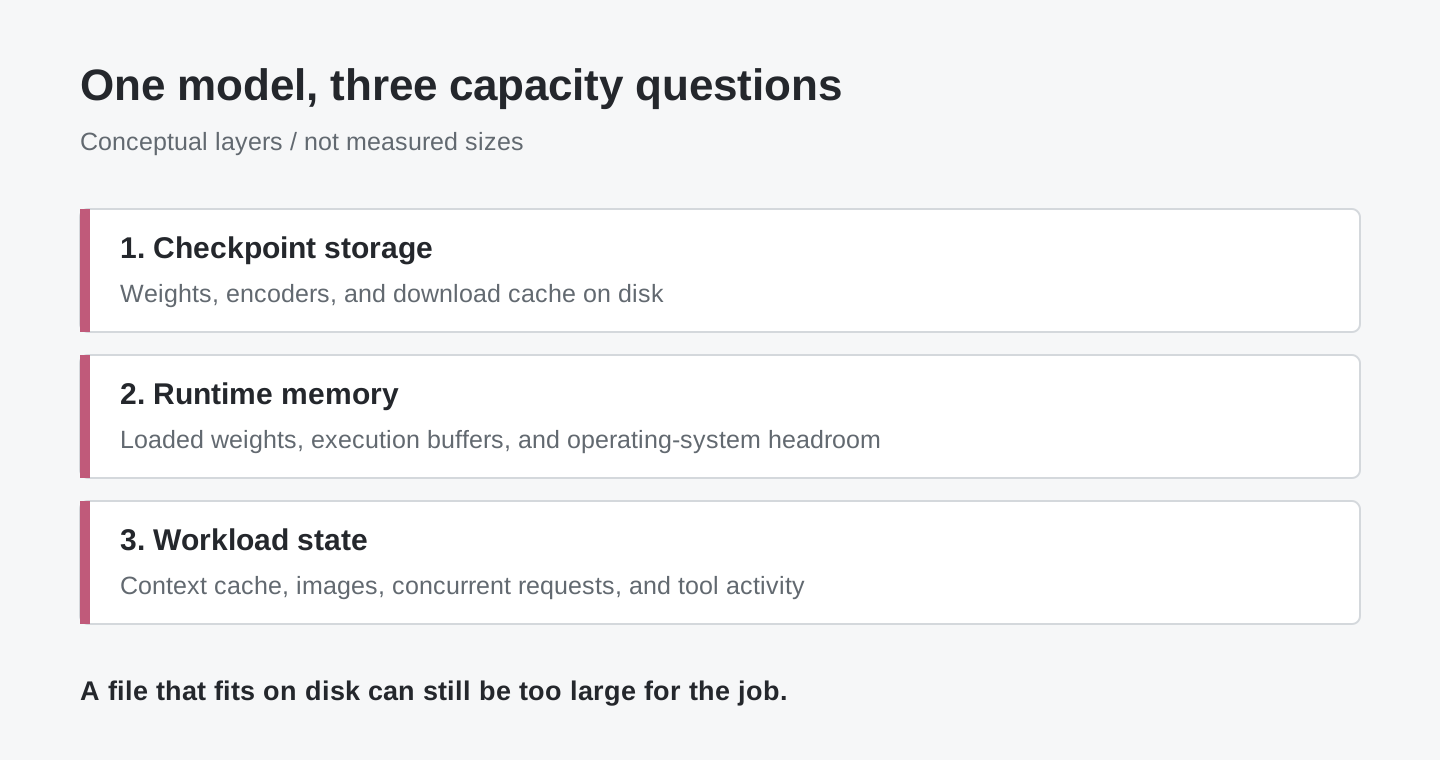
Diagramma concettuale originale. Le fasce identificano tipi di utilizzo della memoria, non proporzioni misurate. La sola dimensione del checkpoint non stima la capacità necessaria per l'intera macchina.
Questa distinzione diventa particolarmente importante con il video. Una breve domanda su un'immagine e un'analisi lunga di molti fotogrammi non sono la stessa richiesta solo perché entrambe usano un modello capace di elaborare immagini. Un primo esperimento sensato mantiene piccolo l'input, limita la risposta e stabilisce una base funzionante prima di aggiungere un archivio più grande o un ciclo di agent più lungo.
Due Mac Studio e un Mac da 512GB raccontano storie diverse
La dimostrazione di Meta usa due Mac Studio M5 Ultra e MLX. L'annuncio descrive fino a 512GB di memoria unificata per macchina e riporta flussi di lavoro locali che comprendono modifiche all'applicazione iOS Ice Cubes e interventi in DaVinci Resolve. Sono dimostrazioni di Meta, non misurazioni dalla nostra scrivania. Guarda le configurazioni e gli esempi nel post di lancio di Meta.
L'articolo di lancio di Hugging Face segue un'altra strada. Descrive test di un checkpoint quantizzato oQ3e su un M3 Ultra con 512GB di memoria. Con un prompt di 1.024 token e 128 token generati, gli autori riportano circa 225 token al secondo durante il prefill e 21 durante la generazione. Questi valori riguardano quel breve test e quel checkpoint, non ogni Mac né la configurazione dimostrativa a due macchine. Leggi la sezione MLX dell'articolo tecnico.
La scheda del checkpoint oQ3e offre un'importante precisazione sulle unità: l'archiviazione dei tensori è circa 344.152 GiB, ovvero 369.531 GB. La scheda descrive circa 370GB in oMLX. Chiamarlo semplicemente «modello da 344GB» confonde unità binarie e decimali proprio quando conta lo spazio di memoria residuo.
| Percorso pubblicato | Cosa illustra | Cosa non si dovrebbe dedurre |
|---|---|---|
| I due Mac Studio M5 Ultra di Meta | Una distribuzione locale con molta memoria e demo con agent | Che ogni configurazione di Muse richieda esattamente due Mac |
| M3 Ultra da 512GB di Hugging Face con oQ3e | Un esempio quantizzato più aggressivamente su una sola macchina | Che un normale MacBook abbia memoria sufficiente |
| Inferenza ospitata | Accesso senza mantenere localmente il checkpoint completo | Che il lavoro resti necessariamente sul tuo computer |
C'è un altro limite importante. La conversione oQ3e include il modello linguistico e l'encoder visivo, ma non l'encoder audio. Una demo vocale e con browser che usa il modello completo non dimostra quindi che lo stesso flusso audio funzioni con questo specifico download. Il nome di un modello non sostituisce la lettura della scheda della sua variante.
La scheda oQ4e rende ancora più esplicito il compromesso di capacità. Indica circa 475.886GB di archiviazione dei tensori e avverte che sono troppi per un uso affidabile su un singolo Mac da 512GB. Più bit possono preservare una rappresentazione diversa dei pesi lasciando però meno spazio al lavoro vero e proprio. Riempire la memoria non equivale a portare a termine un'attività.
Osserva il ciclo degli strumenti, non solo la risposta finale
Un caso d'uso interessante è un assistente di programmazione capace di controllare l'aspetto delle proprie modifiche. L'esempio di asset 3D di Hugging Face combina un modello quantizzato, un agent di programmazione, Three.js, visualizzazioni renderizzate nel browser e feedback visivo. La parte interessante è il ciclo: generare un artefatto, osservarlo, individuare un difetto e correggerlo.
Immagina di usare questo schema per prototipare un configuratore di prodotto. Vorresti che l'agent notasse un controllo nascosto o un oggetto fuori dall'inquadratura, non che producesse soltanto codice sintatticamente valido. È un'applicazione illustrativa dello schema, non l'affermazione che la demo fornisca già un configuratore pronto per la produzione. Il test di accettazione resta responsabilità del progetto: i controlli giusti, le dimensioni giuste e il comportamento corretto su uno schermo piccolo.
Un secondo esempio è la dimostrazione «Call your Browser», collegata dall'articolo di Hugging Face. Combina input vocale e interazione visiva con il browser per cercare prodotti corrispondenti a una descrizione. La demo ospitata nell'articolo tecnico mostra l'interazione senza suggerire che installare i pesi basti a creare un agent browser. Lo Space collegato potrebbe richiedere accesso: non dare per scontato che il link della pagina di lancio garantisca un servizio pubblico eseguibile. Prima di provare una versione ospitata, verifica configurazione e gestione dei dati e usa esempi non sensibili.
Un terzo caso d'uso è un assistente per rivedere i tuoi documenti e screenshot. Per esempio, potresti chiedergli di confrontare un requisito scritto con l'immagine di un'interfaccia e di elencare le discrepanze. Il compito beneficia della comprensione delle immagini senza concedere subito al sistema il permesso di modificare file, inviare messaggi o acquistare qualcosa. Inizia con un'attività per cui una persona possa ispezionare sia l'input sia la risposta proposta.
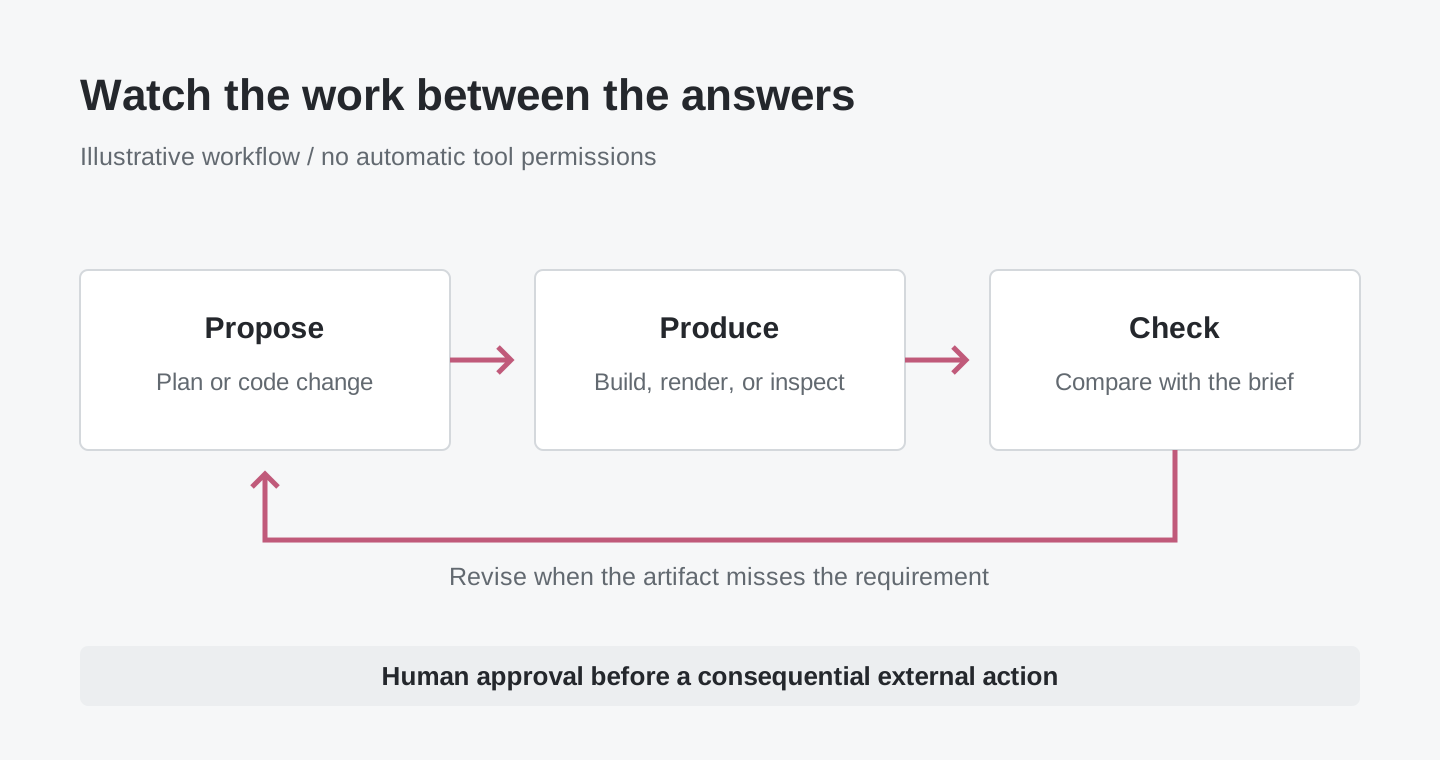
Illustrazione originale del flusso di lavoro. Il framework agent e i suoi strumenti forniscono il ciclo d'azione; scaricare i pesi del modello non concede di per sé accesso al browser o al file system.
Per tutti e tre gli schemi, cerca prove intermedie. Un'attività di programmazione è stata compilata? La pagina renderizzata rispetta il requisito? Una scelta di prodotto soddisfa i vincoli dichiarati? Un paragrafo finale ben scritto non sostituisce l'artefatto che l'attività doveva creare.
Inizia su un Mac senza considerare «download» il primo passo
L'errore più facile è scegliere prima il modello più grande e scoprire a metà strada i requisiti di capacità. Inverti l'ordine. Decidi un'attività piccola, individua un checkpoint supportato e controlla la macchina prima di impegnare spazio o tempo.
- Controlla memoria e spazio di archiviazione libero del Mac. In Terminale, i comandi qui sotto mostrano la versione di macOS, la memoria installata in byte e lo spazio libero nel volume home. Non installano software né scaricano pesi.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Scegli insieme un'applicazione supportata e un checkpoint. Il progetto oMLX offre un'applicazione macOS e documentazione per l'installazione. I prerequisiti documentati includono Apple Silicon e macOS 15 o successivo. Al momento della stesura, l'ultima versione è v0.7.1rc1, una release candidate: tieni separati gli esperimenti dalla workstation da cui dipendono le tue scadenze.
-
Leggi la scheda della conversione esatta prima di selezionarla nell'interfaccia di download del modello. Per l'esempio su una singola macchina qui sopra, l'identificativo è
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Prevedi spazio per il checkpoint, la cache di download, il runtime e il lavoro che vuoi svolgere. Un Mac da 256GB è al di sotto del requisito pubblicato per questa variante; ridurre una risposta a una frase non elimina lo spazio necessario per archiviare i pesi. -
Inizia con un'attività breve e sacrificabile. Prova una piccola domanda testuale o uno screenshot non sensibile con una risposta breve. Verifica che il modello si carichi e che il risultato sia utile prima di aumentare il contesto o aggiungere strumenti. Un caricamento riuscito dimostra compatibilità, non accuratezza fattuale.
-
Aggiungi azioni solo dopo che il flusso in sola lettura funziona. Lavora su una copia del progetto. Limita i file e gli strumenti accessibili all'agent e richiedi conferma prima di qualsiasi azione esterna. Mantieni le modifiche verificabili invece di lasciare che il primo esperimento alteri l'unica copia di lavoro.
Preferisci il percorso di download e selezione dei modelli supportato dall'applicazione a un comando generico copiato dalla pagina di un altro modello. Anche MLX LM offre un percorso da riga di comando, ma il supporto dei modelli e le versioni distribuite possono evolvere a velocità diverse. La sua pull request per il supporto Muse è un riferimento utile per la compatibilità quando scegli una versione, non un motivo per installare un ramo di sviluppo arbitrario.
Non devi acquistare hardware per capire l'utilità del modello. Un endpoint ospitato può rispondere alla domanda se gestisce la tua attività rappresentativa prima che tu esamini una distribuzione locale. Verifica prima prezzi, gestione dei dati e limiti di spesa del provider. Una demo pubblica è un ausilio per imparare, non un backend di produzione gratuito.
Misura un'attività completata, non solo il contatore dei token
I token al secondo aiutano a descrivere una configurazione di inferenza. Non dicono se l'assistente ti ha risparmiato un pomeriggio o ha creato un errore sottile. Una modifica errata più veloce può costare più di una corretta ma lenta, soprattutto quando un agent di lunga durata ripete le proprie supposizioni sbagliate.
Un confronto pratico usa la stessa piccola raccolta di attività tra le configurazioni candidate. Includi una modifica al codice con un test esistente, uno screenshot con un problema noto e una domanda su un documento la cui risposta sia rintracciabile in un passaggio. Mantieni stabili prompt e criteri di accettazione. Poi registra correttezza, tempo necessario per ottenere un risultato revisionato, interventi richiesti e picco di risorse se gli strumenti lo espongono.
Considera prefill e generazione come fasi diverse dell'attesa. Un input lungo può rallentare la prima risposta anche se i token successivi arrivano in fretta. Un agent può anche impiegare tempo a compilare, navigare o attendere un altro strumento. Conta questo tempo quando confronti una configurazione locale con un servizio ospitato: fa parte dell'esperienza dell'utente anche se avviene fuori dal modello.
Ripeti il confronto dopo un aggiornamento significativo del checkpoint o del runtime. Non serve un benchmark ambizioso per scoprire che una modifica ha guastato il flusso di lavoro abituale. Poche attività rappresentative, verificate in modo coerente, sono più utili dello screenshot di un'unica risposta impressionante.
I pesi open offrono possibilità, non privacy automatica o diritti illimitati
Un modello locale può mantenere l'inferenza sulla tua macchina. L'applicazione completa può comunque usare ricerca web, telemetria, strumenti esterni, archiviazione remota o modelli di fallback ospitati. Traccia il percorso dei dati del flusso effettivo prima di definirlo privato. Un esperimento testuale offline e un agent browser per gli acquisti hanno confini diversi anche se partono dallo stesso checkpoint.
Anche la licenza Muse Model prevede condizioni. Richiede attribuzione e una policy d'uso allegata e include termini separati per alcune attività di model-as-a-service. È un rilascio personalizzato di pesi open, non l'affermazione generale che qualsiasi uso sia senza restrizioni. Controlla la licenza corrente per la distribuzione o il servizio che intendi offrire.
Per un team, la responsabilità dovrebbe includere una risposta operativa oltre a quella legale. Chi approva una nuova versione del modello? Chi può ripristinare la configurazione precedente? Dove finiscono prompt e risultati degli strumenti? Chi revisiona una modifica prima che raggiunga un cliente? Queste domande non sono argomenti contro l'inferenza locale. Sono ciò che trasforma l'inferenza locale in un servizio affidabile invece che in una demo di un giorno.
In sintesi: l'IA locale diventa una scelta di configurazione
La vera tappa non è che ora ogni computer possa eseguire un modello enorme. È che una parte maggiore delle decisioni di distribuzione diventa visibile e accessibile all'utente: quali pesi, quale conversione, quale macchina, quale runtime e quali strumenti.
Muse Spark Open rende concreta questa scelta. Due Mac con molta memoria dimostrano un percorso; una conversione più piccola ne dimostra un altro; l'inferenza ospitata offre ancora un diverso compromesso. Scegli la configurazione più piccola che completa in modo affidabile l'attività che ti interessa. La prossima domanda utile non è «Riesco a caricarlo?», ma «Posso fidarmi del lavoro che ricevo?»
Fonti e dimostrazioni
- Meta: lancio di Muse Spark Open, 15 ottobre 2026.
- Scheda del modello e specifiche dei checkpoint di Meta.
- Hugging Face: guida al runtime, condizioni del test MLX e demo di agent, 15 ottobre 2026.
- Conversione oQ3e: unità di archiviazione, encoder inclusi e uso.
- Conversione oQ4e: archiviazione e avvertenza sull'uso su una singola macchina.
- Documentazione di installazione oMLX e release v0.7.1rc1.
- Supporto Muse in MLX LM.
- Licenza Muse Model.
Informazioni su prodotti e compatibilità verificate il 16 ottobre 2026. Le cifre prestazionali sono misurazioni attribuite agli editori e riportate con le condizioni di test dichiarate.
Conserva le decisioni, non solo il nome del modello
Per chi raccoglie link alle fonti, note di configurazione e decisioni di revisione, Telli.sh è uno spazio di lavoro facoltativo. Crea una nota di ricerca.