816B sur un bureau Mac : ce que Muse Spark Open rend vraiment possible
Le modèle à poids ouverts de Meta arrive sur les Mac à grande mémoire. Comparez la configuration à deux Mac Studio et un checkpoint quantifié plus petit, découvrez les démonstrations et choisissez une première configuration adaptée.
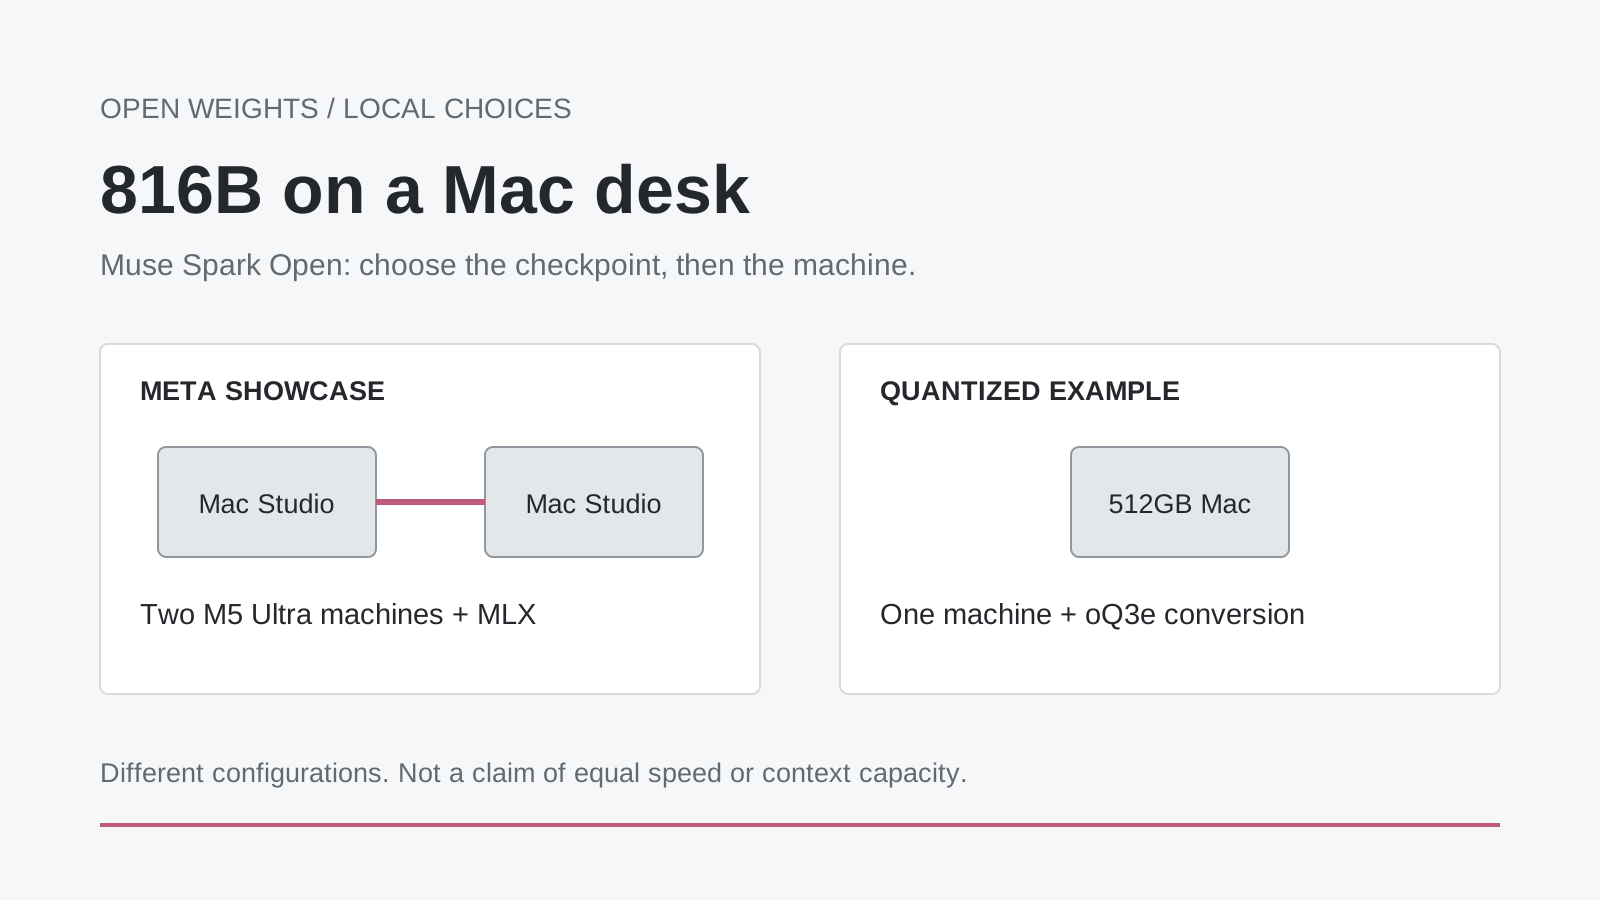
Illustration explicative originale. La démonstration sur deux machines et l’exemple quantifié sur une seule machine reposent sur des configurations différentes ; leurs résultats de performances ne sont pas interchangeables.
Faire tourner sur un bureau un modèle de 816 milliards de paramètres semble contradictoire. Pourtant, le bureau présenté dans l’annonce de Meta du 15 octobre accueille deux Mac Studio, chacun doté d’une très grande capacité mémoire. C’est une tout autre perspective que d’installer le même modèle sur l’ordinateur portable que vous possédez déjà.
Le développement le plus intéressant se trouve juste sous ce gros titre. Muse Spark Open donne aux développeurs accès aux poids du modèle, et les outils qui l’entourent proposent plusieurs façons de les exécuter. Meta montre une configuration à deux machines ; Hugging Face décrit aussi une version davantage quantifiée sur un seul Mac de 512GB. L’IA locale dépend de moins en moins de la possibilité théorique de télécharger un modèle et de plus en plus du choix de la bonne représentation et de la bonne enveloppe opérationnelle.
Ce guide explique ce que le modèle peut faire, pourquoi les chiffres de mémoire diffèrent, quelles démonstrations publiées méritent votre attention et comment faire un premier essai utile sans lancer par mégarde un téléchargement de plusieurs centaines de gigaoctets. Il ne s’agit pas de convaincre chaque lecteur d’acheter une station de travail, mais de clarifier le choix entre une machine locale, un modèle plus petit et un service hébergé.
La nouveauté, c’est l’accès au modèle, pas une mise à niveau universelle des portables
Meta a publié Muse Spark Open le 15 octobre 2026, le décrivant comme un modèle à mélange d’experts de 816B paramètres, dont environ 42B sont actifs par jeton, avec une fenêtre de contexte pouvant atteindre un million de jetons. Cette version vise le codage et les tâches étendues utilisant des outils. Ses poids peuvent être déployés avec plusieurs moteurs d’inférence, plutôt qu’avec une seule application de chat obligatoire.
Cela change qui peut prendre les décisions de déploiement. Un développeur peut choisir un checkpoint, exécuter une pile de service adaptée, intégrer des outils et décider où l’application envoie les informations. Ces choix comptent lorsqu’un projet exige une version de modèle reproductible ou une gestion particulière des données. Ils entraînent aussi des responsabilités qu’un abonnement à un chat géré masque généralement : stockage, mises à niveau, compatibilité, surveillance et reprise.
À notre avis, il s’agit d’un élargissement considérable des choix, pas de la disparition de l’infrastructure. Posséder les poids ressemble à posséder un moteur. Vous pouvez construire un véhicule différent, mais les freins, l’atelier et la route ne sont pas fournis. La question utile est de savoir quelles parties de ce véhicule vous souhaitez réellement entretenir.
Pour un projet de loisir, cet entretien peut être le but même de l’exercice. Pour une petite entreprise qui a besoin d’une réponse avant une réunion, il peut s’agir d’une distraction superflue. Ces deux réactions à la même annonce sont raisonnables. Un modèle à poids ouverts vous laisse choisir ; il ne choisit pas à votre place.
42B paramètres actifs ne transforment pas 816B en petit téléchargement
Les modèles à mélange d’experts ne sélectionnent qu’une partie de leur capacité d’experts pour chaque jeton. Cela explique en partie pourquoi le nombre de paramètres actifs est bien inférieur au total. Cela ne signifie pas que les experts inutilisés peuvent simplement être omis d’un déploiement normal du modèle complet : un autre jeton peut emprunter un autre parcours dans le modèle.
Il faut distinguer trois budgets. Le premier concerne le stockage du checkpoint. Le deuxième est la mémoire de travail nécessaire aux poids et à l’environnement d’exécution. Le troisième correspond à l’état supplémentaire qui augmente avec la charge, notamment le cache d’attention et les entrées multimodales. Réussir le premier test ne prouve pas que les deux autres tiendront.
La fiche officielle du modèle indique des entrées texte, image, vidéo et audio, avec une sortie textuelle. Elle répertorie également différents formats de checkpoint et des besoins mémoire importants. Ce sont les caractéristiques de la famille complète, pas la promesse que chaque checkpoint converti contient tous les encodeurs ou atteint le contexte maximal sur toutes les machines.
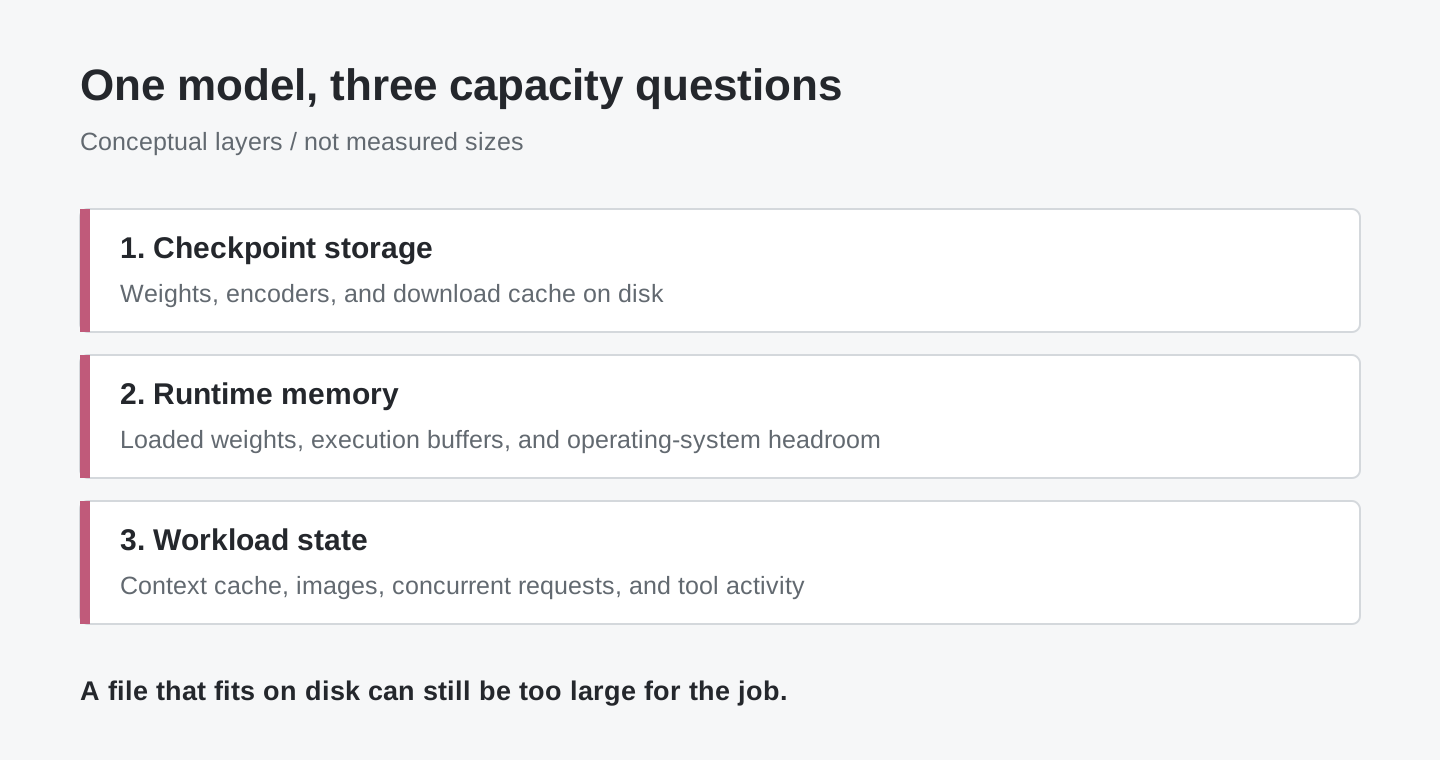
Schéma conceptuel original. Les bandes représentent des catégories d’utilisation mémoire, pas des proportions mesurées. La taille du checkpoint ne suffit pas à estimer la capacité requise de toute la machine.
Cette distinction est particulièrement importante pour la vidéo. Une courte question sur une image et l’analyse approfondie de nombreuses images ne constituent pas la même requête, même si les deux utilisent un modèle capable de traiter la vision. Pour un premier essai raisonnable, gardez une petite entrée, limitez la réponse et établissez une base de fonctionnement avant d’ajouter une archive plus volumineuse ou une boucle d’agent plus longue.
Deux Mac Studio et un Mac de 512GB racontent des histoires différentes
La démonstration de Meta utilise deux Mac Studio M5 Ultra et MLX. Son annonce mentionne jusqu’à 512GB de mémoire unifiée par machine et présente des workflows locaux comprenant des modifications de l’application iOS Ice Cubes et du montage dans DaVinci Resolve. Ce sont les démonstrations de Meta, pas des mesures réalisées sur notre bureau. Consultez les configurations et les exemples dans l’annonce de lancement de Meta.
L’article de lancement de Hugging Face suit une autre voie. Il décrit un test du checkpoint quantifié oQ3e sur un M3 Ultra doté de 512GB de mémoire. Pour une invite de 1,024 jetons et 128 jetons générés, ses auteurs rapportent environ 225 jetons par seconde pendant le préremplissage et 21 pendant la génération. Ces chiffres concernent ce test court et ce checkpoint, pas tous les Mac ni la configuration à deux machines. Consultez la section MLX de l’article technique.
La fiche du checkpoint oQ3e apporte une correction d’unités utile : le stockage de ses tenseurs représente environ 344.152 GiB, soit 369.531 GB. La fiche indique environ 370GB dans oMLX. Parler simplement d’un « modèle de 344GB » brouille les unités binaires et décimales précisément là où la mémoire restante compte.
| Parcours publié | Ce qu’il illustre | Ce qu’il ne faut pas en déduire |
|---|---|---|
| Les deux Mac Studio M5 Ultra de Meta | Un déploiement local à grande mémoire et des démonstrations d’agent | Que toute configuration Muse nécessite exactement deux Mac |
| Le M3 Ultra de 512GB de Hugging Face avec oQ3e | Un exemple sur une seule machine, davantage quantifié | Qu’un MacBook ordinaire dispose d’assez de mémoire |
| Inférence hébergée | Un accès sans entretenir localement le checkpoint complet | Que le traitement reste nécessairement sur votre ordinateur |
Il existe une autre limite importante. La conversion oQ3e comprend le modèle de langage et l’encodeur de vision, mais pas l’encodeur audio. Une démonstration vocale et de navigation web utilisant le modèle complet ne prouve donc pas que le même workflow audio fonctionne avec ce téléchargement précis. Le nom d’un modèle ne remplace pas la lecture de la fiche de sa variante.
La fiche oQ4e rend le compromis de capacité encore plus explicite. Elle indique environ 475.886GB de stockage de tenseurs et avertit que c’est trop pour une utilisation fiable sur un seul Mac de 512GB. Un plus grand nombre de bits peut préserver une représentation différente des poids, tout en laissant moins de place au travail lui-même. Remplir la mémoire ne signifie pas terminer le travail.
Observez la boucle d’outils, pas seulement la réponse finale
Un cas d’usage intéressant est celui d’un assistant de programmation capable d’examiner le résultat de ses modifications. L’exemple de ressource 3D de Hugging Face combine un modèle quantifié, un agent de programmation, Three.js, des vues rendues dans le navigateur et un retour visuel. L’intérêt réside dans la boucle : produire un artefact, l’observer, repérer un défaut et le corriger.
Imaginez utiliser cette approche pour prototyper un configurateur de produit. Vous voudriez que l’agent remarque un contrôle masqué ou un objet hors du cadre de la caméra, et pas seulement qu’il génère du code syntaxiquement valide. Il s’agit d’une application illustrative de cette approche, pas de l’affirmation que la démonstration fournit déjà un configurateur prêt pour la production. Le projet doit toujours définir ses critères d’acceptation : les bons contrôles, les bonnes dimensions et le bon comportement sur un petit écran.
Un deuxième exemple est la démonstration « Call your Browser », citée dans l’article de Hugging Face. Elle combine une entrée vocale et une interaction visuelle avec le navigateur pour chercher des produits correspondant à une description. La démonstration hébergée dans l’article technique montre l’interaction sans laisser entendre que l’installation des poids suffit à créer un agent de navigation. L’accès au Space associé peut être restreint ; ne supposez pas que son lien de lancement garantit un service public exécutable. Avant d’essayer une version hébergée, examinez sa configuration et le traitement des données, et utilisez des exemples non sensibles.
Un troisième cas est un assistant de révision de vos propres documents et captures d’écran. Vous pourriez, par exemple, lui demander de comparer une exigence écrite à l’image d’une interface et d’énumérer les écarts. Cette tâche bénéficie de la compréhension des images sans donner immédiatement au système l’autorisation de modifier des fichiers, d’envoyer des messages ou d’effectuer des achats. Commencez par une tâche dont une personne peut examiner l’entrée comme la réponse proposée.
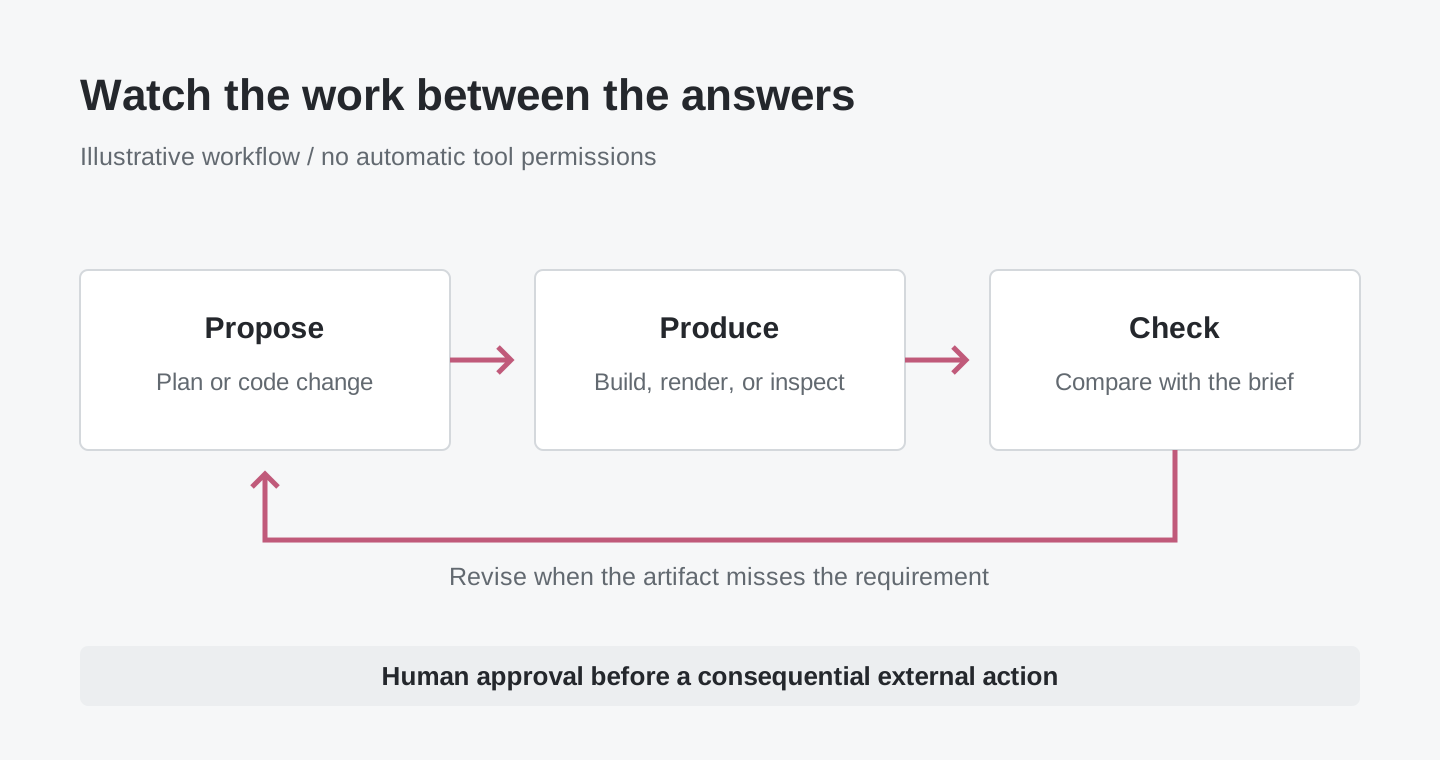
Illustration originale du workflow. Le framework d’agent et ses outils fournissent la boucle d’action ; télécharger les poids du modèle ne donne pas à lui seul accès au navigateur ou au système de fichiers.
Pour ces trois approches, recherchez des éléments intermédiaires vérifiables. Le code a-t-il été compilé ? La page rendue respecte-t-elle l’exigence ? Le choix du produit répond-il aux contraintes énoncées ? Un paragraphe final bien tourné remplace mal l’artefact que la tâche devait produire.
Commencez sur Mac sans faire du « téléchargement » la première étape
L’erreur la plus facile consiste à choisir d’abord le plus grand modèle, puis à découvrir à mi-chemin les exigences de capacité. Faites l’inverse. Choisissez une petite tâche, identifiez un checkpoint pris en charge et vérifiez la machine avant d’y consacrer du stockage ou du temps.
- Vérifiez la mémoire du Mac et l’espace de stockage libre. Dans Terminal, les commandes ci-dessous affichent la version de macOS, la mémoire installée en octets et l’espace libre sur le volume personnel. Elles n’installent aucun logiciel et ne téléchargent pas de poids.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Choisissez ensemble une application et un checkpoint pris en charge. Le projet oMLX fournit une application macOS et sa documentation d’installation. Parmi les prérequis documentés figurent Apple Silicon et macOS 15 ou version ultérieure. À la date de rédaction, la dernière version est v0.7.1rc1, une version candidate : gardez les essais expérimentaux à l’écart d’une station de travail dont vous dépendez pour respecter des échéances.
-
Lisez la fiche de la conversion exacte avant de la sélectionner dans l’interface de téléchargement des modèles. Pour l’exemple sur une seule machine ci-dessus, l’identifiant est
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Prévoyez de la place pour le checkpoint, le cache de téléchargement, l’environnement d’exécution et le travail voulu. Un Mac de 256GB est inférieur aux exigences publiées pour cette variante ; réduire la réponse à une phrase ne supprime pas le stockage nécessaire aux poids. -
Commencez par une tâche courte et jetable. Essayez une petite question textuelle ou une capture d’écran non sensible avec une réponse brève. Vérifiez que le modèle se charge et que le résultat est utile avant d’augmenter le contexte ou d’ajouter des outils. Un chargement réussi confirme la compatibilité, pas l’exactitude factuelle.
-
N’ajoutez des actions qu’une fois le workflow en lecture seule maîtrisé. Travaillez sur une copie du projet. Limitez les fichiers et outils accessibles à l’agent et exigez une confirmation avant toute action externe. Gardez les modifications révisables au lieu de laisser le premier essai toucher à votre unique copie de travail.
Privilégiez le parcours de téléchargement et de sélection des modèles pris en charge par l’application plutôt qu’une commande générique copiée depuis la page d’un autre modèle. MLX LM propose également une interface en ligne de commande, mais la prise en charge des modèles et les versions empaquetées peuvent évoluer à des rythmes différents. Sa pull request de prise en charge de Muse est une référence utile pour la compatibilité, pas une raison d’installer une branche de développement quelconque.
Vous n’avez pas besoin d’acheter du matériel pour comprendre l’utilité du modèle. Un point d’accès hébergé peut vous indiquer s’il traite votre tâche représentative avant d’envisager un déploiement local. Examinez d’abord les tarifs du fournisseur, le traitement des données et les limites de dépenses. Une démonstration publique est un outil d’apprentissage, pas un backend de production gratuit.
Évaluez le travail terminé, pas seulement le compteur de jetons
Le nombre de jetons par seconde aide à décrire une configuration d’inférence. Il ne dit pas si l’assistant vous a fait gagner un après-midi ou a créé une erreur subtile. Une modification erronée plus rapide peut coûter plus cher qu’une modification correcte plus lente, surtout lorsqu’un agent de longue durée répète ses propres suppositions erronées.
Pour une comparaison pratique, exécutez le même petit ensemble de tâches sur les configurations candidates. Incluez une modification de code couverte par un test existant, une capture d’écran présentant un problème connu et une question sur un document dont la réponse peut être reliée à un passage. Gardez l’invite et les critères d’acceptation constants. Notez ensuite l’exactitude, le délai avant un résultat révisé, les interventions nécessaires et l’utilisation maximale des ressources si vos outils l’exposent.
Considérez le préremplissage et la génération comme deux parties différentes de l’attente. Une longue entrée peut retarder la première réponse même si les jetons suivants arrivent rapidement. Un agent peut aussi passer du temps à compiler, naviguer ou attendre un autre outil. Tenez compte de ce délai pour comparer une configuration locale à un service hébergé : il fait partie de l’expérience utilisateur même s’il se situe hors du modèle.
Répétez la comparaison après une mise à jour importante du checkpoint ou de l’environnement d’exécution. Il n’est pas nécessaire de mener un grand benchmark pour détecter qu’une modification a cassé votre workflow habituel. Quelques tâches représentatives, évaluées systématiquement, sont plus utiles qu’une capture d’écran d’une seule réponse impressionnante.
Les poids ouverts offrent des choix, pas une confidentialité automatique ni des droits illimités
Un modèle local peut maintenir l’inférence sur votre machine. L’application complète peut toujours utiliser la recherche web, la télémétrie, des outils externes, un stockage distant ou des modèles de secours hébergés. Cartographiez le parcours des données du workflow réel avant de le qualifier de privé. Une expérience textuelle hors ligne et un agent d’achat dans le navigateur ont des limites différentes, même s’ils partent du même checkpoint.
La licence Muse Model prévoit également des conditions. Elle exige une attribution et une politique d’utilisation associée, et comporte des conditions distinctes pour certaines entreprises proposant le modèle en tant que service. Il s’agit d’une publication personnalisée à poids ouverts, pas d’une affirmation générale selon laquelle tous les usages seraient libres de restrictions. Consultez la licence en vigueur pour la distribution ou le service envisagé.
Pour une équipe, la responsabilité doit avoir une réponse opérationnelle autant que juridique. Qui approuve une nouvelle version du modèle ? Qui peut rétablir la configuration précédente ? Où vont les invites et les résultats des outils ? Qui examine une modification avant qu’elle n’atteigne un client ? Ces questions ne s’opposent pas à l’inférence locale. Elles transforment celle-ci en service fiable plutôt qu’en démonstration d’un jour.
En bref : l’IA locale devient un choix de configuration
La véritable étape franchie n’est pas que chaque ordinateur puisse désormais exécuter un modèle énorme. C’est qu’une plus grande partie des décisions de déploiement est visible et accessible à l’utilisateur : quels poids, quelle conversion, quelle machine, quel environnement d’exécution et quels outils.
Muse Spark Open rend ce choix concret. Deux Mac à grande mémoire illustrent une voie ; une conversion plus petite en montre une autre ; l’inférence hébergée propose encore un autre compromis. Choisissez la configuration la plus modeste qui termine de manière fiable la tâche qui vous importe. La prochaine question utile n’est pas « Puis-je le charger ? », mais « Puis-je faire confiance au travail obtenu ? »
Sources et démonstrations
- Meta : lancement de Muse Spark Open, 15 octobre 2026.
- Fiche du modèle et spécifications des checkpoints de Meta.
- Hugging Face : guide d’exécution, conditions du test MLX et démonstrations d’agent, 15 octobre 2026.
- Conversion oQ3e : unités de stockage, encodeurs inclus et utilisation.
- Conversion oQ4e : stockage et avertissement pour une seule machine.
- Documentation d’installation oMLX et version v0.7.1rc1.
- Prise en charge de Muse par MLX LM.
- Licence Muse Model.
Informations sur le produit et sa compatibilité vérifiées le 16 octobre 2026. Les chiffres de performances ci-dessus sont des mesures attribuées à leurs éditeurs et assorties de leurs conditions de test.
Gardez la décision, pas seulement le nom du modèle
Pour les lecteurs qui rassemblent liens sources, notes de configuration et décisions de révision, Telli.sh est un espace de travail facultatif. Créer une note de recherche.