816B en un escritorio Mac: lo que Muse Spark Open hace realmente posible
El modelo de pesos abiertos de Meta llega a los Mac con mucha memoria. Compara la demostración con dos Mac Studio y un checkpoint cuantizado más pequeño, descubre demostraciones reales y elige una primera configuración sensata.
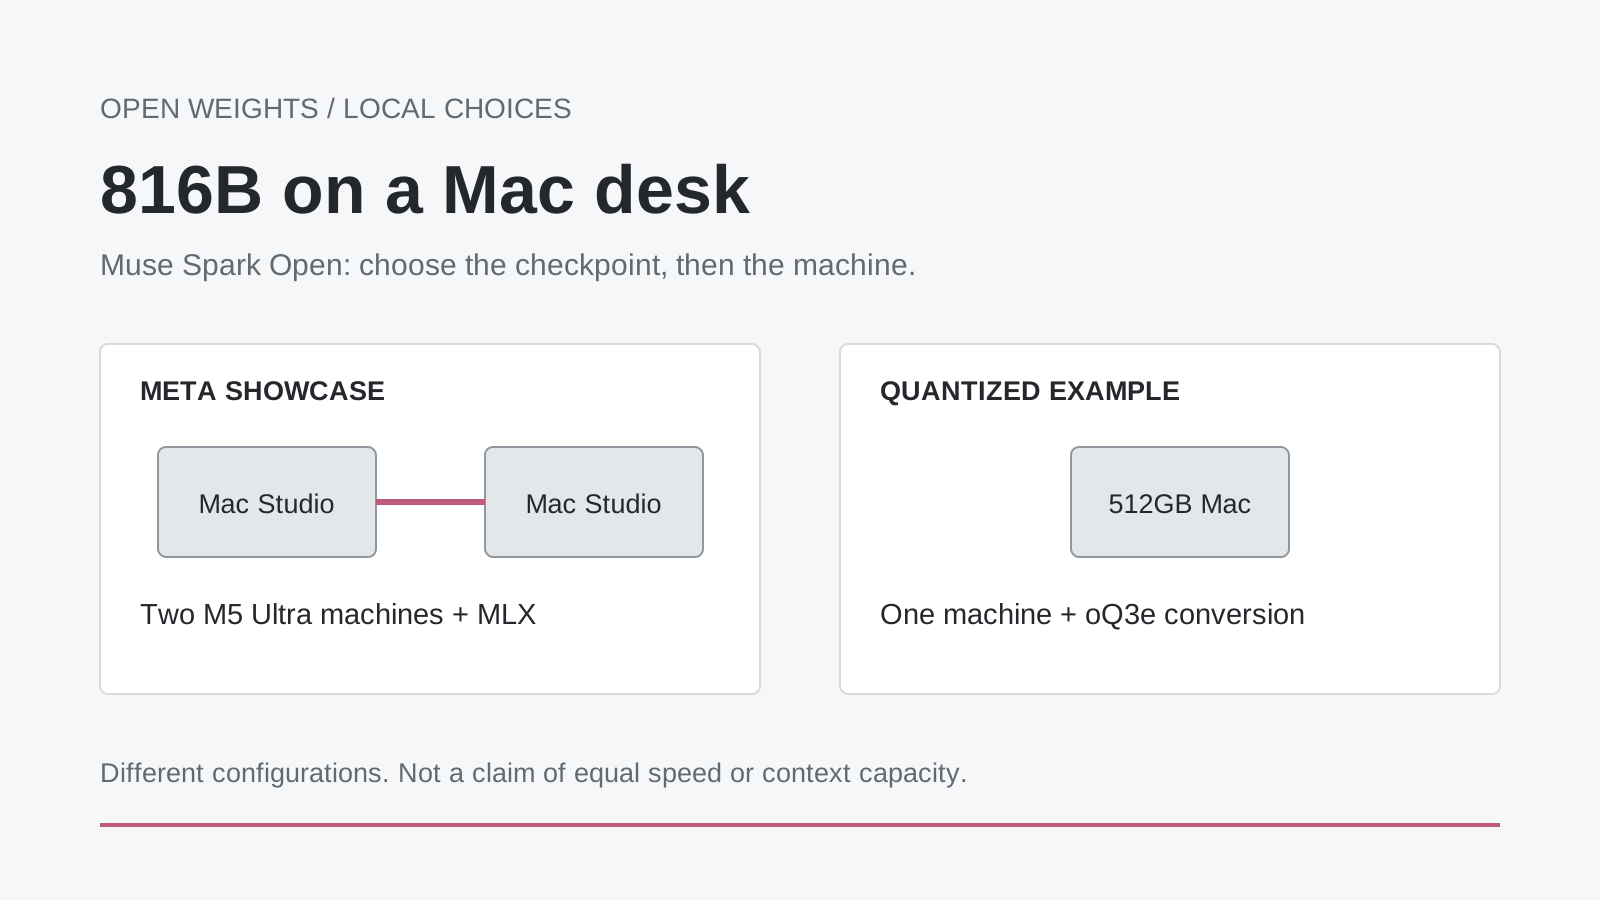
Ilustración explicativa original. La demostración con dos máquinas y el ejemplo cuantizado en una sola máquina usan configuraciones distintas; sus resultados de rendimiento no son intercambiables.
Un modelo de 816.000 millones de parámetros ejecutándose en un escritorio parece una contradicción. Sin embargo, el escritorio del anuncio de Meta del 15 de octubre tiene dos Mac Studio, cada uno con una enorme capacidad de memoria. No es lo mismo que instalar el mismo modelo en el portátil que ya tienes.
La novedad más interesante está justo debajo de ese titular. Muse Spark Open da a los desarrolladores acceso a los pesos del modelo, y las herramientas que lo rodean ofrecen varias formas de ejecutarlos. Meta muestra una configuración con dos máquinas; Hugging Face también describe una versión más cuantizada en un único Mac de 512GB. La IA local depende cada vez menos de si un modelo se puede descargar en teoría y cada vez más de elegir la representación y el margen operativo adecuados.
Esta guía explica qué puede hacer el modelo, por qué difieren las cifras de memoria, qué demostraciones publicadas merece la pena ver y cómo dar un primer paso útil sin iniciar por accidente una descarga de varios cientos de gigabytes. El objetivo no es convertir a cada lector en comprador de una estación de trabajo, sino aclarar un poco la elección entre una máquina local, un modelo más pequeño y un servicio alojado.
El avance es acceder al modelo, no actualizar todos los portátiles
Meta publicó Muse Spark Open el 15 de octubre de 2026 y lo describió como un modelo de mezcla de expertos con 816B parámetros, aproximadamente 42B activos por token y una ventana de contexto de hasta un millón de tokens. La publicación se dirige a la programación y al trabajo prolongado con herramientas. Sus pesos pueden desplegarse mediante varios motores de inferencia, en lugar de una única aplicación de chat obligatoria.
Eso cambia quién puede tomar las decisiones de despliegue. Un desarrollador puede elegir un checkpoint, ejecutar una pila de servicio adecuada, integrar herramientas y decidir adónde envía información la aplicación. Estas decisiones importan cuando un proyecto necesita una versión reproducible del modelo o una forma concreta de gestionar los datos. También conllevan responsabilidades que una suscripción de chat gestionada suele ocultar: almacenamiento, actualizaciones, compatibilidad, supervisión y recuperación.
Nuestra conclusión es que se amplían notablemente las opciones; la infraestructura no desaparece. Tener los pesos es como tener un motor. Te permite construir otro vehículo, pero no incluye los frenos, el taller ni la carretera. La pregunta útil es qué partes de ese vehículo quieres mantener de verdad.
En un proyecto personal, mantenerlas puede ser precisamente el objetivo. En una pequeña empresa que necesita una respuesta antes de una reunión, puede ser una distracción innecesaria. Ambas son reacciones razonables ante el mismo lanzamiento. Un modelo de pesos abiertos deja la decisión en tus manos, pero no la resuelve por ti.
Los 42B parámetros activos no convierten 816B en una descarga pequeña
Los modelos de mezcla de expertos seleccionan solo una parte de su capacidad de expertos para cada token. Eso ayuda a explicar por qué el número de parámetros activos es mucho menor que el total. No significa que los expertos no utilizados puedan omitirse sin más en un despliegue normal del modelo completo: otro token puede necesitar una ruta distinta por el modelo.
Conviene separar tres presupuestos. El primero es el almacenamiento del checkpoint. El segundo es la memoria de trabajo para los pesos y el entorno de ejecución. El tercero es el estado adicional que crece con la carga, incluida la caché de atención y las entradas multimodales. Superar la primera prueba no demuestra que quepan las otras dos.
La ficha oficial del modelo enumera entradas de texto, imagen, vídeo y audio, con salida de texto. También recoge distintos formatos de checkpoint y requisitos de memoria considerables. Son especificaciones de toda la familia del modelo, no una promesa de que cada checkpoint convertido incluya todos los codificadores o alcance el contexto máximo en cualquier máquina.
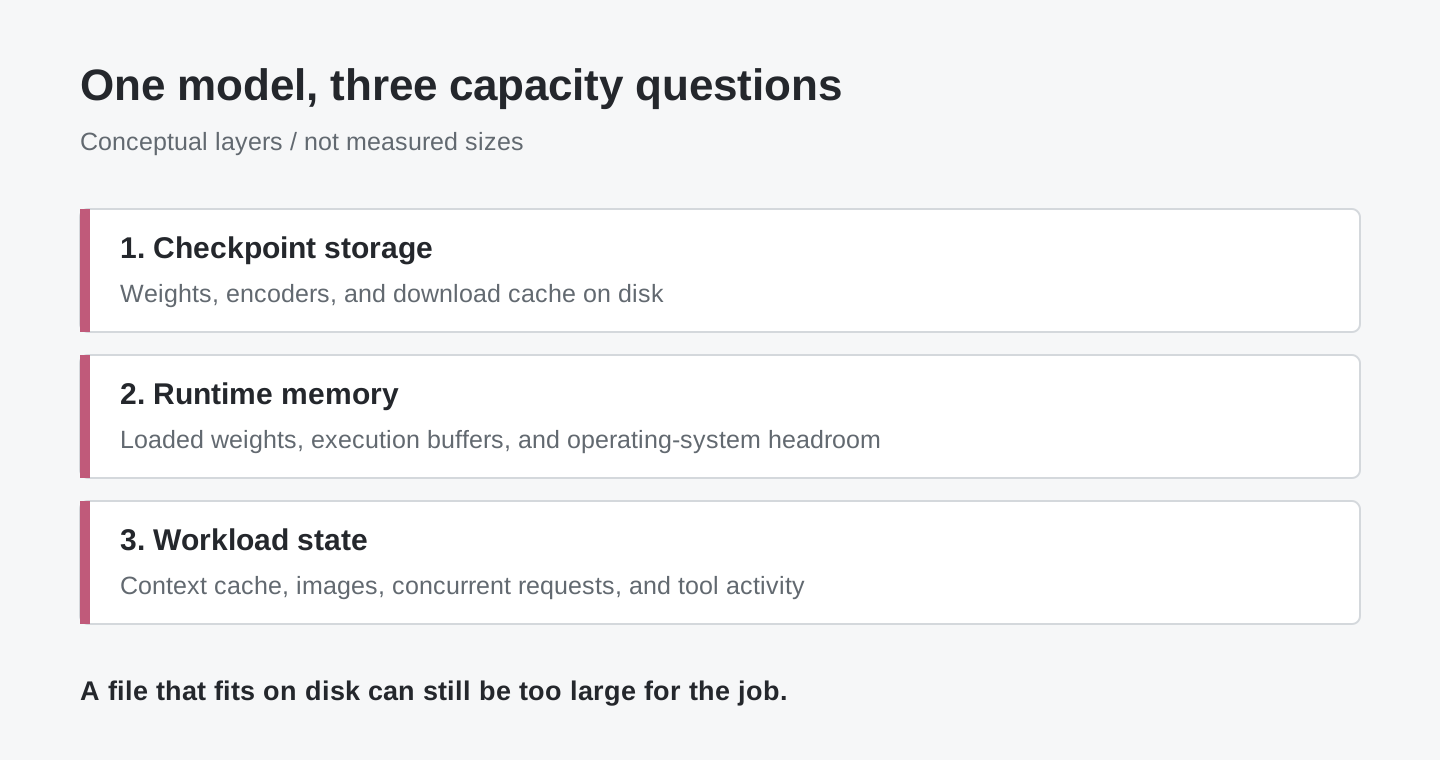
Diagrama conceptual original. Las franjas indican tipos de uso de memoria, no proporciones medidas. El tamaño del checkpoint, por sí solo, no estima la capacidad necesaria para toda la máquina.
Esta distinción es especialmente importante con vídeo. Una pregunta breve sobre una imagen y un análisis largo de muchos fotogramas no son la misma petición solo porque ambos usen un modelo con capacidad visual. Para un primer experimento sensato, mantén pequeña la entrada, limita la respuesta y establece una referencia funcional antes de añadir un archivo mayor o un ciclo de agente más largo.
Dos Mac Studio y un Mac de 512GB cuentan historias distintas
La demostración de Meta utiliza dos Mac Studio M5 Ultra y MLX. Su anuncio describe hasta 512GB de memoria unificada por máquina e informa de flujos de trabajo locales que incluyen cambios en la aplicación iOS Ice Cubes y edición en DaVinci Resolve. Son demostraciones de Meta, no mediciones de nuestro propio escritorio. Consulta las configuraciones y ejemplos en la publicación de lanzamiento de Meta.
El artículo de lanzamiento de Hugging Face sigue otra vía. Describe pruebas de un checkpoint cuantizado oQ3e en un M3 Ultra con 512GB de memoria. Para una solicitud de 1,024 tokens y 128 tokens generados, sus autores informan de aproximadamente 225 tokens por segundo durante el prellenado y 21 durante la generación. Estas cifras corresponden a esa prueba breve y a ese checkpoint, no a todos los Mac ni a la demostración con dos máquinas. Lee la sección de MLX del artículo técnico.
La ficha del checkpoint oQ3e aporta una corrección útil de unidades: el almacenamiento de sus tensores es de unos 344.152 GiB, o 369.531 GB. La ficha describe aproximadamente 370GB en oMLX. Llamarlo simplemente un «modelo de 344GB» confunde unidades binarias y decimales justo cuando importa la memoria restante.
| Vía publicada | Qué ilustra | Qué no debe deducirse |
|---|---|---|
| Los dos Mac Studio M5 Ultra de Meta | Un despliegue local con mucha memoria y demostraciones de agentes | Que todas las configuraciones de Muse requieren exactamente dos Mac |
| El M3 Ultra de 512GB de Hugging Face con oQ3e | Un ejemplo en una sola máquina con mayor cuantización | Que un MacBook normal tenga memoria suficiente |
| Inferencia alojada | Acceso sin mantener localmente el checkpoint completo | Que el trabajo necesariamente permanezca en tu ordenador |
Hay otro límite importante. La conversión oQ3e incluye el modelo de lenguaje y el codificador visual, pero no el codificador de audio. Por tanto, una demostración de voz y navegador con el modelo completo no demuestra que ese mismo flujo de audio funcione con esta descarga concreta. El nombre de un modelo no sustituye la lectura de la ficha de su variante.
La ficha oQ4e hace aún más explícito el compromiso de capacidad. Indica alrededor de 475.886GB de almacenamiento de tensores y advierte que es demasiado para un uso fiable en un solo Mac de 512GB. Más bits pueden conservar una representación distinta de los pesos y, al mismo tiempo, dejar menos espacio para el trabajo real. Llenar la memoria no equivale a terminar el trabajo.
Observa el ciclo de herramientas, no solo la respuesta final
Un caso de uso atractivo es un asistente de programación capaz de inspeccionar el aspecto de sus cambios. El ejemplo de recurso 3D de Hugging Face combina un modelo cuantizado, un agente de programación, Three.js, vistas renderizadas en el navegador y comentarios visuales. Lo interesante es el ciclo: generar un artefacto, observarlo, encontrar un defecto y revisarlo.
Imagina usar ese patrón para crear un prototipo de configurador de productos. Querrías que el agente detectara un control oculto o un objeto fuera del encuadre, no que se limitara a producir código sintácticamente válido. Es una aplicación ilustrativa del patrón, no una afirmación de que la demostración ya proporcione un configurador listo para producción. El proyecto sigue teniendo que definir la prueba de aceptación: los controles adecuados, las dimensiones correctas y el comportamiento correcto en una pantalla pequeña.
Un segundo ejemplo es la demostración «Call your Browser», enlazada desde el artículo de Hugging Face. Combina la entrada de voz con la interacción visual en el navegador para buscar productos que coincidan con una descripción. La demostración alojada en el propio artículo técnico muestra la interacción sin insinuar que instalar los pesos baste para crear un agente de navegador. Es posible que el Space enlazado requiera acceso; no des por hecho que el enlace de su página de lanzamiento garantiza un servicio público ejecutable. Antes de probar una versión alojada, revisa su configuración y tratamiento de datos, y utiliza ejemplos no sensibles.
Un tercer caso de uso es un asistente de revisión para tus propios documentos y capturas de pantalla. Por ejemplo, podrías pedirle que compare un requisito escrito con una imagen de interfaz y enumere las discrepancias. Esa tarea aprovecha la comprensión de imágenes sin conceder inmediatamente al sistema permiso para modificar archivos, enviar mensajes o comprar nada. Empieza con una tarea en la que una persona pueda inspeccionar tanto la entrada como la respuesta propuesta.
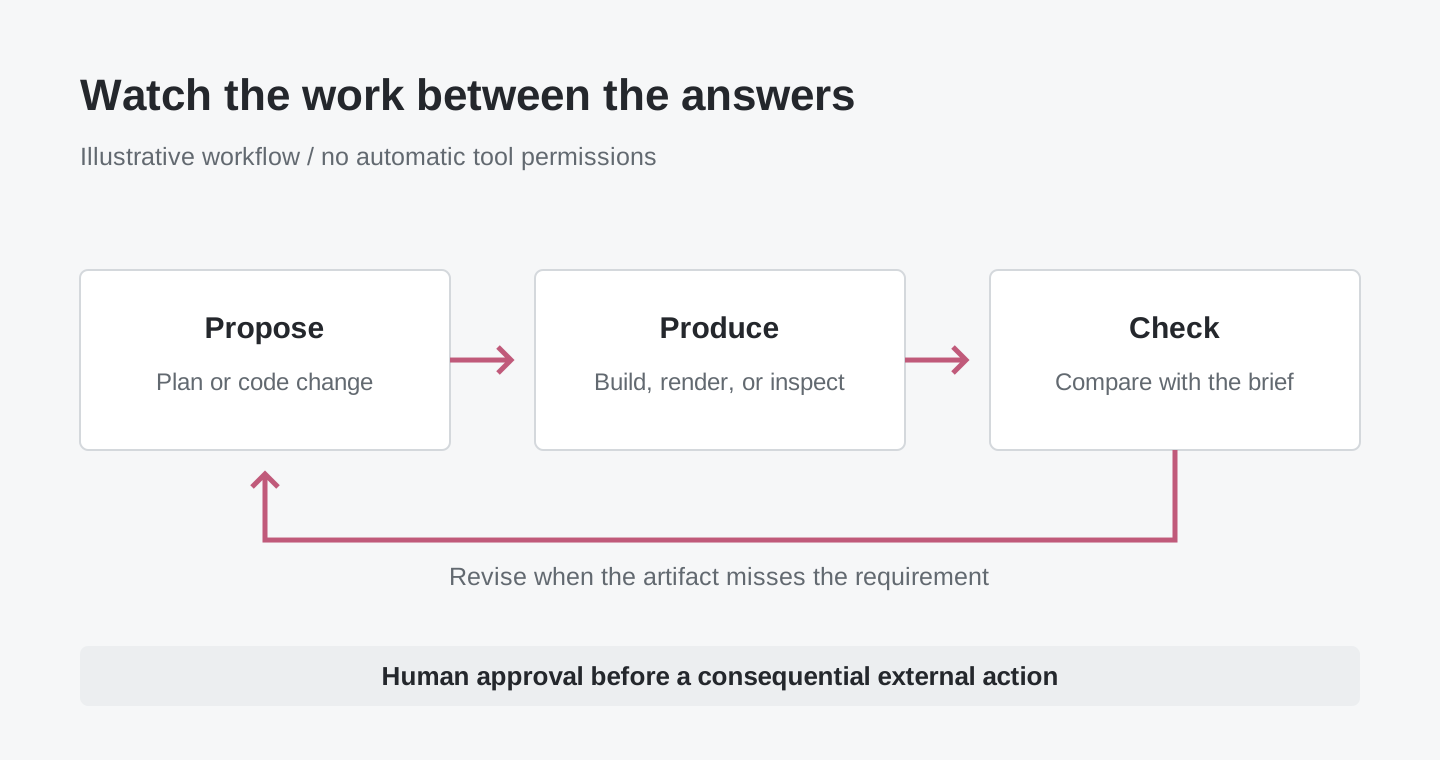
Ilustración original del flujo de trabajo. Un marco de agente y sus herramientas proporcionan el ciclo de acción; descargar los pesos del modelo no concede por sí solo acceso al navegador ni al sistema de archivos.
En los tres patrones, busca pruebas intermedias. ¿Se compiló el código? ¿Coincide la página renderizada con el requisito? ¿Cumple una elección de producto las restricciones indicadas? Un párrafo final pulido no sustituye al artefacto que debía producir la tarea.
Empieza en un Mac sin que «descargar» sea el primer paso
El error más fácil es elegir primero el modelo más grande y descubrir a mitad de camino los requisitos de capacidad. Hazlo al revés. Decide una tarea pequeña, identifica un checkpoint compatible y comprueba la máquina antes de comprometer almacenamiento o tiempo.
- Comprueba la memoria del Mac y el almacenamiento libre. En Terminal, los comandos siguientes muestran la versión de macOS, la memoria instalada en bytes y el espacio libre en el volumen personal. No instalan software ni descargan pesos.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Elige conjuntamente una aplicación y un checkpoint compatibles. El proyecto oMLX ofrece una aplicación para macOS y documentación de instalación. Entre los requisitos documentados se encuentran Apple Silicon y macOS 15 o posterior. En el momento de redactar esto, la versión más reciente es v0.7.1rc1, una versión candidata: mantén el trabajo experimental separado de la estación de trabajo de la que dependes para cumplir plazos.
-
Lee la ficha de la conversión exacta antes de seleccionarla en la interfaz de descarga de modelos. Para el ejemplo de una sola máquina anterior, el identificador es
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Reserva espacio para el checkpoint, la caché de descarga, el entorno de ejecución y el trabajo que quieres realizar. Un Mac de 256GB está por debajo del requisito publicado para esta variante; reducir la respuesta a una frase no elimina el almacenamiento necesario para los pesos. -
Empieza con una tarea breve y prescindible. Prueba una pregunta de texto sencilla o una captura no sensible con una respuesta corta. Confirma que el modelo se carga y que el resultado es útil antes de aumentar el contexto o añadir herramientas. Cargarlo correctamente confirma la compatibilidad, no la exactitud de los hechos.
-
Añade acciones solo cuando funcione el flujo de solo lectura. Trabaja sobre una copia del proyecto. Limita los archivos y herramientas a los que puede acceder el agente y exige confirmación antes de cualquier acción externa. Mantén los cambios revisables en vez de dejar que el primer experimento modifique tu única copia de trabajo.
Prefiere la vía de descarga y selección de modelos admitida por la aplicación a un comando genérico copiado de la página de otro modelo. MLX LM también ofrece una opción de línea de comandos, pero la compatibilidad con modelos y las versiones empaquetadas pueden avanzar a ritmos distintos. Su solicitud de incorporación de compatibilidad con Muse es una referencia útil de compatibilidad al elegir una versión, no una razón para instalar una rama de desarrollo arbitraria.
No necesitas comprar hardware para entender la utilidad del modelo. Un punto de acceso alojado puede responder si gestiona tu tarea representativa antes de que investigues un despliegue local. Revisa primero los precios del proveedor, el tratamiento de datos y los controles de gasto. Una demostración pública es una herramienta de aprendizaje, no un backend de producción gratuito.
Mide el trabajo terminado, no solo el contador de tokens
Los tokens por segundo ayudan a describir una configuración de inferencia. No dicen si el asistente te ahorró una tarde o creó un error sutil. Un cambio incorrecto más rápido puede costar más que uno correcto más lento, sobre todo si un agente de larga duración repite sus propias suposiciones equivocadas.
Una comparación práctica utiliza la misma pequeña colección de tareas en las configuraciones candidatas. Incluye un cambio de código con una prueba existente, una captura de pantalla con un problema conocido y una pregunta sobre un documento cuya respuesta pueda rastrearse hasta un pasaje. Mantén estables la solicitud y las condiciones de aceptación. Después registra la corrección, el tiempo hasta obtener un resultado revisado, las intervenciones necesarias y el uso máximo de recursos, si tus herramientas lo muestran.
Trata el prellenado y la generación como partes distintas de la espera. Una entrada larga puede ralentizar la primera respuesta aunque los tokens posteriores lleguen rápido. Un agente también puede dedicar tiempo a compilar, navegar o esperar otra herramienta. Cuenta ese tiempo al comparar una configuración local con un servicio alojado: forma parte de la experiencia del usuario aunque ocurra fuera del modelo.
Repite la comparación tras una actualización importante del checkpoint o del entorno de ejecución. No hace falta un gran benchmark para detectar que un cambio ha roto tu flujo habitual. Unas pocas tareas representativas, comprobadas de forma coherente, son más útiles que una captura de una única respuesta impresionante.
Los pesos abiertos te dan opciones, no privacidad automática ni derechos ilimitados
Un modelo local puede mantener la inferencia en tu máquina. Aun así, la aplicación completa puede usar búsqueda web, telemetría, herramientas externas, almacenamiento remoto o modelos alternativos alojados. Dibuja la ruta de los datos del flujo real antes de describirlo como privado. Un experimento de texto sin conexión y un agente de compras que usa el navegador tienen límites distintos aunque partan del mismo checkpoint.
La licencia Muse Model también impone condiciones. Exige atribución y una política de uso asociada, e incluye condiciones independientes para ciertas empresas que ofrecen el modelo como servicio. Es una publicación personalizada de pesos abiertos, no una afirmación general de que cualquier uso esté libre de restricciones. Consulta la licencia vigente para la distribución o el servicio que tienes previsto.
En un equipo, la responsabilidad debe tener una respuesta operativa además de legal. ¿Quién aprueba una nueva versión del modelo? ¿Quién puede restaurar la configuración anterior? ¿Adónde van las solicitudes y los resultados de las herramientas? ¿Quién revisa un cambio antes de que llegue a un cliente? Estas preguntas no son argumentos contra la inferencia local. Son lo que la convierte en un servicio fiable en vez de una demostración de un solo día.
En resumen: la IA local se está convirtiendo en una decisión de configuración
El verdadero hito no es que ahora cualquier ordenador pueda ejecutar un modelo enorme. Es que una parte mayor de la decisión de despliegue está a la vista y al alcance del usuario: qué pesos, qué conversión, qué máquina, qué entorno de ejecución y qué herramientas.
Muse Spark Open hace concreta esa elección. Dos Mac con mucha memoria muestran una vía; una conversión más pequeña muestra otra; la inferencia alojada ofrece un compromiso distinto. Elige la configuración más pequeña que complete de forma fiable el trabajo que te importa. La siguiente pregunta útil no es «¿Puedo conseguir que se cargue?», sino «¿Puedo confiar en el trabajo que devuelve?»
Fuentes y demostraciones
- Meta: lanzamiento de Muse Spark Open, 15 de octubre de 2026.
- Ficha del modelo y especificaciones de los checkpoints de Meta.
- Hugging Face: guía del entorno de ejecución, condiciones de la prueba MLX y demostraciones de agentes, 15 de octubre de 2026.
- Conversión oQ3e: unidades de almacenamiento, codificadores incluidos y uso.
- Conversión oQ4e: almacenamiento y advertencia para una sola máquina.
- Documentación de instalación de oMLX y versión v0.7.1rc1.
- Compatibilidad de MLX LM con Muse.
- Licencia Muse Model.
La información de producto y compatibilidad se comprobó el 16 de octubre de 2026. Las cifras de rendimiento anteriores son mediciones atribuidas a sus editores, con las condiciones de prueba que estos indicaron.
Conserva la decisión, no solo el nombre del modelo
Para quienes reúnen enlaces a fuentes, notas de configuración y decisiones de revisión, Telli.sh es un espacio de trabajo opcional. Crear una nota de investigación.