40+ ngôn ngữ dịch trực tiếp rồi xóa khi cúp máy: phiên âm đa ngôn ngữ mới là lớp giữ lại cuộc họp
DeepL ra mắt Voice-to-Voice ngày 16/4/2026 với hơn 40 ngôn ngữ, và mục Hỏi đáp của chính sản phẩm đó ghi rằng dữ liệu cuộc họp được «xử lý tạm thời trong bộ nhớ và bị xóa khi cuộc gọi kết thúc». Ngày 28/8, Open ASR Leaderboard bổ sung ngôn ngữ Nam bán cầu đầu tiên và cho thấy hai mô hình ngang nhau ở mức 4,9 WER lại chênh nhau gần bốn lần về mức độ phụ thuộc của độ chính xác vào việc người nói đến từ đâu. Dịch họp thời gian thực đang thành hàng phổ thông. Bản ghi thì chưa.
Ngày 16 tháng 4 năm 2026, DeepL ra mắt Voice-to-Voice từ Cologne: một bộ sản phẩm dịch giọng nói thời gian thực bao phủ bốn bề mặt — họp trực tuyến, hội thoại trên di động và web, tình huống nhóm cho nhân viên tuyến đầu, và một API dành cho doanh nghiệp. Nó xử lý hơn 40 ngôn ngữ, gồm toàn bộ 24 ngôn ngữ chính thức của EU cùng tiếng Việt, tiếng Thái, tiếng Ả Rập, tiếng Na Uy, tiếng Do Thái, tiếng Bengal và tiếng Tagalog. Trong các đánh giá mù do Slator thực hiện theo đặt hàng của DeepL, 96% chuyên gia ngôn ngữ chọn nó thay vì phần dịch tích hợp sẵn của Google, Microsoft và Zoom; DeepL Voice cho Zoom đạt 96,4 trên 100 so với 87–89 của các nền tảng đối thủ.
Đây là một sản phẩm nghiêm túc, và điều đáng chú ý không phải là buổi ra mắt. Điều đáng chú ý là một câu trong mục Hỏi đáp của chính trang sản phẩm ấy, mà chúng tôi đọc lại vào ngày 31 tháng 8 năm 2026:
«DeepL không lưu trữ vĩnh viễn dữ liệu phiên âm hay dữ liệu dịch. Dữ liệu cuộc họp được xử lý tạm thời trong bộ nhớ và bị xóa khi cuộc gọi kết thúc.»
Hãy đọc hai sự thật ấy cạnh nhau. Bản dịch xuất sắc, và bản dịch đó đã biến mất trước bữa tối.
Tóm tắt nhanh
- Năm 2026, dịch họp thời gian thực đã chuyển từ bài toán khó sang mặt hàng phổ thông đã giao: hơn 40 ngôn ngữ ở DeepL, 58 ngôn ngữ đơn lẻ trên Nova-3 của Deepgram, dịch trực tiếp ngay trong Google Meet.
- Việc không giữ lại gì thường là lựa chọn quyền riêng tư có chủ đích, không phải lỗi — nhưng nó có nghĩa là bản thân cuộc họp không để lại bất kỳ hiện vật nào để xem lại.
- Phiên âm đa ngôn ngữ là lớp riêng nằm bên dưới. Nó giữ chung trong một bản ghi xem lại được: phiên âm ở ngôn ngữ gốc, bản dịch, nhãn người nói và bản tóm tắt. Bài này nói về việc tại sao thứ phải sống sót lại chính là ngôn ngữ gốc, và cách điều hành cuộc họp để nó sống sót.
Phiên bản Google của lập luận này chúng tôi đã viết hồi tháng 6, khi Meet và Translate đẩy dịch giọng nói trực tiếp ra thị trường đại chúng: vì sao các cuộc họp đa ngôn ngữ vẫn cần ghi chú xem lại được. Từ đó tới nay, thị trường đã trả lời một câu hỏi mà chúng tôi mới chỉ đặt ra. Dịch trực tiếp giờ chạy tốt. Nên câu hỏi thú vị đã dịch chuyển: sáng thứ Hai bạn còn lại gì?
Dịch họp thời gian thực không còn là phần khó nữa
Suốt khoảng một thập kỷ, giọng nói đa ngôn ngữ trực tiếp là bản demo không bao giờ sống sót khi va vào một cuộc họp thật. Độ trễ nuốt mất lượt nói, giọng vùng miền đánh gãy bộ nhận dạng, và bất cứ nội dung nào hơi chuyên môn một chút đều ra thành thứ méo mó. Thời ấy chấm dứt trong khoảng mười tháng.
Nova-3 của Deepgram ghi 31 ngôn ngữ trong ghi chú phát hành ngày 10 tháng 12 năm 2025 và 58 trong tài liệu tháng 8 năm 2026: 39 lần bổ sung có tài liệu trong chưa đầy chín tháng, xấp xỉ một ngôn ngữ mới mỗi bảy ngày. Chúng tôi đã đi qua đợt mở rộng đó, cùng phần chữ nhỏ bên dưới nó, trong bài chữ «hỗ trợ» thực sự che giấu điều gì trong độ phủ ngôn ngữ của nhận dạng giọng nói. Google đưa dịch giọng nói trực tiếp vào Meet. DeepL giao bộ sản phẩm giọng nói bốn bề mặt hồi tháng 4.
Những tuyên bố về chất lượng giờ cũng đủ cụ thể để tranh luận, và bản thân điều đó đã là dấu hiệu trưởng thành. Đánh giá Slator do DeepL đặt hàng báo cáo tỷ lệ lỗi 4% cho DeepL Voice so với mức trung bình 17% của các nền tảng họp cạnh tranh, cùng 96,4/100 trên Zoom và 96,3/100 trên Teams. Số liệu do nhà cung cấp đặt hàng thì phải đối xử như số liệu do nhà cung cấp đặt hàng. Nhưng chiều hướng thì không ai cãi, và báo chí đưa tin nghiêm túc cũng chỉ về cùng một phía: The Next Web, trong bài ngày 17 tháng 4 năm 2026, mô tả một buổi demo trực tiếp ở Seoul chạy với độ trễ một đến hai câu, và dẫn lời giám đốc sản phẩm của DeepL thừa nhận rằng khác biệt trật tự từ giữa các ngôn ngữ vẫn là ràng buộc căn bản đối với tốc độ mà dịch giọng-sang-giọng có thể đạt được.
Độ trễ một đến hai câu là đủ dùng. Nó không đủ để thay một phiên dịch viên chuyên nghiệp trong đàm phán hiệp định, và cũng chẳng ai nói thế. Nó thừa đủ cho buổi đồng bộ sản phẩm chiều thứ Ba giữa Warsaw, Seoul và São Paulo — tức là cuộc họp mà phần lớn chúng ta thực sự có.
Điểm mấu chốt là: khi một năng lực tốt lên nhanh đến vậy, nút thắt sẽ dịch chuyển. Nó đã dịch chuyển rồi. Giờ nó nằm thấp hơn một lớp, ở chỗ cuộc họp để lại thứ gì.
Theo thiết kế, bản dịch không sống lâu hơn cuộc gọi
Quay lại câu trong mục Hỏi đáp, vì đó không phải sự cẩu thả. Đó là một tư thế bảo mật, và là tư thế tốt. Chính lời của DeepL viết tiếp: mọi dữ liệu được mã hóa khi truyền, không bao giờ dùng để huấn luyện mô hình, và «chỉ tồn tại trên thiết bị cục bộ của người tham gia cuộc họp». Khi một ngân hàng hay bệnh viện mua công cụ họp, «chúng tôi không giữ gì cả» là câu trả lời qua cửa pháp chế nhanh nhất.
Tư thế đó phổ biến khắp nhóm sản phẩm phụ đề trực tiếp, bởi lưu trữ âm thanh của các cuộc họp đa ngôn ngữ đúng là loại trách nhiệm không ai muốn nhận. Thế nên mặc định của ngành đã thành ra: hiểu nhau tuyệt vời ngay lúc đó, và không còn hiện vật nào sau đó.
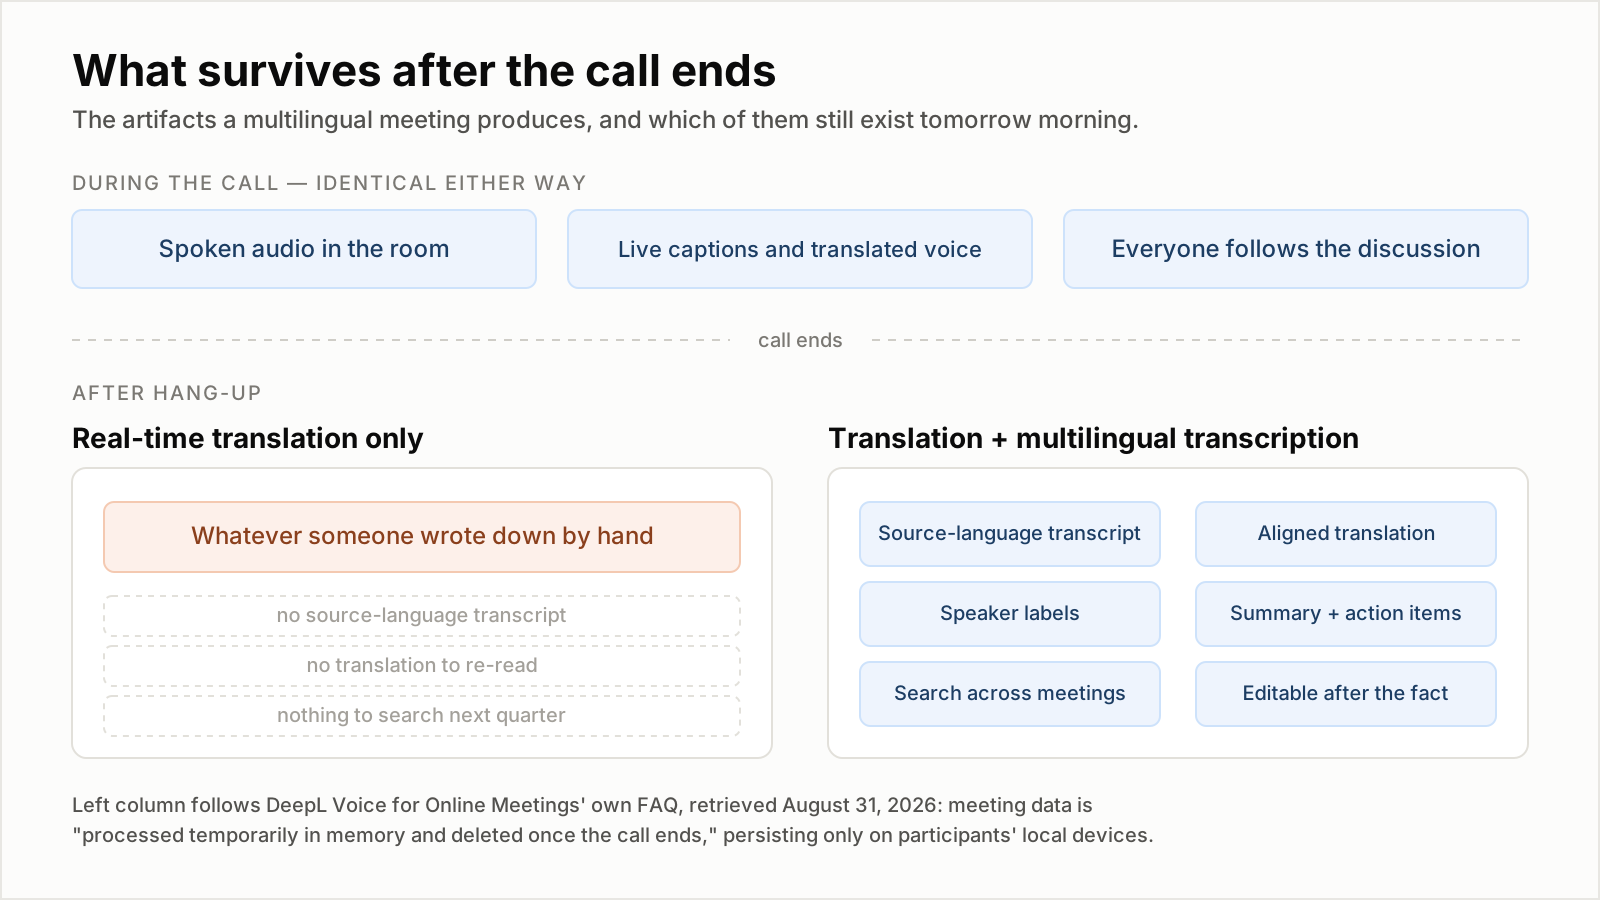
Trong lúc gọi, hai cách làm không thể phân biệt. Khác biệt nằm trọn ở phía bên kia của lúc cúp máy. Cột trái theo đúng mục Hỏi đáp của chính DeepL Voice for Online Meetings, truy cập ngày 31 tháng 8 năm 2026.
Kiểu hỏng mà cấu trúc này tạo ra có hình dạng riêng, và nó cần một cái tên. Gọi là trôi dạt quyết định: mọi người hiểu cuộc họp hoàn hảo, và ba tuần sau không ai chứng minh nổi đã chốt cái gì. Đó không phải hiểu nhầm — bản dịch trực tiếp đã làm đúng việc của nó. Vấn đề là bản sao duy nhất còn lại của một quyết định được đưa ra bằng hai ngôn ngữ đang nằm trong năm bộ nhớ, với năm cách diễn đạt khác nhau, bằng ít nhất hai ngôn ngữ, và trí nhớ thì tái dựng chứ không phát lại.
Trôi dạt quyết định đắt theo kiểu không bao giờ hiện lên hóa đơn của công cụ. Nó hiện ra dưới dạng một tính năng làm lại từ đầu, một hạn chót phải thương lượng lại, một câu hỏi tuân thủ không ai trả lời được, một người mới vào không có cách nào biết quý trước đội đã quyết gì.
Ngày 28 tháng 8: phép đo giải thích vì sao bạn cần ngôn ngữ gốc
Nếu phiên âm là món hàng đã giải quyết xong và đồng đều ở mọi nơi, giữ lại bản ghi chỉ là bài toán dung lượng và bài này sẽ ngắn. Không phải vậy, và bằng chứng gần đây rõ ràng nhất vừa xuất hiện ba ngày trước.
Ngày 28 tháng 8 năm 2026, Hugging Face và Voice Arena thêm ngôn ngữ Nam bán cầu đầu tiên vào Open ASR Leaderboard: tiếng Hindi, hơn nửa tỷ người nói, bước vào một tab đa ngôn ngữ mà trước đó chỉ có các ngôn ngữ châu Âu. Họ đóng góp bốn bộ đánh giá — Monsoon en-IN và hi-IN, bản công khai và bản riêng — gồm 4.888 người nói không trùng lặp, mỗi người có 12 thuộc tính được ghi nhận, thu ở 428 quận huyện và trên hàng trăm mẫu điện thoại thật chứ không phải trong phòng thu.
Rồi họ cho chạy chính các mô hình đang có trên bảng xếp hạng lên bộ dữ liệu đó. Kết quả là thứ hữu ích nhất được công bố trong tháng này về nhận dạng giọng nói.
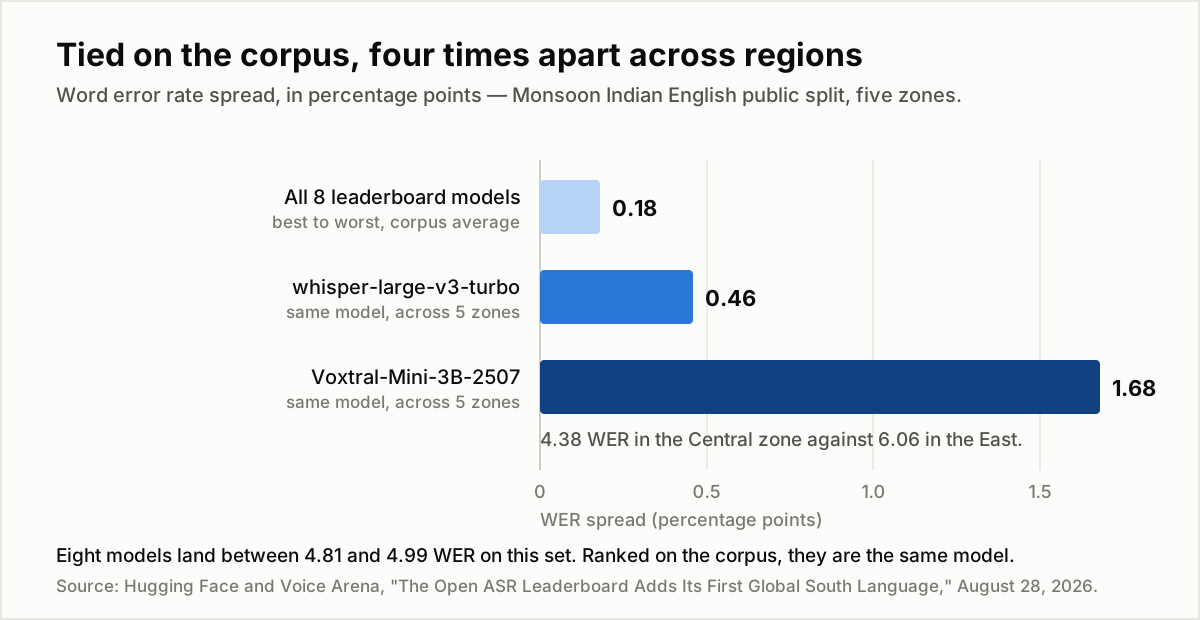
Một trục duy nhất, một đơn vị duy nhất: hai vế được so sánh cách nhau bao nhiêu điểm WER. Nguồn: Hugging Face và Voice Arena, ngày 28 tháng 8 năm 2026.
Tám mô hình trên bảng xếp hạng đều rơi vào khoảng 4,81 đến 4,99 WER trên bộ tiếng Anh Ấn Độ công khai. Tức 0,18 điểm từ tốt nhất tới kém nhất — nằm trong ngưỡng mà năm giờ âm thanh còn chẳng phân giải nổi. Xếp hạng theo ngữ liệu, đúng như bài viết nói, chúng là cùng một mô hình.
Nhóm người nói theo vùng thì chúng thôi là cùng một mô hình. Gộp quận quê của mỗi người nói lên cấp hội đồng vùng, openai/whisper-large-v3-turbo dao động 0,46 điểm giữa năm vùng. mistralai/Voxtral-Mini-3B-2507, chỉ kém nó 0,14 điểm ở trung bình ngữ liệu, dao động tới 1,68: 4,38 WER ở vùng Trung so với 6,06 ở vùng Đông. Hai hệ thống không phân biệt được trên bảng xếp hạng lại chênh nhau gần bốn lần về mức độ mà độ chính xác phụ thuộc vào nơi người nói lớn lên.
Và cũng không phải một vùng nào đó đơn giản là khó hơn. ibm-granite/granite-speech-3.3-2b tệ nhất ở phía Bắc, microsoft/VibeVoice-ASR-HF ở phía Nam, Voxtral ở phía Đông. Nếu có vùng nào khó tự thân, mọi mô hình đã xếp thứ tự các vùng giống nhau. Chúng không làm vậy, và điều đó chỉ về phía các mô hình chứ không phải âm thanh.
Cách đọc mang tính vận hành cho ai đang chủ trì họp đa ngôn ngữ: chất lượng phiên âm của bạn không phải một con số tra được. Nó là hàm của việc ai đang ở trong phòng. Người đồng nghiệp có giọng mà nhà cung cấp của bạn lấy mẫu ít nhất chính là người có những câu sẽ ra sai, và cả bảng xếp hạng lẫn trang sản phẩm đều không cảnh báo bạn. Phòng thủ duy nhất là một bản phiên âm mà con người đọc và sửa được — điều đó đòi hỏi bản phiên âm phải tồn tại.
Tiếng Hindi viết cùng một cụm từ theo mười cách hợp lệ. Bản dịch chọn một.
Phát hiện thứ hai trong cùng công bố ấy tinh tế hơn và chạm sát hơn vào lập luận của bài này.
Biến thể chính tả của tiếng Anh có biên: Anh-Anh với Anh-Mỹ, dấu câu, chữ số với chữ viết. Bộ chuẩn hóa đưa gần hết về một dạng. Tiếng Hindi không có biên như vậy. Lời nói thường ngày trộn rất nhiều tiếng Anh, từ gốc Anh không có cách viết Devanagari cố định, và từ ghép được viết liền hay tách tùy sở thích. Một cụm từ có thể có mười cách viết hợp lệ trở lên, và không tồn tại phía «chuẩn» nào để quy chúng về.
Vì vậy các bộ tiếng Hindi kèm theo một lưới: với mỗi đoạn của bản phiên âm là tập hợp những cách viết được chấp nhận là đúng. Và chúng được chấm bằng OIWER — tỷ lệ lỗi từ có tính đến chính tả, do AI4Bharat đề xuất — thay vì WER thường. Khi chấm lại cùng những giả thuyết đó trên phiên bản bị ép phẳng thành một tham chiếu duy nhất, tỷ lệ lỗi tăng ở mọi hệ thống, tăng không đều, và có những cặp hệ thống đảo thứ hạng cho nhau. Dưới tham chiếu đơn, mô hình được thưởng một phần vì tái tạo đúng cách viết mà người chú giải đã chọn; dưới lưới, chỉ khả năng nhận dạng mới được chấm.
Hãy dừng lại ở hàm ý này. Ngay cả ở mức «cái gì đã được viết ra», thường cũng không có một chuỗi ký tự đúng duy nhất — chỉ có một tập hợp các chuỗi được chấp nhận, và chọn một trong số đó là vứt đi thông tin.
Dịch chính là phép nén ấy, ở một tầng cao hơn và mất mát lớn hơn nhiều. Mỗi dòng dịch là một quyết định giữa các cách hiểu mà bản gốc vốn không buộc phải quyết.
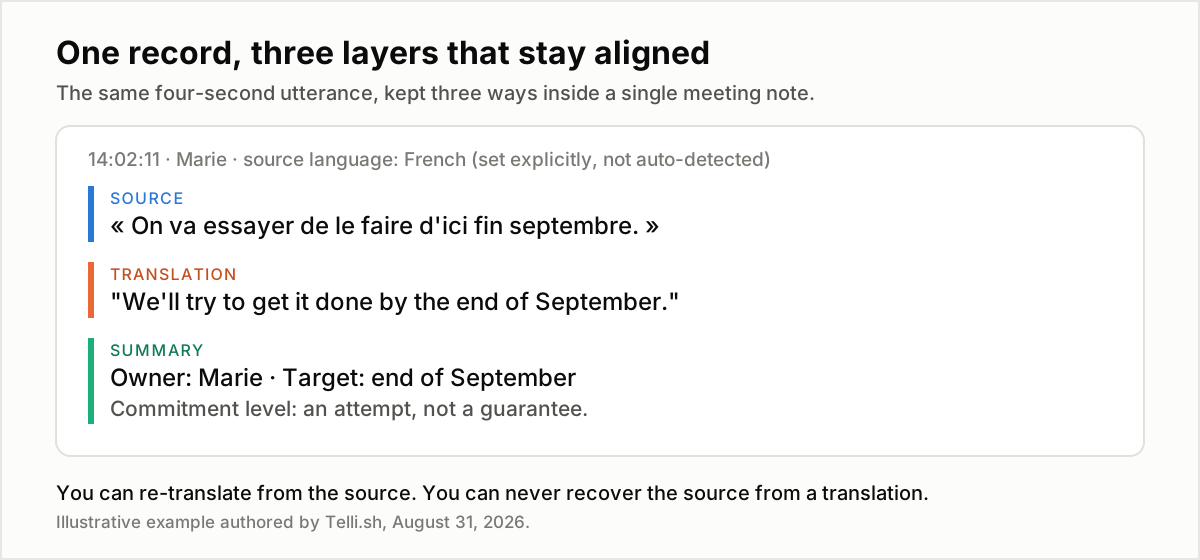
Dòng ở ngôn ngữ gốc là dòng duy nhất trong ba dòng không thể tái tạo từ hai dòng còn lại.
Khi «On va essayer de le faire d'ici fin septembre» thành «Chúng tôi sẽ cố làm xong trước cuối tháng Chín», có một thứ thật sự đã đổi: chữ essayer trong tiếng Pháp mang sắc thái giảm nhẹ riêng mà «cố» làm phẳng đi. Đó là cam kết hay là ý định? Dòng dịch không trả lời được. Dòng gốc thì có. Sáu tuần sau, khi thời hạn trôi và hai đội nhớ câu đó khác nhau, dòng gốc chính là toàn bộ lập luận.
Đây là sự bất đối xứng nằm ở trung tâm cả chủ đề. Dịch là một chiều. Từ bản gốc bạn có thể dịch lại bao nhiêu lần tùy thích, sang năm bằng mô hình tốt hơn. Từ bản dịch, bạn không bao giờ lấy lại được bản gốc.
Sau khi cúp máy còn lại gì: trình dịch thời gian thực so với trình dịch họp có ghi chú
Đây là phép so sánh nói thẳng, giữa ba cách các đội đang xử lý cuộc họp đa ngôn ngữ hiện nay.
| Sáng hôm sau bạn có gì | Lớp dịch thời gian thực | Phiên dịch viên | Trình dịch họp có ghi chú |
|---|---|---|---|
| Hiểu nhau ngay tại chỗ | Có | Có, chất lượng cao nhất | Có |
| Âm thanh cuộc họp | Chỉ khi ghi âm riêng | Chỉ khi ghi âm riêng | Có |
| Phiên âm ở ngôn ngữ gốc | Không | Không, trừ khi phiên âm riêng | Có |
| Bản dịch khớp theo bản gốc | Không | Không | Có |
| Ai nói dòng nào | Không | Không | Có, kèm nhãn người nói |
| Tóm tắt và việc cần làm | Không | Ghi chú của phiên dịch, nếu có | Có, sinh ra từ bản phiên âm |
| Tìm kiếm được sau ba tháng | Không | Không | Có |
| Sửa được dòng sai | Không | Sau đó thì không | Có, sửa trực tiếp bản ghi |
| Chi phí mỗi giờ, ước chừng | Thuê bao phần mềm | 100–200 USD trở lên, phiên dài cần hai phiên dịch | Thuê bao phần mềm |
Hành vi của cột «biến mất» theo đúng mục Hỏi đáp công khai của DeepL Voice for Online Meetings, truy cập ngày 31 tháng 8 năm 2026; mức phí phiên dịch là khoảng giá thị trường được công bố rộng rãi cho phiên dịch hội nghị chuyên nghiệp và thay đổi theo cặp ngôn ngữ và thị trường. Cột thứ ba mô tả nhóm sản phẩm «trình dịch họp có ghi chú» nói chung, không phải một nhà cung cấp cụ thể.
Chính hình dạng của bảng này là lập luận. Cột một và cột ba giống hệt nhau ở hàng duy nhất mà người mua thường đánh giá — hiểu nhau lúc đang họp — và khác nhau ở mọi hàng chỉ có ý nghĩa sau khi họp xong. Các bài so sánh nhà cung cấp gần như luôn chỉ chạy trên hàng đầu tiên.
Trình dịch trực tiếp là một ô cửa sổ. Trình dịch họp có ghi chú vừa là ô cửa sổ vừa là cuốn sổ cái. Các đội mua cửa sổ vì đó là phần họ trải nghiệm, rồi chạy cả quý bằng cuốn sổ cái họ chưa từng mua.
Cách điều hành một cuộc họp đa ngôn ngữ để bản ghi còn dùng được
Sáu bước, theo đúng thứ tự chúng xuất hiện. Không bước nào lạ lùng cả; thất bại gần như luôn là vì không ai quyết.
- Đặt ngôn ngữ gốc một cách tường minh. Đừng dựa vào tự động nhận diện. Tự động nhận diện phải chốt ngay trong vài giây đầu, trên đoạn âm thanh ít ngữ cảnh nhất của cả phiên, và đoán trật thì mọi công đoạn phía sau kém đi cùng lúc. Chọn tường minh còn cho phép động cơ đưa bạn sang một mô hình đơn ngữ chuyên dụng, thường mạnh hơn mô hình đa ngữ — chính Nova-3 ghi tài liệu cho 58 ngôn ngữ riêng lẻ nhưng chuyển mã thì đúng 10.
- Tách danh sách ngôn ngữ mọi người sẽ nói khỏi danh sách ngôn ngữ mọi người sẽ đọc. Đó là hai danh sách khác nhau, và gộp chúng làm một là lỗi cấu hình phổ biến nhất của nhóm sản phẩm này. Trung tâm trợ giúp của DeepL tách đúng như vậy: «ngôn ngữ nói» là những gì bộ nhận dạng chấp nhận, «ngôn ngữ dịch» là những gì phụ đề có thể hiển thị — và danh sách thứ hai dài hơn hẳn.
- Trước cuộc gọi hãy quyết bản ghi sẽ nằm ở đâu, và xác nhận rằng đó không phải nền tảng họp. Nếu nhà cung cấp dịch của bạn xóa dữ liệu cuộc họp khi cúp máy — vốn là mặc định, và là mặc định hợp lý — thì không thiết lập nào bên trong công cụ đó tạo ra bản ghi cả. Việc lưu lại phải là một lựa chọn riêng, có chủ đích.
- Bật nhãn người nói. Một dòng dịch không có quy thuộc thì vô dụng với bất kỳ quyết định nào nó lẽ ra sẽ chống đỡ về sau. «Bọn tôi sẽ xong trước tháng Chín» chỉ trở thành sự kiện khi biết ai đã nói câu đó.
- Sửa tên riêng và thuật ngữ chuyên ngành trong năm phút đầu, ngay lúc đang họp. Tên riêng, tên mã sản phẩm và từ viết tắt là chỗ phiên âm hỏng một cách đều đặn, và cũng là chỗ một dòng sai làm hại bản tóm tắt sinh sau nhiều nhất. Sửa lúc họp đang chạy tốn vài giây; sửa trong một tài liệu không ai đọc lại thì chẳng tốn gì, vì chẳng ai đọc lại.
- Sinh bản tóm tắt từ bản phiên âm ngôn ngữ gốc khi có thể, chứ không phải từ bản dịch. Tóm tắt một bản dịch là chồng hai bước mất mát lên nhau. Đây là khuyến nghị của chúng tôi chứ không phải kết quả đo đạc, nhưng cơ chế thì thẳng thắn: mỗi công đoạn vứt đi thông tin, và chồng lên nhau thì vứt nhiều hơn.
Rồi giữ ba hiện vật đó trong một bản ghi duy nhất. Phiên âm ở một công cụ, bản dịch trong lịch sử chat và bản tóm tắt trong một tài liệu là ba tệp sẽ mâu thuẫn với nhau trong vòng một tháng — và chính sự mâu thuẫn ấy là thứ bạn đang cố ngăn.
Chốt lại: hiểu nhau từng là bài toán băng thông, bản ghi là bài toán trí nhớ
Dịch họp thời gian thực giải bài toán băng thông: đưa ý nghĩa sang bên kia bàn đủ nhanh để cuộc trò chuyện vẫn còn giống một cuộc trò chuyện. Đến năm 2026, với hơn 40 ngôn ngữ ở độ trễ một đến hai câu và 96% ưa chuộng trong thử nghiệm mù, bài toán đó về cơ bản đã xong và rẻ đi từng quý.
Phiên âm đa ngôn ngữ giải bài toán trí nhớ, và lời giải băng thông chẳng chạm gì tới nó. Hiện vật khác, chính sách lưu trữ khác, kiểu hỏng khác. Một đội chỉ mua cái đầu tiên rồi tưởng đã có luôn cái thứ hai sẽ tiếp tục có những cuộc họp tuyệt vời mà họ không giải trình nổi.
Vậy câu hỏi đáng mang tới buổi làm việc tiếp theo với nhà cung cấp không phải «dịch được bao nhiêu ngôn ngữ». Bây giờ nhà cung cấp nghiêm túc nào cũng trả lời bằng một con số lớn hơn 40. Câu hỏi là: khi cuộc gọi kết thúc, thứ gì còn tồn tại — và bằng ngôn ngữ của ai?
Telli.sh đứng ở đâu: tất cả những gì ở trên đều nói về lớp nằm dưới phần dịch trực tiếp, và đó đúng là lớp chúng tôi xây. Telli.sh chạy phiên âm trực tiếp kèm dịch sang 44 ngôn ngữ đích, với giao diện có sẵn ở 15 ngôn ngữ, nên người tham gia ở Warsaw đọc buổi standup tiếng Hàn bằng tiếng Ba Lan ngay khi nó đang diễn ra. Điều quan trọng vào sáng hôm sau là cả ba hiện vật nằm trong cùng một ghi chú: văn bản ngôn ngữ gốc của những gì thực sự được nói, bản dịch khớp theo nó, và bản tóm tắt sinh ra bên trên. Xem lại được, sửa được và tìm kiếm được rất lâu sau khi cuộc gọi kết thúc.
Bắt đầu ghi chú cuộc họp có dịch trực tiếp
Nguồn
- Hugging Face và Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", ngày 28 tháng 8 năm 2026 — các bộ Monsoon en-IN và hi-IN, 4.888 người nói, độ chênh WER theo vùng, OIWER và lưới cho tiếng Hindi.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Cologne, ngày 16 tháng 4 năm 2026 — hơn 40 ngôn ngữ, bốn bề mặt sản phẩm và đánh giá mù của Slator do DeepL đặt hàng.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", ngày 17 tháng 4 năm 2026 — độ trễ ở buổi demo Seoul và ràng buộc trật tự từ.
- DeepL, trang sản phẩm và mục Hỏi đáp DeepL Voice for Online Meetings, truy cập ngày 31 tháng 8 năm 2026 — cách diễn đạt về lưu trữ dữ liệu, điểm số Slator, và ghi chú rằng chế độ giọng-sang-giọng cho họp trực tuyến vẫn đang triển khai dần.
- Trung tâm trợ giúp DeepL, DeepL Voice languages, truy cập ngày 31 tháng 8 năm 2026 — sự phân tách giữa ngôn ngữ nói và ngôn ngữ dịch.
- AI4Bharat, Orthographically-Informed Word Error Rate — chỉ số dùng cho các bộ tiếng Hindi.
- Độ phủ ngôn ngữ của Nova-3 từ Deepgram, tổng hợp trong bài của chính chúng tôi: phân tích mở rộng ngôn ngữ trong nhận dạng giọng nói, ngày 31 tháng 8 năm 2026.