การแปลในการประชุม 40+ ภาษาแบบเรียลไทม์ แล้วลบทิ้งเมื่อวางสาย: ถอดเสียงการประชุมหลายภาษาคือชั้นที่เก็บบันทึกไว้
DeepL เปิดตัว Voice-to-Voice เมื่อวันที่ 16 เมษายน 2026 รองรับกว่า 40 ภาษา และหน้าคำถามที่พบบ่อยของผลิตภัณฑ์เดียวกันระบุว่าข้อมูลการประชุมถูก «ประมวลผลชั่วคราวในหน่วยความจำและถูกลบเมื่อสายสิ้นสุด» วันที่ 28 สิงหาคม Open ASR Leaderboard เพิ่มภาษาจากกลุ่มประเทศซีกโลกใต้เป็นภาษาแรก และแสดงให้เห็นว่าสองโมเดลที่คะแนน WER เท่ากันที่ 4.9 ต่างกันเกือบสี่เท่าในแง่ที่ว่าความแม่นยำขึ้นกับถิ่นที่มาของผู้พูดมากแค่ไหน บริการแปลการประชุมแบบเรียลไทม์กำลังกลายเป็นของสามัญ แต่บันทึกการประชุมยังไม่ใช่
วันที่ 16 เมษายน 2026 DeepL เปิดตัว Voice-to-Voice จากเมืองโคโลญ เป็นชุดผลิตภัณฑ์แปลเสียงพูดแบบเรียลไทม์ที่ครอบคลุมสี่พื้นผิวการใช้งาน ได้แก่ การประชุมออนไลน์ การสนทนาบนมือถือและเว็บ สถานการณ์แบบกลุ่มสำหรับพนักงานหน้างาน และ API สำหรับองค์กร รองรับมากกว่า 40 ภาษา รวมภาษาราชการของสหภาพยุโรปครบทั้ง 24 ภาษา พร้อมภาษาเวียดนาม ไทย อาหรับ นอร์เวย์ ฮีบรู เบงกาลี และตากาล็อก ในการประเมินแบบปิดตาที่ Slator ดำเนินการตามที่ DeepL ว่าจ้าง นักภาษาศาสตร์ 96% เลือกผลิตภัณฑ์นี้แทนการแปลที่ติดมากับ Google, Microsoft และ Zoom โดย DeepL Voice สำหรับ Zoom ได้ 96.4 จาก 100 คะแนน เทียบกับ 87–89 ของแพลตฟอร์มคู่แข่ง
นี่คือผลิตภัณฑ์ที่ทำมาอย่างจริงจัง และสิ่งที่น่าสนใจไม่ใช่การเปิดตัว สิ่งที่น่าสนใจคือประโยคหนึ่งในหน้าคำถามที่พบบ่อยของหน้าผลิตภัณฑ์เดียวกันนั้น ซึ่งเราอ่านซ้ำอีกครั้งเมื่อวันที่ 31 สิงหาคม 2026
«DeepL ไม่จัดเก็บข้อมูลการถอดเสียงหรือข้อมูลการแปลอย่างถาวร ข้อมูลการประชุมจะถูกประมวลผลชั่วคราวในหน่วยความจำและถูกลบเมื่อสายสิ้นสุด»
ลองอ่านสองข้อเท็จจริงนี้เรียงกัน คำแปลยอดเยี่ยม และคำแปลนั้นหายไปแล้วก่อนถึงมื้อเย็น
สรุปสั้น
- ในปี 2026 การแปลการประชุมแบบเรียลไทม์ข้ามจากโจทย์ยากมาเป็นของสามัญที่ส่งมอบแล้ว: กว่า 40 ภาษาจาก DeepL, 58 ภาษาเดี่ยวบน Nova-3 ของ Deepgram, และการแปลสดในตัว Google Meet
- การไม่เก็บอะไรไว้เลยมักเป็นการออกแบบด้านความเป็นส่วนตัวโดยตั้งใจ ไม่ใช่ข้อบกพร่อง แต่ผลก็คือการประชุมนั้นไม่ทิ้งสิ่งใดที่ย้อนกลับมาตรวจสอบได้เลย
- การถอดเสียงหลายภาษาคือชั้นแยกที่อยู่ข้างล่าง มันเก็บบทถอดเสียงในภาษาต้นทาง คำแปล ป้ายกำกับผู้พูด และบทสรุป ไว้ในบันทึกเดียวกันที่ตรวจทานได้ บทความนี้ว่าด้วยเหตุผลที่สิ่งซึ่งต้องรอดมาให้ได้คือภาษาต้นทางโดยเฉพาะ และวิธีดำเนินการประชุมให้มันรอด
เราเคยเขียนข้อโต้แย้งนี้ในเวอร์ชันของ Google ไว้เมื่อเดือนมิถุนายน ตอนที่ Meet และ Translate ดันการแปลเสียงพูดแบบสดออกสู่ผู้ใช้ทั่วไป นั่นคือบทความ ทำไมการประชุมหลายภาษายังต้องการโน้ตที่ตรวจทานได้ หลังจากนั้นตลาดได้ตอบคำถามที่เราเพียงตั้งเอาไว้ การแปลสดใช้งานได้จริงแล้ว คำถามที่น่าสนใจจึงเลื่อนตำแหน่ง: เช้าวันจันทร์คุณเหลืออะไรอยู่ในมือ
การแปลในการประชุมแบบเรียลไทม์ไม่ใช่ส่วนที่ยากอีกต่อไป
ราวสิบปีที่ผ่านมา เสียงพูดหลายภาษาแบบสดคือเดโมที่ไม่เคยรอดเมื่อชนกับการประชุมจริง ความหน่วงกินจังหวะผลัดกันพูด สำเนียงทำให้ตัวรู้จำพัง และเนื้อหาที่มีความเป็นเทคนิคแม้เพียงเล็กน้อยก็ออกมาเละ ยุคนั้นจบลงภายในราวสิบเดือน
Nova-3 ของ Deepgram ระบุ 31 ภาษาในบันทึกรุ่นวันที่ 10 ธันวาคม 2025 และระบุ 58 ภาษาในเอกสารเดือนสิงหาคม 2026 นั่นคือการเพิ่มที่มีเอกสารยืนยัน 39 ภาษาในเวลาไม่ถึงเก้าเดือน หรือประมาณหนึ่งภาษาใหม่ทุกเจ็ดวัน เราไล่เรียงการขยายตัวนี้พร้อมตัวหนังสือเล็ก ๆ ที่รองอยู่ข้างใต้ไว้ในบทความ คำว่า «รองรับ» ซ่อนอะไรไว้จริง ๆ ในความครอบคลุมภาษาของการรู้จำเสียงพูด ฝั่ง Google ใส่การแปลเสียงพูดแบบสดเข้าไปใน Meet ส่วน DeepL ส่งชุดผลิตภัณฑ์เสียงสี่พื้นผิวออกมาในเดือนเมษายน
ข้อกล่าวอ้างเรื่องคุณภาพก็เจาะจงพอจะเถียงได้แล้ว ซึ่งตัวมันเองก็เป็นสัญญาณของความสุกงอม การประเมินของ Slator ที่ DeepL ว่าจ้างรายงานอัตราความผิดพลาด 4% สำหรับ DeepL Voice เทียบกับค่าเฉลี่ย 17% ของแพลตฟอร์มประชุมคู่แข่ง พร้อมคะแนน 96.4/100 บน Zoom และ 96.3/100 บน Teams ตัวเลขที่ผู้ขายว่าจ้างมาก็ควรถูกปฏิบัติในฐานะตัวเลขที่ผู้ขายว่าจ้างมา แต่ทิศทางนั้นไม่มีใครเถียง และการรายงานข่าวอย่างตรงไปตรงมาก็ชี้ไปทางเดียวกัน The Next Web ในบทความวันที่ 17 เมษายน 2026 บรรยายการสาธิตสดที่กรุงโซลซึ่งทำงานด้วยความหน่วงราวหนึ่งถึงสองประโยค และบันทึกว่าประธานเจ้าหน้าที่ฝ่ายผลิตภัณฑ์ของ DeepL ยอมรับว่าความต่างของลำดับคำระหว่างภาษายังเป็นข้อจำกัดพื้นฐานของความเร็วที่การแปลเสียงเป็นเสียงจะทำได้
ความหน่วงหนึ่งถึงสองประโยคถือว่าเพียงพอ มันไม่พอที่จะแทนล่ามมืออาชีพในการเจรจาสนธิสัญญา และก็ไม่มีใครอ้างเช่นนั้น แต่มันเหลือเฟือสำหรับการประชุมซิงก์ผลิตภัณฑ์วันอังคารระหว่างวอร์ซอ โซล และเซาเปาลู ซึ่งก็คือการประชุมที่พวกเราส่วนใหญ่มีอยู่จริง
ประเด็นอยู่ตรงนี้: เมื่อความสามารถอย่างหนึ่งดีขึ้นเร็วขนาดนี้ คอขวดจะย้ายที่ และมันย้ายไปแล้ว ตอนนี้มันอยู่ต่ำลงไปหนึ่งชั้น อยู่ที่ว่าการประชุมทิ้งอะไรไว้เบื้องหลัง
โดยการออกแบบ คำแปลไม่ได้อยู่ยืนยาวกว่าสายที่คุย
กลับไปที่ประโยคในคำถามที่พบบ่อยนั้น เพราะมันไม่ใช่ความสะเพร่า มันคือจุดยืนด้านความปลอดภัย และเป็นจุดยืนที่ดีด้วย ถ้อยคำของ DeepL เองเขียนต่อว่า ข้อมูลทั้งหมดถูกเข้ารหัสระหว่างส่ง ไม่เคยถูกใช้ฝึกโมเดล และ «คงอยู่เฉพาะบนอุปกรณ์ของผู้เข้าร่วมประชุมเท่านั้น» เวลาที่ธนาคารหรือโรงพยาบาลจัดซื้อเครื่องมือประชุม คำตอบว่า «เราไม่เก็บอะไรไว้เลย» คือคำตอบที่ผ่านฝ่ายกฎหมายได้เร็วที่สุด
จุดยืนแบบเดียวกันนี้พบทั่วไปในกลุ่มผลิตภัณฑ์คำบรรยายสด เพราะการเก็บเสียงของการประชุมหลายภาษาคือความรับผิดชอบประเภทที่ไม่มีใครอยากรับช่วงต่อ ค่าตั้งต้นของอุตสาหกรรมจึงกลายเป็น: เข้าใจกันได้ดีเยี่ยมในขณะนั้น และไม่มีสิ่งใดหลงเหลือหลังจากนั้น
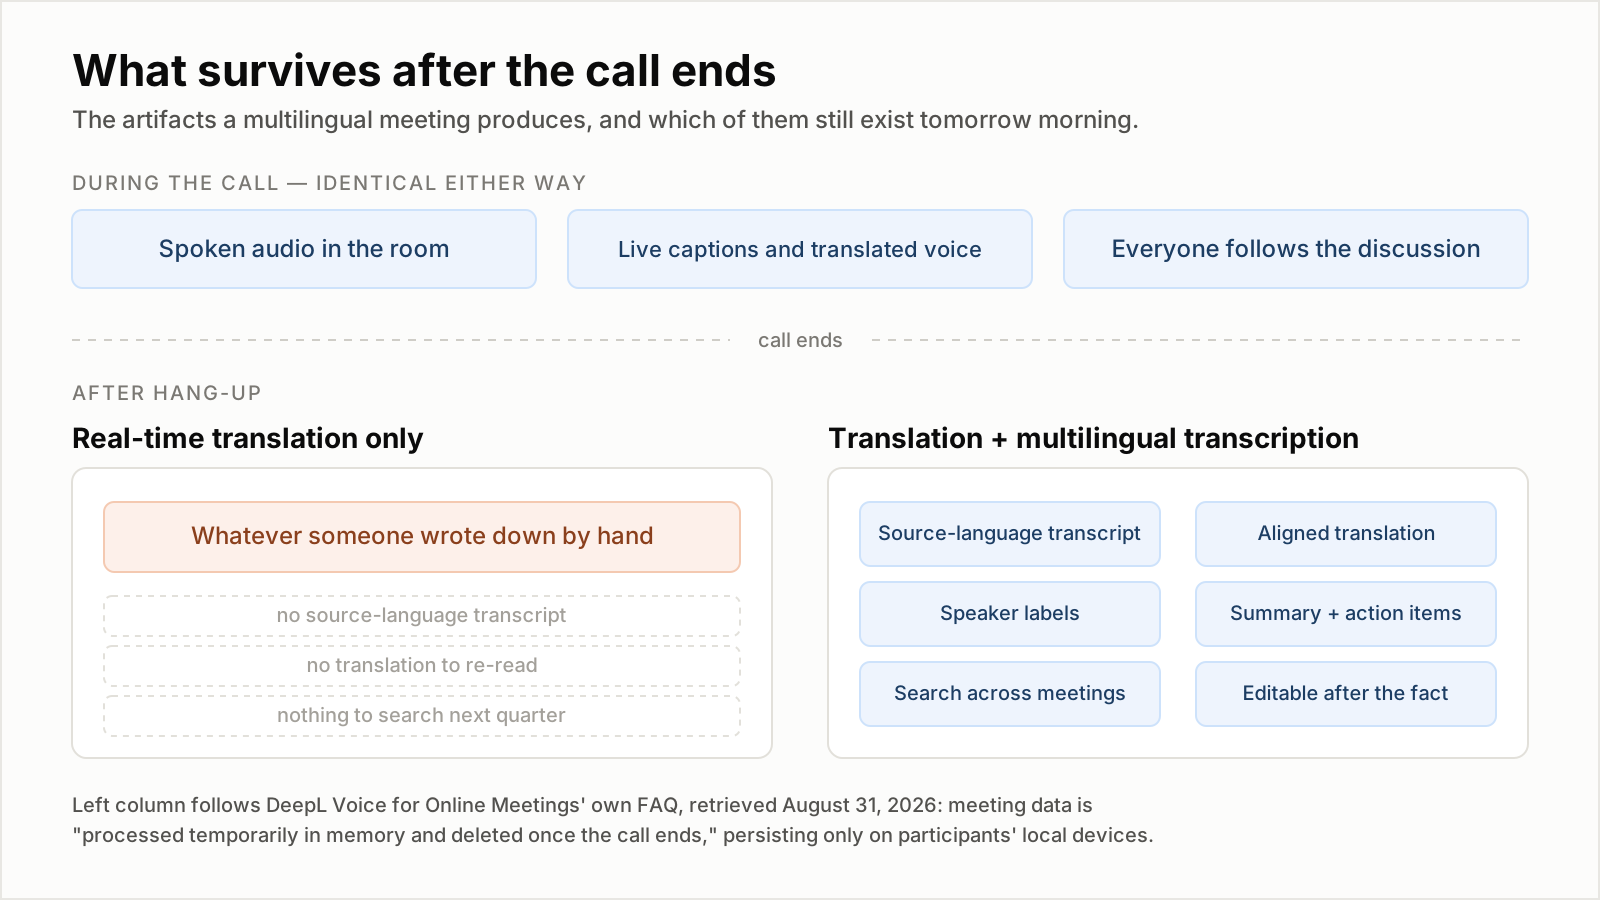
ระหว่างที่คุยอยู่ ทั้งสองแนวทางแยกกันไม่ออก ความต่างอยู่ที่อีกฝั่งของการวางสายทั้งหมด คอลัมน์ซ้ายอิงตามหน้าคำถามที่พบบ่อยของ DeepL Voice for Online Meetings เอง เข้าดูเมื่อวันที่ 31 สิงหาคม 2026
รูปแบบความล้มเหลวที่โครงสร้างนี้สร้างขึ้นมีรูปร่างของมัน และต้องการชื่อเรียก ขอเรียกว่า การเลื่อนไหลของการตัดสินใจ: ทุกคนเข้าใจการประชุมอย่างสมบูรณ์แบบ แล้วสามสัปดาห์ต่อมาไม่มีใครพิสูจน์ได้ว่าตกลงอะไรกันไว้ นี่ไม่ใช่ความเข้าใจผิด การแปลสดทำงานของมันครบถ้วน แต่สำเนาเดียวที่เหลือรอดของการตัดสินใจซึ่งเกิดขึ้นในสองภาษา อยู่ในความทรงจำของคนห้าคน ในถ้อยคำห้าแบบ อย่างน้อยสองภาษา และความทรงจำนั้นสร้างขึ้นใหม่ ไม่ได้เล่นซ้ำ
การเลื่อนไหลของการตัดสินใจมีราคาแพงในแบบที่ไม่เคยปรากฏบนใบแจ้งหนี้ของเครื่องมือ มันปรากฏเป็นฟีเจอร์ที่ต้องทำใหม่ เป็นกำหนดส่งที่ต้องเจรจากันอีกรอบ เป็นคำถามด้านการกำกับดูแลที่ไม่มีใครตอบได้ เป็นพนักงานใหม่ที่ไม่มีทางรู้ว่าทีมตัดสินใจอะไรไว้เมื่อไตรมาสก่อน
28 สิงหาคม: เกณฑ์วัดที่อธิบายว่าทำไมคุณต้องมีภาษาต้นทาง
ถ้าการถอดเสียงเป็นของสามัญที่แก้จบแล้วและสม่ำเสมอเท่ากันหมด การเก็บบันทึกก็คงเป็นแค่ปัญหาพื้นที่จัดเก็บ และบทความนี้ก็คงสั้น แต่มันไม่ใช่ และหลักฐานล่าสุดที่ชัดที่สุดเพิ่งลงมาเมื่อสามวันก่อน
วันที่ 28 สิงหาคม 2026 Hugging Face และ Voice Arena เพิ่มภาษาจากกลุ่มประเทศซีกโลกใต้เป็นภาษาแรกเข้าไปใน Open ASR Leaderboard นั่นคือภาษาฮินดี ซึ่งมีผู้พูดกว่าห้าร้อยล้านคน เข้าสู่แท็บหลายภาษาที่ก่อนหน้านั้นมีแต่ภาษายุโรป พวกเขาสมทบชุดประเมินสี่ชุด ได้แก่ Monsoon en-IN และ hi-IN ทั้งเวอร์ชันสาธารณะและเวอร์ชันปิด รวมผู้พูดที่ไม่ซ้ำกัน 4,888 คน บันทึกคุณลักษณะ 12 อย่างต่อผู้พูดหนึ่งคน เก็บจาก 428 อำเภอและจากโทรศัพท์จริงหลายร้อยรุ่น ไม่ใช่จากห้องอัด
จากนั้นพวกเขาก็เอาโมเดลที่อยู่บนกระดานอันดับมารันบนชุดข้อมูลนี้ ผลลัพธ์คือสิ่งที่มีประโยชน์ที่สุดที่เผยแพร่ในเดือนนี้เกี่ยวกับการรู้จำเสียงพูด
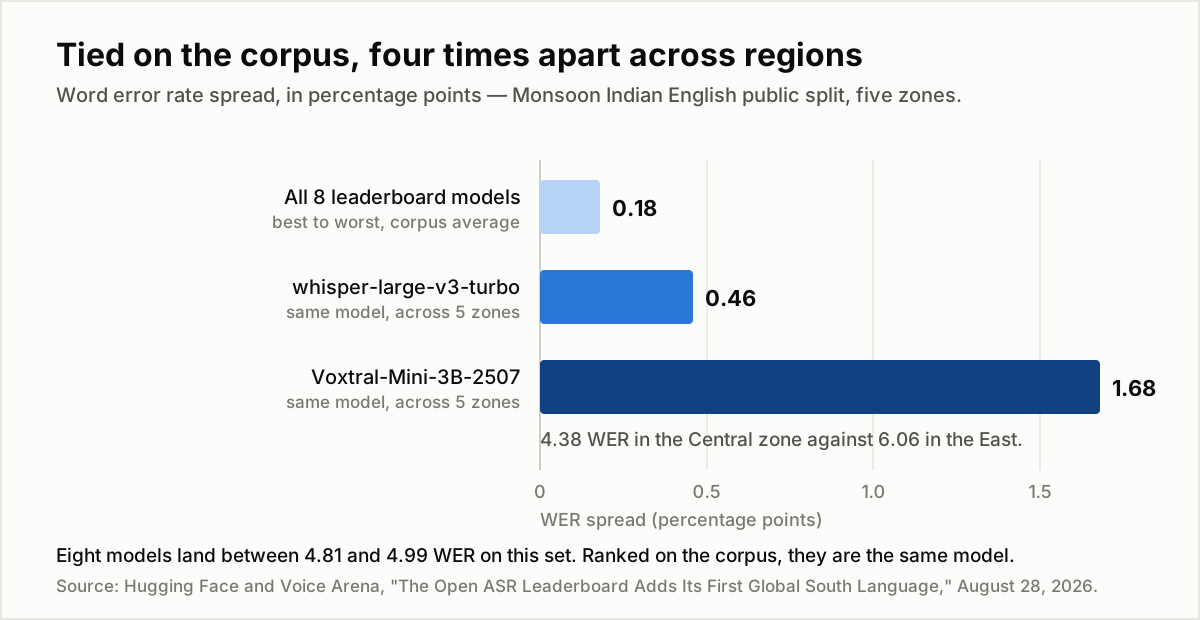
แกนเดียว หน่วยเดียว: สิ่งที่นำมาเทียบกันห่างกันกี่จุด WER ที่มา: Hugging Face และ Voice Arena, 28 สิงหาคม 2026
แปดโมเดลบนกระดานอันดับอยู่ระหว่าง WER 4.81 ถึง 4.99 บนชุดภาษาอังกฤษแบบอินเดียเวอร์ชันสาธารณะ นั่นคือห่างกัน 0.18 จุดจากตัวดีที่สุดถึงแย่ที่สุด ซึ่งอยู่ในระดับที่เสียงห้าชั่วโมงยังแยกไม่ออกด้วยซ้ำ เมื่อจัดอันดับตามคลังข้อมูล อย่างที่บทความนั้นเขียนไว้ พวกมันคือโมเดลเดียวกัน
แต่พอจัดกลุ่มผู้พูดตามภูมิภาค พวกมันก็เลิกเป็นโมเดลเดียวกัน เมื่อยกอำเภอบ้านเกิดของผู้พูดแต่ละคนขึ้นไปเป็นระดับสภาโซน openai/whisper-large-v3-turbo แกว่ง 0.46 จุดข้ามห้าโซน ส่วน mistralai/Voxtral-Mini-3B-2507 ซึ่งตามหลังอยู่เพียง 0.14 จุดในค่าเฉลี่ยคลังข้อมูล กลับแกว่งถึง 1.68 จุด คือ WER 4.38 ในโซนกลาง เทียบกับ 6.06 ในโซนตะวันออก สองระบบที่แยกไม่ออกบนกระดานอันดับ ต่างกันเกือบสี่เท่าในแง่ที่ว่าความแม่นยำของมันขึ้นกับถิ่นที่ผู้พูดเติบโตมามากเพียงใด
และไม่ใช่ว่ามีภูมิภาคใดยากกว่าโดยตัวมันเอง ibm-granite/granite-speech-3.3-2b แย่ที่สุดในภาคเหนือ microsoft/VibeVoice-ASR-HF แย่ที่สุดในภาคใต้ ส่วน Voxtral แย่ที่สุดในภาคตะวันออก ถ้ามีโซนใดยากโดยธรรมชาติ ทุกโมเดลก็ควรจัดลำดับโซนเหมือนกันหมด แต่พวกมันไม่ทำเช่นนั้น ซึ่งชี้ไปที่ตัวโมเดล ไม่ใช่ที่ตัวเสียง
การอ่านเชิงปฏิบัติสำหรับคนที่ต้องดำเนินการประชุมหลายภาษา: คุณภาพการถอดเสียงของคุณไม่ใช่ตัวเลขตัวเดียวที่เปิดดูได้ มันเป็นฟังก์ชันของว่าใครอยู่ในห้อง เพื่อนร่วมงานที่ผู้ให้บริการของคุณเก็บตัวอย่างสำเนียงของเขาไว้น้อยที่สุด คือคนที่ประโยคจะออกมาผิด และทั้งกระดานอันดับและหน้าเว็บผู้ขายก็จะไม่เตือนคุณ การป้องกันเดียวคือบทถอดเสียงที่มนุษย์อ่านและแก้ได้ ซึ่งเรียกร้องว่าต้องมีบทถอดเสียงอยู่ก่อน
ภาษาฮินดีเขียนวลีเดียวกันได้สิบแบบที่ถูกต้อง คำแปลเลือกมาแบบเดียว
ข้อค้นพบที่สองในการเผยแพร่ชุดเดียวกันนั้นละเอียดอ่อนกว่า และเฉียดใกล้ข้อโต้แย้งของบทความนี้มากกว่า
ความผันแปรทางอักขรวิธีของภาษาอังกฤษมีขอบเขต: อังกฤษแบบบริติชกับอเมริกัน เครื่องหมายวรรคตอน ตัวเลขกับตัวหนังสือ ตัวนอร์มัลไลเซอร์ยุบส่วนใหญ่ให้เหลือรูปเดียวได้ ภาษาฮินดีไม่มีขอบเขตแบบนั้น ภาษาพูดในชีวิตประจำวันปนภาษาอังกฤษหนาแน่น คำที่มาจากภาษาอังกฤษไม่มีการสะกดแบบเทวนาครีที่ลงตัว และคำประสมจะเขียนติดกันหรือแยกกันก็แล้วแต่ความชอบ วลีเดียวอาจมีรูปเขียนที่ถูกต้องสิบแบบหรือมากกว่า และไม่มีฝั่งที่เป็นมาตรฐานให้ยุบเข้าไปหาเลย
ชุดข้อมูลฮินดีจึงมาพร้อมแลตทิซ คือในแต่ละช่วงของบทถอดเสียงจะมีเซ็ตของรูปเขียนที่ยอมรับว่าถูกต้องแนบมาด้วย และให้คะแนนด้วย OIWER คืออัตราความผิดพลาดระดับคำที่คำนึงถึงอักขรวิธี ซึ่ง AI4Bharat เป็นผู้เสนอ แทนที่จะใช้ WER ธรรมดา เมื่อเอาผลลัพธ์ชุดเดิมมาให้คะแนนใหม่โดยเทียบกับเวอร์ชันที่ถูกยุบให้เหลืออ้างอิงเดียว อัตราความผิดพลาดสูงขึ้นในทุกระบบ สูงขึ้นไม่เท่ากัน และมีคู่ระบบที่สลับอันดับกัน ภายใต้อ้างอิงเดียว โมเดลได้รางวัลส่วนหนึ่งจากการผลิตซ้ำการสะกดที่ผู้ทำคำอธิบายเลือกไว้ ส่วนภายใต้แลตทิซ สิ่งที่ถูกให้คะแนนคือการรู้จำล้วน ๆ
หยุดคิดสักครู่ว่านี่หมายความว่าอะไร แม้ในระดับที่ว่า «สิ่งใดถูกเขียนลงไป» ก็มักไม่มีสายอักขระที่ถูกต้องเพียงสายเดียว มีเพียงเซ็ตของสายอักขระที่ยอมรับได้ และการเลือกมาหนึ่งอันคือการโยนข้อมูลทิ้ง
การแปลก็คือการยุบแบบเดียวกันนี้ เพียงแต่สูงขึ้นไปอีกชั้นและสูญเสียมากกว่ามาก ทุกบรรทัดที่ถูกแปลคือการตัดสินใจเลือกระหว่างการตีความ ซึ่งต้นฉบับไม่จำเป็นต้องตัดสินใจเลย
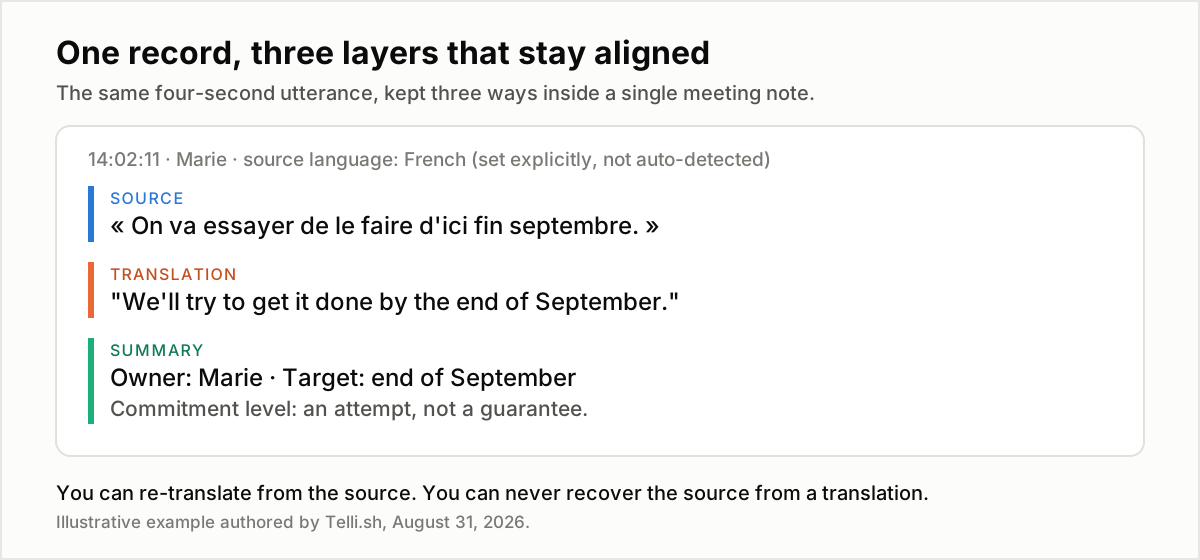
บรรทัดในภาษาต้นทางคือบรรทัดเดียวในสามบรรทัดที่สร้างขึ้นใหม่จากอีกสองบรรทัดไม่ได้
เมื่อ «On va essayer de le faire d'ici fin septembre» กลายเป็น «เราจะพยายามทำให้เสร็จภายในสิ้นเดือนกันยายน» มีบางอย่างที่เป็นจริงเปลี่ยนไป คำว่า essayer ในภาษาฝรั่งเศสมีน้ำเสียงผ่อนหนักเป็นเบาเฉพาะตัว ซึ่งคำว่า «พยายาม» ทำให้แบนราบลง นั่นคือคำมั่นหรือแค่ความตั้งใจ บรรทัดที่แปลแล้วบอกไม่ได้ บรรทัดต้นทางบอกได้ หกสัปดาห์ถัดมา เมื่อกำหนดการเลื่อนและสองทีมจำประโยคนั้นไม่ตรงกัน บรรทัดต้นทางคือข้อโต้แย้งทั้งหมด
นี่คือความไม่สมมาตรที่อยู่ใจกลางเรื่องทั้งหมด การแปลเดินทางเดียว จากต้นฉบับ คุณจะแปลใหม่กี่ครั้งก็ได้ ปีหน้าด้วยโมเดลที่ดีกว่าก็ได้ แต่จากคำแปล คุณไม่มีวันกู้ต้นฉบับกลับมาได้เลย
หลังวางสายแล้วเหลืออะไร: บริการแปลการประชุมแบบเรียลไทม์ เทียบกับตัวที่เก็บบันทึกการประชุมไว้ด้วย
นี่คือการเปรียบเทียบที่พูดกันตรง ๆ ระหว่างสามวิธีที่ทีมงานใช้จัดการประชุมหลายภาษาในทุกวันนี้
| สิ่งที่คุณมีในเช้าวันรุ่งขึ้น | ชั้นการแปลแบบเรียลไทม์ | ล่ามที่เป็นมนุษย์ | ตัวแปลการประชุมที่มีโน้ต |
|---|---|---|---|
| ความเข้าใจกันในห้อง | มี | มี คุณภาพสูงสุด | มี |
| ไฟล์เสียงของการประชุม | เฉพาะเมื่อบันทึกแยกไว้ | เฉพาะเมื่อบันทึกแยกไว้ | มี |
| บทถอดเสียงในภาษาต้นทาง | ไม่มี | ไม่มี เว้นแต่ถอดแยกต่างหาก | มี |
| คำแปลที่เรียงตรงกับต้นฉบับ | ไม่มี | ไม่มี | มี |
| ใครพูดบรรทัดไหน | ไม่มี | ไม่มี | มี พร้อมป้ายกำกับผู้พูด |
| บทสรุปและรายการงานที่ต้องทำ | ไม่มี | โน้ตของล่าม ถ้ามี | มี สร้างจากบทถอดเสียง |
| ค้นหาได้ในอีกสามเดือน | ไม่ได้ | ไม่ได้ | ได้ |
| แก้บรรทัดที่ผิดได้ | ไม่ได้ | หลังจากนั้นแก้ไม่ได้ | ได้ แก้ที่ตัวบันทึก |
| ต้นทุนต่อชั่วโมงโดยทั่วไป | ค่าสมาชิกซอฟต์แวร์ | 100–200 ดอลลาร์สหรัฐขึ้นไป การประชุมยาวต้องใช้ล่ามสองคน | ค่าสมาชิกซอฟต์แวร์ |
พฤติกรรมของคอลัมน์ที่หายไปอิงตามหน้าคำถามที่พบบ่อยซึ่งเผยแพร่ของ DeepL Voice for Online Meetings เข้าดูเมื่อวันที่ 31 สิงหาคม 2026 ส่วนค่าจ้างล่ามคือช่วงราคาตลาดที่มีการเผยแพร่กันทั่วไปสำหรับล่ามการประชุมมืออาชีพ และเปลี่ยนไปตามคู่ภาษาและตลาด คอลัมน์ที่สามอธิบายกลุ่มผลิตภัณฑ์ «ตัวแปลการประชุมที่มีโน้ต» โดยรวม ไม่ใช่ผู้ให้บริการรายใดรายหนึ่ง
รูปทรงของตารางนี้คือข้อโต้แย้งในตัวมันเอง คอลัมน์ที่หนึ่งกับคอลัมน์ที่สามเหมือนกันทุกประการในแถวเดียวที่ผู้ซื้อมักประเมิน คือความเข้าใจกันขณะประชุม และต่างกันในทุกแถวที่มีความหมายหลังการประชุมจบลง การเปรียบเทียบผู้ให้บริการเกือบทั้งหมดวิ่งอยู่บนแถวแรกแถวเดียว
ตัวแปลสดคือหน้าต่าง ตัวแปลการประชุมที่มีโน้ตคือหน้าต่างและสมุดบัญชีในเวลาเดียวกัน ทีมงานซื้อหน้าต่างเพราะนั่นคือส่วนที่พวกเขาสัมผัสได้ แล้วก็เดินไตรมาสทั้งไตรมาสด้วยสมุดบัญชีที่ไม่เคยซื้อ
วิธีจัดประชุมสองภาษาและหลายภาษาให้บันทึกการประชุมยังใช้งานได้
หกขั้นตอน เรียงตามลำดับที่มันเกิดขึ้นจริงในการประชุม ไม่มีขั้นตอนไหนพิสดารเลย ความล้มเหลวเกือบทุกครั้งเกิดจากการที่ไม่มีใครตัดสินใจ
- ตั้งภาษาต้นทางอย่างชัดเจน อย่าพึ่งการตรวจจับอัตโนมัติ การตรวจจับอัตโนมัติต้องตัดสินใจภายในไม่กี่วินาทีแรก บนเสียงที่มีบริบทน้อยที่สุดของทั้งเซสชัน และถ้าเดาผิด ทุกขั้นตอนถัดไปจะแย่ลงพร้อมกันหมด การเลือกอย่างชัดเจนยังทำให้เอนจินส่งคุณไปยังโมเดลภาษาเดี่ยวโดยเฉพาะได้ ซึ่งโดยทั่วไปแข็งแรงกว่าโมเดลหลายภาษา อย่าง Nova-3 เองก็ทำเอกสารไว้ 58 ภาษาแบบทีละภาษา แต่การสลับภาษาในประโยคเดียวกันรองรับเพียง 10 ภาษาเท่านั้น
- แยกภาษาที่คนจะพูด ออกจากภาษาที่คนจะอ่าน นี่คือรายการสองรายการที่ต่างกัน และการเหมารวมเป็นรายการเดียวคือความผิดพลาดในการตั้งค่าที่พบบ่อยที่สุดของผลิตภัณฑ์กลุ่มนี้ ศูนย์ช่วยเหลือของ DeepL เองก็แยกไว้แบบนี้เป๊ะ ๆ «ภาษาพูด» คือสิ่งที่ตัวรู้จำรับได้ ส่วน «ภาษาแปล» คือสิ่งที่คำบรรยายจะแสดงผลออกมาได้ และรายการหลังยาวกว่ามาก
- ตัดสินใจก่อนเริ่มประชุมว่าบันทึกจะไปอยู่ที่ไหน และยืนยันว่ามันไม่ใช่แพลตฟอร์มการประชุม ถ้าผู้ให้บริการแปลของคุณลบข้อมูลการประชุมตอนวางสาย ซึ่งเป็นค่าตั้งต้นและเป็นค่าตั้งต้นที่มีเหตุผลรองรับ ก็จะไม่มีการตั้งค่าใดในเครื่องมือนั้นที่สร้างบันทึกขึ้นมาได้ การเก็บบันทึกต้องเป็นทางเลือกที่แยกต่างหากและตั้งใจทำ
- เปิดป้ายกำกับผู้พูดไว้ บรรทัดที่แปลแล้วโดยไม่รู้ว่าใครพูดนั้นใช้ไม่ได้กับการตัดสินใจใด ๆ ที่มันควรจะไปค้ำในภายหลัง ประโยค «เราจะทำให้เสร็จภายในกันยายน» จะกลายเป็นข้อเท็จจริงก็ต่อเมื่อรู้ว่าใครเป็นคนพูด
- แก้ชื่อเฉพาะและศัพท์เฉพาะทางภายในห้านาทีแรก แก้สด ๆ ชื่อเฉพาะ ชื่อรหัสผลิตภัณฑ์ และตัวย่อ คือจุดที่การถอดเสียงพลาดอย่างสม่ำเสมอ และเป็นจุดที่บรรทัดผิดจะทำลายบทสรุปที่สร้างขึ้นภายหลังมากที่สุดด้วย แก้ระหว่างที่ประชุมยังเดินอยู่ใช้เวลาไม่กี่วินาที ส่วนการแก้ในเอกสารที่ไม่มีใครกลับไปอ่านนั้นไม่มีต้นทุนเลย เพราะไม่มีใครกลับไปอ่าน
- สร้างบทสรุปจากบทถอดเสียงภาษาต้นทางเมื่อทำได้ ไม่ใช่จากคำแปล การสรุปคำแปลคือการซ้อนขั้นตอนที่มีการสูญเสียสองชั้นเข้าด้วยกัน ข้อนี้เป็นคำแนะนำของเราเอง ไม่ใช่ผลที่วัดมา แต่กลไกนั้นตรงไปตรงมา ทุกขั้นตอนโยนข้อมูลทิ้ง และการซ้อนกันก็โยนทิ้งมากขึ้น
จากนั้นเก็บทั้งสามสิ่งไว้ในบันทึกเดียวกัน บทถอดเสียงอยู่ในเครื่องมือหนึ่ง คำแปลอยู่ในประวัติแชท และบทสรุปอยู่ในเอกสารอีกที่ นั่นคือสามไฟล์ที่จะขัดแย้งกันเองภายในหนึ่งเดือน และความขัดแย้งนั้นเองคือสิ่งที่คุณพยายามป้องกันตั้งแต่แรก
สรุปแก่น: ความเข้าใจเคยเป็นปัญหาแบนด์วิดท์ ส่วนบันทึกคือปัญหาความทรงจำ
การแปลการประชุมแบบเรียลไทม์แก้ปัญหาแบนด์วิดท์ คือการส่งความหมายข้ามโต๊ะให้เร็วพอที่บทสนทนายังรู้สึกเป็นบทสนทนา ในปี 2026 ด้วยกว่า 40 ภาษาที่ความหน่วงหนึ่งถึงสองประโยค และความนิยม 96% ในการทดสอบแบบปิดตา ปัญหานั้นถือว่าแก้ไปได้มากแล้วและถูกลงทุกไตรมาส
การถอดเสียงหลายภาษาแก้ปัญหาความทรงจำ และไม่มีอะไรในคำตอบฝั่งแบนด์วิดท์ที่แตะปัญหานี้เลย สิ่งที่ได้ต่างกัน นโยบายการเก็บรักษาต่างกัน รูปแบบความล้มเหลวต่างกัน ทีมที่ซื้อแค่อย่างแรกแล้วคิดว่าได้อย่างที่สองมาด้วย จะยังคงมีการประชุมที่ยอดเยี่ยมซึ่งพวกเขาอธิบายที่มาที่ไปไม่ได้ต่อไป
ดังนั้นคำถามที่ควรถือติดมือไปคุยกับผู้ให้บริการรายถัดไปจึงไม่ใช่ «แปลได้กี่ภาษา» เพราะตอนนี้ผู้ให้บริการที่จริงจังทุกรายตอบด้วยตัวเลขที่มากกว่า 40 คำถามที่ควรถามคือ เมื่อสายจบลง อะไรยังคงอยู่ และอยู่ในภาษาของใคร
Telli.sh อยู่ตรงไหน: ทั้งหมดข้างต้นว่าด้วยชั้นที่อยู่ใต้การแปลสด และนั่นคือชั้นที่เราสร้างพอดี Telli.sh ทำการถอดเสียงสดพร้อมแปลไปยัง 44 ภาษาปลายทาง โดยตัวอินเทอร์เฟซเองมีให้ใช้ 15 ภาษา คนที่เข้าร่วมจากวอร์ซอจึงอ่านการประชุมเช้าภาษาเกาหลีเป็นภาษาโปแลนด์ได้ในขณะที่มันกำลังดำเนินอยู่ สิ่งที่สำคัญในเช้าวันรุ่งขึ้นคือ ทั้งสามสิ่งอยู่ในโน้ตเดียวกัน ได้แก่ ข้อความภาษาต้นทางของสิ่งที่ถูกพูดออกมาจริง คำแปลที่เรียงตรงกับมัน และบทสรุปที่สร้างทับอยู่ข้างบน ตรวจทานได้ แก้ไขได้ และค้นหาได้อีกนานหลังจากที่สายจบลงแล้ว
แหล่งอ้างอิง
- Hugging Face และ Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 สิงหาคม 2026 — ชุด Monsoon en-IN และ hi-IN, ผู้พูด 4,888 คน, ความแปรผันของ WER รายโซน, OIWER และแลตทิซของภาษาฮินดี
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, โคโลญ, 16 เมษายน 2026 — กว่า 40 ภาษา, สี่พื้นผิวผลิตภัณฑ์ และการประเมินแบบปิดตาของ Slator ที่ DeepL ว่าจ้าง
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 เมษายน 2026 — ความหน่วงในการสาธิตที่โซลและข้อจำกัดเรื่องลำดับคำ
- DeepL, หน้าผลิตภัณฑ์และคำถามที่พบบ่อยของ DeepL Voice for Online Meetings, เข้าดูเมื่อ 31 สิงหาคม 2026 — ถ้อยคำเรื่องการเก็บรักษาข้อมูล, คะแนนจาก Slator และหมายเหตุว่าโหมดเสียงเป็นเสียงสำหรับการประชุมออนไลน์ยังทยอยเปิดใช้งาน
- ศูนย์ช่วยเหลือ DeepL, DeepL Voice languages, เข้าดูเมื่อ 31 สิงหาคม 2026 — การแยกระหว่างภาษาพูดกับภาษาแปล
- AI4Bharat, Orthographically-Informed Word Error Rate — ตัวชี้วัดที่ใช้กับชุดข้อมูลภาษาฮินดี
- ความครอบคลุมภาษาของ Nova-3 จาก Deepgram ตามที่รวบรวมไว้ในบทความของเราเอง การวิเคราะห์การขยายภาษาในการรู้จำเสียงพูด, 31 สิงหาคม 2026