40+ bahasa diterjemah secara langsung, dipadam sebaik talian ditamatkan: transkripsi berbilang bahasa ialah lapisan yang menyimpan mesyuarat itu
DeepL melancarkan Voice-to-Voice pada 16 April 2026 untuk lebih 40 bahasa, dan FAQ produk yang sama menyatakan data mesyuarat «diproses sementara dalam memori dan dipadam sebaik panggilan tamat». Pada 28 Ogos, Open ASR Leaderboard menambah bahasa Selatan Global pertamanya dan menunjukkan bahawa dua model yang seri pada 4.9 WER berbeza hampir empat kali ganda dari segi sejauh mana ketepatannya bergantung pada asal usul penutur. Terjemahan mesyuarat masa nyata sedang menjadi komoditi. Rekodnya belum.
Pada 16 April 2026, DeepL melancarkan Voice-to-Voice dari Cologne: satu suite terjemahan suara masa nyata yang merangkumi empat permukaan — mesyuarat maya, perbualan pada telefon dan web, situasi berkumpulan untuk pekerja barisan hadapan, serta API untuk perusahaan. Ia mengendalikan lebih 40 bahasa, termasuk kesemua 24 bahasa rasmi EU di samping bahasa Vietnam, Thai, Arab, Norway, Ibrani, Bengali dan Tagalog. Dalam penilaian buta yang dijalankan oleh Slator atas tempahan DeepL, 96% ahli bahasa memilihnya berbanding terjemahan asli yang terbina dalam Google, Microsoft dan Zoom; DeepL Voice untuk Zoom memperoleh 96.4 daripada 100 berbanding 87–89 bagi platform pesaing.
Ini produk yang dibuat dengan serius, dan bahagian yang menarik bukanlah pelancarannya. Yang menarik ialah satu ayat dalam FAQ pada halaman produk yang sama, yang kami baca semula pada 31 Ogos 2026:
«DeepL tidak menyimpan data transkripsi atau terjemahan secara kekal. Data mesyuarat diproses sementara dalam memori dan dipadam sebaik panggilan tamat.»
Bacalah dua fakta itu bersebelahan. Terjemahannya cemerlang, dan terjemahan itu sudah lenyap sebelum makan malam.
Ringkasan pantas
- Pada 2026, terjemahan mesyuarat masa nyata berpindah daripada masalah sukar kepada komoditi yang sudah dihantar: lebih 40 bahasa di DeepL, 58 bahasa tunggal pada Nova-3 milik Deepgram, terjemahan langsung di dalam Google Meet.
- Tiada apa-apa yang tinggal biasanya merupakan keputusan privasi yang disengajakan, bukan kecacatan — tetapi ia bermakna mesyuarat itu sendiri tidak meninggalkan sebarang artifak yang boleh disemak semula.
- Transkripsi berbilang bahasa ialah lapisan berasingan di bawahnya. Ia menyimpan transkrip dalam bahasa sumber, terjemahan, label penutur dan ringkasan dalam satu rekod yang boleh disemak. Tulisan ini membincangkan mengapa yang mesti bertahan justeru bahasa sumber, dan bagaimana mengendalikan mesyuarat supaya ia bertahan.
Versi hujah ini yang menumpukan Google telah kami tulis pada Jun lalu, ketika Meet dan Translate menolak terjemahan pertuturan langsung kepada pengguna umum: mengapa mesyuarat berbilang bahasa masih memerlukan nota yang boleh disemak. Sejak itu pasaran telah menjawab soalan yang ketika itu kami hanya ajukan. Terjemahan langsung kini benar-benar berfungsi. Maka soalan yang menarik pun beralih: pada hari Isnin, apa yang tinggal di tangan anda?
Terjemahan mesyuarat masa nyata bukan lagi bahagian yang sukar
Selama kira-kira sedekad, pertuturan berbilang bahasa secara langsung ialah demo yang tidak pernah selamat apabila bertembung dengan mesyuarat sebenar. Kelewatan memakan giliran bercakap, loghat memusnahkan pengecam suara, dan apa sahaja yang sedikit teknikal keluar berkecai. Era itu berakhir dalam masa kira-kira sepuluh bulan.
Nova-3 daripada Deepgram menyenaraikan 31 bahasa dalam nota keluaran bertarikh 10 Disember 2025 dan 58 dalam dokumentasi Ogos 2026: 39 penambahan berdokumen dalam masa kurang sembilan bulan, lebih kurang satu bahasa baharu setiap tujuh hari. Kami menyusuri pengembangan itu, berserta cetakan halus di bawahnya, dalam apa yang sebenarnya disembunyikan perkataan «disokong» dalam liputan bahasa pengecaman pertuturan. Google memasukkan terjemahan pertuturan langsung ke dalam Meet. DeepL menghantar suite suara berpermukaan empat pada April.
Dakwaan kualiti kini cukup khusus untuk dipertikaikan, dan itu sendiri satu tanda kematangan. Penilaian Slator yang ditempah DeepL melaporkan kadar ralat 4% bagi DeepL Voice berbanding purata 17% pada platform mesyuarat pesaing, serta 96.4/100 pada Zoom dan 96.3/100 pada Teams. Angka yang ditempah vendor patut dilayan sebagai angka yang ditempah vendor. Namun arahnya tidak dipertikaikan, dan liputan yang jujur menunjuk ke arah yang sama: The Next Web, dalam artikel 17 April 2026, menggambarkan demo langsung di Seoul yang berjalan dengan kelewatan satu hingga dua ayat, dan mencatat pengakuan ketua pegawai produk DeepL bahawa perbezaan susunan kata antara bahasa kekal menjadi kekangan asas terhadap kelajuan yang boleh dicapai terjemahan suara-ke-suara.
Kelewatan satu hingga dua ayat sudah memadai. Ia tidak memadai untuk menggantikan jurubahasa profesional dalam rundingan perjanjian, dan tiada siapa mendakwa begitu. Tetapi ia lebih daripada cukup untuk sesi penyelarasan produk hari Selasa antara Warsaw, Seoul dan São Paulo — iaitu mesyuarat yang benar-benar kita jalani.
Inilah intinya: apabila sesuatu keupayaan menjadi sebaik itu sepantas itu, halangan sesak akan berpindah. Ia sudah berpindah. Kini ia berada satu lapisan di bawah, pada apa yang ditinggalkan oleh mesyuarat itu.
Menurut reka bentuknya, terjemahan itu tidak hidup lebih lama daripada panggilan
Kembali kepada ayat FAQ tadi, kerana itu bukan kecuaian. Itu satu pendirian keselamatan, dan pendirian yang baik. Kata-kata DeepL sendiri bersambung: semua data disulitkan semasa transit, tidak pernah digunakan untuk melatih model, dan «hanya kekal pada peranti tempatan peserta mesyuarat». Apabila bank atau hospital membeli alat mesyuarat, jawapan «kami tidak menyimpan apa-apa» ialah jawapan yang paling cepat melepasi semakan undang-undang.
Pendirian yang sama lazim di seluruh kategori sari kata langsung, kerana menyimpan audio mesyuarat berbilang bahasa memang jenis tanggungjawab yang tiada siapa mahu warisi. Maka lalai industri kini menjadi: kefahaman yang sangat baik pada waktu itu, dan tiada artifak selepasnya.
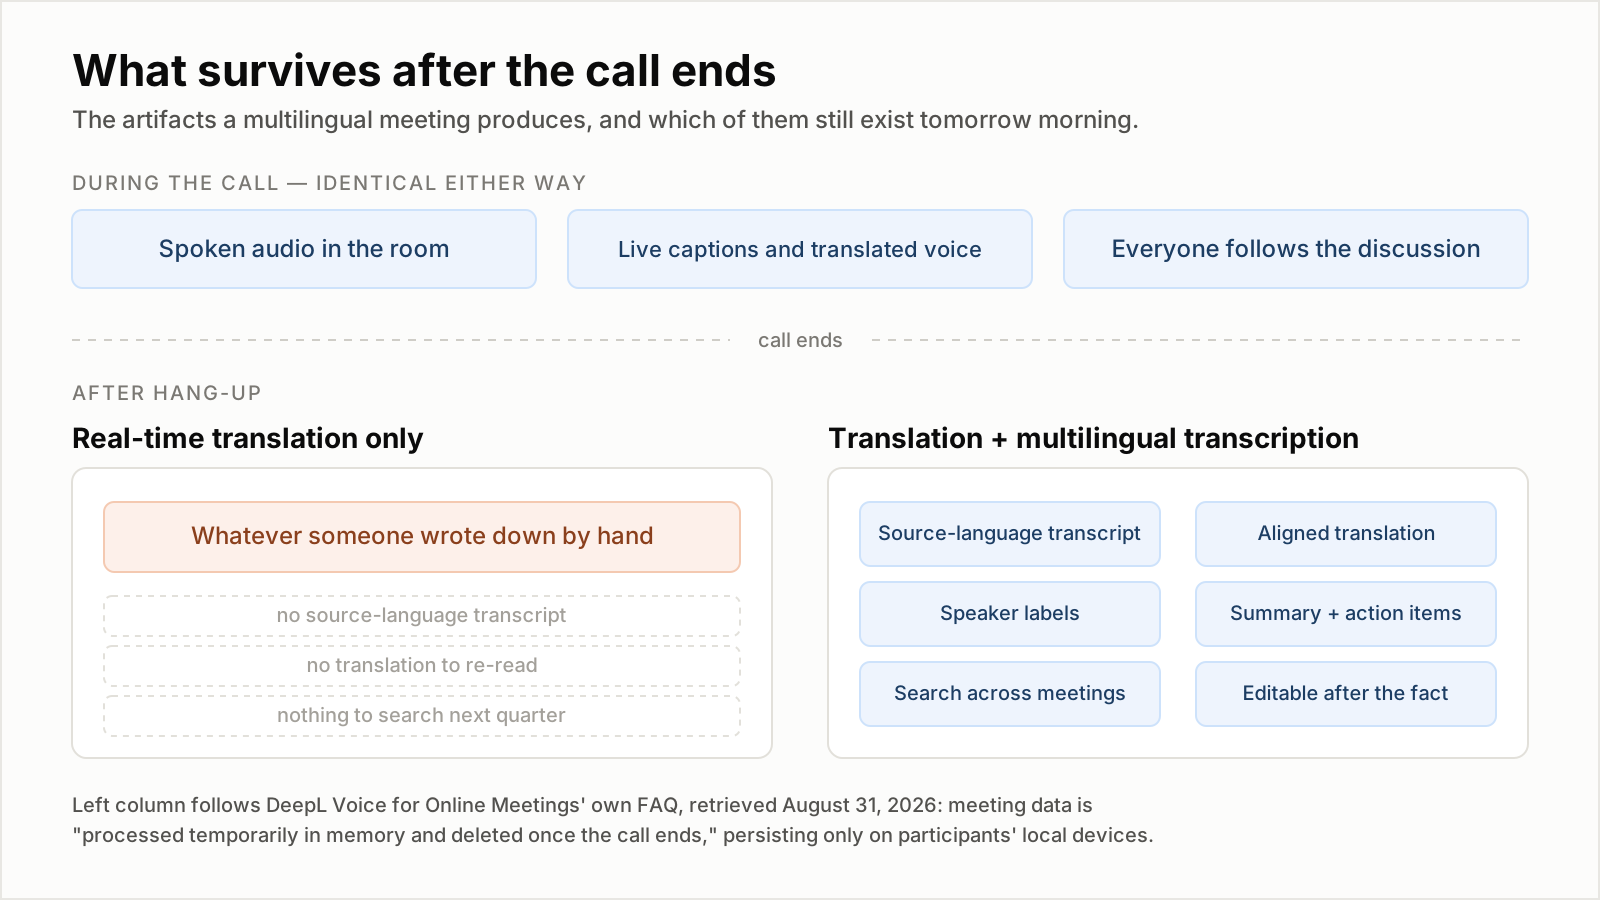
Semasa panggilan berlangsung, kedua-dua pendekatan tidak dapat dibezakan. Perbezaannya sepenuhnya berada di sebelah sana penamatan talian. Lajur kiri mengikut FAQ DeepL Voice for Online Meetings sendiri, dicapai pada 31 Ogos 2026.
Mod kegagalan yang terhasil daripada struktur ini mempunyai bentuknya, dan ia memerlukan nama. Panggil sahaja hanyutan keputusan: semua orang memahami mesyuarat itu dengan sempurna, dan tiga minggu kemudian tiada siapa boleh membuktikan apa yang telah dipersetujui. Ini bukan salah faham — terjemahan langsung sudah melakukan tugasnya. Masalahnya, satu-satunya salinan yang tinggal bagi keputusan yang dibuat dalam dua bahasa itu hidup dalam lima ingatan, dalam lima rumusan berbeza, sekurang-kurangnya dalam dua bahasa, dan ingatan itu membina semula, bukan memainkan semula.
Hanyutan keputusan mahal dengan cara yang tidak pernah muncul pada invois alat itu. Ia muncul sebagai ciri yang dibina semula, tarikh akhir yang dirundingkan semula, soalan pematuhan yang tiada siapa boleh jawab, pekerja baharu yang tiada cara untuk mengetahui apa yang diputuskan pasukan pada suku tahun lalu.
28 Ogos: penanda aras yang menerangkan mengapa anda memerlukan bahasa sumber
Andai transkripsi ialah komoditi yang sudah selesai dan seragam, menyimpan rekod hanyalah masalah ruang storan dan tulisan ini akan pendek sahaja. Ia bukan begitu, dan bukti terkini paling jelas mendarat tiga hari lalu.
Pada 28 Ogos 2026, Hugging Face dan Voice Arena menambah bahasa Selatan Global pertama ke dalam Open ASR Leaderboard: bahasa Hindi, dituturkan lebih setengah bilion orang, masuk ke tab berbilang bahasa yang sebelum itu hanya merangkumi bahasa Eropah. Mereka menyumbang empat set penilaian — Monsoon en-IN dan hi-IN, versi awam dan persendirian — dengan 4,888 penutur yang tidak bertindih, 12 atribut direkodkan bagi setiap penutur, dikumpul di 428 daerah dan pada ratusan model telefon sebenar, bukan di studio.
Kemudian mereka menjalankan model-model yang sedia ada pada papan pendahulu itu ke atasnya. Hasilnya ialah perkara paling berguna yang diterbitkan bulan ini tentang pengecaman pertuturan.
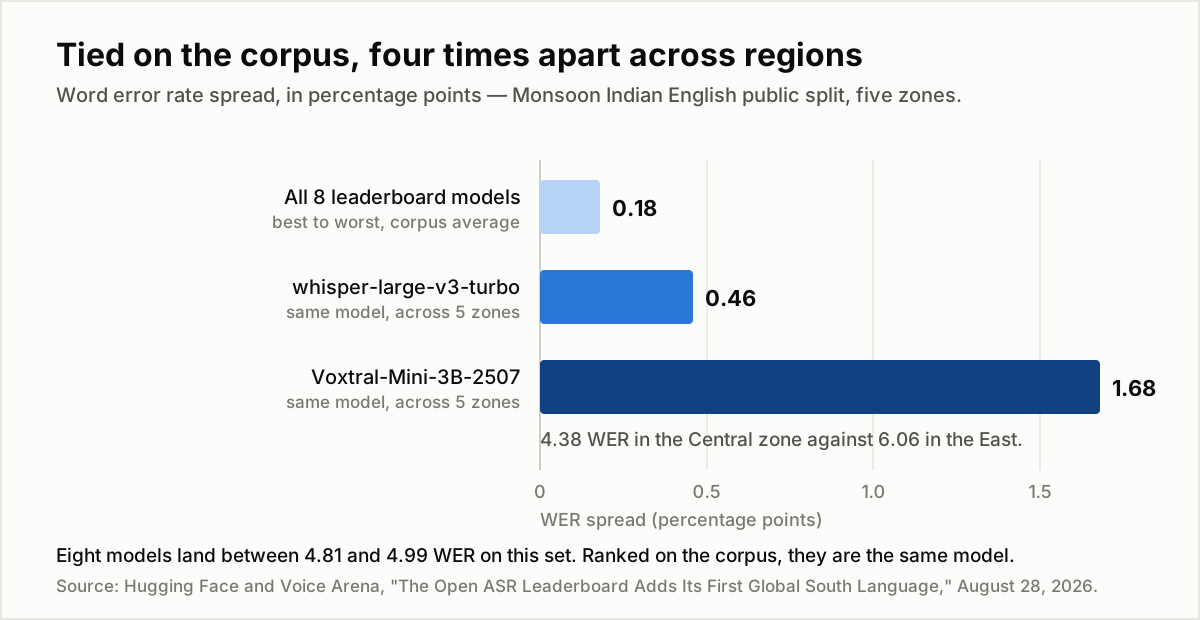
Satu paksi, satu unit: berapa mata WER memisahkan perkara yang dibandingkan. Sumber: Hugging Face dan Voice Arena, 28 Ogos 2026.
Lapan model pada papan pendahulu berada antara 4.81 dan 4.99 WER pada set awam bahasa Inggeris India. Itu 0.18 mata daripada yang terbaik kepada yang paling lemah — dalam lingkungan yang lima jam audio pun tidak mampu bezakan. Disusun mengikut korpus, seperti dinyatakan penerbitan itu, mereka ialah model yang sama.
Kumpulkan penutur mengikut wilayah, dan mereka berhenti menjadi model yang sama. Dengan menaikkan daerah asal setiap penutur ke peringkat majlis zonnya, openai/whisper-large-v3-turbo berubah 0.46 mata merentas lima zon. mistralai/Voxtral-Mini-3B-2507, yang hanya ketinggalan 0.14 mata pada purata korpus, berubah 1.68 mata: 4.38 WER di zon Tengah berbanding 6.06 di Timur. Dua sistem yang tidak dapat dibezakan pada papan pendahulu ternyata berbeza hampir empat kali ganda dari segi sejauh mana ketepatannya bergantung pada tempat penutur itu membesar.
Dan bukan pula satu wilayah itu memang lebih sukar. ibm-granite/granite-speech-3.3-2b paling teruk di Utara, microsoft/VibeVoice-ASR-HF di Selatan, Voxtral di Timur. Jika ada zon yang memang sukar secara semula jadi, semua model akan menyusun zon dengan cara yang sama. Mereka tidak berbuat demikian, dan itu menuding kepada model, bukan kepada audionya.
Bacaan operasi bagi sesiapa yang mengendalikan mesyuarat berbilang bahasa: kualiti transkripsi anda bukan satu angka yang boleh dicari. Ia satu fungsi kepada siapa yang berada dalam bilik itu. Rakan sekerja yang loghatnya paling sedikit disampel oleh vendor anda ialah rakan yang ayat-ayatnya akan keluar salah, dan baik papan pendahulu mahupun halaman vendor tidak akan memberi amaran kepada anda. Satu-satunya pertahanan ialah transkrip yang boleh dibaca dan dibetulkan oleh manusia — dan itu menuntut transkrip itu wujud.
Bahasa Hindi menulis frasa yang sama dalam sepuluh bentuk yang sah. Terjemahan memilih satu.
Penemuan kedua dalam penerbitan yang sama lebih halus dan menyentuh hujah tulisan ini dengan lebih rapat.
Kepelbagaian ortografi bahasa Inggeris ada sempadannya: British lawan Amerika, tanda baca, angka lawan perkataan. Penormal memetakan hampir kesemuanya kepada satu bentuk. Bahasa Hindi tidak bersempadan begitu. Pertuturan harian bercampur baur dengan bahasa Inggeris, perkataan berasal bahasa Inggeris tiada ejaan Devanagari yang mantap, dan kata majmuk ditulis bercantum atau berasingan mengikut citarasa. Satu frasa boleh mempunyai sepuluh bentuk tulisan sah atau lebih, dan tiada pihak kanonik untuk memetakannya.
Justeru set Hindi dibekalkan bersama satu kekisi: bagi setiap petak transkrip, himpunan ejaan yang diterima sebagai betul. Pemarkahannya menggunakan OIWER — kadar ralat perkataan yang mengambil kira ortografi, diperkenalkan oleh AI4Bharat — dan bukan WER biasa. Apabila hipotesis yang sama dimarkahkan semula terhadap versi yang diratakan kepada satu rujukan tunggal, kadar ralat meningkat bagi setiap sistem, meningkat secara tidak sekata, dan pasangan sistem bertukar kedudukan. Di bawah rujukan tunggal, sesebuah model sebahagiannya diganjari kerana menghasilkan semula pilihan ejaan penganotasi; di bawah kekisi, hanya pengecaman yang dimarkahkan.
Berhentilah sebentar pada implikasinya. Walaupun pada tahap «apa yang telah ditulis», selalunya tiada satu rentetan yang betul — yang ada ialah himpunan rentetan yang boleh diterima, dan memilih satu daripadanya bermakna membuang maklumat.
Terjemahan ialah pemampatan yang sama persis, satu tingkat lebih tinggi dan jauh lebih banyak hilangnya. Setiap baris terjemahan ialah keputusan antara pembacaan yang sebenarnya tidak perlu diputuskan oleh sumbernya.
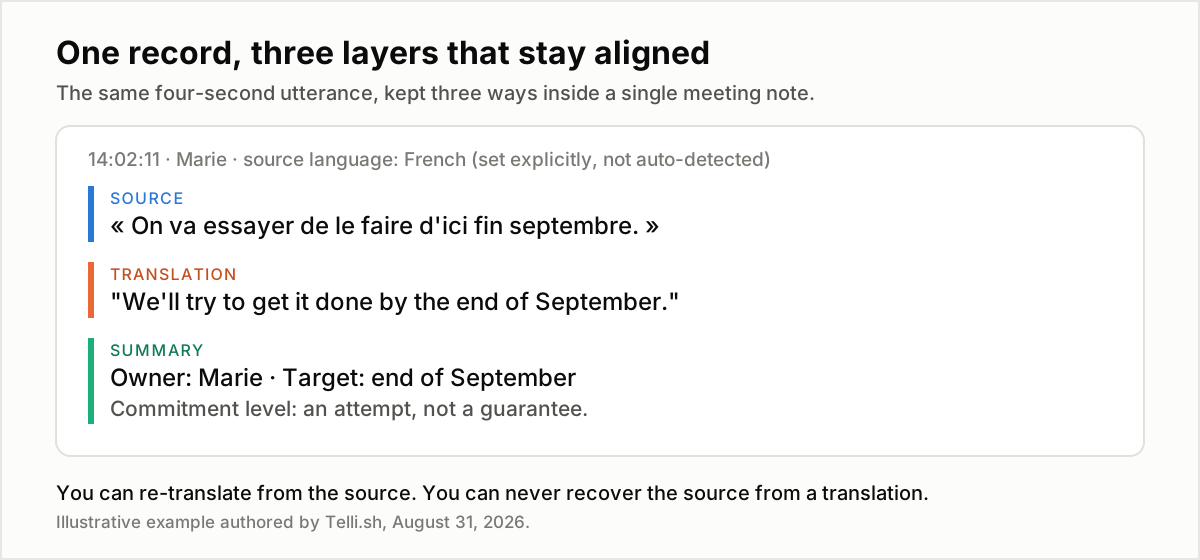
Baris dalam bahasa sumber ialah satu-satunya daripada ketiga-tiganya yang tidak boleh dijana semula daripada yang lain.
Apabila «On va essayer de le faire d'ici fin septembre» menjadi «Kami akan cuba siapkannya menjelang akhir September», ada sesuatu yang nyata telah berubah: essayer dalam bahasa Perancis membawa nada pelembutan tersendiri yang diratakan oleh perkataan «cuba». Adakah itu komitmen atau sekadar niat? Baris terjemahan tidak dapat memberitahu. Baris sumbernya boleh. Enam minggu kemudian, apabila tarikhnya tergelincir dan dua pasukan mengingati ayat itu secara berbeza, baris sumber itulah keseluruhan hujahnya.
Inilah ketaksimetrian di tengah-tengah keseluruhan topik ini. Terjemahan berjalan sehala. Daripada sumber, anda boleh menterjemah semula seberapa kerap yang anda mahu, tahun depan dengan model yang lebih baik. Daripada terjemahan, sumbernya tidak akan pernah dapat anda pulihkan.
Apa yang tinggal selepas panggilan tamat: penterjemah masa nyata berbanding penterjemah mesyuarat bernota
Berikut perbandingannya secara terus terang, merentas tiga cara pasukan mengendalikan mesyuarat berbilang bahasa hari ini.
| Apa yang ada pada pagi esoknya | Lapisan terjemahan masa nyata | Jurubahasa manusia | Penterjemah mesyuarat bernota |
|---|---|---|---|
| Saling faham dalam bilik | Ya | Ya, kualiti tertinggi | Ya |
| Audio mesyuarat | Hanya jika dirakam berasingan | Hanya jika dirakam berasingan | Ya |
| Transkrip dalam bahasa sumber | Tidak | Tidak, melainkan ditranskrip berasingan | Ya |
| Terjemahan yang sejajar dengan sumber | Tidak | Tidak | Ya |
| Siapa menuturkan baris yang mana | Tidak | Tidak | Ya, dengan label penutur |
| Ringkasan dan senarai tindakan | Tidak | Nota jurubahasa, jika ada | Ya, dijana daripada transkrip |
| Boleh dicari tiga bulan kemudian | Tidak | Tidak | Ya |
| Baris yang salah boleh dibetulkan | Tidak | Tidak selepas itu | Ya, dengan menyunting rekod |
| Kos sejam yang lazim | Langganan perisian | AS$100–200 ke atas, dua jurubahasa untuk sesi panjang | Langganan perisian |
Kelakuan lajur yang hilang mengikut FAQ terbitan DeepL Voice for Online Meetings, dicapai pada 31 Ogos 2026; kadar jurubahasa ialah julat pasaran yang lazim diterbitkan bagi pentafsiran persidangan profesional dan berubah mengikut pasangan bahasa serta pasaran. Lajur ketiga menerangkan kategori «penterjemah mesyuarat bernota» secara umum, bukan satu vendor tertentu.
Bentuk jadual itu sendiri ialah hujahnya. Lajur pertama dan lajur ketiga adalah sama pada satu-satunya baris yang biasanya dinilai pembeli — kefahaman secara langsung — dan berbeza pada setiap baris yang barulah penting selepas mesyuarat tamat. Perbandingan antara vendor hampir selalu dijalankan pada baris pertama.
Penterjemah langsung ialah sebuah tingkap. Penterjemah mesyuarat bernota ialah tingkap sekali gus lejar. Pasukan membeli tingkap kerana itulah bahagian yang mereka alami, kemudian menjalankan satu suku tahun penuh di atas lejar yang tidak pernah mereka beli.
Cara mengendalikan mesyuarat berbilang bahasa supaya rekodnya kekal berguna
Enam langkah, mengikut urutan kemunculannya. Tiada satu pun yang aneh; kegagalannya hampir selalu kerana tiada siapa yang membuat keputusan.
- Tetapkan bahasa sumber secara jelas. Jangan bergantung pada pengesanan automatik. Pengesanan automatik terpaksa membuat keputusan dalam beberapa saat pertama, pada audio yang paling kurang konteks sepanjang sesi, dan tekaan yang meleset merosotkan semua peringkat seterusnya sekali gus. Pemilihan yang jelas juga membolehkan enjin menghalakan anda kepada model ekabahasa khusus, yang lazimnya lebih kuat daripada model berbilang bahasa — Nova-3, misalnya, mendokumenkan 58 bahasa satu demi satu, tetapi pertukaran kod hanya pada tepat 10.
- Asingkan bahasa yang akan dituturkan daripada bahasa yang akan dibaca. Ini dua senarai berbeza, dan menganggapnya satu ialah kesilapan konfigurasi paling lazim dalam kategori ini. Pusat bantuan DeepL sendiri mengasingkannya begitu: «bahasa lisan» ialah apa yang diterima oleh pengecam, «bahasa terjemahan» ialah apa yang boleh dipaparkan sebagai sari kata — dan senarai kedua jauh lebih panjang.
- Putuskan sebelum panggilan di mana rekod itu akan berada, dan pastikan ia bukan platform mesyuarat. Jika vendor terjemahan anda memadam data mesyuarat sebaik talian ditamatkan — dan itu kelakuan lalai yang boleh dipertahankan — maka tiada tetapan dalam alat itu yang akan menghasilkan rekod. Penangkapan rekod mesti menjadi pilihan berasingan yang disengajakan.
- Biarkan label penutur dihidupkan. Baris terjemahan tanpa penyandaran tidak berguna bagi apa-apa keputusan yang kelak sepatutnya ia sokong. «Kami akan siapkan menjelang September» hanya menjadi fakta apabila diketahui siapa yang mengatakannya.
- Betulkan nama khas dan istilah bidang dalam lima minit pertama, secara langsung. Nama khas, nama kod produk dan akronim ialah titik di mana transkripsi gagal secara konsisten, sekali gus titik di mana baris yang salah paling merosakkan ringkasan yang dijana kemudian. Membetulkannya ketika mesyuarat sedang berjalan memakan beberapa saat; membetulkannya dalam dokumen yang tiada siapa baca semula tidak memakan kos apa-apa, kerana memang tiada siapa membacanya semula.
- Jana ringkasan daripada transkrip bahasa sumber apabila boleh, bukan daripada terjemahan. Meringkaskan terjemahan bermakna menyusun dua peringkat yang sama-sama kehilangan maklumat. Ini saranan kami, bukan hasil yang diukur, tetapi mekanismenya mudah: setiap peringkat membuang maklumat, dan menyusunnya membuang lebih banyak.
Kemudian simpan ketiga-tiga artifak itu dalam satu rekod. Transkrip dalam satu alat, terjemahan dalam sejarah sembang, dan ringkasan dalam satu dokumen ialah tiga fail yang akan bercanggah antara satu sama lain dalam masa sebulan — dan percanggahan itulah yang sejak awal anda cuba elakkan.
Kesimpulannya: kefahaman ialah masalah lebar jalur, rekod ialah masalah ingatan
Terjemahan mesyuarat masa nyata menyelesaikan masalah lebar jalur: memindahkan makna ke seberang meja cukup pantas sehingga perbualan masih terasa seperti perbualan. Pada 2026, dengan lebih 40 bahasa pada kelewatan satu hingga dua ayat dan 96% keutamaan dalam ujian buta, masalah itu pada dasarnya sudah selesai dan semakin murah setiap suku tahun.
Transkripsi berbilang bahasa menyelesaikan masalah ingatan, dan tiada apa-apa dalam penyelesaian lebar jalur yang menyentuhnya. Artifak berbeza, dasar penyimpanan berbeza, mod kegagalan berbeza. Pasukan yang membeli yang pertama sahaja lalu menyangka sudah mendapat yang kedua akan terus mengadakan mesyuarat cemerlang yang tidak dapat mereka pertanggungjawabkan.
Maka soalan yang berbaloi dibawa ke pertemuan seterusnya dengan vendor bukanlah «berapa banyak bahasa yang boleh diterjemah». Setiap vendor yang serius kini menjawabnya dengan angka melebihi 40. Soalannya ialah: apabila panggilan tamat, apa yang masih wujud — dan dalam bahasa siapa?
Di mana Telli.sh berada: semua yang di atas adalah tentang lapisan di bawah terjemahan langsung, dan itulah lapisan yang kami bina. Telli.sh menjalankan transkripsi langsung dengan terjemahan ke dalam 44 bahasa sasaran, dengan antara muka yang tersedia dalam 15 bahasa, jadi peserta di Warsaw membaca standup berbahasa Korea dalam bahasa Poland ketika ia sedang berlangsung. Yang penting pada pagi esoknya ialah ketiga-tiga artifak kekal dalam satu nota: teks bahasa sumber bagi apa yang benar-benar dituturkan, terjemahan yang sejajar dengannya, dan ringkasan yang dijana di atasnya. Boleh disemak, boleh dibetulkan dan boleh dicari lama selepas panggilan itu tamat.
Mulakan nota mesyuarat dengan terjemahan langsung
Sumber
- Hugging Face dan Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 Ogos 2026 — set Monsoon en-IN dan hi-IN, 4,888 penutur, varians WER mengikut zon, OIWER dan kekisi bahasa Hindi.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Cologne, 16 April 2026 — lebih 40 bahasa, empat permukaan produk, dan penilaian buta Slator yang ditempah DeepL.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 April 2026 — kelewatan demo Seoul dan kekangan susunan kata.
- DeepL, halaman produk dan FAQ DeepL Voice for Online Meetings, dicapai pada 31 Ogos 2026 — rumusan tentang penyimpanan data, skor Slator, dan nota bahawa suara-ke-suara untuk mesyuarat dalam talian masih dilancarkan berperingkat.
- Pusat Bantuan DeepL, DeepL Voice languages, dicapai pada 31 Ogos 2026 — pengasingan antara bahasa lisan dan bahasa terjemahan.
- AI4Bharat, Orthographically-Informed Word Error Rate — metrik yang digunakan bagi set bahasa Hindi.
- Liputan bahasa Nova-3 daripada Deepgram sebagaimana dihimpun dalam tulisan kami sendiri, analisis pengembangan bahasa dalam pengecaman pertuturan, 31 Ogos 2026.