40+ bahasa diterjemahkan langsung, lalu dihapus saat sambungan ditutup: transkripsi multibahasa adalah lapisan yang menyimpan rapatnya
DeepL meluncurkan Voice-to-Voice pada 16 April 2026 untuk lebih dari 40 bahasa, dan FAQ produk yang sama menyebut data rapat «diproses sementara di memori dan dihapus begitu panggilan berakhir». Pada 28 Agustus, Open ASR Leaderboard menambahkan bahasa Global South pertamanya dan menunjukkan bahwa dua model yang seimbang di angka 4,9 WER berbeda hampir empat kali lipat dalam hal seberapa besar akurasinya bergantung pada asal daerah penuturnya. Terjemahan rapat real-time sedang menjadi komoditas. Rekamannya belum.
Pada 16 April 2026, DeepL meluncurkan Voice-to-Voice dari Köln: rangkaian produk penerjemahan suara real-time yang mencakup empat permukaan — rapat virtual, percakapan di ponsel dan web, situasi kelompok untuk pekerja lapangan, serta API untuk perusahaan. Produk ini menangani lebih dari 40 bahasa, termasuk seluruh 24 bahasa resmi Uni Eropa ditambah bahasa Vietnam, Thailand, Arab, Norwegia, Ibrani, Bengali, dan Tagalog. Dalam evaluasi buta yang dijalankan Slator atas pesanan DeepL, 96% linguis memilihnya dibanding terjemahan bawaan Google, Microsoft, dan Zoom; DeepL Voice untuk Zoom meraih 96,4 dari 100 berbanding 87–89 untuk platform pesaing.
Ini produk yang digarap serius, dan bagian menariknya bukan peluncurannya. Bagian menariknya adalah satu kalimat di FAQ pada halaman produk yang sama, yang kami baca ulang pada 31 Agustus 2026:
«DeepL tidak menyimpan data transkripsi atau terjemahan secara permanen. Data rapat diproses sementara di memori dan dihapus begitu panggilan berakhir.»
Bacalah dua fakta itu berdampingan. Terjemahannya luar biasa, dan terjemahan itu sudah lenyap sebelum makan malam.
Ringkasnya
- Pada 2026, terjemahan rapat real-time berpindah dari kategori masalah sulit ke kategori komoditas yang sudah dikirim: lebih dari 40 bahasa di DeepL, 58 bahasa tunggal di Nova-3 milik Deepgram, terjemahan langsung di dalam Google Meet.
- Tidak menyisakan apa pun biasanya merupakan keputusan privasi yang disengaja, bukan cacat — tetapi artinya rapat itu sendiri tidak meninggalkan artefak apa pun yang bisa ditinjau.
- Transkripsi multibahasa adalah lapisan tersendiri di bawahnya. Lapisan itu menjaga transkrip dalam bahasa sumber, terjemahan, penanda pembicara, dan ringkasan tetap berada dalam satu catatan yang bisa ditinjau. Tulisan ini membahas mengapa justru bahasa sumber yang harus bertahan, dan bagaimana menjalankan rapat agar ia bertahan.
Versi argumen ini yang berfokus pada Google kami tulis Juni lalu, ketika Meet dan Translate mendorong terjemahan suara langsung ke pasar luas: mengapa rapat multibahasa tetap butuh catatan yang bisa ditinjau. Sejak itu pasar menjawab pertanyaan yang saat itu hanya kami ajukan. Terjemahan langsung kini benar-benar berfungsi. Maka pertanyaan menariknya bergeser: hari Senin, apa yang tersisa di tangan Anda?
Terjemahan rapat real-time bukan lagi bagian yang sulit
Selama sekitar satu dekade, ucapan multibahasa secara langsung adalah demo yang tak pernah selamat begitu bertemu rapat sungguhan. Latensi memakan giliran bicara, aksen merontokkan pengenal suara, dan apa pun yang sedikit teknis keluar berantakan. Era itu berakhir dalam kira-kira sepuluh bulan.
Nova-3 dari Deepgram mencantumkan 31 bahasa dalam catatan rilis 10 Desember 2025 dan 58 dalam dokumentasi Agustus 2026: 39 penambahan terdokumentasi dalam kurang dari sembilan bulan, kira-kira satu bahasa baru setiap tujuh hari. Kami menelusuri ekspansi itu, berikut cetakan halus di bawahnya, dalam apa yang sebenarnya disembunyikan kata «didukung» dalam cakupan bahasa pengenalan ucapan. Google memasukkan terjemahan suara langsung ke Meet. DeepL mengirimkan rangkaian produk suara berpermukaan empat pada April.
Klaim kualitasnya pun kini cukup spesifik untuk diperdebatkan, dan itu sendiri tanda kematangan. Penilaian Slator yang dipesan DeepL melaporkan tingkat kesalahan 4% untuk DeepL Voice berbanding rata-rata 17% pada platform rapat pesaing, serta 96,4/100 di Zoom dan 96,3/100 di Teams. Angka pesanan vendor diperlakukan sebagai angka pesanan vendor. Namun arahnya tidak diperdebatkan, dan liputan yang jujur menunjuk ke arah yang sama: The Next Web, dalam artikel 17 April 2026, menggambarkan demo langsung di Seoul yang berjalan dengan jeda satu sampai dua kalimat, dan mencatat pengakuan chief product officer DeepL bahwa perbedaan urutan kata antarbahasa tetap menjadi kendala mendasar bagi kecepatan yang bisa dicapai terjemahan suara-ke-suara.
Jeda satu sampai dua kalimat itu cukup. Tidak cukup untuk menggantikan juru bahasa profesional dalam negosiasi perjanjian, dan tak seorang pun mengklaim demikian. Tetapi lebih dari cukup untuk sinkronisasi produk hari Selasa antara Warsawa, Seoul, dan São Paulo — yaitu rapat yang benar-benar kita jalani sehari-hari.
Intinya begini: ketika sebuah kemampuan menjadi sebaik itu secepat itu, sumbatannya berpindah. Ia sudah berpindah. Kini ia berada satu lapis di bawah, pada apa yang ditinggalkan rapat itu.
Berdasarkan rancangannya, terjemahan tidak hidup lebih lama dari panggilannya
Kembali ke kalimat FAQ tadi, sebab itu bukan kecerobohan. Itu sikap keamanan, dan sikap yang baik. Rumusan DeepL sendiri berlanjut: semua data dienkripsi saat transit, tidak pernah dipakai melatih model, dan «hanya bertahan di perangkat lokal peserta rapat». Ketika bank atau rumah sakit membeli perkakas rapat, jawaban «kami tidak menyimpan apa pun» adalah jawaban yang paling cepat lolos tinjauan hukum.
Sikap yang sama lazim di seluruh kategori teks langsung, karena menyimpan audio rapat multibahasa persis merupakan jenis tanggung jawab yang tak ingin diwarisi siapa pun. Maka nilai bawaan industri menjadi: pemahaman yang sangat baik saat itu juga, dan tidak ada artefak sesudahnya.
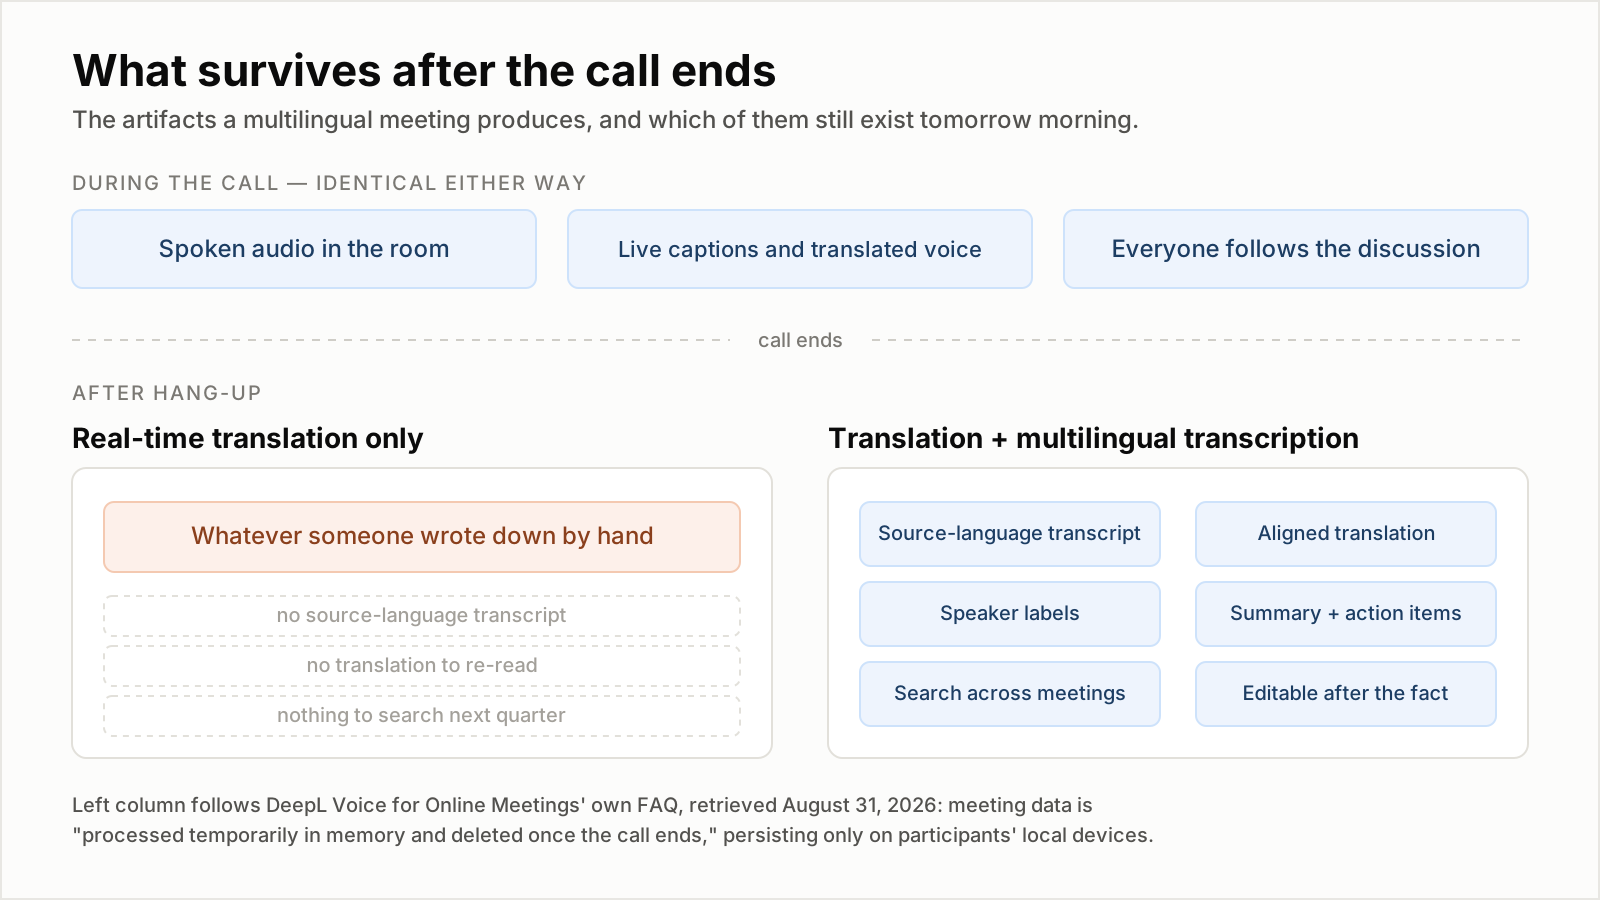
Selama panggilan berlangsung, kedua pendekatan tak bisa dibedakan. Perbedaannya sepenuhnya berada di sisi lain dari tombol tutup. Kolom kiri mengikuti FAQ DeepL Voice for Online Meetings sendiri, diakses 31 Agustus 2026.
Mode kegagalan yang dihasilkan struktur ini punya bentuk, dan ia butuh nama. Sebut saja pergeseran keputusan: semua orang memahami rapat itu dengan sempurna, lalu tiga minggu kemudian tak ada yang bisa membuktikan apa yang disepakati. Ini bukan salah paham — terjemahan langsung sudah menjalankan tugasnya. Persoalannya, satu-satunya salinan tersisa dari keputusan yang diambil dalam dua bahasa itu hidup di lima ingatan, dalam lima rumusan berbeda, setidaknya dalam dua bahasa, dan ingatan itu merekonstruksi, bukan memutar ulang.
Pergeseran keputusan itu mahal dengan cara yang tak pernah muncul di tagihan perkakasnya. Ia muncul sebagai fitur yang dibangun ulang, tenggat yang dinegosiasikan lagi, pertanyaan kepatuhan yang tak bisa dijawab siapa pun, karyawan baru yang tak punya cara mengetahui apa yang diputuskan tim kuartal lalu.
28 Agustus: tolok ukur yang menjelaskan mengapa Anda butuh bahasa sumber
Andai transkripsi adalah komoditas yang sudah beres dan seragam, menyimpan rekaman hanyalah soal ruang penyimpanan dan tulisan ini akan pendek. Kenyataannya tidak, dan bukti terbaru yang paling jelas mendarat tiga hari lalu.
Pada 28 Agustus 2026, Hugging Face dan Voice Arena menambahkan bahasa Global South pertama ke Open ASR Leaderboard: bahasa Hindi, dituturkan lebih dari setengah miliar orang, masuk ke tab multibahasa yang sampai saat itu hanya memuat bahasa-bahasa Eropa. Mereka menyumbang empat set evaluasi — Monsoon en-IN dan hi-IN, versi publik dan privat — dengan 4.888 penutur yang tidak saling tumpang tindih, 12 atribut tercatat per penutur, dikumpulkan di 428 distrik dan pada ratusan model ponsel nyata, bukan di studio.
Lalu mereka menjalankan model-model yang sudah ada di papan peringkat itu di atasnya. Hasilnya adalah hal paling berguna yang terbit bulan ini tentang pengenalan ucapan.
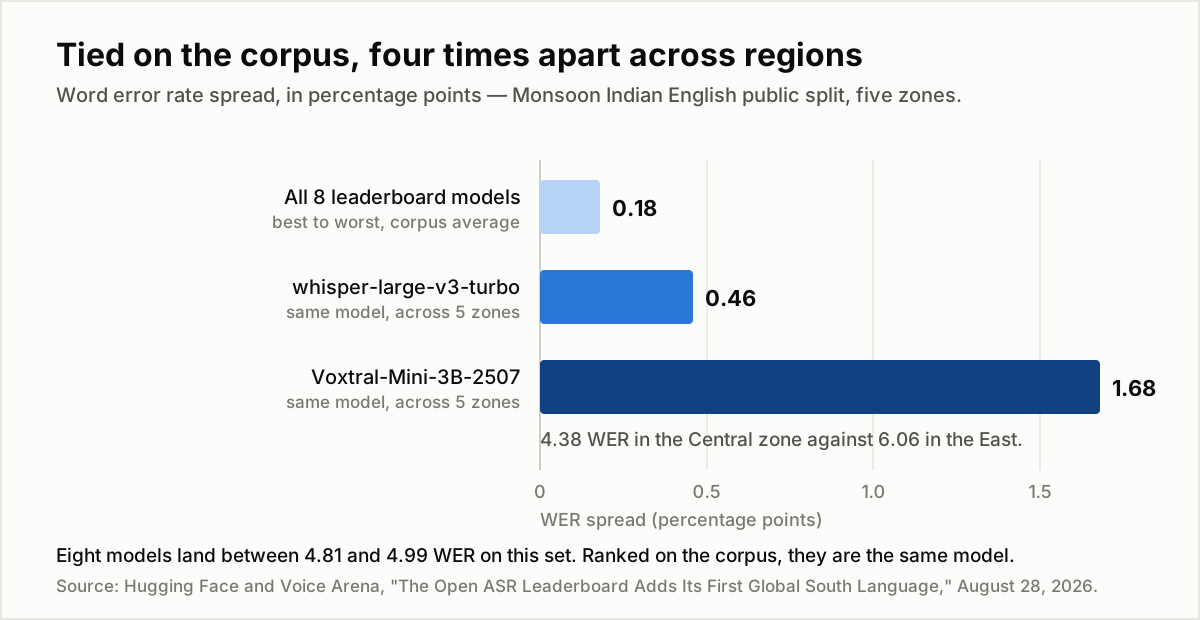
Satu sumbu, satu satuan: berapa poin WER yang memisahkan hal-hal yang dibandingkan. Sumber: Hugging Face dan Voice Arena, 28 Agustus 2026.
Delapan model di papan peringkat berada antara 4,81 dan 4,99 WER pada set publik bahasa Inggris India. Itu 0,18 poin dari terbaik ke terburuk — masih di dalam rentang yang bahkan tak bisa dipisahkan oleh lima jam audio. Diperingkat berdasarkan korpus, seperti disebut publikasinya, mereka adalah model yang sama.
Kelompokkan penuturnya menurut wilayah, dan mereka berhenti menjadi model yang sama. Dengan menaikkan distrik asal setiap penutur ke tingkat dewan zonanya, openai/whisper-large-v3-turbo bervariasi 0,46 poin di lima zona. mistralai/Voxtral-Mini-3B-2507, yang hanya tertinggal 0,14 poin pada rata-rata korpus, bervariasi 1,68 poin: 4,38 WER di zona Tengah berbanding 6,06 di Timur. Dua sistem yang tak terbedakan di papan peringkat ternyata berbeda hampir empat kali lipat dalam hal seberapa besar akurasinya bergantung pada tempat penuturnya tumbuh besar.
Dan bukan berarti satu wilayah memang lebih sulit. ibm-granite/granite-speech-3.3-2b paling buruk di Utara, microsoft/VibeVoice-ASR-HF di Selatan, Voxtral di Timur. Kalau ada zona yang sulit secara hakiki, semua model akan mengurutkan zona dengan cara yang sama. Mereka tidak, dan itu menunjuk ke modelnya, bukan ke audionya.
Pembacaan operasionalnya bagi siapa pun yang memimpin rapat multibahasa: kualitas transkripsi Anda bukan satu angka yang bisa dicari. Ia adalah fungsi dari siapa yang ada di ruangan. Rekan kerja yang aksennya paling sedikit disampel oleh vendor Anda adalah rekan yang kalimatnya akan keluar salah, dan baik papan peringkat maupun halaman vendor tidak akan memperingatkan Anda. Satu-satunya pertahanan adalah transkrip yang bisa dibaca dan diperbaiki manusia — dan itu mensyaratkan transkripnya ada.
Bahasa Hindi menuliskan frasa yang sama dalam sepuluh bentuk yang sah. Terjemahan memilih satu.
Temuan kedua dalam publikasi yang sama lebih halus dan menyentuh argumen tulisan ini lebih dekat.
Variasi ortografi bahasa Inggris punya batas: Britania lawan Amerika, tanda baca, angka lawan kata. Penormal memetakan hampir semuanya ke satu bentuk. Bahasa Hindi tidak berbatas seperti itu. Tuturan sehari-hari sangat bercampur bahasa Inggris, kata berasal Inggris tidak punya ejaan Devanagari yang mapan, dan bentuk majemuk ditulis serangkai atau terpisah menurut selera. Satu frasa bisa punya sepuluh bentuk tulisan sah atau lebih, dan tidak ada sisi kanonis untuk memetakannya.
Karena itu set Hindi disertai kisi: untuk tiap rentang transkrip, himpunan ejaan yang diterima sebagai benar. Penilaiannya memakai OIWER — tingkat kesalahan kata yang memperhitungkan ortografi, diperkenalkan AI4Bharat — bukan WER biasa. Ketika hipotesis yang sama dinilai ulang terhadap versi yang diratakan menjadi rujukan tunggal, tingkat kesalahan naik pada semua sistem, naik secara tidak merata, dan pasangan sistem bertukar peringkat. Di bawah rujukan tunggal, sebuah model sebagian diganjar karena mereproduksi pilihan ejaan si anotator; di bawah kisi, yang dinilai hanya pengenalannya.
Diamlah sejenak pada implikasinya. Bahkan pada tataran «apa yang tertulis» pun sering tidak ada satu untai teks yang benar — yang ada adalah himpunan untai yang bisa diterima, dan memilih satu berarti membuang informasi.
Terjemahan adalah pengerutan yang persis sama, satu tingkat di atasnya dan jauh lebih banyak hilangnya. Setiap baris terjemahan adalah keputusan di antara pembacaan yang sebenarnya tak perlu diputuskan oleh sumbernya.
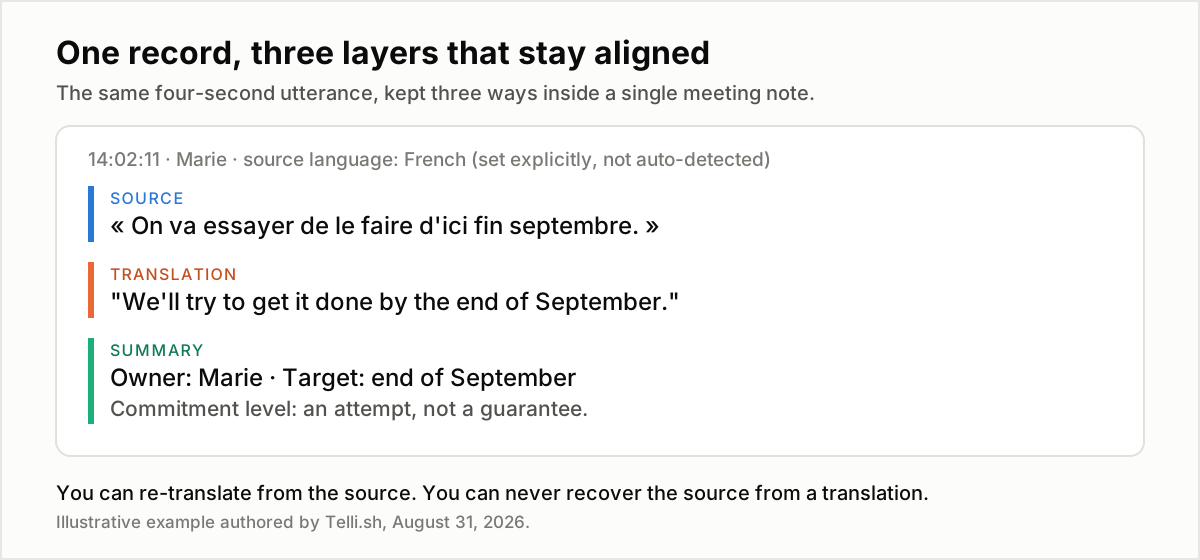
Baris dalam bahasa sumber adalah satu-satunya dari ketiganya yang tak bisa dibangkitkan ulang dari yang lain.
Ketika «On va essayer de le faire d'ici fin septembre» menjadi «Kami akan berusaha menyelesaikannya sebelum akhir September», ada sesuatu yang nyata berubah: essayer dalam bahasa Prancis membawa nuansa pelunakan khas yang diratakan oleh kata «berusaha». Apakah itu komitmen atau sekadar niat? Baris terjemahannya tidak bisa menjawab. Baris sumbernya bisa. Enam minggu kemudian, saat tanggalnya meleset dan dua tim mengingat kalimat itu secara berbeda, baris sumber itulah seluruh argumennya.
Inilah asimetri di pusat seluruh topik ini. Terjemahan berjalan satu arah. Dari sumber Anda bisa menerjemahkan ulang sesering yang Anda mau, tahun depan dengan model yang lebih baik. Dari terjemahan, sumbernya tak akan pernah bisa Anda pulihkan.
Apa yang tersisa setelah panggilan berakhir: penerjemah real-time versus penerjemah rapat dengan catatan
Berikut perbandingannya secara terus terang, di antara tiga cara tim menangani rapat multibahasa saat ini.
| Yang Anda punya keesokan paginya | Lapisan terjemahan real-time | Juru bahasa manusia | Penerjemah rapat dengan catatan |
|---|---|---|---|
| Saling paham di ruangan | Ya | Ya, kualitas tertinggi | Ya |
| Audio rapat | Hanya jika direkam terpisah | Hanya jika direkam terpisah | Ya |
| Transkrip dalam bahasa sumber | Tidak | Tidak, kecuali ditranskrip terpisah | Ya |
| Terjemahan yang sejajar dengan sumber | Tidak | Tidak | Ya |
| Siapa mengucapkan baris yang mana | Tidak | Tidak | Ya, dengan penanda pembicara |
| Ringkasan dan daftar tindakan | Tidak | Catatan juru bahasa, kalau ada | Ya, dibuat dari transkrip |
| Bisa dicari tiga bulan kemudian | Tidak | Tidak | Ya |
| Baris keliru bisa diperbaiki | Tidak | Setelahnya tidak bisa | Ya, dengan menyunting catatannya |
| Biaya per jam pada umumnya | Langganan perangkat lunak | US$100–200 ke atas, dua juru bahasa untuk sesi panjang | Langganan perangkat lunak |
Perilaku kolom yang menghilang mengikuti FAQ terbitan DeepL Voice for Online Meetings, diakses 31 Agustus 2026; tarif juru bahasa adalah rentang pasar yang lazim dipublikasikan untuk juru bahasa konferensi profesional dan berubah menurut pasangan bahasa serta pasar. Kolom ketiga menggambarkan kategori «penerjemah rapat dengan catatan» secara umum, bukan satu vendor tertentu.
Bentuk tabel itu sendirilah argumennya. Kolom satu dan kolom tiga identik pada satu-satunya baris yang biasanya dinilai pembeli — saling paham secara langsung — dan berbeda pada setiap baris yang baru penting setelah rapat usai. Perbandingan antarvendor hampir selalu dijalankan di baris pertama.
Penerjemah langsung adalah jendela. Penerjemah rapat dengan catatan adalah jendela sekaligus buku besar. Tim membeli jendela karena itulah bagian yang mereka alami, lalu menjalankan satu kuartal penuh di atas buku besar yang tak pernah mereka beli.
Cara menjalankan rapat multibahasa agar rekamannya tetap berguna
Enam langkah, dalam urutan kemunculannya. Tak satu pun eksotis; kegagalannya hampir selalu karena tidak ada yang memutuskan.
- Tetapkan bahasa sumber secara eksplisit. Jangan bersandar pada deteksi otomatis. Deteksi otomatis harus memutuskan pada detik-detik pertama, pada audio paling minim konteks di seluruh sesi, dan tebakan yang meleset menurunkan semua tahap berikutnya sekaligus. Pemilihan eksplisit juga memungkinkan mesin mengarahkan Anda ke model ekabahasa khusus, yang umumnya lebih kuat daripada model multibahasa — Nova-3, misalnya, mendokumentasikan 58 bahasa satu per satu, tetapi alih kode hanya pada tepat 10.
- Pisahkan bahasa yang akan diucapkan dari bahasa yang akan dibaca. Ini dua daftar berbeda, dan memperlakukannya sebagai satu adalah kesalahan konfigurasi paling umum di kategori ini. Pusat bantuan DeepL memisahkannya persis begitu: «bahasa lisan» adalah yang diterima pengenal suara, «bahasa terjemahan» adalah yang bisa ditampilkan sebagai teks — dan daftar kedua jauh lebih panjang.
- Putuskan sebelum panggilan di mana rekamannya akan tinggal, dan pastikan itu bukan platform rapatnya. Kalau vendor terjemahan Anda menghapus data rapat saat sambungan ditutup — dan itu perilaku bawaan yang bisa dipertahankan — maka tidak ada pengaturan apa pun di dalam perkakas itu yang akan menghasilkan rekaman. Perekaman harus menjadi pilihan tersendiri yang disengaja.
- Biarkan penanda pembicara tetap menyala. Baris terjemahan tanpa atribusi tak berguna bagi keputusan apa pun yang kelak harus ia sokong. «Kami selesaikan sebelum September» baru menjadi fakta setelah diketahui siapa yang mengatakannya.
- Perbaiki nama diri dan istilah bidang dalam lima menit pertama, secara langsung. Nama diri, nama sandi produk, dan akronim adalah titik di mana transkripsi gagal secara andal, sekaligus titik di mana baris yang keliru paling merusak ringkasan yang dibuat kemudian. Memperbaikinya saat rapat berjalan memakan hitungan detik; memperbaikinya di dokumen yang tak pernah dibaca ulang tidak memakan biaya apa pun, karena memang tak ada yang membacanya lagi.
- Buat ringkasan dari transkrip bahasa sumber bila memungkinkan, bukan dari terjemahannya. Meringkas terjemahan berarti menumpuk dua tahap yang sama-sama kehilangan informasi. Ini rekomendasi kami, bukan hasil pengukuran, tetapi mekanismenya lugas: setiap tahap membuang informasi, dan menumpuknya membuang lebih banyak.
Lalu simpan ketiga artefak itu dalam satu catatan. Transkrip di satu perkakas, terjemahan di riwayat obrolan, dan ringkasan di dokumen adalah tiga berkas yang akan saling bertentangan dalam sebulan — dan pertentangan itulah yang sejak awal ingin Anda cegah.
Pada akhirnya: pemahaman adalah soal lebar pita, rekaman adalah soal ingatan
Terjemahan rapat real-time memecahkan soal lebar pita: memindahkan makna ke seberang meja cukup cepat sehingga percakapan tetap terasa seperti percakapan. Pada 2026, dengan lebih dari 40 bahasa pada jeda satu sampai dua kalimat dan 96% preferensi dalam uji buta, soal itu pada dasarnya sudah terpecahkan dan makin murah tiap kuartal.
Transkripsi multibahasa memecahkan soal ingatan, dan tidak ada bagian dari solusi lebar pita yang menyentuhnya. Artefaknya berbeda, kebijakan penyimpanannya berbeda, mode kegagalannya berbeda. Tim yang hanya membeli yang pertama lalu mengira sudah mendapat yang kedua akan terus punya rapat-rapat hebat yang tak bisa mereka pertanggungjawabkan.
Maka pertanyaan yang layak dibawa ke pertemuan berikutnya dengan vendor bukan «berapa bahasa yang bisa diterjemahkan». Semua vendor serius kini menjawabnya dengan angka di atas 40. Pertanyaannya adalah: ketika panggilan berakhir, apa yang masih ada — dan dalam bahasa siapa?
Di mana Telli.sh berada: semua di atas adalah soal lapisan di bawah terjemahan langsung, dan lapisan itulah yang kami bangun. Telli.sh menjalankan transkripsi langsung dengan terjemahan ke 44 bahasa tujuan, dengan antarmuka yang tersedia dalam 15 bahasa, sehingga peserta di Warsawa membaca standup berbahasa Korea dalam bahasa Polandia selagi rapat berlangsung. Yang penting keesokan paginya: ketiga artefak tetap berada dalam satu catatan — teks bahasa sumber dari apa yang benar-benar diucapkan, terjemahan yang sejajar dengannya, dan ringkasan yang dibuat di atasnya. Bisa ditinjau, bisa diperbaiki, dan bisa dicari lama setelah panggilannya usai.
Mulai catatan rapat dengan terjemahan langsung
Sumber
- Hugging Face dan Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 Agustus 2026 — set Monsoon en-IN dan hi-IN, 4.888 penutur, variasi WER antarzona, OIWER dan kisi bahasa Hindi.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Köln, 16 April 2026 — lebih dari 40 bahasa, empat permukaan produk, dan evaluasi buta Slator yang dipesan DeepL.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 April 2026 — latensi demo Seoul dan kendala urutan kata.
- DeepL, halaman produk dan FAQ DeepL Voice for Online Meetings, diakses 31 Agustus 2026 — rumusan tentang penyimpanan data, skor Slator, dan catatan bahwa suara-ke-suara untuk rapat daring masih bertahap diluncurkan.
- Pusat Bantuan DeepL, DeepL Voice languages, diakses 31 Agustus 2026 — pemisahan antara bahasa lisan dan bahasa terjemahan.
- AI4Bharat, Orthographically-Informed Word Error Rate — metrik yang dipakai untuk set bahasa Hindi.
- Cakupan bahasa Nova-3 dari Deepgram sebagaimana dirangkum dalam tulisan kami sendiri, analisis ekspansi bahasa pada pengenalan ucapan, 31 Agustus 2026.