Bốn mô hình tiên phong trong ba ngày, và không ai nói cho bạn biết bạn cần mô hình nào
Từ ngày 1 đến ngày 3 tháng 9 năm 2026, Anthropic, Meta, Google và OpenAI đều tung ra mô hình tiên phong, và CNBC đặt tên cho sự kiệt sức phát sinh từ đó: mệt mỏi vì mô hình. Số lượng bản phát hành là phần nhàm chán. Phần thú vị là mỗi bản phát hành đều tạo ra một cuộc đánh giá mà ai đó ở phía dưới phải chạy, còn các công ty tung ra chúng thì chẳng có lý do gì để giúp bạn bỏ qua nó. Bài viết mổ xẻ chi phí thật của việc đổi mô hình, vì sao rẻ hơn trên mỗi token không có nghĩa là rẻ hơn trên mỗi tác vụ, và vì sao phần mềm được quản lý trọn gói, xây riêng cho một công việc hẹp, là dàn xếp duy nhất mà người khác có thể quyết định thay bạn.
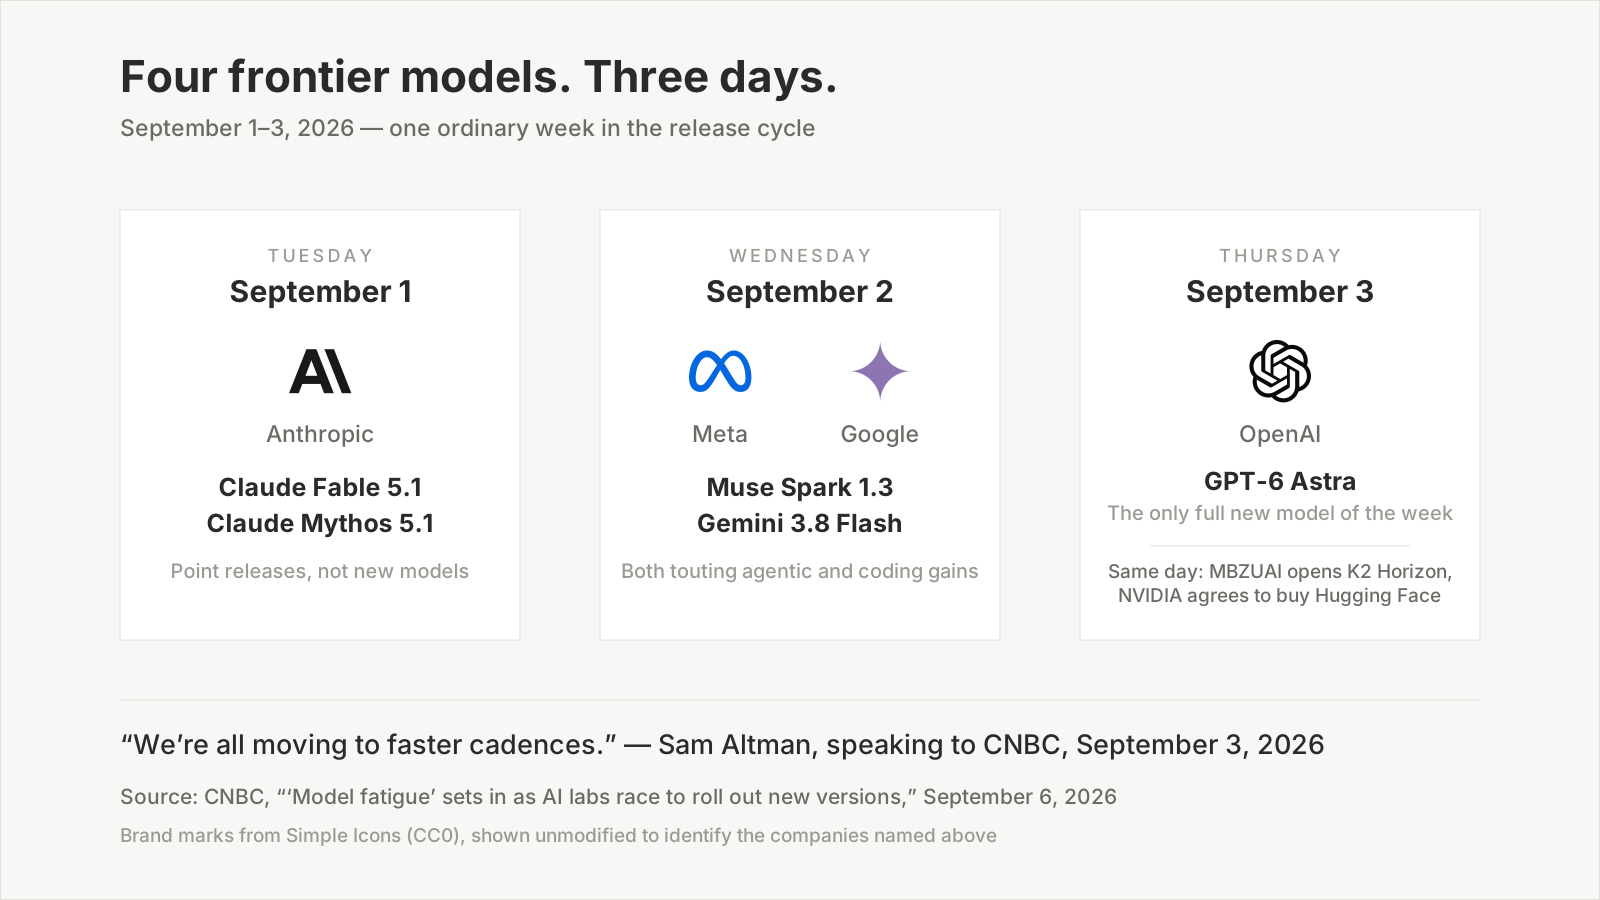
Logo thương hiệu lấy từ Simple Icons (CC0), hiển thị nguyên trạng để nhận diện các công ty được nhắc tên. Ngày phát hành và câu trích của Altman theo CNBC, ngày 6 tháng 9 năm 2026.
Từ thứ Ba đến thứ Năm của tuần đầu tháng 9 năm 2026, Anthropic tung ra Claude Fable 5.1 và Claude Mythos 5.1, Meta tung ra Muse Spark 1.3, Google tung ra Gemini 3.8 Flash, còn OpenAI tung ra GPT-6 Astra. Cũng trong ngày thứ Năm đó, Đại học Trí tuệ Nhân tạo Mohamed bin Zayed ở Abu Dhabi mở dòng K2 Horizon cho toàn thế giới, và NVIDIA đồng ý mua lại Hugging Face với giá 12.930.300.000 USD.
Sáu thông báo. Ba ngày. CNBC đăng bài vào Chủ nhật, ngày 6 tháng 9, dưới một cụm từ đã lan truyền nhiều tuần trong giới làm nghề: mệt mỏi vì mô hình.
Cách đọc hiển nhiên là ngành này đang chạy nhanh hơn mức bất kỳ ai theo kịp. Cách đọc đó đúng, và phần lớn là nhạt. Đây mới là phần đáng để bạn chú ý: mỗi bản phát hành đều chuyển một khoản chi phí, và việc chuyển ấy chỉ chạy theo đúng một chiều. Mỗi mô hình mà một phòng thí nghiệm tung ra đều trở thành một cuộc đánh giá mà ai đó ở phía dưới phải chạy — và không ai ở phía trên có bất kỳ lý do nào để giúp bạn bỏ qua nó.
TL;DR
- Bốn bản phát hành tiên phong đổ bộ trong ba ngày (1–3 tháng 9 năm 2026); ngày 6 tháng 9, CNBC gọi tên sự kiệt sức phát sinh là "mệt mỏi vì mô hình".
- Chi phí thật không phải là sự chú ý, mà là công sức đánh giá. Một CEO doanh nghiệp nói với CNBC rằng khi nhóm của ông muốn đánh giá 10 mô hình cho một tác vụ, họ thử khoảng 5.
- Giá trên mỗi token là thước đo thay thế tồi cho chi phí trên mỗi tác vụ — một mô hình mạnh hơn, đắt hơn có thể hoàn thành phần việc khó hơn với giá thấp hơn vì đi ít bước hơn.
- Về mặt cấu trúc, các nhà cung cấp mô hình không có hứng thú nói cho bạn biết khi nào một mô hình rẻ hơn là đủ. Chính khoảng trống đó là toàn bộ lý do tồn tại của phần mềm được quản lý và xây riêng cho một mục đích.
Mệt mỏi vì mô hình có tên gọi vào ngày 6 tháng 9
"Tôi thấy mệt mỏi vì mô hình là chuyện có thật", Zhen Lu, CEO của Runpod, một startup hạ tầng AI, nói với CNBC. "Đừng hiểu lầm tôi, tôi cực kỳ hào hứng với tất cả những đổi mới đang diễn ra, nhưng tôi thực sự nghĩ chúng ta đang ở trong một môi trường nhiều bọt đến mức bạn buộc phải tạo tiếng ồn."
Cùng tuần đó, Sam Altman đưa ra với CNBC một cách diễn giải nhẹ nhàng hơn: "tất cả chúng ta đều đang chuyển sang nhịp phát hành nhanh hơn", ông nói, và quy một phần sự tăng tốc cho việc mọi người "vừa đi nghỉ hè về".
Cả hai điều đều có thể đúng. Nhịp độ đang thực sự tăng tốc, và sự tăng tốc ấy thực sự có phần là diễn. Ahmed Abbasi, giáo sư tại Mendoza School of Business thuộc Notre Dame với 25 năm trong ngành AI, nói thẳng ra logic thương mại: các phòng thí nghiệm "đều đang chơi trò giành phần trong hầu bao". Anthropic và OpenAI đẩy mạnh nhất khi tiến về phía thị trường đại chúng, và nhà đầu tư tư nhân đã định giá mỗi bên gần 1 nghìn tỷ USD.
Cái hầu bao đó khổng lồ. Tháng 5 năm 2026, Gartner dự báo chi tiêu AI toàn cầu sẽ đạt 2,59 nghìn tỷ USD trong năm nay, tăng 47% so với năm 2025. Hạ tầng chiếm phần lớn nhất, nhưng hơn 1 nghìn tỷ USD trong số đó rơi vào dịch vụ, phần mềm, bảo mật, mô hình và công cụ — tức là rơi vào những quyết định mà ai đó phải đưa ra.
Điểm mấu chốt là đây: một thị trường lớn đến vậy, tăng trưởng nhanh đến vậy, sẽ tưởng thưởng cho tiếng ồn. Nó không tưởng thưởng cho việc nói với khách hàng rằng họ dùng ít hơn cũng được.
Chi phí không phải sự chú ý. Đó là cuộc đánh giá bạn không chạy hết nổi
Hỏi một người làm nghề xem mệt mỏi vì mô hình thực sự cảm thấy ra sao, bạn sẽ không nghe "tôi đọc quá nhiều bài giới thiệu". Bạn sẽ nghe một phép tính.
Suresh Vasudevan, CEO của Clockwork Systems, một startup AI cho doanh nghiệp, đưa cho CNBC con số hữu ích nhất trong cả bài. Nếu công ty ông muốn đánh giá 10 mô hình AI cho một tác vụ cụ thể, ông nói, có thể họ chỉ chọn năm. "Đi đánh giá từng mô hình một trong số đang ra hiện nay thực sự rất khó."
Hãy dừng lại một nhịp ở tỷ lệ đó, vì nó là sự thật chịu lực của toàn bộ chủ đề này. Một công ty mà chính công việc kinh doanh của họ là AI doanh nghiệp, với những người làm việc này chuyên nghiệp, với ngân sách tính toán được phân bổ đúng cho mục đích này, chỉ đánh giá một nửa số ứng viên mà họ tin là đáng đánh giá.
Hãy gọi nửa còn lại là năm mô hình chưa từng thử. Chúng không bị loại. Không ai thấy chúng thiếu sót. Chúng chỉ đơn giản là chưa từng được chạy, và vì thế câu hỏi liệu một trong số đó có nhanh hơn, rẻ hơn hay chính xác hơn trên khối lượng công việc cụ thể của bạn hay không sẽ mãi mãi bỏ ngỏ. Mỗi tuần có phát hành lại chất thêm vào đống đó.
Và xử lý đống đó rất tốn kém, vì đổi mô hình không phải là nâng số phiên bản. Đó là tái thẩm định. Đây là những gì thực sự phải diễn ra trước khi một mô hình mới chạm tới môi trường sản xuất:
| Thứ phải kiểm tra lại | Vì sao mô hình mới làm hỏng nó |
|---|---|
| Prompt và chỉ dẫn hệ thống | Được tinh chỉnh theo tật của mô hình cũ; cách diễn đạt lái được mô hình này một cách ổn định có thể lái mô hình khác đi chỗ khác |
| Độ ổn định của định dạng đầu ra | Các bộ phân tích phía sau phụ thuộc vào hình dạng — JSON, tiêu đề, ký tự phân cách — mà thói quen định dạng thì đổi giữa các mô hình |
| Độ chính xác trên dữ liệu thật của bạn | Chênh lệch điểm benchmark được đo trên tập công khai, không phải trên cuộc họp của bạn, ticket của bạn, mã nguồn của bạn |
| Hành vi công cụ và API | Các mô hình tác tử khác nhau ở chỗ khi nào gọi, thử lại thường xuyên ra sao, và làm gì khi một lệnh gọi thất bại |
| Độ trễ và thông lượng khi tải cao | Mô hình nhanh hơn ở một yêu cầu đơn lẻ có thể chậm hơn khi đứng sau giới hạn tần suất của bạn |
| Tổng chi phí ở khối lượng của bạn | Giá mỗi token nhân số token tiêu thụ nhân số lần thử — xem bên dưới |
| An toàn và hành vi từ chối | Ranh giới dịch chuyển giữa các phiên bản theo cả hai hướng |
| Các ca hồi quy | Đúng những lỗi bạn đã sửa, thứ mà không benchmark của ai khác biết đến |
Tám hạng mục, mỗi hạng mục cần ví dụ thật, một lượt chạy so sánh và phán đoán của một con người. Đó là một dự án, không phải một thay đổi cấu hình. Nhân nó với số bản phát hành tiên phong trong một tháng bất kỳ, và lý do của tỷ lệ 10 trên 5 trở nên hiển nhiên.
Chúng tôi đã viết hẳn một bài về cách đo việc này trên chính khối lượng công việc của bạn thay vì tin vào bảng xếp hạng, và tóm tắt thật lòng là làm cho tử tế mất vài ngày, không phải vài giờ.
Rẻ hơn trên mỗi token không phải là rẻ hơn trên mỗi tác vụ
Phát hiện phản trực giác nhất trong cả câu chuyện này không đến từ một phòng thí nghiệm mà từ một kỹ sư đang cố tự động hóa việc lựa chọn.
Moe Khalil, kỹ sư sản phẩm tại cổng AI mã nguồn mở LiteLLM, ngày 4 tháng 9 đăng một bài viết tựa đề "Model Fatigue is Real". Anh làm việc trên bộ tự động định tuyến của LiteLLM — phần mềm mà toàn bộ nhiệm vụ là chọn mô hình thay cho bạn — và anh công khai mối liên hệ đó ngay từ đầu, điều mà phần lớn người viết về chủ đề này không làm.
Giả định khởi điểm của nhóm anh là giả định trực giác. Lấy hai mô hình đều giải được một tác vụ; mô hình có giá mỗi token bằng một nửa theo model card lẽ ra phải giải nó với khoảng một nửa chi phí.
Kết quả thử nghiệm không như vậy. Mô hình mạnh hơn, đắt hơn lại giải những tác vụ khó hơn với một phần nhỏ chi phí của mô hình rẻ. Khalil giải thích: "Vì nó thông minh hơn, nó chọn cách tiếp cận thông minh hơn, và về đến sản phẩm hoàn chỉnh nhanh hơn nhiều."
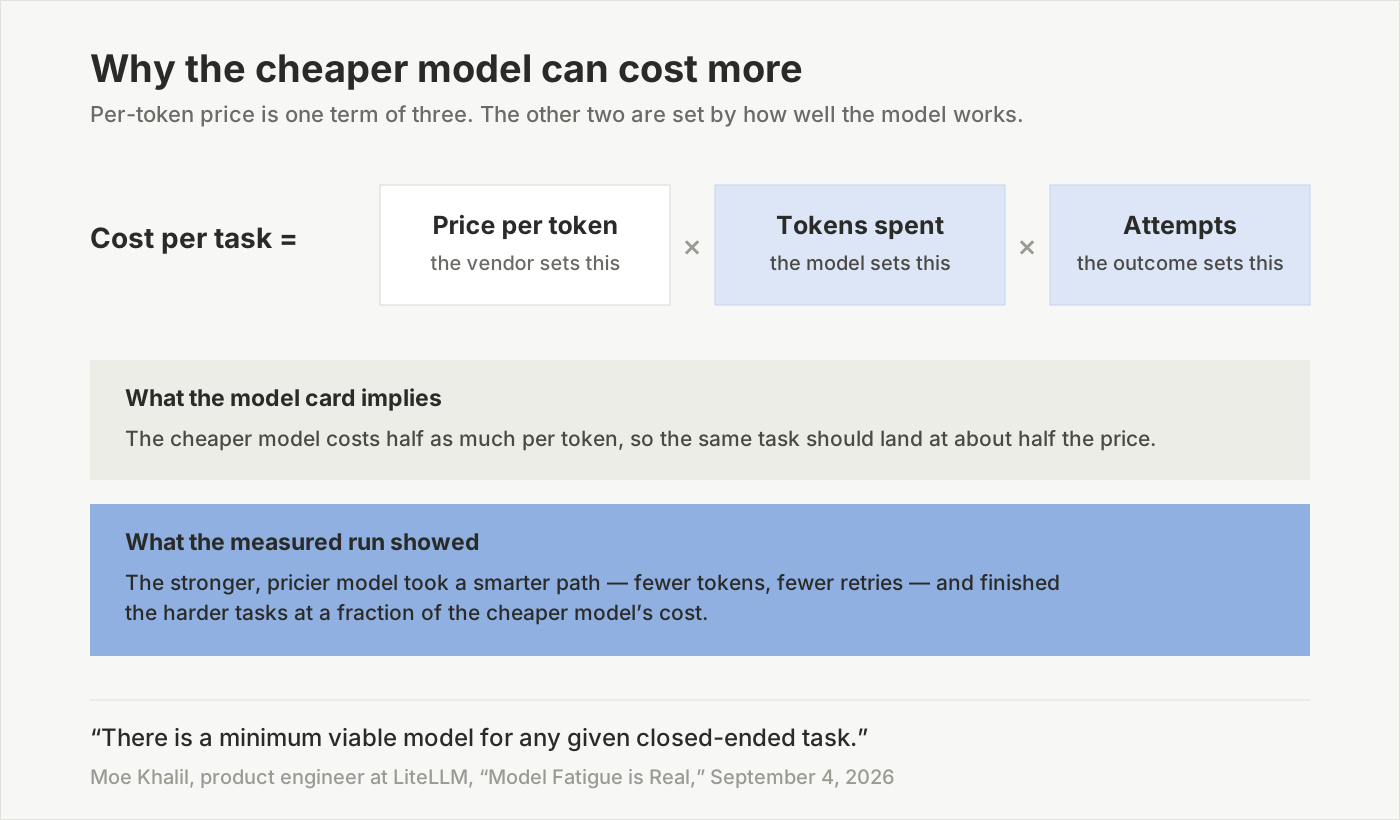
Trong ba thừa số, chỉ có giá mỗi token là xuất hiện trên trang bảng giá. Hai thừa số còn lại là thuộc tính năng lực của mô hình, và chúng chỉ lộ ra khi bạn cho chạy công việc thật.
Điều này định nghĩa lại hoàn toàn trang bảng giá. Con số mà nhà cung cấp quảng cáo chỉ là một thừa số trong tích của ba: giá mỗi token, số token đã tiêu, và số lần thử cho đến khi tác vụ thực sự thành công. Nhà cung cấp đặt thừa số thứ nhất. Chính mô hình đặt thừa số thứ hai và thứ ba, và không thừa số nào biết trước được cho đến khi bạn đẩy công việc của mình qua nó.
Nghĩa là phép so sánh mà người ta dạy bạn — lướt cột giá, chọn cái rẻ — không chỉ thiếu sót. Trên các tác vụ thật, nó có thể chỉ sai hướng.
Ở phía trên, không ai có động cơ nói cho bạn biết
Rồi Khalil nói ra phần người ta thường nuốt vào, và đó là câu sắc bén nhất viết về chủ đề này trong cả năm:
"Với các công ty mô hình, sự lười này là một tính năng — không phải lỗi. Họ thích tôi dùng [mô hình cao cấp nhất] để tóm tắt email của mình hơn, và họ không có động cơ nào để nói cho tôi biết khi nào một mô hình rẻ hơn cũng làm tốt y như vậy. Việc của họ là tiếp tục đẩy biên giới đi xa. Còn tìm ra khi nào không nên dùng biên giới thì để mặc tôi."
Hãy đọc lại câu đó với con số của Gartner trong đầu. Một thị trường 2,59 nghìn tỷ USD, tăng trưởng 47% mỗi năm, trong đó nhà cung cấp hưởng lợi từ việc mọi khách hàng mặc định chọn lên trên và chẳng chịu chi phí nào khi khách hàng tiêu quá tay.
Đây không phải âm mưu và không đòi hỏi ai phải cư xử tệ. Đó chỉ là hình dạng của độ dốc động cơ. Việc của một phòng thí nghiệm tiên phong là dịch chuyển biên giới. Nói cho bạn biết rằng mô hình tầm trung của năm ngoái xử lý được 80% khối lượng công việc của bạn là việc của người khác, và cho đến gần đây thì đó chẳng là việc của ai cả.
Nhận xét thứ hai của Abbasi cũng thuộc về chỗ này. Ông cho rằng "không phải trùng hợp" khi mọi nhà phát triển lớn đều công bố trong cùng một tuần, và Noah Faro, giám đốc công nghệ của Farsight, một startup tài chính AI, đồng tình — lưu ý rằng các đối thủ đọc kế hoạch của nhau một phần qua tình trạng sẵn có của năng lực tính toán đám mây, vì tất cả đều tranh giành công suất từ cùng một nhóm nhỏ nhà cung cấp. Faro cũng đưa ra nhận xét hạ nhiệt: khác với GPT-6 Astra, các bản ra mắt của Anthropic, Meta và Google tuần đó là bản nâng cấp nhỏ, tức nâng cấp mô hình sẵn có chứ không phải mô hình mới. Theo đánh giá của ông, hai bản phát hành gần nhất thực sự tạo khác biệt là Fable 5 của Anthropic hồi tháng 6 và Kimi K3 của Moonshot AI hồi tháng 7.
Vậy là: sáu thông báo, một mô hình tiên phong thực sự mới, và nguyên một chu kỳ đánh giá phát sinh cho mọi người ở phía dưới.
Hai cách ngành này hấp thụ chuyện đó, và chúng không giống nhau
Nếu các phòng thí nghiệm không quyết, thì ai đó phải quyết. Hai câu trả lời đã xuất hiện, và chúng khác nhau về cấu trúc.
Câu trả lời theo chiều ngang là định tuyến. Các cổng như LiteLLM đặt mọi mô hình sau một khóa API duy nhất và cố chọn theo từng yêu cầu. Khalil mô tả bài toán kỹ thuật rất chính xác: với bất kỳ tác vụ đóng nào cũng tồn tại một mô hình tối thiểu khả dụng — mô hình rẻ nhất mà vẫn thành công — và cái khó là đoán được đó là mô hình nào trước khi tác vụ chạy. Cách tốt nhất hiện tại của nhóm anh suy ra điều đó từ dữ liệu benchmark công khai cộng với các quy tắc kinh nghiệm trong prompt; họ cũng đã thử phân loại bằng LLM và các cách lai. Tự anh đánh giá: "Tất cả vẫn chưa hoàn hảo, nhưng khá hơn một bậc so với không có gì."
Định tuyến là kỹ thuật thật và nó có ích. Nhưng hãy để ý nó dịch chuyển cái gì và không dịch chuyển cái gì. Nó hấp thụ phần đường ống — một khóa, một giao diện, tự động có quyền dùng mô hình mới. Nó không hấp thụ phần trách nhiệm. Khi bộ định tuyến chọn sai, đầu ra tệ vẫn là của bạn, trong sản phẩm của bạn, trước mặt người dùng của bạn. Việc đánh giá câu trả lời có tốt hay không vẫn thuộc về bạn.
Câu trả lời theo chiều dọc là phần mềm được quản lý trọn gói, xây cho một công việc. Ở đây nhà cung cấp không định tuyến giữa các mô hình thay bạn; họ nhận trọn tác vụ khỏi tay bạn và giao lại kết quả hoàn chỉnh. Bạn không thấy tên mô hình. Bạn thấy một bản ghi lời, một bản tóm tắt, một bản dịch, một đề nghị hoàn ứng đã nộp.
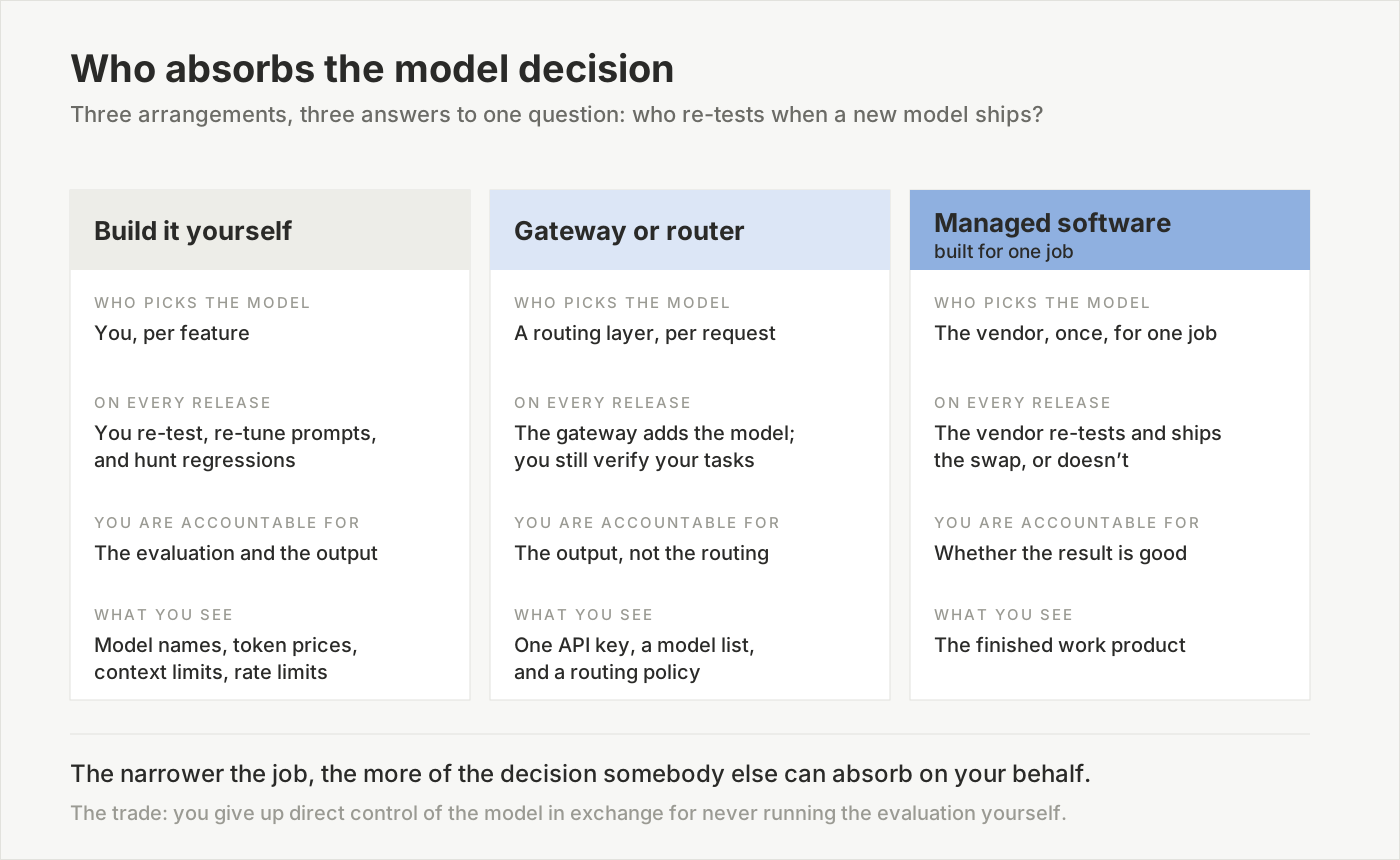
Càng đi sang phải, phần quyết định còn lại của bạn càng ít — và bạn càng phụ thuộc vào việc nhà cung cấp có làm cuộc đánh giá một cách trung thực hay không.
Cộng đồng AI chạy cục bộ đi tới kết luận tương tự từ hướng ngược lại. Một phân tích công bố trong năm nay mô tả giới mô hình nhỏ như một chiếc máy chạy bộ: tải về, cấu hình, chạy vài prompt, đánh giá nửa vời, rồi lao sang bản phát hành kế tiếp. Khuyến nghị của họ là dừng lại — chuẩn hóa trên một cấu hình dùng hằng ngày đã được kiểm chứng, và chỉ nhận mô hình mới sau khi đã thử nó đủ lâu trên các tác vụ thật, mang tính đại diện, để xác nhận nó thực sự tốt hơn cho khối lượng công việc cụ thể của bạn. Cùng một kết luận, đến từ một người chơi nghiệp dư có hai chiếc GPU và từ một CEO có ngân sách tính toán: chọn một lần, cho đến nơi đến chốn, và thôi mang ra cãi lại vào mỗi thứ Năm.
Vì sao chính sự hẹp của công việc mới làm quyết định trở nên hấp thụ được
Đây là quan điểm của chúng tôi, và đó cũng là lý do hạng mục sản phẩm này tồn tại.
Quyết định về mô hình chỉ có thể do người hiểu tác vụ đưa ra. Nghe có vẻ hiển nhiên. Không hề, vì nó loại gần như tất cả mọi người ra ngoài.
Một giao diện trò chuyện đa dụng không thể quyết thay bạn, vì vào bất kỳ buổi sáng nào nó cũng có thể được yêu cầu viết một bài sonnet, gỡ lỗi một tình huống tranh chấp luồng, hoặc tóm tắt một hợp đồng thuê nhà. Không tồn tại mô hình tối thiểu khả dụng cho "bất cứ thứ gì người dùng gõ tiếp theo". Lựa chọn mặc định an toàn duy nhất là mô hình mạnh nhất hiện có — đúng là mặc định phục vụ lợi ích của nhà cung cấp, và đúng là mặc định mà theo lời Khalil, chẳng ai có động cơ can bạn.
Một cổng có thể đoán khá hơn, vì nó nhìn thấy prompt. Nhưng nó nhìn prompt mà không biết một câu trả lời tốt trong lĩnh vực của bạn trông ra sao, và không phải chịu hậu quả nào nếu đoán sai.
Phần mềm được quản lý, xây riêng cho một mục đích, đứng ở một vị trí hoàn toàn khác. Khi công việc đã cố định — ghi lại lời một cuộc họp 60 phút với bốn người nói luân phiên giữa tiếng Việt và tiếng Anh, rồi tạo danh sách việc cần làm — thì tác vụ đó đóng đúng theo nghĩa của Khalil. Tồn tại một mô hình tối thiểu khả dụng cho nó. Và quan trọng nhất, đó là cùng một mô hình tối thiểu khả dụng cho mọi khách hàng có công việc ấy, nghĩa là cuộc đánh giá chỉ phải chạy một lần và chi phí của nó được chia đều cho tất cả.
Đó là toàn bộ lập luận kinh tế của hạng mục này, và nó đáng được phát biểu thành một quy tắc: công việc càng hẹp, phần quyết định về mô hình mà người khác có thể gánh thay bạn càng lớn. Một nhà cung cấp phục vụ đúng một khối lượng công việc có thể kham nổi việc thử cả 10 ứng viên, vì họ thử một lần, cho hàng nghìn khách hàng, đối chiếu với một định nghĩa cố định về kết quả tốt. Còn bạn thử năm cái, cho riêng mình, đối chiếu với một định nghĩa mà bạn phải tự nghĩ ra, là cách đắt đỏ để có câu trả lời tệ hơn.
Sự đánh đổi ở đây là thật và đáng được gọi tên một cách trung thực. Bạn từ bỏ quyền kiểm soát trực tiếp việc mô hình nào chạy công việc của bạn. Đổi lại, bạn thôi phải chạy đánh giá, thôi phải theo dõi lịch phát hành, và thứ bạn phán xét là đầu ra — vốn luôn là thứ duy nhất bạn thực sự quan tâm.
Cách nhận ra bạn đang mua dàn xếp nào
Trước lần mua sắm AI kế tiếp, bốn câu hỏi theo thứ tự:
- Công việc có đóng không? Bạn có nói được trong một câu rằng đầu ra đúng trông như thế nào không? Nếu có, một công cụ theo chiều dọc được quản lý có thể gánh quyết định. Nếu câu trả lời là "còn tùy chúng tôi hỏi gì", bạn đang mua một mô hình đa dụng và cuộc đánh giá vẫn là của bạn.
- Ai kiểm thử lại khi có mô hình mới? Hỏi thẳng nhà cung cấp. Một nhà cung cấp dạng quản lý phải mô tả được bộ đánh giá và quy trình chuyển đổi của họ. Nếu câu trả lời là bạn sẽ "được dùng các mô hình mới nhất", thì bạn đã mua đường ống chứ không phải phán đoán.
- Bạn được cho xem cái gì — một mô hình hay một kết quả? Nếu sản phẩm phơi ra tên mô hình, cửa sổ ngữ cảnh và giá token, nó đang trả quyết định lại cho bạn. Đó vẫn là một sản phẩm chính đáng, nhưng hãy định giá nó tương ứng.
- Tổng chi phí ở khối lượng của bạn là bao nhiêu? Giá mỗi token, nhân số token thực sự tiêu trên công việc của bạn, nhân số lần thử cho đến khi ra đúng. Hãy chạy chính các tác vụ của bạn. Trang bảng giá không trả lời được câu này.
Chốt lại: biên giới là một giá trị mặc định, không phải một quyết định
Mệt mỏi vì mô hình thường được mô tả như một vấn đề chú ý — quá nhiều tin, quá nhanh. Không phải vậy. Đó là một khoản chi phí mà thị trường tăng trưởng nhanh nhất ngành công nghệ đã lặng lẽ đẩy sang khách hàng, nơi nó nằm đó, không được định giá và phần lớn không được đo đếm.
Các phòng thí nghiệm sẽ tiếp tục tung hàng, vì tung hàng là việc của họ và thị trường trả tiền cho việc đó. Gánh nặng đánh giá sẽ tiếp tục lớn lên, vì nó lớn lên một cách máy móc theo từng bản phát hành. Và phần lớn các nhóm sẽ tiếp tục giải quyết theo cách duy nhất mà một nhóm bận rộn có thể: với tay lấy mô hình mới nhất, lớn nhất, đắt nhất — lựa chọn duy nhất mà không ai phải bảo vệ trong một cuộc họp.
Mọi phần mềm nhận trọn một công việc khỏi tay bạn — và không bao giờ cho bạn thấy tên mô hình — đều là một canh bạc rằng cách làm kia là cách điều hành doanh nghiệp tồi. Canh bạc đó trông càng có lý sau mỗi tuần phát hành.
Telli.sh đứng ở đâu: đây chính là hạng mục mà chúng tôi đang xây. Telli.sh ghi âm cuộc họp, tách người nói, dịch thời gian thực giữa 15 ngôn ngữ, và tạo bản tóm tắt cùng danh sách việc cần làm — và nó không bao giờ hỏi bạn muốn dùng mô hình nào, vì đó là việc của chúng tôi, không phải của bạn. Tiện ích mở rộng trình duyệt của chúng tôi thì có cung cấp chín công cụ dịch, bao gồm một tùy chọn chạy hoàn toàn trên thiết bị, dành cho những người thực sự muốn quyền kiểm soát đó; sản phẩm họp thì cố ý không làm vậy, vì "ghi lại cuộc họp này cho tốt" là một tác vụ đóng, và chúng tôi thà được đánh giá qua bản ghi lời hơn là qua mô hình phía sau nó.
Ghi lại cuộc họp tiếp theo và để người khác chọn mô hình
Nguồn
- CNBC, "'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace", ngày 6 tháng 9 năm 2026 — trình tự phát hành từ ngày 1 đến 3 tháng 9 năm 2026; câu "mệt mỏi vì mô hình là chuyện có thật" của Zhen Lu; nhận xét "nhịp phát hành nhanh hơn" của Sam Altman; Ahmed Abbasi về "trò giành phần trong hầu bao" và các mức định giá tư nhân gần 1 nghìn tỷ USD; Noah Faro về các bản nâng cấp nhỏ và về Fable 5 cùng Kimi K3 là hai bản gần nhất tạo khác biệt; và con số 10 mô hình đánh giá năm của Suresh Vasudevan. Có đóng góp của Kate Rooney và MacKenzie Sigalos; truy cập ngày 8 tháng 9 năm 2026
- Moe Khalil, "Model Fatigue is Real", ngày 4 tháng 9 năm 2026 — lập luận "không có động cơ nói cho tôi biết khi nào một mô hình rẻ hơn cũng được"; khung mô hình tối thiểu khả dụng cho các tác vụ đóng; và kết quả đo được rằng mô hình mạnh hơn, đắt hơn giải các tác vụ khó hơn với một phần nhỏ chi phí của mô hình rẻ. Khalil công khai trong bài rằng anh là kỹ sư sản phẩm tại LiteLLM, nơi xây bộ tự động định tuyến; truy cập ngày 8 tháng 9 năm 2026
- Gartner, "Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026", ngày 19 tháng 5 năm 2026 — chi tiêu AI toàn cầu đạt 2,59 nghìn tỷ USD trong năm 2026, tăng 47% so với cùng kỳ, với hạ tầng AI là phân khúc lớn nhất
- MindStudio, "Local AI Model Fatigue: Why One Setup Beats Chasing Every Release" — mô tả chu kỳ phát hành mô hình nhỏ chạy cục bộ như một chiếc máy chạy bộ và lập luận cho việc chuẩn hóa trên một cấu hình dùng hằng ngày đã kiểm chứng
- AI타임스, "[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'", ngày 7 tháng 9 năm 2026 — bài báo tiếng Hàn đưa lại câu chuyện của CNBC cùng các bình luận của giới lập trình xung quanh nó
- Cách chúng tôi đọc thương vụ NVIDIA mua Hugging Face — thông báo còn lại của cùng tuần đó, và lớp phân phối nằm dưới mọi mô hình được nhắc tên ở đây
- Cách đo độ chính xác của bản ghi lời trên khối lượng công việc của bạn — một cuộc đánh giá thật sự tốn bao nhiêu khi bạn làm cho tử tế