Empat model frontier dalam tiga hari, dan tiada siapa akan memberitahu anda yang mana anda perlukan
Antara 1 hingga 3 September 2026, Anthropic, Meta, Google dan OpenAI semuanya melancarkan model frontier, dan CNBC memberi nama kepada keletihan yang timbul: model fatigue. Jumlah pelancaran ialah bahagian yang membosankan. Bahagian yang menarik ialah setiap pelancaran mencipta satu penilaian yang perlu dijalankan oleh seseorang di hiliran, sementara syarikat yang melancarkannya langsung tiada sebab untuk membantu anda melangkaunya. Tulisan ini meneliti kos sebenar menukar model, mengapa lebih murah setiap token bukan bermakna lebih murah setiap tugasan, dan mengapa perisian terurus sepenuhnya yang dibina untuk satu kerja sempit ialah satu-satunya susunan di mana orang lain boleh membuat keputusan bagi pihak anda.
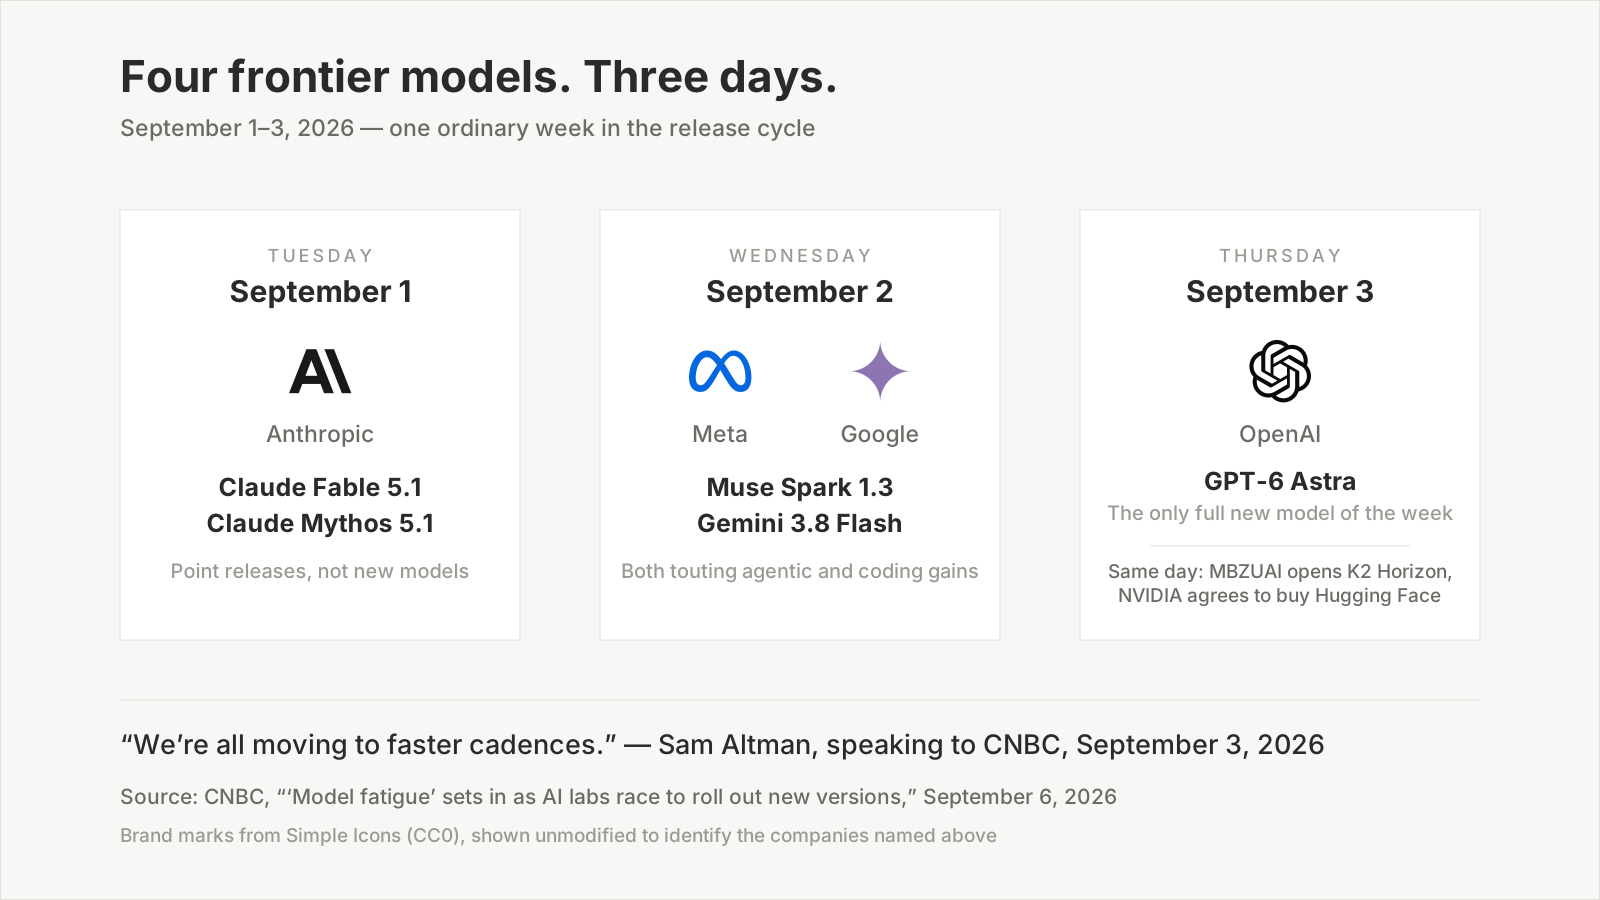
Tanda jenama daripada Simple Icons (CC0), dipaparkan tanpa diubah suai untuk mengenal pasti syarikat yang dinamakan. Tarikh pelancaran dan petikan Altman menurut CNBC, 6 September 2026.
Antara Selasa dan Khamis pada minggu pertama September 2026, Anthropic melancarkan Claude Fable 5.1 dan Claude Mythos 5.1, Meta melancarkan Muse Spark 1.3, Google melancarkan Gemini 3.8 Flash, dan OpenAI melancarkan GPT-6 Astra. Pada Khamis yang sama, Mohamed bin Zayed University of Artificial Intelligence di Abu Dhabi membuka keluarga K2 Horizon kepada dunia, dan NVIDIA bersetuju membeli Hugging Face dengan harga AS$12,930,300,000.
Enam pengumuman. Tiga hari. CNBC menyiarkan laporannya pada Ahad, 6 September, di bawah satu frasa yang sudah berminggu-minggu beredar dalam kalangan pengamal: model fatigue.
Bacaan yang paling jelas ialah industri ini bergerak lebih laju daripada kemampuan sesiapa pun mengikutinya. Bacaan itu benar, dan sebahagian besarnya tidak menarik. Inilah bahagian yang berbaloi mendapat perhatian anda: setiap pelancaran memindahkan satu kos, dan pemindahan itu berjalan tepat ke satu arah sahaja. Setiap model yang dilancarkan sesebuah makmal menjadi satu penilaian yang perlu dijalankan oleh seseorang di hiliran — dan tiada sesiapa di huluan mempunyai sebab walau sedikit pun untuk membantu anda melangkaunya.
TL;DR
- Empat pelancaran frontier mendarat dalam tiga hari (1–3 September 2026); pada 6 September CNBC menamakan keletihan yang timbul itu sebagai "model fatigue".
- Kos sebenarnya bukan perhatian, tetapi kerja penilaian. Seorang CEO syarikat AI korporat memberitahu CNBC bahawa apabila pasukannya mahu menilai 10 model bagi sesuatu tugasan, mereka menguji kira-kira 5.
- Harga setiap token ialah proksi yang lemah bagi kos setiap tugasan — model yang lebih kuat dan lebih mahal boleh menyiapkan kerja yang lebih sukar dengan kos lebih rendah kerana mengambil lebih sedikit langkah.
- Dari segi struktur, vendor model tiada minat untuk memberitahu anda bila model yang lebih murah sudah memadai. Jurang itulah keseluruhan sebab kewujudan perisian terurus yang dibina khusus.
Model fatigue mendapat namanya pada 6 September
"Saya rasa model fatigue ini memang wujud," kata Zhen Lu, CEO syarikat pemula infrastruktur AI Runpod, kepada CNBC. "Jangan salah faham, saya amat teruja dengan segala inovasi yang sedang berlaku, tetapi saya benar-benar berpendapat kita berada dalam persekitaran yang penuh buih sehingga anda terpaksa membuat bising."
Pada minggu yang sama Sam Altman menawarkan kerangka yang lebih lembut kepada CNBC: "kita semua sedang beralih kepada kadens yang lebih pantas," katanya, sambil mengaitkan sebahagian pecutan itu dengan semua orang yang "kembali daripada cuti musim panas".
Kedua-duanya boleh benar. Kadensnya memang benar-benar memecut, dan pecutan itu memang benar-benar sebahagiannya lakonan. Ahmed Abbasi, profesor di Mendoza School of Business, Notre Dame, dengan 25 tahun dalam bidang AI, menyatakan logik komersialnya secara terus terang: makmal-makmal itu "semuanya sedang bermain permainan bahagian dompet". Anthropic dan OpenAI menolak paling kuat sambil menuju ke pasaran awam, dan pelabur persendirian sudah menilai kedua-duanya hampir AS$1 trilion.
Dompet yang dimaksudkan itu amat besar. Pada Mei 2026 Gartner meramalkan perbelanjaan AI sedunia akan mencecah AS$2.59 trilion tahun ini, kenaikan 47% berbanding 2025. Infrastruktur mengambil bahagian terbesar, tetapi jauh lebih daripada AS$1 trilion jatuh kepada perkhidmatan, perisian, keselamatan, model dan perkakas — iaitu kepada keputusan yang perlu dibuat oleh seseorang.
Inilah intinya: pasaran sebesar itu, yang membesar sepantas itu, memberi ganjaran kepada kelantangan. Ia tidak memberi ganjaran kerana memberitahu pelanggan bahawa mereka boleh memadai dengan yang lebih sedikit.
Kosnya bukan perhatian. Ia penilaian yang anda tidak sempat habiskan
Tanya seorang pengamal bagaimana model fatigue sebenarnya terasa, dan anda tidak akan mendengar "saya membaca terlalu banyak siaran pelancaran". Anda akan mendengar aritmetik.
Suresh Vasudevan, CEO syarikat pemula AI korporat Clockwork Systems, memberikan CNBC angka paling berguna dalam keseluruhan laporan itu. Jika syarikatnya mahu menilai 10 model AI bagi sesuatu tugasan tertentu, katanya, mungkin ia hanya akan memilih lima. "Sungguh mencabar untuk pergi menilai setiap satu daripada yang sedang keluar sekarang."
Berhentilah seketika pada nisbah itu, kerana itulah fakta yang menanggung seluruh perkara ini. Sebuah syarikat yang perniagaannya memang AI korporat, dengan orang yang melakukan kerja ini secara profesional, dengan bajet pengkomputeran yang diperuntukkan tepat untuk tujuan itu, hanya menilai separuh daripada calon yang ia sendiri percaya berbaloi dinilai.
Panggil separuh yang lagi satu itu lima yang tak pernah diuji. Mereka tidak ditolak. Tiada sesiapa mendapati mereka kurang. Mereka cuma tidak pernah dijalankan, jadi persoalan sama ada salah satu daripadanya akan lebih pantas, lebih murah atau lebih tepat pada beban kerja khusus anda kekal terbuka selama-lamanya. Setiap minggu pelancaran menambah longgokan itu.
Dan longgokan itu mahal untuk diselesaikan, kerana menukar model bukan menaikkan versi. Ia satu pentauliahan semula. Inilah yang benar-benar mesti berlaku sebelum sesebuah model baharu sampai ke pengeluaran:
| Apa yang perlu disemak semula | Mengapa model baharu merosakkannya |
|---|---|
| Gesaan dan arahan sistem | Ditala pada kerenah model lama; ungkapan yang memandu satu model dengan boleh dipercayai boleh membawa model lain ke tempat lain |
| Kestabilan format output | Penghurai di hiliran bergantung pada bentuk — JSON, tajuk, pemisah — sedangkan tabiat pemformatan berubah antara model |
| Ketepatan pada data sebenar anda | Beza markah penanda aras diukur pada set awam, bukan pada mesyuarat anda, tiket anda, pangkalan kod anda |
| Kelakuan alat dan API | Model agentik berbeza dari segi bila ia memanggil, sekerap mana ia mencuba semula, dan apa yang dilakukannya apabila panggilan gagal |
| Kependaman dan daya pemprosesan di bawah beban | Model yang lebih pantas pada satu permintaan tunggal boleh menjadi lebih perlahan di sebalik had kadar anda |
| Jumlah kos pada volum anda | Harga setiap token didarab token yang digunakan didarab bilangan percubaan — lihat di bawah |
| Keselamatan dan kelakuan penolakan | Sempadan beralih antara versi ke kedua-dua arah |
| Kes regresi | Tepat kegagalan yang sudah anda betulkan, yang tiada penanda aras orang lain tahu tentangnya |
Lapan kategori, setiap satu memerlukan contoh sebenar, satu larian perbandingan dan pertimbangan seseorang. Itu satu projek, bukan satu perubahan konfigurasi. Darabkan dengan bilangan pelancaran frontier dalam mana-mana bulan, dan sebab nisbah 10 berbanding 5 menjadi jelas.
Kami menulis satu tulisan penuh tentang cara mengukur perkara ini pada beban kerja anda sendiri dan bukannya mempercayai papan pendahulu, dan ringkasan jujurnya ialah melakukannya dengan betul mengambil masa berhari-hari, bukan berjam-jam.
Lebih murah setiap token bukan lebih murah setiap tugasan
Penemuan paling bertentangan dengan gerak hati dalam keseluruhan cerita ini bukan datang daripada sebuah makmal tetapi daripada seorang jurutera yang cuba mengautomasikan pilihan itu.
Moe Khalil, jurutera produk di get laluan AI sumber terbuka LiteLLM, menerbitkan tulisan bertajuk "Model Fatigue is Real" pada 4 September. Dia bekerja pada auto router LiteLLM — perisian yang keseluruhan kerjanya ialah memilih model bagi pihak anda — dan dia mendedahkan hubungan itu di bahagian awal, sesuatu yang lebih daripada apa yang kebanyakan penulis tentang topik ini lakukan.
Andaian permulaan pasukannya ialah andaian yang paling masuk akal. Ambil dua model yang kedua-duanya boleh menyelesaikan sesuatu tugasan; yang harganya separuh setiap token menurut kad model sepatutnya menyelesaikannya dengan kira-kira separuh harga.
Bukan itu yang ditunjukkan oleh ujian. Model yang lebih kuat dan lebih mahal itu menyelesaikan tugasan yang lebih sukar dengan sepersekian kos model yang murah. Penjelasan Khalil: "Kerana ia lebih pintar, ia mengambil pendekatan yang lebih pintar, dan sampai ke produk siap jauh lebih pantas."
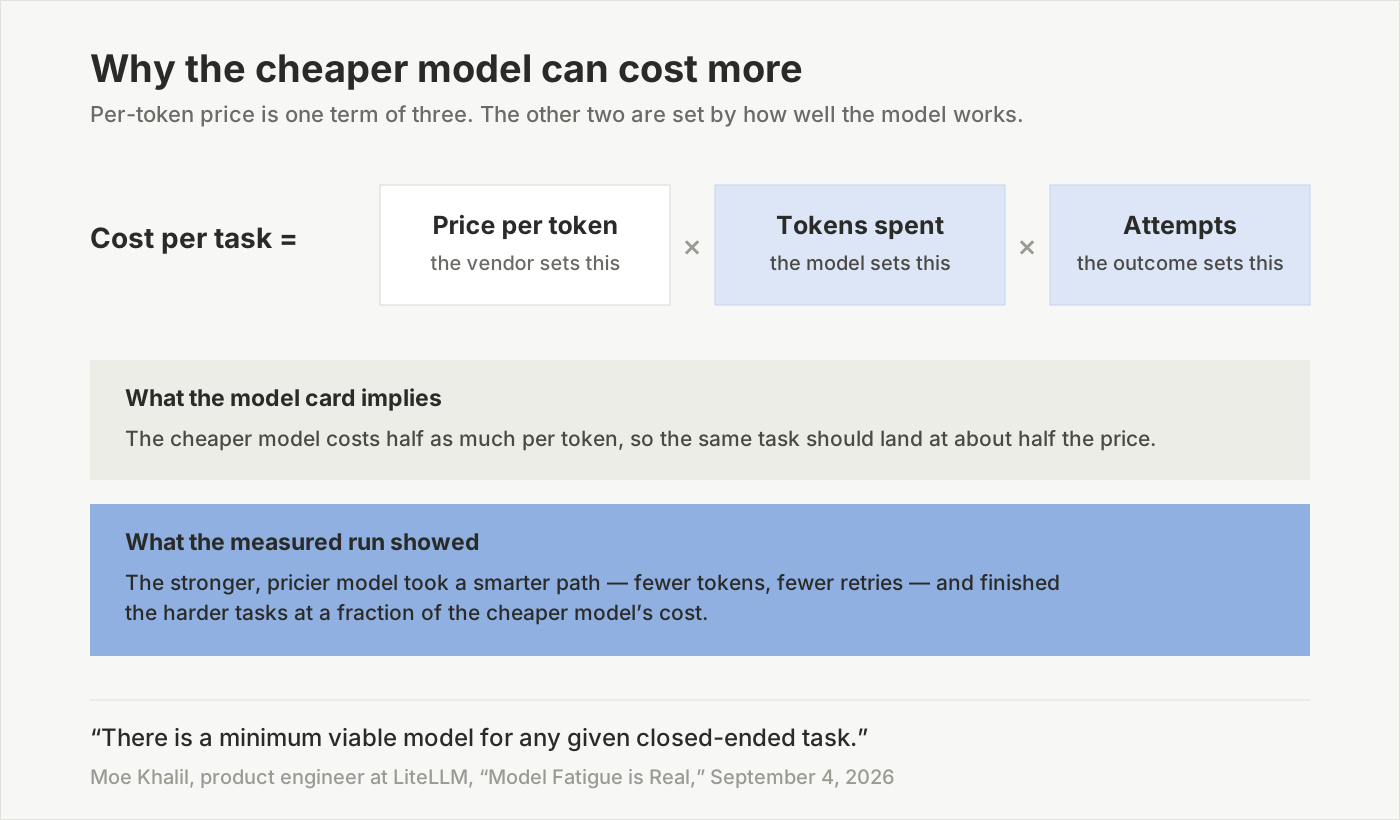
Daripada ketiga-tiga faktor, hanya harga setiap token yang muncul pada halaman harga. Dua yang lain ialah sifat kecekapan model, dan ia hanya menampakkan diri apabila anda benar-benar menjalankan kerja itu.
Ini mengubah maksud halaman harga sepenuhnya. Angka yang diiklankan sesebuah vendor hanyalah satu faktor dalam hasil darab tiga: harga setiap token, token yang digunakan, dan bilangan percubaan sehingga tugasan itu benar-benar berjaya. Vendor menetapkan yang pertama. Model itu sendiri menetapkan yang kedua dan ketiga, dan kedua-duanya tidak dapat diketahui sebelum anda melalukan kerja anda sendiri melaluinya.
Ini bermakna perbandingan yang diajar kepada anda — imbas lajur harga, ambil yang murah — bukan sekadar tidak lengkap. Pada tugasan sebenar, ia boleh menunjuk ke arah yang salah.
Di huluan tiada sesiapa berinsentif memberitahu anda
Khalil kemudian menyebut bahagian yang biasanya ditelan, dan ia ayat paling tajam yang ditulis tentang perkara ini sepanjang tahun ini:
"Bagi syarikat model, kemalasan ini ialah ciri — bukan pepijat. Mereka lebih suka saya menggunakan [model peringkat teratas] untuk meringkaskan e-mel saya, dan mereka tiada insentif untuk memberitahu saya bila model yang lebih murah akan berfungsi sama baiknya. Kerja mereka ialah terus menolak frontier. Mencari tahu bila tidak patut menggunakan frontier itu dibiarkan kepada saya."
Baca sekali lagi dengan angka Gartner di kepala. Sebuah pasaran AS$2.59 trilion, membesar 47% setahun, yang di dalamnya pembekal mendapat faedah daripada setiap pelanggan yang secara lalai mencapai ke atas dan tidak menanggung apa-apa kos apabila pelanggan berbelanja berlebihan.
Ini bukan konspirasi dan ia tidak memerlukan sesiapa berkelakuan buruk. Beginilah rupa kecerunan insentif. Kerja sebuah makmal frontier ialah mengalihkan frontier. Memberitahu anda bahawa model pertengahan tahun lepas mampu mengendalikan 80% beban kerja anda ialah kerja orang lain, dan sehingga baru-baru ini ia bukan kerja sesiapa pun.
Pemerhatian kedua Abbasi juga tergolong di sini. Dia mencadangkan bahawa ia "bukan kebetulan" apabila semua pembangun utama mengumumkan pada minggu yang sama, dan Noah Faro, ketua teknologi syarikat pemula kewangan AI Farsight, bersetuju — sambil menyatakan bahawa para pesaing membaca rancangan satu sama lain sebahagiannya daripada ketersediaan pengkomputeran awan, memandangkan semuanya bersaing untuk kapasiti daripada segelintir vendor yang sama. Faro turut membuat pengamatan yang mengempiskan keghairahan: tidak seperti GPT-6 Astra, pelancaran Anthropic, Meta dan Google pada minggu itu ialah keluaran titik, iaitu naik taraf model sedia ada dan bukan model baharu. Pada penilaiannya, dua pelancaran terakhir yang benar-benar menggerakkan jarum ialah Fable 5 daripada Anthropic pada Jun dan Kimi K3 daripada Moonshot AI pada Julai.
Jadi: enam pengumuman, satu model frontier yang benar-benar baharu, dan kerja bernilai satu kitaran penilaian penuh yang dijana untuk semua orang di hiliran.
Dua cara industri menyerap perkara ini, dan kedua-duanya tidak sama
Jika makmal tidak mahu membuat keputusan itu, seseorang terpaksa membuatnya. Dua jawapan telah muncul, dan kedua-duanya berbeza dari segi struktur.
Jawapan mendatarnya ialah penghalaan. Get laluan seperti LiteLLM meletakkan setiap model di sebalik satu kunci API dan cuba memilih bagi setiap permintaan. Khalil menerangkan masalah teknikalnya dengan tepat: bagi mana-mana tugasan tertutup wujud satu model minimum yang masih berdaya guna — yang paling murah tetapi masih berjaya — dan cabarannya ialah meramalkan yang mana satu itu sebelum tugasan itu dijalankan. Pendekatan terbaik pasukannya buat masa ini menyimpulkannya daripada data penanda aras awam serta heuristik di dalam gesaan; mereka juga sudah mencuba pengelasan LLM dan pendekatan hibrid. Penilaiannya sendiri: "Semuanya masih tidak sempurna, tetapi setingkat lebih baik daripada tiada apa-apa."
Penghalaan ialah kejuruteraan sebenar dan ia membantu. Tetapi perhatikan apa yang dipindahkannya dan apa yang tidak. Ia menyerap paip — satu kunci, satu antara muka, capaian automatik kepada model baharu. Ia tidak menyerap kebertanggungjawaban. Apabila penghala memilih salah, output buruk itu masih milik anda, di dalam produk anda, di hadapan pengguna anda. Menilai sama ada jawapan itu bagus tetap tanggungjawab anda.
Jawapan menegaknya ialah perisian terurus sepenuhnya yang dibina untuk satu kerja. Di sini vendor tidak menghala antara model bagi pihak anda; ia mengambil keseluruhan tugasan daripada tangan anda dan menyerahkan hasil yang siap. Anda tidak melihat nama model. Anda melihat transkrip, ringkasan, terjemahan, satu tuntutan perbelanjaan yang telah dihantar.
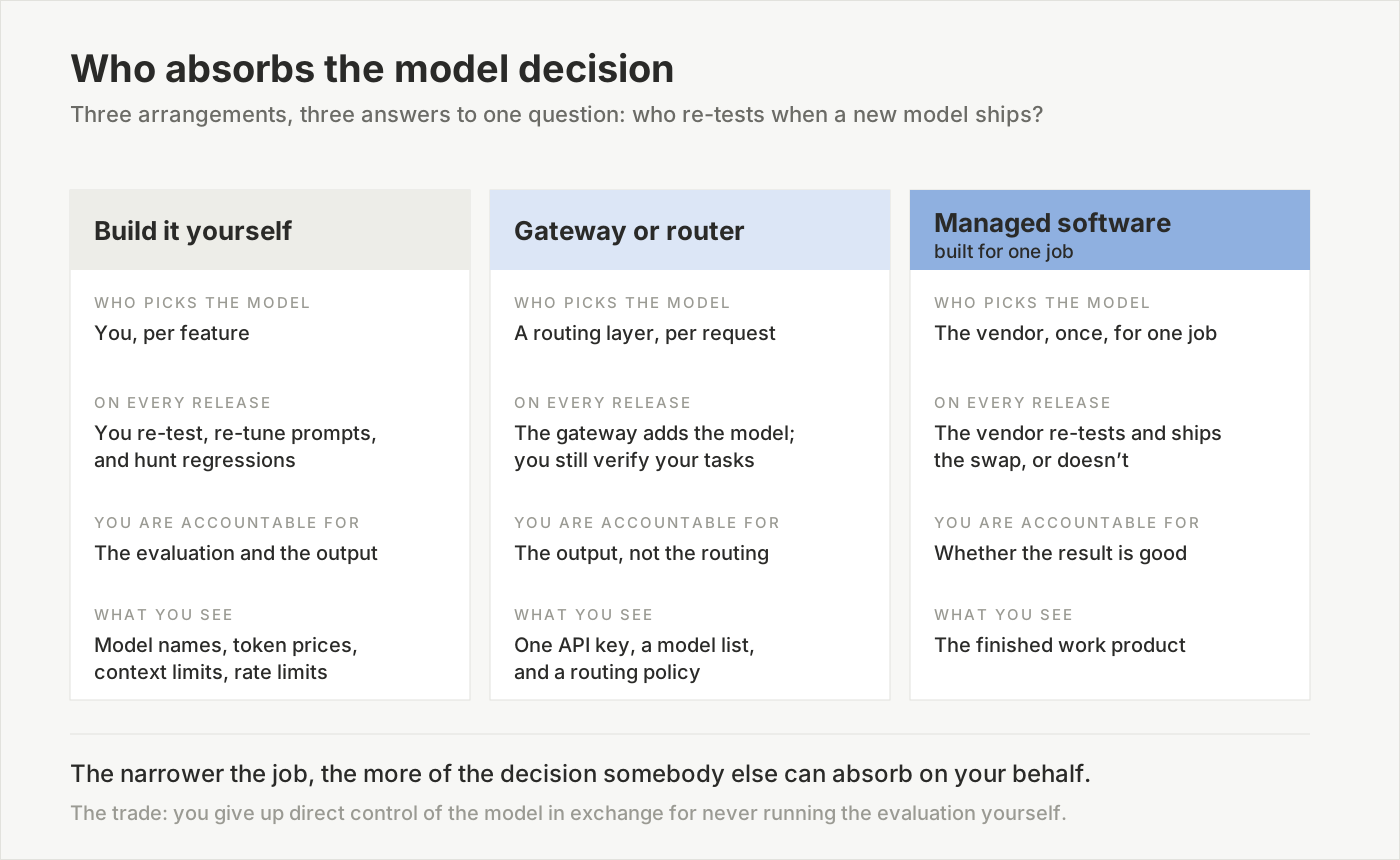
Semakin ke kanan, semakin sedikit keputusan yang kekal milik anda — dan semakin besar pergantungan anda pada sama ada vendor telah menjalankan penilaian itu dengan jujur.
Komuniti AI setempat sampai kepada kesimpulan yang serupa daripada arah bertentangan. Sebuah analisis yang diterbitkan tahun ini menggambarkan dunia model kecil sebagai sebuah treadmill: muat turun, konfigur, jalankan beberapa gesaan, nilai separuh jalan, terus ke pelancaran berikutnya. Saranannya ialah berhenti — menyeragamkan diri pada satu susunan harian yang terbukti dan menerima model baharu hanya selepas mengujinya cukup lama pada tugasan sebenar yang mewakili keadaan, bagi mengesahkan ia memang lebih baik untuk beban kerja khusus anda. Kesimpulan yang sama, dicapai oleh seorang penggemar dengan dua GPU dan oleh seorang CEO dengan bajet pengkomputeran: pilih sekali, dengan betul, dan berhenti membangkitkannya semula setiap hari Khamis.
Mengapa kerja yang sempit itulah yang membolehkan keputusan diserap
Inilah pandangan kami, dan inilah sebab kategori ini wujud sama sekali.
Keputusan model hanya boleh dibuat oleh seseorang yang mengenali tugasan itu. Bunyinya remeh. Ia tidak, kerana ia menyingkirkan hampir semua orang.
Antara muka sembang serba guna tidak boleh membuat keputusan bagi pihak anda, kerana pada mana-mana pagi ia mungkin diminta menulis sebuah soneta, menyahpepijat keadaan perlumbaan, atau meringkaskan satu perjanjian sewa. Tiada model minimum yang berdaya guna bagi "apa sahaja yang pengguna taip seterusnya". Satu-satunya nilai lalai yang selamat ialah model terkuat yang ada — tepat sekali nilai lalai yang menguntungkan kepentingan vendor, dan tepat sekali nilai lalai yang menurut Khalil tiada sesiapa berinsentif memujuk anda menjauhinya.
Sebuah get laluan boleh meneka dengan lebih baik, kerana ia melihat gesaan. Tetapi ia melihat gesaan tanpa pengetahuan tentang rupa jawapan yang baik dalam domain anda, dan tanpa akibat jika ia tersilap.
Perisian terurus yang dibina khusus berada pada kedudukan yang sama sekali berbeza. Apabila kerjanya tetap — menyalin sebuah mesyuarat 60 minit dengan empat penutur yang bertukar antara bahasa Melayu dan bahasa Inggeris, kemudian menghasilkan senarai tindakan — tugasan itu tertutup tepat dalam erti kata Khalil. Wujud satu model minimum yang berdaya guna untuknya. Dan yang paling penting, ia model minimum yang sama bagi setiap pelanggan yang mempunyai kerja itu, bermakna penilaiannya cukup dijalankan sekali dan kosnya dilunaskan merentas semua orang.
Itulah keseluruhan hujah ekonomi bagi kategori ini, dan ia berbaloi dinyatakan sebagai satu peraturan: semakin sempit kerjanya, semakin banyak bahagian keputusan model yang boleh diserap oleh orang lain bagi pihak anda. Sebuah vendor yang melayani satu beban kerja mampu menguji kesemua 10 calon kerana ia mengujinya sekali, untuk beribu-ribu pelanggan, terhadap satu takrif hasil yang baik yang tetap. Anda menguji lima, untuk diri sendiri, terhadap satu takrif yang anda sendiri terpaksa cipta, ialah cara mahal untuk mendapat jawapan yang lebih buruk.
Pertukaran ini nyata dan berbaloi dinamakan dengan jujur. Anda melepaskan kawalan langsung ke atas model mana yang menjalankan kerja anda. Sebagai pertukaran, anda berhenti menjalankan penilaian, berhenti menjejaki kalendar pelancaran, dan apa yang anda nilai ialah outputnya — satu-satunya perkara yang sememangnya anda pedulikan sejak awal.
Cara mengenal pasti susunan mana yang anda beli
Sebelum pembelian AI anda yang seterusnya, empat soalan mengikut urutan:
- Adakah kerja itu tertutup? Bolehkah anda menyatakan dalam satu ayat rupa sebuah output yang betul? Jika ya, sebuah alat menegak terurus boleh memiliki keputusan itu. Jika jawapannya "bergantung apa yang kami minta", anda sedang membeli sebuah model am dan penilaian itu kekal milik anda.
- Siapa menguji semula apabila model baharu keluar? Tanya vendor secara terus. Sebuah vendor terurus sepatutnya mampu menerangkan set penilaian dan proses penukarannya. Jika jawapannya anda akan "mendapat capaian kepada model terkini", anda membeli paip, bukan pertimbangan.
- Apa yang ditunjukkan kepada anda — sebuah model atau sebuah hasil? Jika produk itu memaparkan nama model, tetingkap konteks dan harga token, ia sedang memulangkan keputusan itu kepada anda. Itu produk yang sah, tetapi tetapkan harganya mengikut kenyataan tersebut.
- Bagaimana rupa jumlah kos pada volum anda? Harga setiap token, didarab token yang benar-benar digunakan pada kerja anda, didarab bilangan percubaan sehingga betul. Jalankan tugasan anda sendiri. Halaman harga tidak dapat menjawabnya.
Kesimpulannya: frontier ialah nilai lalai, bukan keputusan
Model fatigue lazimnya digambarkan sebagai masalah perhatian — terlalu banyak berita, terlalu pantas. Ia bukan. Ia satu kos yang dipindahkan secara senyap oleh pasaran paling pantas berkembang dalam teknologi kepada pelanggannya, tempat ia terletak tanpa harga dan sebahagian besarnya tanpa diukur.
Makmal akan terus melancarkan, kerana melancarkan itulah kerja mereka dan pasaran membayarnya. Beban penilaian akan terus membesar, kerana ia membesar secara mekanikal dengan setiap pelancaran. Dan kebanyakan pasukan akan terus menyelesaikannya dengan satu-satunya cara yang mampu dilakukan pasukan yang sibuk: mencapai model yang paling baharu, paling besar, paling mahal — satu-satunya pilihan yang tidak perlu dipertahankan sesiapa dalam mesyuarat.
Setiap perisian yang mengambil sesuatu kerja sepenuhnya daripada tangan anda — dan tidak pernah menunjukkan nama model kepada anda — ialah satu pertaruhan bahawa cara di atas itu satu cara yang buruk untuk menjalankan perniagaan. Pertaruhan itu kelihatan makin baik setiap minggu pelancaran.
Di mana Telli.sh berada: inilah kategori tempat kami membina. Telli.sh merakam mesyuarat, mengasingkan penutur, menterjemah merentas 15 bahasa secara masa nyata, dan menghasilkan ringkasan serta senarai tindakan — dan ia tidak pernah bertanya model mana yang hendak digunakan, kerana itu kerja kami, bukan kerja anda. Sambungan pelayar kami memang menawarkan sembilan enjin terjemahan termasuk satu pilihan yang sepenuhnya pada peranti, untuk mereka yang benar-benar mahukan kawalan itu; produk mesyuarat sengaja tidak berbuat demikian, kerana "salin mesyuarat ini dengan baik" ialah tugasan tertutup dan kami lebih suka dinilai berdasarkan transkrip berbanding model di sebaliknya.
Rakam mesyuarat anda yang seterusnya dan biar orang lain memilih modelnya
Sumber
- CNBC, "'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace", 6 September 2026 — kronologi pelancaran bagi 1–3 September 2026; petikan Zhen Lu bahawa "model fatigue memang wujud"; kenyataan Sam Altman tentang "kadens yang lebih pantas"; Ahmed Abbasi tentang "permainan bahagian dompet" dan penilaian persendirian hampir AS$1 trilion; Noah Faro tentang keluaran titik serta tentang Fable 5 dan Kimi K3 sebagai dua pelancaran terakhir yang menggerakkan jarum; dan angka Suresh Vasudevan, lima daripada sepuluh model dinilai. Sumbangan laporan oleh Kate Rooney dan MacKenzie Sigalos; dicapai pada 8 September 2026
- Moe Khalil, "Model Fatigue is Real", 4 September 2026 — hujah "tiada insentif untuk memberitahu saya bila model yang lebih murah akan berfungsi"; kerangka model minimum yang berdaya guna bagi tugasan tertutup; dan penemuan terukur bahawa model yang lebih kuat dan lebih mahal menyelesaikan tugasan yang lebih sukar dengan sepersekian kos model yang lebih murah. Khalil mendedahkan dalam tulisannya bahawa dia jurutera produk di LiteLLM, yang membina auto router; dicapai pada 8 September 2026
- Gartner, "Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026", 19 Mei 2026 — perbelanjaan AI sedunia sebanyak AS$2.59 trilion pada 2026, kenaikan 47% berbanding tahun sebelumnya, dengan infrastruktur AI sebagai segmen terbesar
- MindStudio, "Local AI Model Fatigue: Why One Setup Beats Chasing Every Release" — gambaran treadmill bagi kitaran pelancaran model kecil setempat dan hujah untuk menyeragamkan diri pada satu susunan harian yang terbukti
- AI타임스, "[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'", 7 September 2026 — liputan berbahasa Korea yang mengetengahkan laporan CNBC dan komentar pembangun di sekitarnya
- Bacaan kami tentang pengambilalihan Hugging Face oleh NVIDIA — pengumuman lain pada minggu yang sama, dan lapisan pengedaran di bawah setiap model yang dinamakan di sini
- Cara mengukur ketepatan transkripsi pada beban kerja anda sendiri — berapa kos sebuah penilaian sebenar apabila anda menjalankannya dengan betul