Quattro modelli di frontiera in tre giorni, e nessuno vi dirà quale vi serviva
Tra il 1º e il 3 settembre 2026 Anthropic, Meta, Google e OpenAI hanno rilasciato tutti modelli di frontiera, e la CNBC ha dato un nome alla stanchezza che ne è seguita: model fatigue. Il numero dei rilasci è la parte noiosa. La parte interessante è che ogni rilascio crea una valutazione che qualcuno, a valle, dovrà eseguire, e le aziende che li pubblicano non hanno alcun motivo per aiutarvi a saltarla. Quanto costa davvero un cambio di modello, perché più economico per token non significa più economico per compito, e perché un software completamente gestito e costruito per un solo lavoro preciso è l'unico assetto in cui qualcun altro può decidere al posto vostro.
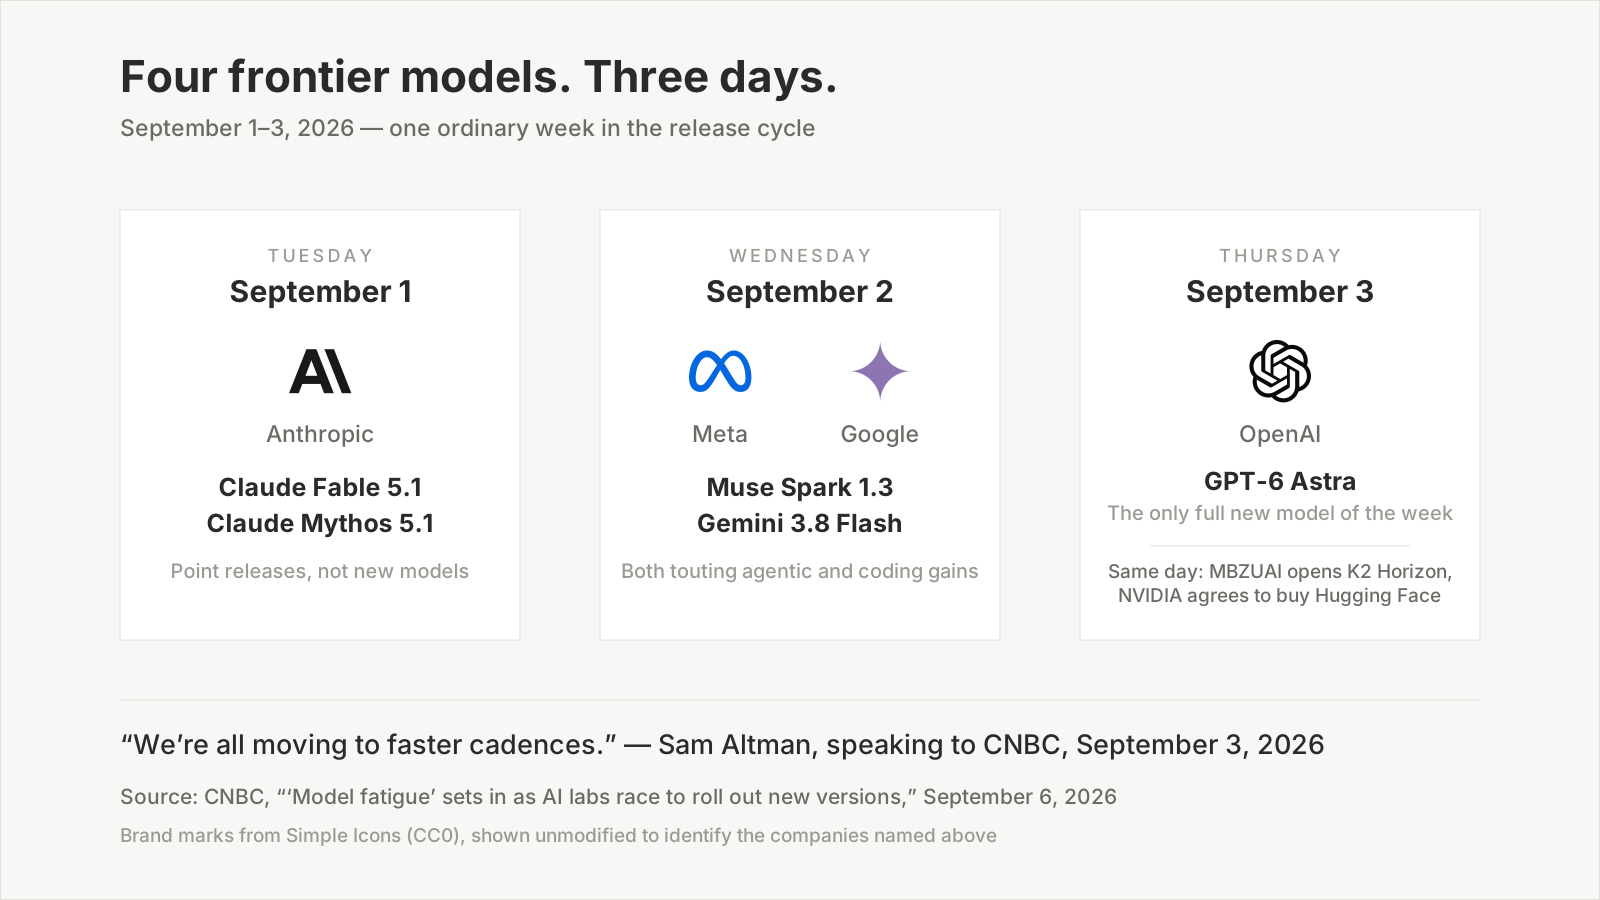
Marchi da Simple Icons (CC0), mostrati senza modifiche per identificare le aziende citate. Date di rilascio e citazione di Altman da CNBC, 6 settembre 2026.
Tra martedì e giovedì della prima settimana di settembre 2026, Anthropic ha rilasciato Claude Fable 5.1 e Claude Mythos 5.1, Meta ha rilasciato Muse Spark 1.3, Google ha rilasciato Gemini 3.8 Flash e OpenAI ha rilasciato GPT-6 Astra. Quello stesso giovedì la Mohamed bin Zayed University of Artificial Intelligence di Abu Dhabi ha aperto al mondo la famiglia K2 Horizon, e NVIDIA ha accettato di comprare Hugging Face per 12.930.300.000 dollari.
Sei annunci. Tre giorni. La CNBC ha pubblicato il pezzo domenica 6 settembre sotto un'espressione che circolava da settimane tra gli addetti ai lavori: model fatigue.
La lettura ovvia è che il settore corre più veloce di quanto chiunque riesca a seguire. Quella lettura è vera, e in gran parte poco interessante. Ecco la parte che merita la vostra attenzione: ogni rilascio trasferisce un costo, e il trasferimento va in una direzione soltanto. Ogni modello che un laboratorio pubblica diventa una valutazione che qualcuno, a valle, deve eseguire, e nessuno a monte ha il benché minimo motivo di aiutarvi a saltarla.
TL;DR
- Quattro rilasci di frontiera in tre giorni (1º–3 settembre 2026); la CNBC ha battezzato la stanchezza che ne è seguita «model fatigue» il 6 settembre.
- Il costo vero non è l'attenzione, è il lavoro di valutazione. Un amministratore delegato del settore ha detto alla CNBC che quando il suo team vuole valutare 10 modelli per un compito, ne prova circa 5.
- Il prezzo per token è un pessimo indicatore del costo per compito: un modello più potente e più caro può portare a termine lavori più difficili spendendo meno, perché fa meno passaggi.
- I fornitori di modelli non hanno alcun interesse strutturale a dirvi quando basterebbe un modello più economico. Quel vuoto è per intero la ragione per cui esiste il software gestito e costruito su misura.
La model fatigue ha avuto un nome il 6 settembre
«Ho la sensazione che la model fatigue sia una cosa reale», ha detto alla CNBC Zhen Lu, amministratore delegato di Runpod, startup di infrastrutture per l'IA. «Non fraintendetemi, sono entusiasta di tutta l'innovazione che sta accadendo, ma penso davvero che siamo in un contesto con così tanta schiuma che bisogna fare rumore.»
Nella stessa settimana Sam Altman ha offerto alla CNBC un inquadramento più morbido: «ci stiamo spostando tutti verso cadenze più rapide», ha detto, attribuendo parte dell'accelerazione al fatto che tutti sono «tornati dalle vacanze estive».
Le due cose possono essere entrambe vere. La cadenza sta davvero accelerando, e l'accelerazione è davvero in parte messinscena. Ahmed Abbasi, docente alla Mendoza School of Business di Notre Dame con 25 anni di IA alle spalle, ha esposto la logica commerciale senza giri di parole: i laboratori stanno «giocando tutti la partita della quota di portafoglio». Anthropic e OpenAI spingono più forte di tutti mentre si avvicinano ai mercati pubblici, e gli investitori privati valutano già ciascuna delle due vicino a 1.000 miliardi di dollari.
Il portafoglio in questione è enorme. A maggio 2026 Gartner prevedeva che la spesa mondiale in IA avrebbe raggiunto quest'anno 2.590 miliardi di dollari, con un aumento del 47% rispetto al 2025. La quota maggiore va alle infrastrutture, ma ben più di 1.000 miliardi di dollari finiscono in servizi, software, sicurezza, modelli e strumenti: cioè in decisioni che qualcuno deve prendere.
Ecco il punto: un mercato di quelle dimensioni, che cresce a quella velocità, premia chi fa rumore. Non premia chi dice ai clienti che potrebbero cavarsela con meno.
Il costo non è l'attenzione. È la valutazione che non riuscite a finire
Chiedete a un professionista come si sente davvero la model fatigue e non vi risponderà «leggo troppi post di lancio». Vi risponderà con l'aritmetica.
Suresh Vasudevan, amministratore delegato di Clockwork Systems, startup di IA per le imprese, ha dato alla CNBC il numero più utile dell'intero pezzo. Se la sua azienda vuole valutare 10 modelli di IA per un compito specifico, ha detto, può darsi che ne scelga cinque. «È davvero difficile andare a valutare ognuno di quelli che stanno uscendo adesso.»
Fermatevi un attimo su quel rapporto, perché è il fatto portante di tutta la questione. Un'azienda il cui mestiere è l'IA per le imprese, con persone che lo fanno di professione e con un budget di calcolo stanziato esattamente per questo, valuta metà dei candidati che essa stessa ritiene degni di valutazione.
Chiamiamo l'altra metà i cinque mai provati. Non sono stati scartati. Nessuno li ha trovati insufficienti. Semplicemente non sono mai stati eseguiti, e così la domanda se uno di loro sarebbe stato più veloce, più economico o più accurato sul vostro carico di lavoro specifico resta aperta per sempre. Ogni settimana di rilasci aggiunge qualcosa a quella pila.
E smaltire la pila costa, perché cambiare modello non è alzare un numero di versione. È una riqualificazione. Ecco che cosa deve succedere davvero prima che un modello nuovo arrivi in produzione:
| Che cosa va ricontrollato | Perché un modello nuovo lo rompe |
|---|---|
| Prompt e istruzioni di sistema | Sono tarati sulle manie del vecchio modello; una formulazione che ne guidava uno in modo affidabile può portarne un altro altrove |
| Stabilità del formato di output | I parser a valle dipendono dalla forma — JSON, intestazioni, delimitatori — e le abitudini di formattazione cambiano da modello a modello |
| Accuratezza sui vostri dati reali | Gli scarti nei benchmark si misurano su set pubblici, non sulle vostre riunioni, i vostri ticket, il vostro codice |
| Comportamento con strumenti e API | I modelli agentici differiscono su quando chiamano, quanto spesso riprovano e cosa fanno quando una chiamata fallisce |
| Latenza e throughput sotto carico | Un modello più veloce su una singola richiesta può essere più lento dietro i vostri limiti di frequenza |
| Costo totale al vostro volume | Prezzo per token per token consumati per tentativi: vedi sotto |
| Sicurezza e comportamento di rifiuto | I confini si spostano tra una versione e l'altra, in entrambe le direzioni |
| Casi di regressione | Esattamente i guasti che avete già sistemato, di cui nessun benchmark altrui sa nulla |
Otto categorie, ciascuna con esempi reali, un'esecuzione di confronto e il giudizio di qualcuno. È un progetto, non una modifica di configurazione. Moltiplicatelo per il numero di rilasci di frontiera di un mese qualsiasi e la ragione del rapporto 10 a 5 diventa evidente.
Abbiamo scritto un pezzo intero su come misurarlo sul vostro carico di lavoro invece di fidarvi di una classifica, e il riassunto onesto è che farlo per bene richiede giorni, non ore.
Più economico per token non è più economico per compito
Il risultato più controintuitivo di tutta questa storia non è arrivato da un laboratorio ma da un ingegnere che stava cercando di automatizzare la scelta.
Moe Khalil, product engineer del gateway per l'IA open source LiteLLM, ha pubblicato il 4 settembre un post intitolato «Model Fatigue is Real». Lavora all'auto router di LiteLLM — software il cui unico mestiere è scegliere un modello al posto vostro — e ha dichiarato quell'affiliazione fin dall'inizio, cosa che la maggior parte di chi scrive su questo tema non fa.
L'assunto di partenza del suo team era quello intuitivo. Prendete due modelli capaci entrambi di risolvere un compito; quello che secondo la scheda costa la metà per token dovrebbe risolverlo per circa la metà del prezzo.
I test hanno mostrato altro. Il modello più potente e più caro risolveva i compiti più difficili a una frazione del costo di quello economico. La spiegazione di Khalil: «Poiché era più intelligente, adottava un approccio più intelligente e arrivava al prodotto finito molto più in fretta.»
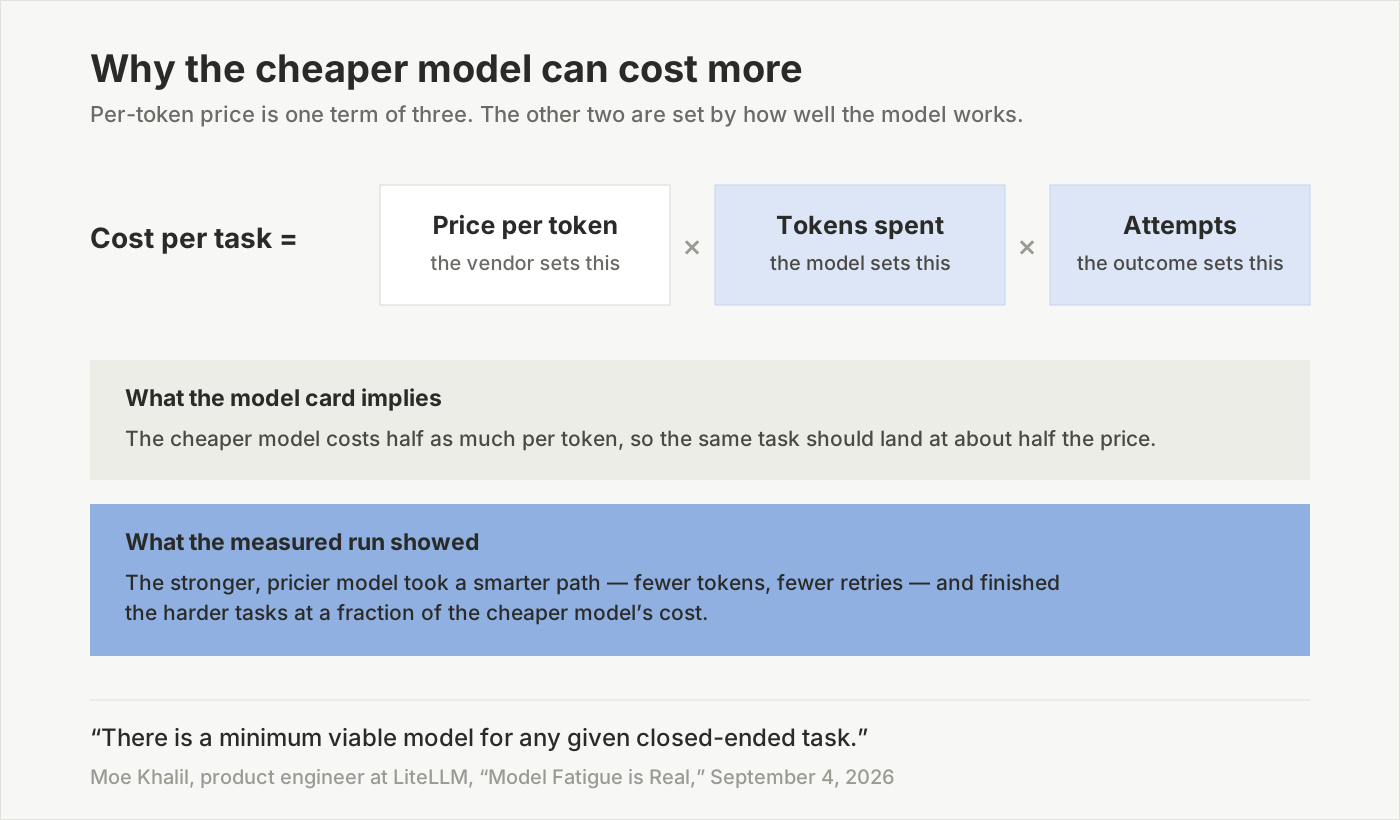
Dei tre termini, il prezzo per token è l'unico che compare su una pagina dei prezzi. Gli altri due sono proprietà della competenza del modello, e si manifestano solo quando mandate in esecuzione il lavoro.
Questo ridefinisce del tutto la pagina dei prezzi. Il numero che un fornitore pubblicizza è un fattore in un prodotto di tre: prezzo per token, token spesi e tentativi finché il compito riesce davvero. Il primo lo fissa il fornitore. Il secondo e il terzo li fissa il modello stesso, e nessuno dei due è conoscibile prima di averci fatto passare il vostro lavoro.
Il che significa che il confronto che vi hanno insegnato a fare — scorrere la colonna dei prezzi, prendere quello economico — non è soltanto incompleto. Su compiti reali può indicare la direzione sbagliata.
A monte nessuno ha interesse a dirvelo
Khalil dice poi la parte che di solito si tace, ed è la frase più affilata scritta quest'anno sull'argomento:
«Per le aziende dei modelli questa pigrizia è una funzionalità, non un difetto. Preferiscono che io usi [il modello di punta] per riassumere le mie email, e non hanno alcun incentivo a dirmi quando un modello più economico funzionerebbe altrettanto bene. Il loro mestiere è continuare a spingere la frontiera. Capire quando non usare la frontiera è lasciato a me.»
Rileggetelo con in testa il numero di Gartner. Un mercato da 2.590 miliardi di dollari, in crescita del 47% l'anno, in cui i fornitori traggono beneficio da ogni cliente che per default sale di fascia e non sostengono alcun costo quando i clienti spendono troppo.
Non è un complotto e non richiede che qualcuno si comporti male. È semplicemente la forma che ha il gradiente degli incentivi. Il mestiere di un laboratorio di frontiera è spostare la frontiera. Dirvi che il modello di fascia media dell'anno scorso gestisce l'80% del vostro carico di lavoro è il mestiere di qualcun altro, e fino a poco fa non era il mestiere di nessuno.
Anche la seconda osservazione di Abbasi appartiene a questo punto. Ha suggerito che «non è una coincidenza» che tutti i grandi sviluppatori abbiano annunciato nella stessa settimana, e Noah Faro, responsabile tecnologico della startup di finanza con IA Farsight, ha concordato, notando che i rivali leggono i piani altrui anche dalla disponibilità di capacità di calcolo in cloud, dato che competono tutti per la capacità della stessa manciata di fornitori. Faro ha aggiunto anche l'osservazione che sgonfia: a differenza di GPT-6 Astra, i lanci di Anthropic, Meta e Google di quella settimana erano release intermedie, aggiornamenti di modelli esistenti anziché modelli nuovi. Nella sua valutazione, gli ultimi due rilasci che hanno davvero spostato l'ago sono stati Fable 5 di Anthropic a giugno e Kimi K3 di Moonshot AI a luglio.
Dunque: sei annunci, un modello di frontiera genuinamente nuovo e un intero ciclo di valutazione di lavoro generato per tutti quelli a valle.
Due modi in cui il settore sta assorbendo tutto questo, e non sono la stessa cosa
Se i laboratori non prendono la decisione, qualcuno deve prenderla. Sono emerse due risposte, ed è una differenza strutturale.
La risposta orizzontale è il routing. Gateway come LiteLLM mettono ogni modello dietro un'unica chiave API e provano a scegliere richiesta per richiesta. Khalil descrive il problema tecnico con precisione: per ogni compito chiuso esiste un modello minimo funzionante — il più economico che ancora riesce — e la difficoltà sta nel prevedere quale sia prima che il compito venga eseguito. L'approccio migliore che il suo team ha oggi lo deduce da dati di benchmark pubblici più euristiche nel prompt; hanno provato anche la classificazione con LLM e soluzioni ibride. Il suo verdetto: «Tutto ancora imperfetto, ma un gradino sopra il niente.»
Il routing è ingegneria vera e aiuta. Ma osservate che cosa sposta e che cosa no. Assorbe l'idraulica: una chiave, un'interfaccia, accesso automatico ai modelli nuovi. Non assorbe la responsabilità. Quando il router sbaglia, l'output cattivo resta vostro, nel vostro prodotto, davanti al vostro utente. Valutare se la risposta fosse buona spetta ancora a voi.
La risposta verticale è il software completamente gestito costruito per un solo lavoro. Qui il fornitore non instrada tra modelli per conto vostro; vi toglie di mano il compito per intero e consegna un risultato finito. Non vedete un nome di modello. Vedete una trascrizione, un riassunto, una traduzione, una nota spese depositata.
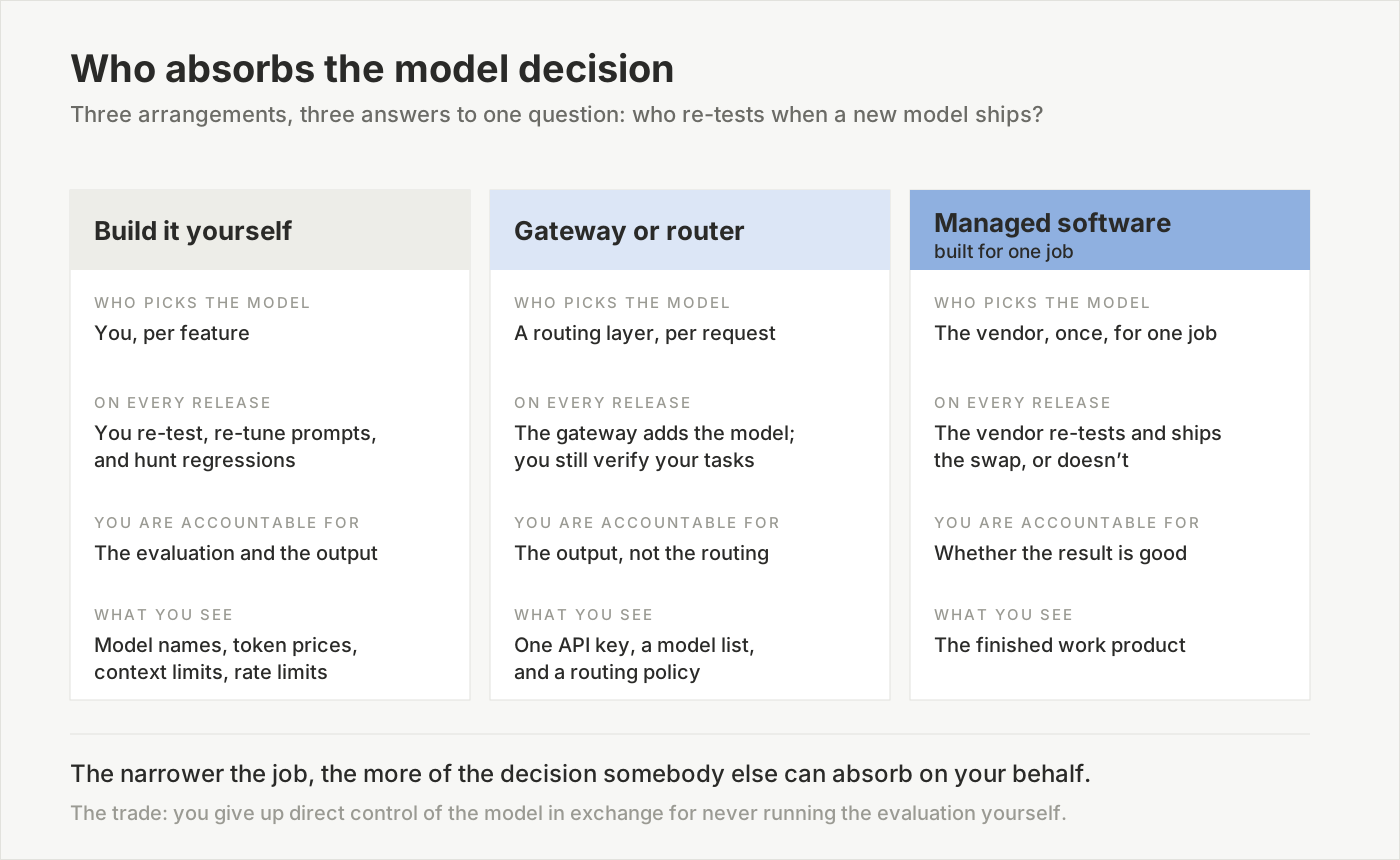
Più si va verso destra, meno decisione resta a voi, e più dipendete dal fatto che il fornitore abbia svolto la valutazione onestamente.
La comunità dell'IA locale è arrivata a una conclusione simile dalla direzione opposta. Un'analisi pubblicata quest'anno descriveva la scena dei modelli piccoli come un tapis roulant: scaricare, configurare, lanciare qualche prompt, giudicare a metà, passare al rilascio successivo. La raccomandazione era di smettere: standardizzarsi su una configurazione quotidiana collaudata e adottare un modello nuovo solo dopo averlo provato abbastanza a lungo su compiti reali e rappresentativi da confermare che è davvero migliore per il vostro carico di lavoro specifico. Stessa conclusione, raggiunta da un appassionato con due GPU e da un amministratore delegato con un budget di calcolo: scegliete una volta, per bene, e smettete di rimettere tutto in discussione ogni giovedì.
Perché è la ristrettezza del lavoro a rendere assorbibile la decisione
Ecco la nostra posizione, ed è la ragione per cui questa categoria esiste.
La decisione sul modello può prenderla solo chi conosce il compito. Sembra banale. Non lo è, perché esclude quasi tutti.
Un'interfaccia di chat generalista non può decidere per voi, perché in una mattina qualsiasi le si può chiedere di scrivere un sonetto, di fare il debug di una race condition o di riassumere un contratto d'affitto. Non esiste un modello minimo funzionante per «qualunque cosa l'utente digiti adesso». L'unico default sicuro è il modello più potente disponibile: esattamente il default che serve gli interessi del fornitore, ed esattamente quello da cui, dice Khalil, nessuno ha interesse a dissuadervi.
Un gateway può indovinare meglio, perché vede il prompt. Ma lo vede senza sapere che aspetto abbia una buona risposta nel vostro dominio, e senza conseguenze se sbaglia.
Il software gestito costruito su misura occupa una posizione del tutto diversa. Quando il lavoro è fissato — trascrivere una riunione di 60 minuti con quattro interlocutori che passano dall'italiano all'inglese e poi produrre le azioni da svolgere — il compito è chiuso esattamente nel senso di Khalil. Per esso esiste un modello minimo funzionante. E, aspetto decisivo, è lo stesso modello minimo funzionante per ogni cliente che ha quel lavoro: la valutazione va eseguita una volta sola e il suo costo si ammortizza su tutti.
È tutto qui l'argomento economico della categoria, e vale la pena enunciarlo come regola: più il lavoro è ristretto, maggiore è la parte di decisione sul modello che qualcun altro può assorbire per voi. Un fornitore che serve un solo carico di lavoro può permettersi di testare tutti e 10 i candidati, perché li testa una volta, per migliaia di clienti, rispetto a una definizione fissa di buon risultato. Che ne testiate cinque voi, da soli, rispetto a una definizione che dovete pure inventarvi, è il modo costoso per ottenere una risposta peggiore.
Lo scambio è reale e merita di essere detto con onestà. Rinunciate al controllo diretto su quale modello esegue il vostro lavoro. In cambio smettete di eseguire la valutazione, smettete di seguire i calendari dei rilasci, e ciò che giudicate è l'output: da sempre l'unica cosa che vi interessava davvero.
Come capire quale assetto state comprando
Prima del vostro prossimo acquisto di IA, quattro domande in ordine:
- Il lavoro è chiuso? Riuscite a dire in una frase che aspetto ha un output corretto? Se sì, uno strumento verticale gestito può prendersi la decisione. Se la risposta è «dipende da che cosa gli chiediamo», state comprando un modello generalista e la valutazione resta vostra.
- Chi ripete i test quando esce un modello nuovo? Chiedetelo direttamente al fornitore. Un fornitore gestito dovrebbe saper descrivere il proprio set di valutazione e il processo di sostituzione. Se la risposta è che avrete «accesso ai modelli più recenti», avete comprato idraulica, non giudizio.
- Che cosa vi viene mostrato, un modello o un risultato? Se il prodotto espone nomi di modelli, finestre di contesto e prezzi per token, vi sta restituendo la decisione. È un prodotto legittimo, ma valutatelo di conseguenza.
- Quanto fa il costo totale al vostro volume? Prezzo per token, per i token effettivamente consumati sul vostro lavoro, per i tentativi necessari a farlo bene. Eseguite i vostri compiti. La pagina dei prezzi non può rispondere.
In conclusione: la frontiera è un default, non una decisione
La model fatigue viene di solito descritta come un problema di attenzione: troppe notizie, troppo in fretta. Non lo è. È un costo che il mercato in più rapida crescita della tecnologia ha spostato silenziosamente sui propri clienti, dove resta senza prezzo e in larga parte non misurato.
I laboratori continueranno a rilasciare, perché rilasciare è il loro mestiere e il mercato lo paga. Il carico di valutazione continuerà a crescere, perché cresce meccanicamente a ogni rilascio. E la maggior parte dei team continuerà a risolverlo nell'unico modo possibile per un team impegnato: allungando la mano verso il modello più nuovo, più grande e più costoso, l'unica opzione che nessuno deve difendere in riunione.
Ogni software che vi toglie di mano un lavoro per intero, e non vi mostra mai un nome di modello, è una scommessa sul fatto che quello sia un cattivo modo di condurre un'attività. La scommessa appare migliore a ogni settimana di rilasci.
Dove si colloca Telli.sh: è la categoria in cui costruiamo. Telli.sh registra le riunioni, separa gli interlocutori, traduce in tempo reale in 15 lingue e produce riassunti e azioni da svolgere, e non vi chiede mai quale modello usare, perché quello è il nostro mestiere, non il vostro. La nostra estensione per browser offre invece nove motori di traduzione, inclusa un'opzione interamente sul dispositivo, per chi quel controllo lo vuole davvero; il prodotto per le riunioni deliberatamente non lo fa, perché «trascrivere bene questa riunione» è un compito chiuso e preferiamo essere giudicati sulla trascrizione anziché sul modello che c'è dietro.
Registrate la vostra prossima riunione e lasciate scegliere il modello a qualcun altro
Fonti
- CNBC, «'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace», 6 settembre 2026 — la cronologia dei rilasci dal 1º al 3 settembre 2026; la citazione di Zhen Lu sul fatto che «la model fatigue è una cosa reale»; l'osservazione di Sam Altman sulle «cadenze più rapide»; Ahmed Abbasi sulla «partita della quota di portafoglio» e sulle valutazioni private vicine a 1.000 miliardi di dollari; Noah Faro sulle release intermedie e su Fable 5 e Kimi K3 come gli ultimi due che hanno spostato l'ago; e la cifra di Suresh Vasudevan, cinque modelli valutati su dieci. Con il contributo di Kate Rooney e MacKenzie Sigalos; consultato l'8 settembre 2026
- Moe Khalil, «Model Fatigue is Real», 4 settembre 2026 — l'argomento del «nessun incentivo a dirmi quando basterebbe un modello più economico»; l'inquadramento del modello minimo funzionante per i compiti chiusi; e il riscontro misurato che il modello più potente e più caro risolveva compiti più difficili a una frazione del costo di quello economico. Khalil ha dichiarato nel post di essere product engineer di LiteLLM, che sviluppa un auto router; consultato l'8 settembre 2026
- Gartner, «Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026», 19 maggio 2026 — spesa mondiale in IA di 2.590 miliardi di dollari nel 2026, in crescita del 47% su base annua, con le infrastrutture per l'IA come segmento maggiore
- MindStudio, «Local AI Model Fatigue: Why One Setup Beats Chasing Every Release» — la descrizione a tapis roulant del ciclo di rilasci dei piccoli modelli locali e la tesi di standardizzarsi su una configurazione quotidiana collaudata
- AI타임스, «[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'», 7 settembre 2026 — la copertura in coreano che ha rilanciato il pezzo della CNBC e i commenti degli sviluppatori attorno a esso
- La nostra lettura dell'acquisizione di Hugging Face da parte di NVIDIA — l'altro annuncio della stessa settimana, e il livello di distribuzione sotto ogni modello citato qui
- Come misurare l'accuratezza della trascrizione sul proprio carico di lavoro — quanto costa una valutazione vera, quando la si fa per bene