Empat model frontier dalam tiga hari, dan tak seorang pun akan memberi tahu Anda mana yang Anda butuhkan
Antara 1 dan 3 September 2026, Anthropic, Meta, Google, dan OpenAI sama-sama merilis model frontier, dan CNBC memberi nama pada kelelahan yang muncul: model fatigue. Jumlah rilis adalah bagian yang membosankan. Bagian yang menarik adalah setiap rilis menciptakan evaluasi yang harus dijalankan seseorang di hilir, sementara perusahaan yang merilisnya sama sekali tidak punya alasan untuk membantu Anda melewatinya. Tulisan ini membedah berapa biaya sebenarnya dari mengganti model, mengapa lebih murah per token bukan berarti lebih murah per tugas, dan mengapa perangkat lunak terkelola penuh yang dibangun untuk satu pekerjaan sempit adalah satu-satunya susunan di mana orang lain bisa memutuskan untuk Anda.
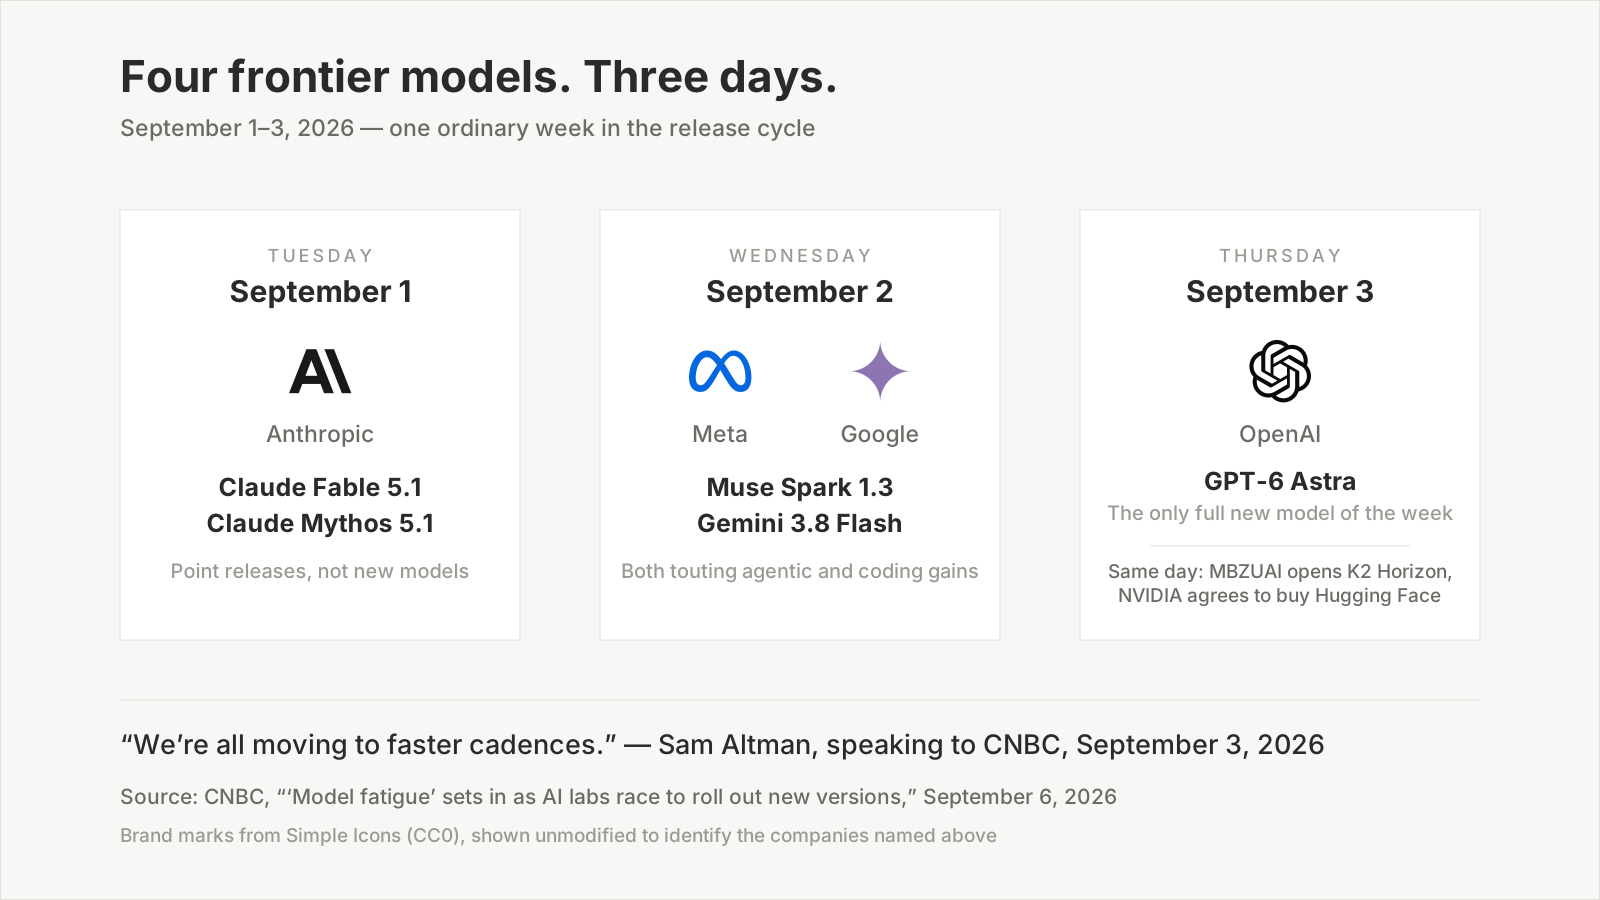
Logo merek dari Simple Icons (CC0), ditampilkan tanpa modifikasi untuk mengidentifikasi perusahaan yang disebut. Tanggal rilis dan kutipan Altman dari CNBC, 6 September 2026.
Antara Selasa dan Kamis pada pekan pertama September 2026, Anthropic merilis Claude Fable 5.1 dan Claude Mythos 5.1, Meta merilis Muse Spark 1.3, Google merilis Gemini 3.8 Flash, dan OpenAI merilis GPT-6 Astra. Pada Kamis yang sama, Mohamed bin Zayed University of Artificial Intelligence di Abu Dhabi membuka keluarga K2 Horizon untuk publik, dan NVIDIA sepakat membeli Hugging Face seharga US$12.930.300.000.
Enam pengumuman. Tiga hari. CNBC menurunkan laporannya pada Minggu, 6 September, di bawah sebuah frasa yang sudah berminggu-minggu beredar di kalangan praktisi: model fatigue.
Pembacaan yang paling gampang adalah bahwa industri ini bergerak lebih cepat daripada kemampuan siapa pun mengikutinya. Pembacaan itu benar, dan sebagian besar tidak menarik. Ini bagian yang layak mendapat perhatian Anda: setiap rilis memindahkan biaya, dan perpindahannya berjalan tepat ke satu arah. Setiap model yang dirilis sebuah lab berubah menjadi evaluasi yang harus dijalankan seseorang di hilir — dan tak seorang pun di hulu punya alasan sedikit pun untuk membantu Anda melewatinya.
TL;DR
- Empat rilis frontier mendarat dalam tiga hari (1–3 September 2026); pada 6 September CNBC menamai kelelahan yang muncul sebagai "model fatigue".
- Biaya sesungguhnya bukan perhatian, melainkan kerja evaluasi. Seorang CEO perusahaan AI korporat memberi tahu CNBC bahwa ketika timnya ingin menilai 10 model untuk sebuah tugas, mereka menguji sekitar 5.
- Harga per token adalah proksi yang buruk untuk biaya per tugas — model yang lebih kuat dan lebih mahal bisa menyelesaikan pekerjaan yang lebih sulit dengan biaya lebih rendah karena menempuh lebih sedikit langkah.
- Secara struktural, vendor model tidak berminat memberi tahu Anda kapan model yang lebih murah sudah cukup. Celah itulah seluruh alasan keberadaan perangkat lunak terkelola yang dibangun untuk tujuan khusus.
Model fatigue mendapat namanya pada 6 September
"Saya merasa model fatigue itu nyata," kata Zhen Lu, CEO startup infrastruktur AI Runpod, kepada CNBC. "Jangan salah paham, saya sangat bersemangat dengan semua inovasi yang sedang terjadi, tapi saya benar-benar berpikir kita berada di lingkungan dengan begitu banyak buih sehingga Anda harus membuat kebisingan."
Pada pekan yang sama Sam Altman menawarkan bingkai yang lebih lembut kepada CNBC: "kita semua sedang beralih ke kadensi yang lebih cepat," katanya, dan mengaitkan sebagian percepatan itu dengan semua orang yang "kembali dari liburan musim panas".
Keduanya bisa benar. Kadensinya memang benar-benar dipercepat, dan percepatan itu memang benar-benar sebagian adalah pertunjukan. Ahmed Abbasi, guru besar di Mendoza School of Business, Notre Dame, dengan 25 tahun di bidang AI, menyampaikan logika komersialnya secara blak-blakan: para lab "semuanya sedang memainkan permainan pangsa dompet". Anthropic dan OpenAI mendorong paling keras saat melaju menuju pasar publik, dan investor swasta sudah menilai masing-masing mendekati US$1 triliun.
Dompet yang dimaksud sangat besar. Pada Mei 2026 Gartner memperkirakan belanja AI dunia akan mencapai US$2,59 triliun tahun ini, naik 47% dibandingkan 2025. Infrastruktur mengambil porsi terbesar, tetapi jauh lebih dari US$1 triliun jatuh ke layanan, perangkat lunak, keamanan, model, dan perkakas — artinya jatuh ke keputusan-keputusan yang harus diambil seseorang.
Inilah intinya: pasar sebesar itu, yang tumbuh secepat itu, memberi imbalan pada kegaduhan. Ia tidak memberi imbalan pada memberi tahu pelanggan bahwa mereka bisa cukup dengan yang lebih sedikit.
Biayanya bukan perhatian. Biayanya adalah evaluasi yang tak bisa Anda tuntaskan
Tanyakan pada seorang praktisi bagaimana model fatigue sebenarnya terasa, dan Anda tidak akan mendengar "saya membaca terlalu banyak pengumuman rilis". Anda akan mendengar aritmetika.
Suresh Vasudevan, CEO startup AI korporat Clockwork Systems, memberi CNBC angka paling berguna dalam seluruh laporan itu. Jika perusahaannya ingin mengevaluasi 10 model AI untuk sebuah tugas tertentu, katanya, mungkin ia hanya akan memilih lima. "Sungguh menantang untuk pergi dan mengevaluasi setiap model yang keluar saat ini."
Berhentilah sejenak pada rasio itu, karena itulah fakta yang menyangga seluruh topik ini. Sebuah perusahaan yang bisnisnya memang AI korporat, diisi orang-orang yang mengerjakan ini secara profesional, dengan anggaran komputasi yang dialokasikan persis untuk keperluan ini, hanya mengevaluasi separuh kandidat yang ia sendiri anggap layak dievaluasi.
Sebut separuh sisanya lima yang tak pernah diuji. Mereka tidak ditolak. Tidak ada yang menemukan mereka kurang. Mereka hanya tidak pernah dijalankan, sehingga pertanyaan apakah salah satunya akan lebih cepat, lebih murah, atau lebih akurat pada beban kerja spesifik Anda akan terbuka selamanya. Setiap pekan rilis menambah tumpukan itu.
Dan tumpukan itu mahal untuk dibereskan, sebab mengganti model bukan menaikkan versi. Itu kualifikasi ulang. Inilah yang benar-benar harus terjadi sebelum sebuah model baru sampai ke produksi:
| Yang harus diperiksa ulang | Mengapa model baru merusaknya |
|---|---|
| Prompt dan instruksi sistem | Disetel terhadap kebiasaan model lama; frasa yang mengarahkan satu model dengan andal bisa mengarahkan model lain ke tempat lain |
| Stabilitas format keluaran | Parser di hilir bergantung pada bentuk — JSON, judul, pembatas — sementara kebiasaan pemformatan bergeser antarmodel |
| Akurasi pada data nyata Anda | Selisih benchmark diukur pada himpunan publik, bukan pada rapat Anda, tiket Anda, basis kode Anda |
| Perilaku perkakas dan API | Model agentik berbeda dalam kapan memanggil, seberapa sering mencoba ulang, dan apa yang dilakukan saat panggilan gagal |
| Latensi dan throughput di bawah beban | Model yang lebih cepat pada satu permintaan bisa lebih lambat di balik batas laju Anda |
| Biaya total pada volume Anda | Harga per token dikali token yang terpakai dikali jumlah percobaan — lihat di bawah |
| Keamanan dan perilaku penolakan | Batas-batasnya bergeser antarversi ke dua arah |
| Kasus regresi | Persis kegagalan yang sudah Anda perbaiki, yang tidak diketahui benchmark siapa pun |
Delapan kategori, masing-masing membutuhkan contoh nyata, satu eksekusi pembanding, dan penilaian seseorang. Itu sebuah proyek, bukan perubahan konfigurasi. Kalikan dengan jumlah rilis frontier dalam bulan mana pun, dan alasan rasio 10 berbanding 5 menjadi jelas.
Kami menulis satu tulisan utuh tentang cara mengukur ini pada beban kerja Anda sendiri alih-alih memercayai papan peringkat, dan ringkasan jujurnya adalah melakukannya dengan benar memakan hari, bukan jam.
Lebih murah per token bukan berarti lebih murah per tugas
Temuan paling berlawanan dengan intuisi dalam seluruh cerita ini bukan datang dari sebuah lab, melainkan dari seorang insinyur yang berusaha mengotomatiskan pilihan itu.
Moe Khalil, product engineer di gateway AI sumber terbuka LiteLLM, menerbitkan tulisan berjudul "Model Fatigue is Real" pada 4 September. Ia mengerjakan auto router LiteLLM — perangkat lunak yang seluruh tugasnya adalah memilihkan model untuk Anda — dan ia mengungkapkan afiliasi itu sejak awal, sesuatu yang tidak dilakukan kebanyakan orang yang menulis soal ini.
Asumsi awal timnya adalah asumsi yang intuitif. Ambil dua model yang sama-sama bisa menyelesaikan sebuah tugas; yang harganya separuh per token menurut kartu model semestinya menyelesaikannya dengan sekitar separuh biaya.
Bukan itu yang ditunjukkan pengujian. Model yang lebih kuat dan lebih mahal justru menyelesaikan tugas-tugas yang lebih sulit dengan sepersekian biaya model murah. Penjelasan Khalil: "Karena ia lebih pintar, ia mengambil pendekatan yang lebih pintar, dan sampai ke produk jadi jauh lebih cepat."
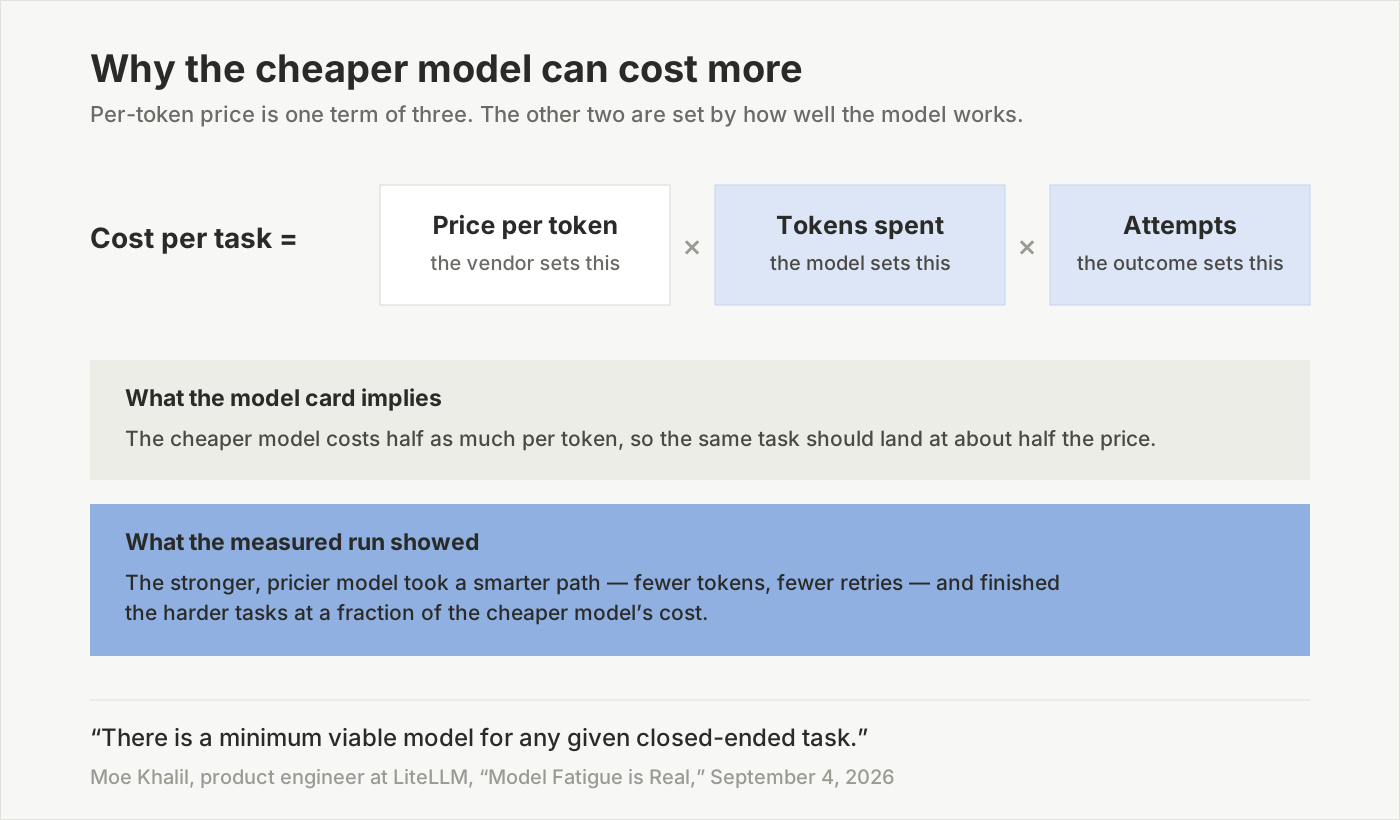
Dari ketiga faktor, hanya harga per token yang muncul di halaman harga. Dua sisanya adalah sifat kompetensi model, dan baru muncul ketika Anda benar-benar menjalankan pekerjaannya.
Ini mengubah makna halaman harga secara total. Angka yang diiklankan vendor hanyalah satu faktor dari perkalian tiga: harga per token, token yang terpakai, dan jumlah percobaan sampai tugas benar-benar berhasil. Vendor menetapkan yang pertama. Model itu sendiri menetapkan yang kedua dan ketiga, dan keduanya tak dapat diketahui sebelum Anda melewatkan pekerjaan Anda sendiri melaluinya.
Artinya, perbandingan yang diajarkan kepada Anda — pindai kolom harga, ambil yang murah — bukan sekadar tidak lengkap. Pada tugas nyata, ia bisa menunjuk ke arah yang salah.
Di hulu tak ada yang punya insentif memberi tahu Anda
Khalil lalu mengatakan bagian yang biasanya ditelan, dan itu kalimat paling tajam yang ditulis tentang topik ini sepanjang tahun:
"Bagi perusahaan model, kemalasan ini adalah fitur — bukan bug. Mereka lebih suka saya memakai [model kelas atas] untuk meringkas surel saya, dan mereka tidak punya insentif untuk memberi tahu saya kapan model yang lebih murah akan bekerja sama baiknya. Tugas mereka adalah terus mendorong frontier. Mencari tahu kapan tidak memakai frontier diserahkan kepada saya."
Baca sekali lagi dengan angka Gartner di kepala. Pasar US$2,59 triliun, tumbuh 47% setahun, di mana pemasok diuntungkan oleh setiap pelanggan yang secara bawaan meraih ke atas dan tidak menanggung biaya apa pun ketika pelanggan berbelanja berlebihan.
Ini bukan konspirasi dan tidak menuntut siapa pun berperilaku buruk. Begitulah bentuk gradien insentifnya. Tugas sebuah lab frontier adalah menggeser frontier. Memberi tahu Anda bahwa model kelas menengah tahun lalu menangani 80% beban kerja Anda adalah tugas orang lain, dan sampai belum lama ini itu bukan tugas siapa-siapa.
Pengamatan kedua Abbasi juga masuk di sini. Ia menyebut "bukan kebetulan" bahwa semua pengembang besar mengumumkan pada pekan yang sama, dan Noah Faro, kepala teknologi startup keuangan AI Farsight, sependapat — mencatat bahwa para pesaing membaca rencana satu sama lain sebagian dari ketersediaan komputasi awan, karena mereka semua berebut kapasitas dari segelintir vendor yang sama. Faro juga menyampaikan poin yang mengempiskan hiruk-pikuk: berbeda dengan GPT-6 Astra, peluncuran Anthropic, Meta, dan Google pekan itu adalah rilis titik, peningkatan atas model yang sudah ada alih-alih model baru. Menurut penilaiannya, dua rilis terakhir yang benar-benar menggerakkan jarum adalah Fable 5 dari Anthropic pada Juni dan Kimi K3 dari Moonshot AI pada Juli.
Jadi: enam pengumuman, satu model frontier yang benar-benar baru, dan pekerjaan senilai satu siklus evaluasi penuh yang tercipta untuk semua orang di hilir.
Dua cara industri menyerap ini, dan keduanya tidak sama
Kalau para lab tidak mau mengambil keputusan, seseorang harus mengambilnya. Dua jawaban telah muncul, dan keduanya berbeda secara struktural.
Jawaban horizontalnya adalah perutean. Gateway seperti LiteLLM menaruh setiap model di balik satu kunci API dan mencoba memilih per permintaan. Khalil menggambarkan masalah teknisnya dengan tepat: untuk setiap tugas tertutup ada model minimum yang masih layak — yang termurah tetapi tetap berhasil — dan tantangannya adalah memperkirakan yang mana itu sebelum tugasnya dijalankan. Pendekatan terbaik timnya saat ini menyimpulkannya dari data benchmark publik ditambah heuristik di dalam prompt; mereka juga sudah mencoba klasifikasi dengan LLM dan pendekatan hibrida. Penilaiannya sendiri: "Semuanya masih tidak sempurna, tapi selangkah lebih baik daripada tidak ada apa-apa."
Perutean adalah rekayasa sungguhan dan ia membantu. Tetapi perhatikan apa yang dipindahkannya dan apa yang tidak. Ia menyerap pipa ledeng — satu kunci, satu antarmuka, akses otomatis ke model baru. Ia tidak menyerap pertanggungjawaban. Ketika router salah pilih, keluaran buruk itu tetap milik Anda, di dalam produk Anda, di depan pengguna Anda. Menilai apakah jawabannya bagus tetap menjadi urusan Anda.
Jawaban vertikalnya adalah perangkat lunak terkelola penuh yang dibangun untuk satu pekerjaan. Di sini vendor tidak merutekan antarmodel atas nama Anda; ia mengambil seluruh tugas dari tangan Anda dan menyerahkan hasil yang sudah jadi. Anda tidak melihat nama model. Anda melihat transkrip, ringkasan, terjemahan, laporan pengeluaran yang sudah diajukan.
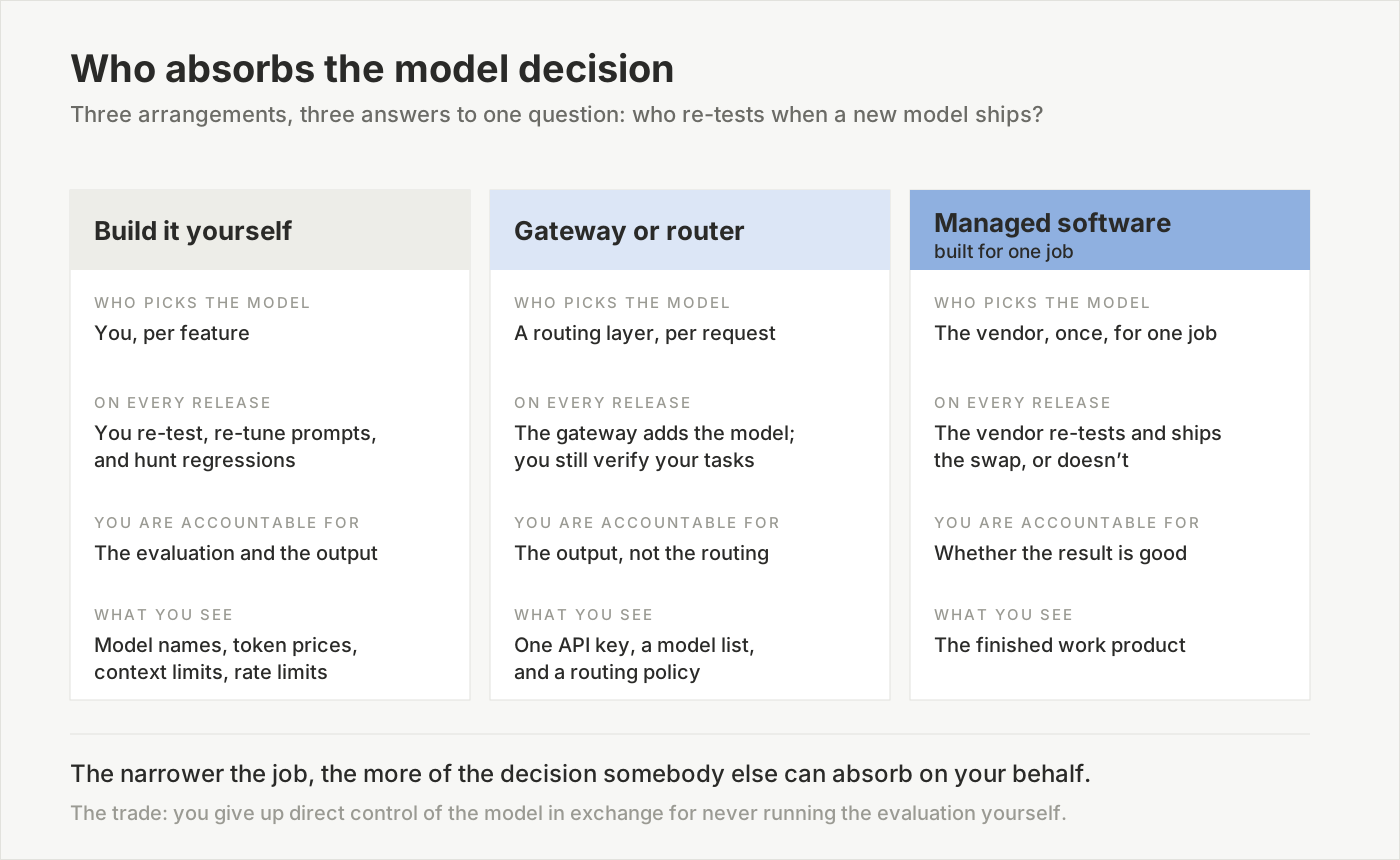
Semakin ke kanan, semakin sedikit keputusan yang tersisa di tangan Anda — dan semakin besar ketergantungan Anda pada apakah vendor sudah menjalankan evaluasinya dengan jujur.
Komunitas AI lokal sampai pada kesimpulan serupa dari arah yang berlawanan. Sebuah analisis yang terbit tahun ini menggambarkan dunia model kecil sebagai treadmill: unduh, konfigurasi, jalankan beberapa prompt, nilai setengah-setengah, lanjut ke rilis berikutnya. Rekomendasinya adalah berhenti — menstandarkan diri pada satu konfigurasi harian yang sudah terbukti dan mengadopsi model baru hanya setelah mengujinya cukup lama pada tugas nyata yang representatif untuk memastikan ia benar-benar lebih baik untuk beban kerja spesifik Anda. Kesimpulan yang sama, dicapai oleh seorang penghobi dengan dua GPU dan oleh seorang CEO dengan anggaran komputasi: pilih sekali, dengan benar, dan berhenti mempersoalkannya lagi setiap Kamis.
Mengapa pekerjaan yang sempit itulah yang membuat keputusan bisa diserap
Ini pandangan kami, dan inilah alasan kategori ini ada sama sekali.
Keputusan model hanya bisa diambil oleh orang yang mengenal tugasnya. Kedengarannya sepele. Tidak, karena itu menyingkirkan hampir semua orang.
Antarmuka obrolan serbaguna tidak bisa memutuskan untuk Anda, sebab pada pagi mana pun ia bisa diminta menulis soneta, men-debug race condition, atau meringkas kontrak sewa. Tidak ada model minimum yang masih layak untuk "apa pun yang diketik pengguna berikutnya". Satu-satunya bawaan yang aman adalah model terkuat yang tersedia — persis bawaan yang melayani kepentingan vendor, dan persis bawaan yang menurut Khalil tidak ada orang berinsentif untuk membujuk Anda meninggalkannya.
Gateway bisa menebak lebih baik, karena ia melihat prompt. Tetapi ia melihat prompt tanpa pengetahuan tentang seperti apa jawaban yang baik di domain Anda, dan tanpa konsekuensi bila ia keliru.
Perangkat lunak terkelola yang dibangun untuk tujuan khusus berada di posisi yang sepenuhnya berbeda. Ketika pekerjaannya sudah pasti — mentranskripsi rapat 60 menit dengan empat pembicara yang berpindah-pindah antara bahasa Indonesia dan Inggris, lalu menghasilkan daftar tindakan — tugas itu tertutup persis dalam pengertian Khalil. Ada model minimum yang masih layak untuknya. Dan yang menentukan, itu adalah model minimum yang sama bagi setiap pelanggan dengan pekerjaan itu, yang berarti evaluasinya cukup dijalankan sekali dan biayanya tersebar ke semua orang.
Itulah seluruh argumen ekonomi kategori ini, dan layak dituliskan sebagai aturan: semakin sempit pekerjaannya, semakin besar bagian keputusan model yang bisa diserap orang lain untuk Anda. Vendor yang melayani satu beban kerja mampu menguji seluruh 10 kandidat karena ia mengujinya sekali, untuk ribuan pelanggan, terhadap definisi hasil yang baik yang sudah tetap. Anda menguji lima, untuk diri sendiri, terhadap definisi yang harus Anda karang sendiri, adalah cara mahal untuk mendapatkan jawaban yang lebih buruk.
Pertukarannya nyata dan layak disebut dengan jujur. Anda melepaskan kendali langsung atas model mana yang menjalankan pekerjaan Anda. Sebagai gantinya, Anda berhenti menjalankan evaluasi, berhenti melacak kalender rilis, dan yang Anda nilai adalah keluarannya — satu-satunya hal yang sejak awal benar-benar Anda pedulikan.
Cara mengetahui susunan mana yang sedang Anda beli
Sebelum pembelian AI Anda berikutnya, empat pertanyaan secara berurutan:
- Apakah pekerjaannya tertutup? Bisakah Anda menyatakan dalam satu kalimat seperti apa keluaran yang benar? Kalau ya, sebuah perkakas vertikal terkelola bisa memiliki keputusan itu. Kalau jawabannya "tergantung apa yang kami minta", Anda sedang membeli model umum dan evaluasinya tetap milik Anda.
- Siapa yang menguji ulang ketika model baru dirilis? Tanyakan langsung ke vendornya. Vendor terkelola semestinya bisa menjelaskan himpunan evaluasi dan proses penggantiannya. Kalau jawabannya Anda akan "mendapat akses ke model-model terbaru", Anda membeli pipa ledeng, bukan penilaian.
- Apa yang ditunjukkan kepada Anda — sebuah model atau sebuah hasil? Kalau produknya memajang nama model, jendela konteks, dan harga token, ia sedang mengembalikan keputusan itu kepada Anda. Itu produk yang sah, tapi hargailah sesuai kenyataan tersebut.
- Seperti apa biaya totalnya pada volume Anda? Harga per token, dikali token yang benar-benar terpakai pada pekerjaan Anda, dikali percobaan sampai benar. Jalankan tugas Anda sendiri. Halaman harga tidak bisa menjawab ini.
Kesimpulan: frontier adalah nilai bawaan, bukan keputusan
Model fatigue biasanya digambarkan sebagai masalah perhatian — terlalu banyak berita, terlalu cepat. Bukan. Ia adalah biaya yang diam-diam dipindahkan oleh pasar dengan pertumbuhan tercepat di dunia teknologi ke pelanggannya, tempat ia mengendap tanpa harga dan sebagian besar tanpa diukur.
Para lab akan terus merilis, karena merilis adalah pekerjaan mereka dan pasar membayarnya. Beban evaluasi akan terus tumbuh, karena ia tumbuh secara mekanis dengan setiap rilis. Dan sebagian besar tim akan terus menyelesaikannya dengan satu-satunya cara yang bisa ditempuh tim yang sibuk: meraih model terbaru, terbesar, termahal — satu-satunya pilihan yang tak perlu dibela siapa pun dalam rapat.
Setiap perangkat lunak yang mengambil sebuah pekerjaan sepenuhnya dari tangan Anda — dan tak pernah menunjukkan nama model — adalah taruhan bahwa cara di atas adalah cara yang buruk untuk menjalankan bisnis. Taruhan itu tampak makin bagus setiap pekan rilis.
Di mana Telli.sh berada: inilah kategori tempat kami membangun. Telli.sh merekam rapat, memisahkan pembicara, menerjemahkan 15 bahasa secara waktu nyata, dan menghasilkan ringkasan serta daftar tindakan — dan ia tidak pernah menanyakan model mana yang harus dipakai, karena itu tugas kami, bukan tugas Anda. Ekstensi peramban kami memang menawarkan sembilan mesin terjemahan termasuk satu opsi yang sepenuhnya berjalan di perangkat, untuk orang-orang yang memang menginginkan kendali itu; produk rapat sengaja tidak melakukannya, karena "transkripsikan rapat ini dengan baik" adalah tugas tertutup dan kami lebih suka dinilai dari transkripnya ketimbang dari model di baliknya.
Rekam rapat Anda berikutnya dan biarkan orang lain memilih modelnya
Sumber
- CNBC, "'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace", 6 September 2026 — kronologi rilis untuk 1–3 September 2026; kutipan Zhen Lu bahwa "model fatigue itu nyata"; komentar Sam Altman tentang "kadensi yang lebih cepat"; Ahmed Abbasi tentang "permainan pangsa dompet" dan valuasi swasta mendekati US$1 triliun; Noah Faro tentang rilis titik serta tentang Fable 5 dan Kimi K3 sebagai dua rilis terakhir yang menggerakkan jarum; dan angka Suresh Vasudevan, lima dari sepuluh model dievaluasi. Kontribusi liputan oleh Kate Rooney dan MacKenzie Sigalos; diakses 8 September 2026
- Moe Khalil, "Model Fatigue is Real", 4 September 2026 — argumen "tidak ada insentif untuk memberi tahu saya kapan model yang lebih murah akan bekerja"; kerangka model minimum yang masih layak untuk tugas tertutup; dan temuan terukur bahwa model yang lebih kuat dan lebih mahal menyelesaikan tugas yang lebih sulit dengan sepersekian biaya model yang lebih murah. Khalil mengungkapkan dalam tulisannya bahwa ia product engineer di LiteLLM, yang membangun auto router; diakses 8 September 2026
- Gartner, "Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026", 19 Mei 2026 — belanja AI dunia sebesar US$2,59 triliun pada 2026, naik 47% secara tahunan, dengan infrastruktur AI sebagai segmen terbesar
- MindStudio, "Local AI Model Fatigue: Why One Setup Beats Chasing Every Release" — penggambaran siklus rilis model kecil lokal sebagai treadmill dan argumen untuk menstandarkan diri pada satu konfigurasi harian yang sudah terbukti
- AI타임스, "[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'", 7 September 2026 — liputan berbahasa Korea yang mengangkat laporan CNBC dan komentar pengembang di sekitarnya
- Pembacaan kami atas akuisisi Hugging Face oleh NVIDIA — pengumuman lain pada pekan yang sama, dan lapisan distribusi di bawah setiap model yang disebut di sini
- Cara mengukur akurasi transkripsi pada beban kerja Anda sendiri — berapa biaya sebuah evaluasi nyata ketika Anda menjalankannya dengan benar