MiniCPM-OCR può leggere in locale una cartella di scansioni. Quali pagine vanno controllate?
L'SDK MiniCPM-OCR 1.0.5 elabora più file in un'unica esecuzione. Conserva un risultato per documento, verifica i campi critici e decidi quali scansioni possono entrare in un archivio ricercabile.
Tre vecchie fatture si leggono a occhio ma sono difficili da cercare. Una è un PDF appiattito. Una è una foto con un angolo piegato. L'ultima è una scansione nitida con una tabella che continua su due pagine. Uno strumento OCR locale può trasformare le immagini in testo. Chi approva l'archivio deve poter risalire al file di ogni risultato e verificare che le colonne abbiano mantenuto il loro significato.
OpenBMB ha pubblicato la versione 1.0.5 dell'SDK di MiniCPM-OCR il 9 novembre 2026. L'aggiornamento accetta più input in una sola esecuzione e produce un risultato per file. Un'opzione separata permette di trattare le immagini singole come documenti indipendenti. MiniCPM-OCR 1.0, con 1,3 miliardi di parametri, è pensato per documenti e PDF in cinese e inglese. OpenBMB aveva già pubblicato il modello e l'SDK e mette a disposizione le istruzioni per eseguire localmente il servizio di riconoscimento. Versione su PyPI · Progetto OpenBMB e cronologia delle modifiche
L'esperimento utile è un piccolo lotto con risultati verificabili. Assegna un identificativo stabile a ogni input, conserva l'estrazione accanto alla fonte e controlla i campi che potrebbero causare problemi se fossero sbagliati. È la differenza tra una bozza su cui fare ricerche e un documento che consente di prendere decisioni.
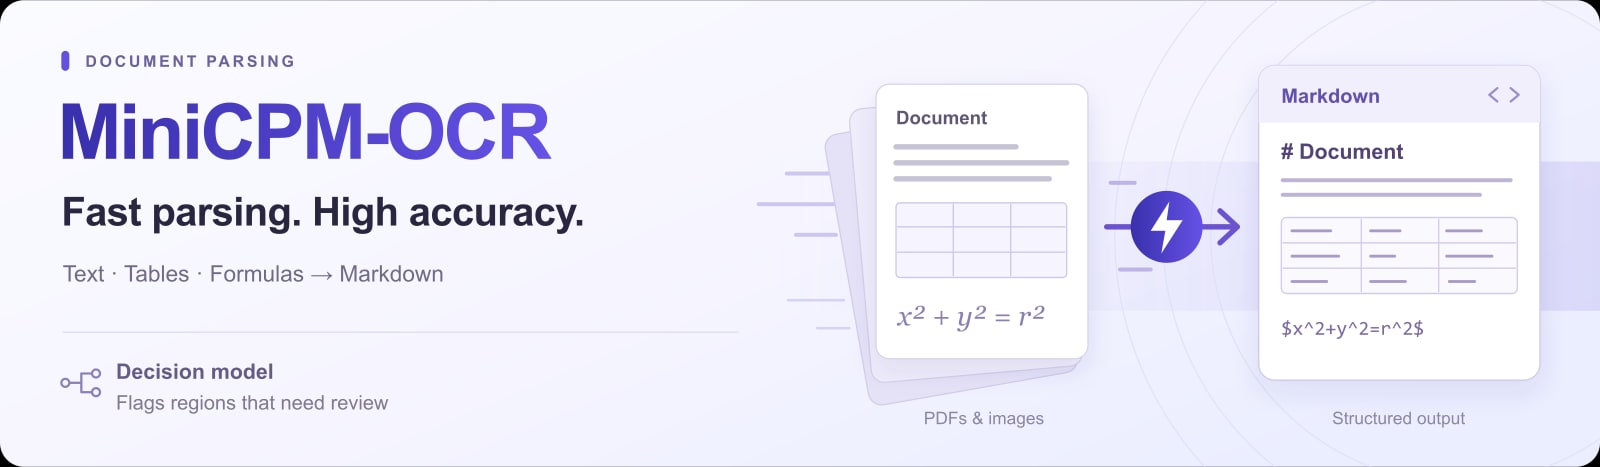
L'illustrazione ufficiale del rilascio MiniCPM-OCR di OpenBMB mostra il passaggio dai documenti al testo strutturato. Apache 2.0. Convertita in raster e ridimensionata da Telli.sh. Illustrazione originale

L'aggiornamento rende più facile tenere distinti i documenti
Le note di OpenBMB del 9 novembre dicono che la versione 1.0.5 restituisce un risultato per ogni file quando riceve più input. L'opzione --split-images tratta le immagini singole come documenti separati. Entrambi i dettagli contano per un ufficio che gestisce PDF di più pagine e foto. Una fattura già raccolta in un PDF in genere dovrebbe rimanere unita. Due fotografie senza relazione dovrebbero restare due record distinti. Pacchetto e note di rilascio di MiniCPM-OCR 1.0.5
Per una piccola valutazione, prepara un documento per tipo. Un PDF nitido può stabilire l'ordine di lettura atteso. Una foto può mostrare se una piega, una rotazione o un riflesso causa un errore in una zona. Una tabella densa mostra che cosa accade quando due colonne hanno valori simili. Se nell'archivio ci sono foto di due pagine dello stesso documento, decidi come raggrupparle prima di passarle al parser. Il raggruppamento riguarda il documento originale, mentre il comando riceve file.
Il lotto di esempio usa un identificativo stabile per ogni input e conserva la fonte durante la revisione. Illustrazione di Telli.sh.
Usa un elenco degli input che identifichi l'originale, il numero di pagine e l'output previsto. Se usi una somma di controllo per rilevare modifiche accidentali, calcolala a partire dall'originale prima di eseguire il lotto. Salva le estrazioni in una destinazione separata perché un tentativo successivo non sovrascriva l'unica fonte. Se due cartelle contengono entrambe un file chiamato invoice.pdf, un identificativo stabile mantiene chiaro l'abbinamento anche quando il nome è ambiguo.
Scegli un formato leggibile dal processo successivo. L'SDK di OpenBMB assembla l'output in Markdown o JSON, secondo la configurazione. Markdown è comodo per chi legge una bozza. Un output strutturato può aiutare un processo a valle a gestire le regioni restituite dal parser. In entrambi i casi serve un confronto con l'immagine quando un numero o un campo verrà usato per decidere. Flusso di analisi di OpenBMB
La configurazione locale separa l'analisi della pagina dal riconoscimento
OpenBMB documenta due fasi per analizzare intere pagine su computer. L'SDK usa un modello di impaginazione per individuare e ordinare testo, tabelle, formule e altre regioni. Invia ritagli delle regioni via HTTP a un servizio di riconoscimento e assembla le risposte nell'ordine di lettura. Puoi eseguire entrambe le fasi su hardware che controlli. Il servizio di riconoscimento è un ambiente separato e l'SDK può anche puntare a un servizio altrove. Guida di OpenBMB per l'analisi di pagine intere e la configurazione locale
Questo confine conta quando un documento contiene informazioni private. La domanda è dove la fase di analisi dell'impaginazione invia i ritagli. Anche un SDK locale può trasmettere il contenuto attraverso la rete se è configurato per chiamare un servizio ospitato. Una configurazione locale dovrebbe puntare al servizio previsto e rispettare le regole approvate dall'organizzazione per archiviazione e registri. Una demo pubblica con un esempio sintetico permette di vedere l'interfaccia senza inviare un documento reale di un cliente.
Il 5 novembre OpenBMB ha pubblicato un'immagine Docker che comprende SDK, vLLM e modello. La configurazione documentata richiede Linux x86-64, una GPU NVIDIA, un driver compatibile con CUDA 12.9 e Docker con NVIDIA Container Toolkit. OpenBMB documenta anche motori come llama.cpp e Ollama per il servizio di riconoscimento. La dimensione del modello da sola non stabilisce se una macchina possa eseguire agevolmente tutto il flusso. Verifica il componente di analisi dell'impaginazione, il formato del modello, la memoria e la velocità di elaborazione sulla macchina di destinazione. Requisiti di installazione OpenBMB
Per i singoli documenti c'è anche un'opzione mobile. OpenBMB ha annunciato l'analisi offline su iOS il 2 novembre. Un aggiornamento del progetto il 12 novembre ha esteso la demo sul dispositivo ad Android e HarmonyOS. Considera le demo mobili e l'SDK desktop per i lotti come due modi diversi di usare il modello. Scegli in base a dove sono i file e a come intendi controllare i risultati. Cronologia delle versioni mobili OpenBMB
Controlla i campi che possono essere sbagliati anche se sembrano giusti
Immagina che una fattura indichi 10 unità a 38,50 ciascuna. La tabella estratta riporta 38,50 nella colonna della quantità e 10 in quella del prezzo unitario. Un sistema che verifica soltanto la presenza dei due numeri può considerarla corretta. Per chi usa il risultato, l'informazione importante è l'associazione tra valori e colonne. Confronta insieme la riga, le intestazioni e i totali.
Il rischio cambia per un archivio destinato alla ricerca. Un refuso in una nota descrittiva può essere accettabile se il personale trova l'originale. Un numero di ordine di acquisto sbagliato può portare al documento errato. Definisci quali campi devono corrispondere esattamente e controllali sull'originale. Se la pagina contiene un codice, conserva gli zeri iniziali durante il controllo. La visualizzazione numerica o l'importazione in un foglio può rimuoverli anche quando il parser ha letto correttamente il campo.
| Esempio di documento | Che cosa confrontare con l'originale | Che cosa decidere prima dell'uso a valle |
|---|---|---|
| Fatture | ID del fornitore, numero di fattura, valuta, totali e intestazioni delle colonne | Quali campi richiedono corrispondenza esatta |
| Report a più colonne | Titolo, ordine delle colonne e didascalie accanto alle figure | Se il risultato si legge nella sequenza corretta |
| Modulo ruotato o fotografato | Nomi, caselle selezionate, timbri o annotazioni vicino a una piega | Quali pagine richiedono un controllo manuale o una nuova scansione |
| Scansione multilingue | Identificativi e testo dei campi in ogni lingua presente | Quali lingue soddisfano i criteri di accettazione dell'archivio |
OpenBMB descrive MiniCPM-OCR 1.0 come un modello per cinese e inglese. I team che lavorano con pagine in coreano o in più lingue dovrebbero misurare la precisione sulle proprie pagine. Una prova concreta include un documento denso, un modulo nitido e una fotografia per ogni lingua importante. Registra il tipo di errore invece di ridurre pochi documenti diversi a una media unica. Descrizione del modello OpenBMB
Un punteggio per regione aiuta a decidere cosa rivedere per primo
OpenBMB pubblica anche MiniCPM-OCR Jev, un modello separato che valuta testo, formule e tabelle estratti confrontandoli con una regione dell'immagine. Il progetto presenta il punteggio come un modo per trovare regioni da rivedere. Per un lotto puoi usarlo per stabilire la priorità e continuare a verificare con l'originale i campi che comportano le conseguenze maggiori. Prima di ordinare la coda con un punteggio, stabilisci se porta in alto gli errori che ti interessano. Spiegazione di OpenBMB su MiniCPM-OCR Jev
Il punteggio facoltativo per regione aiuta a stabilire le priorità di revisione. I campi che determinano pagamenti, identificativi o altre decisioni possono ancora richiedere un controllo diretto. Illustrazione di Telli.sh.
Per vedere quando il punteggio aiuta, prepara un piccolo insieme di riferimento con alcuni errori che il team sa già riconoscere. Un carattere mancante in un codice, una riga allineata male e una frase di una pagina nitida sollecitano problemi diversi. Includi alcune regioni corrette. Esamina quando il modello dà un punteggio alto a un errore o basso a un risultato giusto. Sono i casi da discutere prima di introdurre una soglia nel processo.
Tieni visibili le discrepanze. Se un revisore corregge un totale, conserva l'output OCR originale e registra la modifica in relazione al documento fonte. Il team può così capire se gli errori si concentrano su un tipo di documento o una modalità di acquisizione. Chi interviene in seguito può distinguere la correzione umana dal primo risultato del modello.
Il tempo di controllo umano può decidere se il processo a lotti è scalabile. Registra il tempo per risolvere un problema e quali pagine richiedono un secondo esame. Uno strumento locale può far risparmiare tempo sui documenti nitidi e allungare la coda per le scansioni di qualità bassa. Se lo stesso modulo cartaceo crea ripetutamente problemi, migliorare la scansione può essere più utile che aggiungere un altro modello.
Usa un piccolo lotto che possa fallire in modi diversi
- Raccogli documenti di esempio autorizzati. Includi una scansione nitida, una foto ruotata e una tabella di più pagine, con lingua e impaginazione rappresentative. Conserva ogni originale con un identificativo stabile.
- Scegli un percorso locale approvato. Per i lotti su computer, segui la guida di OpenBMB e verifica il punto di accesso usato dal servizio di riconoscimento. Controlla hardware e ambiente prima di caricare i file. Guida ufficiale all'installazione locale
- Esegui l'SDK e conserva i risultati per file. Registra versione dell'SDK, modello o quantizzazione, motore e formato di output. Scegli come raggruppare le immagini e conserva la fonte di ogni risultato. Istruzioni SDK 1.0.5
- Rivedi in base allo scopo dell'archivio. Controlla l'ordine di lettura per la ricerca e i campi critici per gli usi successivi. Registra quali documenti sono stati accettati, corretti o respinti e perché.
- Ripeti con un piccolo gruppo nuovo. Mantieni gli stessi criteri. Confronta il tempo fino al termine della revisione e la tracciabilità, e risolvi i problemi dei tipi di documento che richiedono ancora lavoro manuale prima di aumentare il volume.
Scegli un uso alla tua portata. Un assistente che aiuta a cercare tra documenti di riunione scansionati non richiede le stesse garanzie sui campi di uno strumento che compila un pagamento. Inizia con la ricerca o un altro processo reversibile se è la necessità immediata. Il pilota può indicare quali estrazioni meriteranno controlli più severi in seguito.
Dai all'archivio un modo semplice per mostrare ciò che ha indicizzato. Se il risultato di ricerca mostra solo il testo generato dalla macchina, l'utente può scambiare un risultato plausibile per un dato definitivo. Visualizza il nome del file o l'ID del documento accanto al risultato e rendi facile trovare la pagina corrispondente. Se l'estrazione ha uno stato di revisione, mostralo. Chi usa l'archivio può così capire quando serve leggere l'originale.
Una prova di recupero è utile quando un lotto condivide una cartella di output. Immagina che un file fallisca e che tu ripeta solo quel file con una configurazione diversa. Verifica che gli altri risultati restino e che l'elenco identifichi l'output della seconda esecuzione. Il controllo si può fare senza rielaborazione automatica. Serve a capire se una persona può migliorare un risultato senza perdere la traccia degli altri.
Il lotto è utile se ogni risultato riporta alla pagina originale
L'aggiornamento dell'SDK di MiniCPM-OCR riduce il lavoro necessario per inviare un file alla volta. Il resto dipende dall'archivio. Mantieni separati i documenti, scegli dove elaborare le immagini e lascia che l'uso successivo determini quanto verificare ogni campo. Chi trova un numero nel risultato il mese prossimo dovrebbe poter aprire la pagina da cui viene e vedere ciò che ha visto il parser.
Fonti
- SDK MiniCPM-OCR 1.0.5 su PyPI, 9 novembre 2026
- Repository MiniCPM-OCR di OpenBMB, schede dei modelli, date e guide di installazione
- Dimostrazione pubblica di OpenBMB
- Illustrazione di rilascio OpenBMB e licenza
Per conservare in un registro consultabile le decisioni di revisione di un archivio documentale, crea un account Telli.sh.