MiniCPM-OCR lit un dossier de scans en local. Quelles pages faut-il encore vérifier ?
Le SDK MiniCPM-OCR 1.0.5 traite plusieurs entrées à la fois. Gardez un résultat par document, contrôlez les champs critiques et décidez quels scans verser dans des archives interrogeables.
Trois anciennes factures sont lisibles et difficiles à retrouver par recherche. La première est un PDF aplati. La deuxième est une photo dont un coin est plié. La dernière est un scan net avec un tableau sur deux pages. Un outil de reconnaissance optique local peut convertir ces images en texte. La personne qui valide les archives doit toutefois savoir quel résultat correspond à quel fichier et si les valeurs figurent encore dans les bonnes colonnes.
Le 9 novembre 2026, OpenBMB a publié la version 1.0.5 du SDK MiniCPM-OCR. Elle accepte plusieurs entrées dans la même exécution et produit un résultat par fichier. Une option distincte permet de traiter les images autonomes comme des documents séparés. Le modèle MiniCPM-OCR 1.0, doté de 1,3 milliard de paramètres, est conçu pour les documents et PDF en chinois et en anglais. OpenBMB avait publié le modèle et le SDK auparavant, et fournit des instructions pour faire tourner le service de reconnaissance en local. Version sur PyPI · Projet OpenBMB et historique des versions
Un bon premier essai consiste à traiter un petit lot dont on peut vérifier chaque résultat. Attribuez un identifiant stable à chaque entrée, conservez l’extraction à côté de sa source et vérifiez les champs dont une erreur aurait des conséquences. On peut alors juger si un brouillon interrogeable peut servir de document de travail.
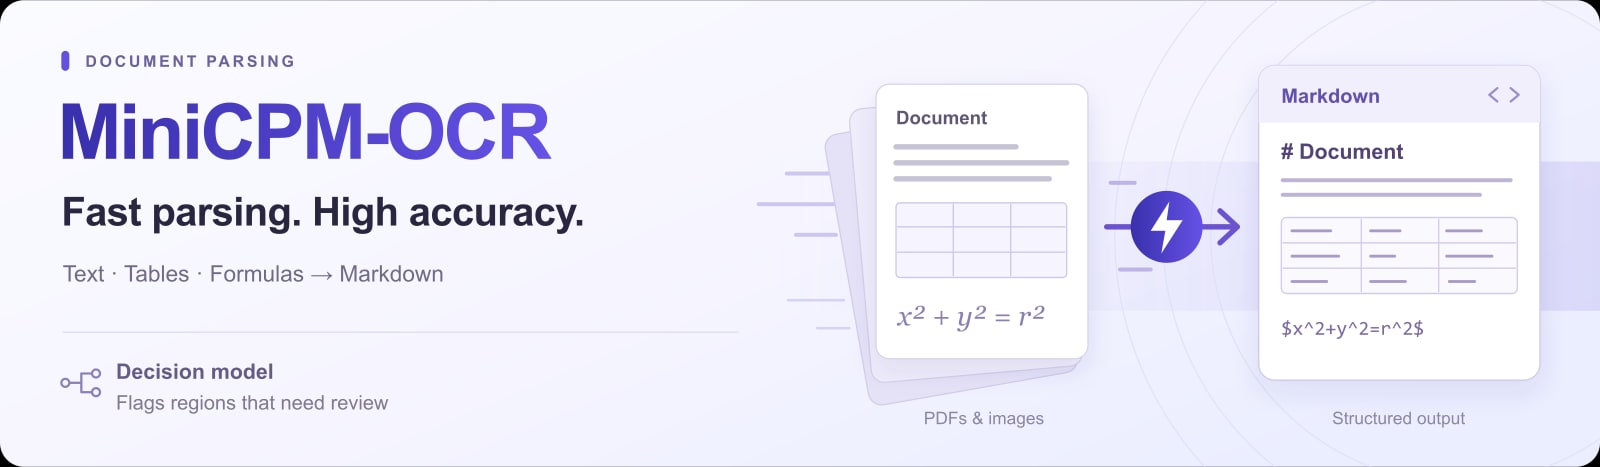
L’illustration officielle d’OpenBMB pour le lancement de MiniCPM-OCR montre comment des documents deviennent du texte structuré. Licence Apache 2.0. Convertie en image matricielle et redimensionnée par Telli.sh. Illustration originale

La mise à jour facilite la séparation des documents
Selon les notes de version d’OpenBMB du 9 novembre, la version 1.0.5 renvoie un résultat par fichier lorsqu’elle reçoit plusieurs entrées. Son option --split-images traite les images autonomes comme des documents distincts. Ces détails comptent quand un service traite à la fois des PDF de plusieurs pages et des photos. Une facture déjà assemblée en un PDF devrait normalement rester groupée. Deux photos sans rapport doivent rester deux pièces distinctes. Paquet et notes de version de MiniCPM-OCR 1.0.5
Préparez un exemplaire de chaque type de document pour un petit essai. Un PDF net permet d’établir l’ordre de lecture attendu. Une feuille photographiée révèle si un pli, une rotation ou un reflet perturbe la détection d’une zone. Un tableau dense montre ce qui se passe quand deux colonnes contiennent des valeurs similaires. Si les archives contiennent deux pages photographiées de la même pièce, choisissez comment les regrouper avant l’analyse. Le regroupement relève du document d’origine, tandis que la commande reçoit des fichiers.
Dans cet exemple, chaque entrée conserve un identifiant stable et sa source reste disponible lors de la vérification. Illustration de Telli.sh.
Utilisez un manifeste d’entrée pour identifier l’original, le nombre de pages et la sortie attendue. Si vous utilisez une somme de contrôle pour détecter une modification accidentelle, calculez-la à partir de l’original avant le traitement. Rangez les extractions à part pour qu’un nouvel essai ne puisse pas écraser l’unique source. Si deux dossiers contiennent chacun un fichier invoice.pdf, un identifiant stable évite toute ambiguïté dans leur rapprochement.
Commencez avec un format que l’étape suivante sait lire. Le SDK d’OpenBMB assemble les résultats en Markdown ou JSON, selon la configuration. Le Markdown facilite la lecture humaine d’un brouillon. La sortie structurée peut aider un traitement ultérieur à exploiter les zones retournées. Dans les deux cas, comparez le résultat à l’image lorsqu’un nombre ou un champ doit servir à une décision. Chaîne d’analyse d’OpenBMB
En local, l’analyse de la mise en page et la reconnaissance sont deux étapes
OpenBMB documente deux éléments pour l’analyse de pages entières sur ordinateur. Le SDK exécute un modèle de mise en page pour repérer et ordonner texte, tableaux, formules et autres zones. Il envoie par HTTP les extraits d’image à un service de reconnaissance, puis assemble les réponses dans l’ordre de lecture. Les deux éléments peuvent fonctionner sur du matériel que vous contrôlez. Le service de reconnaissance tourne dans un environnement distinct, et le SDK peut aussi pointer vers un service situé ailleurs. Analyse de pages entières et déploiement local, selon OpenBMB
Cette séparation compte pour les documents confidentiels. Il faut savoir où l’étape de mise en page envoie les extraits. Un SDK local configuré pour appeler un service hébergé peut envoyer le contenu sur le réseau. Pointez vers le service prévu et appliquez les règles approuvées de stockage et de journalisation. Un exemple synthétique permet d’explorer l’interface d’une démonstration publique sans envoyer un document client réel.
Le 5 novembre, OpenBMB a publié une image Docker qui regroupe le SDK, vLLM et le modèle. La configuration documentée demande Linux x86-64, un GPU NVIDIA, un pilote compatible avec CUDA 12.9 et Docker avec NVIDIA Container Toolkit. OpenBMB documente également des moteurs tels que llama.cpp et Ollama pour la reconnaissance. La taille du modèle ne suffit pas à établir si toute la chaîne tournera confortablement sur une machine. Vérifiez le composant de mise en page, le format du modèle, la mémoire et le débit sur le matériel visé. Prérequis de déploiement d’OpenBMB
Il existe aussi une solution mobile pour les documents individuels. OpenBMB a annoncé l’analyse hors ligne sous iOS le 2 novembre. Une mise à jour du projet le 12 novembre a étendu la démonstration sur appareil à Android et HarmonyOS. Les démonstrations mobiles et le SDK de traitement par lots sur ordinateur offrent des usages distincts. Choisissez selon l’emplacement des fichiers et la façon dont vous comptez examiner les résultats. Historique des versions mobiles d’OpenBMB
Vérifiez les champs qui peuvent sembler corrects malgré une erreur
Imaginons une ligne de facture de dix unités à 38,50 chacune. Le tableau extrait affiche 38,50 dans la colonne quantité et 10 dans la colonne prix unitaire. Un contrôle qui vérifie seulement la présence des deux nombres peut accepter le résultat. Pour la personne qui l’utilise, l’association entre la valeur et la colonne est essentielle. Comparez ensemble la ligne, les en-têtes et les totaux.
Dans des archives destinées à la recherche, le risque prend une autre forme. Une faute dans une note descriptive peut être tolérable si le personnel retrouve l’original. Une erreur dans un numéro de bon de commande peut renvoyer au mauvais document. Définissez les champs qui exigent une correspondance exacte et comparez-les à la source. Pour un code, gardez les zéros initiaux. Un affichage numérique ou l’import dans un tableur peut les supprimer alors que l’analyse a bien lu le champ.
| Exemple de document | Éléments à comparer à l’original | Décision à prendre avant utilisation |
|---|---|---|
| Factures | Identifiant du fournisseur, numéro de facture, devise, totaux et en-têtes de colonnes | Quels champs doivent correspondre exactement |
| Rapport en plusieurs colonnes | Titres, ordre des colonnes et légendes à côté des figures | Si le résultat se lit dans le bon ordre |
| Formulaire tourné ou photographié | Noms, cases cochées, cachets ou inscriptions près d’un pli | Quelles pages exigent un contrôle humain ou un nouveau scan |
| Scan multilingue | Identifiants et texte des champs dans chaque langue présente | Quelles langues répondent aux critères des archives |
OpenBMB présente MiniCPM-OCR 1.0 comme un modèle pour le chinois et l’anglais. Les équipes qui travaillent sur des pages coréennes ou multilingues devraient mesurer la précision sur ces pages. Un essai pratique comprend un document dense, un formulaire net et une photo pour chaque langue importante. Relevez les types d’erreur avant d’agréger des documents très différents en un seul score. Description du modèle par OpenBMB
Un score par zone aide à déterminer ce qu’il faut examiner en premier
OpenBMB publie également MiniCPM-OCR Jev, un modèle distinct qui évalue le texte, les formules et les tableaux extraits par rapport à une zone d’image. Le projet présente le score comme un moyen de repérer les zones à vérifier. Pour un lot, utilisez-le comme indice de priorité tout en comparant à l’original les champs dont une erreur aurait des conséquences. Vérifiez sa capacité à faire ressortir les erreurs pertinentes avant de l’utiliser pour ordonner la file de revue. Présentation de MiniCPM-OCR Jev par OpenBMB
Un score facultatif par zone aide à organiser la vérification. Les champs qui déterminent un paiement, une identification ou une autre décision peuvent encore exiger une comparaison directe. Illustration de Telli.sh.
Pour voir où ce score aide, préparez un petit jeu de référence avec des erreurs que l’équipe sait reconnaître. Un caractère manquant dans un numéro de pièce, une ligne décalée et une phrase sur une page bien lisible couvrent des difficultés différentes. Ajoutez aussi quelques zones correctes. Examinez les erreurs bien notées et les bons résultats mal notés. Ce sont les exemples à discuter avant d’intégrer un seuil au processus.
Gardez une trace des désaccords. Si une personne corrige un total, conservez la sortie OCR initiale et reliez la correction au document source. L’équipe peut alors voir si les erreurs se concentrent sur un type de document ou une méthode de capture. La personne suivante peut distinguer une correction humaine du premier résultat du modèle.
Le temps de vérification humaine peut déterminer si le traitement par lots passe à l’échelle. Mesurez le temps nécessaire pour régler un problème et notez les types de page qui demandent un deuxième examen. Un outil local peut accélérer le traitement des documents propres tout en allongeant la file des scans difficiles. Si le même formulaire papier pose problème de façon répétée, améliorer sa numérisation peut être plus efficace qu’ajouter un modèle.
Utilisez un petit lot qui peut échouer de plusieurs façons
- Rassemblez des exemples autorisés. Prenez un scan net, une photo tournée et un tableau sur plusieurs pages, avec des langues et mises en page représentatives. Gardez un identifiant stable pour chaque original.
- Choisissez un chemin local approuvé. Pour les lots sur ordinateur, suivez le guide d’OpenBMB et vérifiez le point de terminaison du service de reconnaissance. Contrôlez les prérequis matériels et logiciels avant de charger vos fichiers. Guide officiel de déploiement local
- Exécutez le SDK et conservez les résultats fichier par fichier. Notez la version du SDK, le modèle ou sa quantification, le moteur et le format de sortie. Choisissez consciemment le regroupement des images et gardez la source de chaque résultat. Instructions pour le SDK 1.0.5
- Contrôlez selon l’usage prévu des archives. Vérifiez l’ordre de lecture pour la recherche et les champs critiques pour les traitements suivants. Consignez quels documents ont été acceptés, corrigés ou rejetés et pourquoi.
- Recommencez avec un petit lot inédit. Appliquez les mêmes règles. Comparez le temps jusqu’à la fin de la vérification et la traçabilité, puis examinez les types de documents encore traités à la main avant d’augmenter le volume.
Choisissez un usage à votre portée. Un assistant de recherche dans des dossiers de réunion numérisés n’exige pas les mêmes garanties qu’un outil qui remplit un formulaire de paiement de facture. Commencez par la recherche ou une autre étape réversible si c’est là que le besoin se trouve. Le pilote peut indiquer quelles extractions méritent ensuite des contrôles renforcés.
Permettez aux utilisateurs de voir ce que les archives ont indexé. Un résultat qui affiche seulement le texte produit par la machine peut paraître fiable dès qu’il est plausible. Affichez le nom du fichier source ou l’identifiant du document et rendez la page correspondante facile à ouvrir. Indiquez le statut de vérification lorsqu’il existe. Chacun peut alors savoir quand il faut relire l’original.
Un lot qui partage un répertoire de sortie se prête aussi à un essai de reprise. Supposons qu’un fichier échoue et que vous relanciez ce seul fichier avec une autre configuration. Vérifiez que les autres résultats restent disponibles et que le manifeste identifie la sortie du deuxième essai. Le contrôle ne nécessite aucune réexécution automatisée. Il montre si une personne peut améliorer un résultat en préservant la trace des autres.
Un lot est utile lorsque chaque résultat ramène à sa page
La mise à jour du SDK MiniCPM-OCR réduit le travail d’envoi fichier par fichier. Le reste relève de la politique d’archivage. Préservez les limites de chaque document, choisissez où traiter les images et adaptez la vérification des champs à l’usage qui suivra. Si quelqu’un trouve un nombre dans un résultat le mois prochain, il doit pouvoir ouvrir la page d’origine et voir ce que l’outil avait sous les yeux.
Sources
- SDK MiniCPM-OCR 1.0.5 sur PyPI, 9 novembre 2026
- Dépôt OpenBMB MiniCPM-OCR, fiches de modèles, dates de publication et guides
- Démonstration publique d’OpenBMB
- Illustration de lancement d’OpenBMB et licence
Pour retrouver les décisions de vérification prises lors de la constitution de vos archives documentaires, créez un compte Telli.sh.