MiniCPM-OCR puede leer una carpeta de escaneos en local. ¿Qué páginas necesitan revisión?
El SDK MiniCPM-OCR 1.0.5 procesa varias entradas de una vez. Conserva un resultado por documento, verifica los campos críticos y decide qué escaneos pueden entrar en un archivo con búsqueda.
Hay tres facturas antiguas que una persona puede leer, pero en las que cuesta buscar. Una es un PDF aplanado. Otra es una fotografía con una esquina doblada. La última es un escaneo nítido con una tabla que ocupa dos páginas. Una herramienta local de OCR puede pasar las imágenes a texto. Quien apruebe el archivo necesita saber de qué fichero sale cada resultado y si las columnas conservan su significado.
OpenBMB publicó la versión 1.0.5 del SDK de MiniCPM-OCR el 9 de noviembre de 2026. La actualización acepta varias entradas en una ejecución y produce un resultado por archivo. Una opción adicional permite tratar las imágenes sueltas como documentos independientes. MiniCPM-OCR 1.0, con 1.300 millones de parámetros, está diseñado para documentos y PDF en chino e inglés. OpenBMB publicó antes el modelo y el SDK, y ofrece instrucciones para ejecutar localmente el servicio de reconocimiento. Versión en PyPI · Proyecto de OpenBMB e historial de cambios
La prueba útil es un lote pequeño con resultados auditables. Da un identificador estable a cada entrada, guarda la extracción junto a su fuente y revisa los campos que causarían problemas si fueran incorrectos. Eso separa un borrador en el que se puede buscar de un registro que sirve para tomar decisiones.
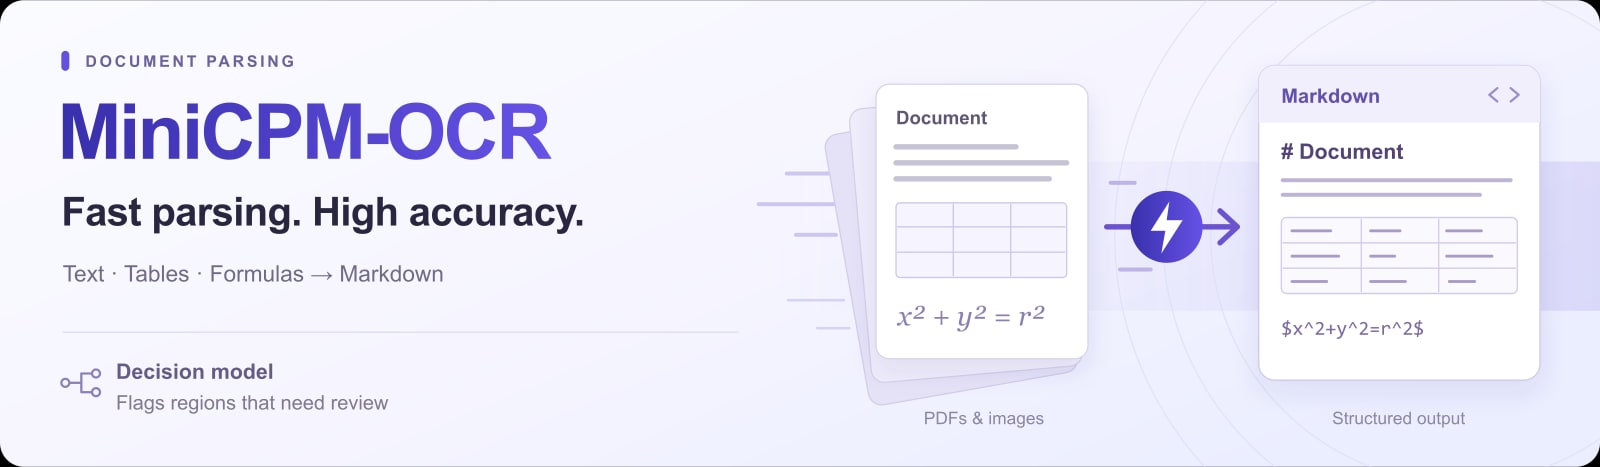
La ilustración oficial de MiniCPM-OCR de OpenBMB muestra el paso de documentos a texto estructurado. Apache 2.0. Rasterizada y redimensionada por Telli.sh. Ilustración original

La actualización facilita conservar los límites de cada documento
Las notas de OpenBMB del 9 de noviembre indican que la versión 1.0.5 devuelve un resultado por archivo de entrada cuando recibe varios. La opción --split-images convierte imágenes sueltas en documentos separados. Los dos detalles importan en una oficina que mezcla PDF de varias páginas con fotos hechas con cámara. Una factura que ya está reunida en un PDF normalmente debe quedar junta. Dos fotografías sin relación deben seguir siendo registros distintos. Paquete y notas de MiniCPM-OCR 1.0.5
Para una evaluación pequeña, prepara un documento de cada tipo. Un PDF nítido puede establecer el orden de lectura esperado. Una hoja fotografiada puede revelar si un doblez, un giro o un reflejo provoca un segmento incorrecto. Una tabla densa muestra qué sucede cuando dos columnas contienen valores parecidos. Si el archivo tiene fotos de dos páginas del mismo registro, decide cómo agruparlas antes de dárselas al analizador. La agrupación original pertenece al documento, mientras que el comando recibe archivos.
El lote de ejemplo conserva un identificador estable por entrada y mantiene la fuente disponible durante la revisión. Ilustración de Telli.sh.
Usa un inventario de entradas que identifique el original, el número de páginas y la salida esperada. Si calculas una suma de verificación para detectar cambios accidentales, hazlo sobre el original antes de procesar el lote. Guarda las extracciones en otro destino para que una ejecución posterior no pueda sobrescribir la única fuente. Si dos carpetas contienen un archivo llamado invoice.pdf, un identificador estable mantiene clara la correspondencia aunque el nombre por sí solo sea ambiguo.
Empieza con un formato que pueda leer el siguiente proceso. El SDK de OpenBMB reúne las salidas como Markdown o JSON, según su configuración. Markdown es cómodo para quien lee un borrador. Una salida estructurada puede ayudar a otro proceso a manejar las regiones que devuelve el analizador. Ambos formatos requieren comprobar la imagen si un número o campo se usará para tomar una decisión. Flujo de análisis de OpenBMB
La configuración local tiene una fase de diseño de página y otra de reconocimiento
OpenBMB documenta dos etapas para analizar páginas completas en un ordenador. El SDK usa un modelo de diseño de página para localizar y ordenar texto, tablas, fórmulas y otras regiones. Envía recortes de esas regiones por HTTP a un servicio de reconocimiento y reúne las respuestas en orden de lectura. Las dos etapas pueden ejecutarse en equipos que controles. El servicio de reconocimiento es un entorno separado, y el SDK también puede apuntar a un servicio externo. Guía de OpenBMB para analizar páginas completas y ejecutar el servicio en local
Ese límite importa cuando un documento tiene información privada. La pregunta es adónde envía los recortes la etapa de diseño de página. Un SDK local configurado para llamar a un servicio alojado aún puede transmitir el contenido del documento por la red. La configuración local debería apuntar al servicio previsto y usar las normas de almacenamiento y registro que haya aprobado la organización. Una demo pública con un ejemplo sintético permite conocer la interfaz sin enviar un documento real de un cliente.
El 5 de noviembre OpenBMB publicó una imagen Docker con el SDK, vLLM y el modelo. La configuración documentada requiere Linux x86-64, una GPU NVIDIA, un controlador compatible con CUDA 12.9 y Docker con NVIDIA Container Toolkit. OpenBMB también documenta otros motores para el servicio de reconocimiento, como llama.cpp y Ollama. El tamaño del modelo por sí solo no dice si un equipo puede ejecutar todo el flujo con holgura. Comprueba el componente de diseño, el formato del modelo, la memoria y el rendimiento en el equipo de destino. Requisitos de despliegue de OpenBMB
También hay una opción móvil para documentos individuales. OpenBMB anunció el procesamiento sin conexión en iOS el 2 de noviembre. Una actualización del 12 de noviembre amplió la demostración en el dispositivo a Android y HarmonyOS. Trata esas demos móviles y el SDK de lotes para ordenador como formas distintas de usar el modelo. Elige según dónde estén los archivos y cómo quieras inspeccionar los resultados. Historial de versiones móviles de OpenBMB
Comprueba los campos que pueden parecer correctos y estar mal
Imagina una factura con una línea de 10 unidades a 38,50 cada una. En la tabla extraída, 38,50 aparece en la columna de cantidad y 10 en la de precio unitario. Un sistema que solo comprueba si los dos números están presentes puede darla por buena. Para quien use el resultado, la relación entre los valores y sus columnas es la información importante. Compara la fila, los encabezados y los totales en conjunto.
El riesgo es distinto en un archivo para búsquedas. Un error tipográfico en una nota descriptiva puede ser aceptable si el personal encuentra el original. Un número de pedido incorrecto puede dirigir a otro documento. Decide qué campos deben coincidir exactamente y contrástalos con el original. Si la página incluye un código, conserva los ceros iniciales al revisarlo. La presentación como número o la importación a una hoja de cálculo pueden eliminarlos incluso si el analizador los leyó bien.
| Ejemplo de documento | Qué comparar con el original | Qué decidir antes de utilizarlo |
|---|---|---|
| Facturas | Identificador de proveedor, número de factura, moneda, totales y encabezados de columnas | Qué campos requieren una coincidencia exacta |
| Informe con varias columnas | Encabezado, orden de las columnas y pies junto a las figuras | Si el resultado se lee en la secuencia correcta |
| Formulario girado o fotografiado | Nombres, casillas marcadas, sellos y entradas cerca de un pliegue | Qué páginas necesitan revisión manual o un nuevo escaneo |
| Escaneo multilingüe | Identificadores y texto de los campos en cada idioma presente | Qué idiomas cumplen los criterios del archivo |
OpenBMB describe MiniCPM-OCR 1.0 como un modelo orientado al chino y al inglés. Los equipos con páginas en coreano o varios idiomas deben medir su precisión en sus propias páginas. Una prueba práctica incluye un documento denso, un formulario limpio y una foto por cada idioma relevante. Registra el tipo de error en lugar de promediar unos pocos documentos heterogéneos en una sola puntuación. Descripción del modelo de OpenBMB
La puntuación por región ayuda a priorizar lo que se revisa
OpenBMB también publica MiniCPM-OCR Jev, un modelo separado que evalúa texto, fórmulas y tablas extraídos frente a una región de la imagen. El proyecto presenta la puntuación como una forma de encontrar regiones que podrían necesitar revisión. En un lote, puedes usarla para ordenar la cola y seguir contrastando los campos de mayor impacto con el original. Antes de dirigir la revisión con una puntuación, comprueba si coloca arriba los errores que te importan. Explicación de OpenBMB sobre MiniCPM-OCR Jev
La puntuación opcional por región ayuda a ordenar la revisión. Los campos que determinan pagos, identificadores u otras decisiones pueden requerir una comprobación directa. Ilustración de Telli.sh.
Para ver cuándo ayuda una puntuación, prepara un pequeño conjunto de referencia con fallos que el equipo ya sabe reconocer. Un carácter ausente en un número de pieza, una fila desalineada y una frase de una página limpia ponen a prueba fallos distintos. Añade algunas regiones correctas. Examina cuándo el modelo da una puntuación alta a un error o una baja a un resultado correcto. Son los casos que conviene discutir antes de fijar un umbral en el flujo.
Deja visibles las discrepancias. Si alguien corrige un total, conserva la salida original de OCR y registra el cambio respecto al documento fuente. Así puedes revisar si los errores se concentran en un tipo de documento o un método de captura. La siguiente persona también podrá distinguir una corrección humana de la primera salida del modelo.
El tiempo que dedica una persona a comprobar los resultados puede determinar si el proceso por lotes se puede ampliar. Anota cuánto cuesta resolver un problema y qué tipos de páginas requieren otra lectura. Una herramienta local puede ahorrar tiempo con documentos nítidos y añadir escaneos malos a la cola de revisión. Si falla una y otra vez el mismo formulario en papel, quizá sea más útil mejorar cómo se escanea que añadir otro modelo.
Usa un lote pequeño que pueda fallar de formas distintas
- Reúne documentos de ejemplo autorizados. Incluye un escaneo nítido, una foto girada y una tabla de varias páginas, con idiomas y diseños representativos. Conserva un identificador estable para cada original.
- Elige un método local aprobado. Para lotes en el ordenador, sigue la guía local de OpenBMB y verifica el punto de conexión del servicio de reconocimiento. Revisa los requisitos de equipo y entorno antes de cargar los archivos. Guía oficial de despliegue local
- Ejecuta el SDK y conserva los resultados por archivo. Registra versión del SDK, modelo o cuantización, motor y formato de salida. Elige cómo se agrupan las imágenes y conserva la fuente de cada resultado. Instrucciones del SDK 1.0.5
- Revisa según el propósito del archivo. Comprueba el orden de lectura para búsqueda y los campos críticos para usos posteriores. Registra qué documentos se aceptaron, corrigieron o rechazaron y por qué.
- Repite con un conjunto pequeño y nuevo. Aplica las mismas reglas. Compara el tiempo hasta acabar la revisión y la trazabilidad, y resuelve los tipos de documento que todavía requieren trabajo manual antes de aumentar el volumen.
Elige un objetivo alcanzable. Un asistente que permite buscar actas escaneadas no necesita las garantías de una herramienta que rellena un formulario de pago de facturas. Empieza con búsqueda u otro flujo reversible si esa es la necesidad inmediata. El piloto puede mostrar qué extracciones merecerán comprobaciones más fuertes más adelante.
Dale al archivo una manera sencilla de mostrar qué ha indexado. Si el resultado muestra solo el texto generado por la máquina, alguien puede tomar un texto plausible por definitivo. Pon junto al resultado el nombre del archivo de origen o su identificador y facilita localizar la página. Si la extracción tiene un estado de revisión, muéstralo también. Así las personas que usan el archivo pueden saber cuándo hace falta leer el original.
Hay una prueba de recuperación útil cuando un lote comparte un directorio de salida. Imagina que falla un archivo y lo vuelves a ejecutar con otra configuración. Verifica que los demás resultados siguen presentes y que el inventario distingue qué salida se produjo en el segundo intento. No hace falta reprocesar de manera automática. La prueba comprueba si se puede mejorar un resultado sin perder el registro de lo que produjeron los demás archivos.
El lote es útil si cada resultado lleva a la página de origen
La actualización del SDK de MiniCPM-OCR evita parte del trabajo de enviar un archivo cada vez. Lo demás depende de cómo se organice el archivo. Conserva los límites de cada documento, elige dónde se procesan las imágenes y ajusta la verificación de cada campo según lo que requiera el siguiente flujo. Si alguien encuentra un número el mes próximo, debería poder abrir la página y ver lo mismo que vio el analizador.
Fuentes
- SDK MiniCPM-OCR 1.0.5 en PyPI, 9 de noviembre de 2026
- Repositorio MiniCPM-OCR de OpenBMB, fichas de modelos, fechas y guías de despliegue
- Demostración pública de OpenBMB
- Ilustración del lanzamiento de OpenBMB y licencia
Para conservar las decisiones de revisión de un archivo documental en un registro consultable, crea una cuenta en Telli.sh.