Mercury 3 obiecuje szybsze odpowiedzi. Czy zadanie AI skończy się wcześniej?
Nowy dyfuzyjny model językowy Inception celuje w pracę interaktywną. Gdzie szybkość pomaga, jak porównywać całe zadania i dlaczego promocyjna cena potrzebuje osobnej kolumny.
Klient pyta, czy może zmienić zamówienie przed wysyłką. Asystent znajduje je, czyta zasady, sprawdza magazyn i przygotowuje odpowiedź. Każdy krok jest mały. Razem oczekiwanie zmienia prostą wymianę w powolny kontakt z bardzo zajętą osobą.
Inception wydało Mercury 3 19 października, kierując najnowszy dyfuzyjny model językowy do aplikacji z kumulującymi się przerwami. Firma podaje 1068 tokenów wyjściowych na sekundę na GPU NVIDIA i kontekst miliona tokenów. To specyfikacje dostawcy, nie gwarancja pełnej interakcji klienta. Ogłoszenie Inception.
Ciekawe jest to, co szybszy model pozwala zmienić. Korepetytor podpowiada, gdy uczeń nadal pracuje. Agent wsparcia sprawdza wyjątek przed odpowiedzią. Asystent przeglądarkowy wykonuje kolejny przydatny krok w tym samym czasie oczekiwania. Omawiamy możliwości, koszty i praktyczną ocenę, czy Mercury 3 poprawia rzeczywiste zadanie.
Sprzęt NVIDIA H100 jako kontekst wnioskowania GPU. Zdjęcie: 极客湾Geekerwan, źródło Wikimedia Commons, CC BY 3.0; zmniejszone i przekonwertowane do JPEG, znak wodny autora zachowany. Nie przedstawia infrastruktury Inception ani naszego testu i nie wskazuje sprzętu raportowanego wyniku Mercury 3.

Dyfuzja daje Inception inną drogę do szybszego tekstu
Inception to firma badawcza i produktowa sprzedająca modele językowe przez usługi hostowane. Rodzina Mercury używa dyfuzji, poprawiając tekst w wielu pozycjach zamiast polegać wyłącznie na sekwencji od lewej do prawej. Artykuł Mercury zgłoszony 17 czerwca 2025 roku opisuje metodę i ocenę wcześniejszej rodziny. To tło podejścia, nie raport benchmarku Mercury 3.
Dla odbiorcy wniosek jest prosty: kolejność obliczania tekstu wpływa na czas otrzymania użytecznej odpowiedzi przez aplikację. Nie czyni każdej odpowiedzi natychmiastową ani nie usuwa rozumowania przy trudnych pytaniach. Zmienia część pracy. Reszta aplikacji nadal pobiera informacje, decyduje i przedstawia wynik nadający się do użycia.
Pomyśl o opóźnieniu jako budżecie oczekiwania. Programista wydaje go na dłuższe wyjaśnienie, dodatkowe źródło albo wcześniejszą krótką odpowiedź. Szybszy model tworzy zapas. Korzyść zależy od sposobu jego wykorzystania.
Największe znaczenie ma to przy wielu wywołaniach. Asystent z jedną krótką odpowiedzią ma mało okazji do odzyskania czasu. Agent przeplatający czytanie, wybór działania i inspekcję wyniku płaci opóźnienie wielokrotnie. Oszczędność na powtarzanym etapie zmienia doświadczenie nawet bez spektakularnej pojedynczej odpowiedzi.
Tokeny na sekundę mierzą tylko odcinek podróży
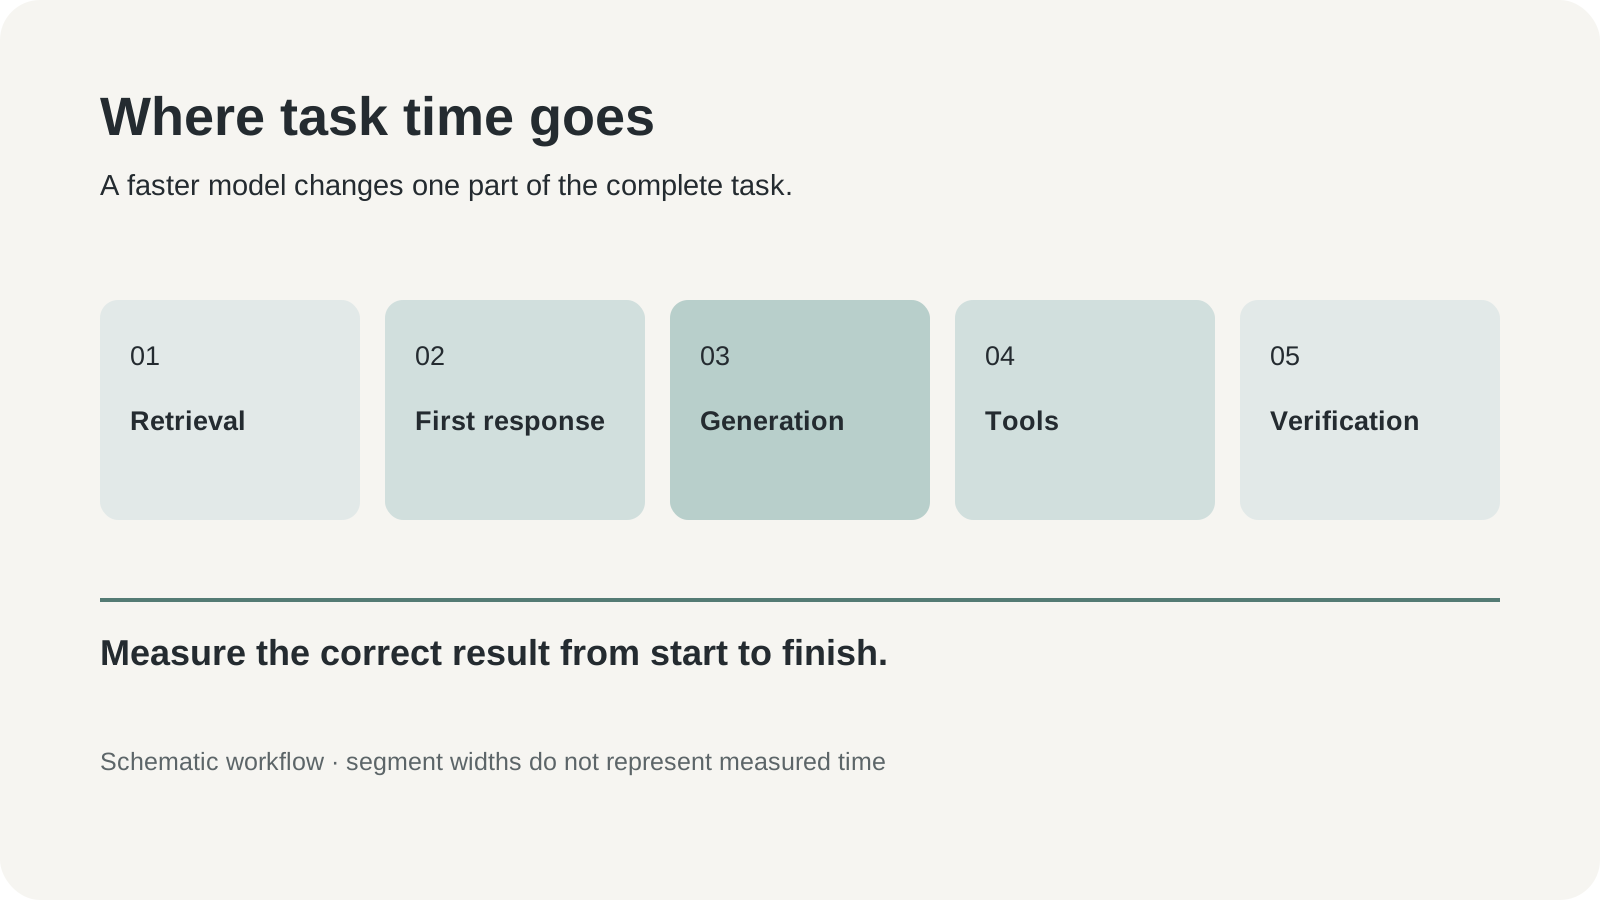
Autorska infografika etapów składających się na czas zadania. Rozmiary segmentów są schematyczne, bez zmierzonych czasów.
Funkcja AI ma kilka zegarów. Czas pierwszej odpowiedzi opisuje oczekiwanie interfejsu przed użytecznym zdarzeniem. Przepustowość wyjścia to szybkość tekstu. Opóźnienie narzędzi obejmuje wyszukiwanie, bazę i usługi zewnętrzne. Czas całego zadania zawiera kroki poprawnego wyniku, ponowienia i korekty.
Zegary mogą wskazywać różne rzeczy. System od razu przesyła pierwsze słowa i długo kończy złożone żądanie. Inny czeka, ale zwraca krótki wynik bez poprawek. Trzeci generuje szybko, lecz czeka na system zamówień. Właściwy wskaźnik zależy od pracy.
| Pomiar | Co mówi twórcy | Czego nie wyjaśnia |
|---|---|---|
| Pierwsza użyteczna odpowiedź | Czy interfejs szybko potwierdza lub posuwa żądanie | Poprawności końcowego wyniku |
| Tokeny wyjściowe na sekundę | Szybkości generowania tekstu | Wyszukiwania, kolejek i narzędzi |
| Czas całego zadania | Czasu poprawnego rezultatu | Przyczyny spowolnienia |
| Czas z poprawkami | Praktycznego kosztu akceptowalnego wyniku | Zachowania innego zadania |
Naszym zdaniem szybki model zasługuje na miejsce, gdy usuwa czas z pracy użytkownika. Krótsze generowanie jest cenne, jeśli skraca pracę albo umożliwia potrzebną kontrolę. Mniej cenne, gdy aplikacja zamienia oszczędność w zbędny tekst.
Pytanie testowe powinno być konkretne: czy zadanie przyspieszyło przy tym samym standardzie akceptacji? Następnie ustal zmieniony etap. Pozwala to odróżnić poprawę modelu od krótszego polecenia, rozgrzanej pamięci podręcznej czy szybszej usługi.
Asystent wsparcia może wydać oszczędność na lepszą odpowiedź
Rozważmy wsparcie sklepu. Klient chce zmienić adres po zamówieniu. Asystent potrzebuje statusu, zasad i poprawionych danych. Użyteczny wynik to trafny krok: dozwolona zmiana przez autoryzowane narzędzie albo wyjaśnienie potrzeby interwencji człowieka.
Szybkość pomaga w kilku miejscach. Szybkie pytanie zatrzymuje klienta w rozmowie. Szybkie czytanie zasad zostawia czas na wyjątek dla pakowanego zamówienia. Zwięzły finał potwierdza zmiany i sprawy oczekujące. Żadna poprawa nie wymaga dłuższej wiadomości.
Ocena powinna uwzględniać tarcie: klient poprawia kod pocztowy, zamówienie już wysłano, dokument zawiera wąski wyjątek. Zmierz użycie obecnej wartości zamiast pierwszej. Oddziel uprawnienie do zmiany od zdolności opisania jej.
Unikaj szybkiej pewnej odpowiedzi tworzącej więcej pracy. Jeśli klient ponownie kontaktuje się z pomocą w celu korekty, efektywność była pozorna. Zapisz ponowny kontakt i przekazanie człowiekowi obok szybkości. Tak atrakcyjna statystyka staje się decyzją operacyjną.
Korepetytor korzysta z informacji przed utratą uwagi
Drugi przykład to aplikacja edukacyjna reagująca na krótkie odpowiedzi. Uczeń wysyła zdanie w obcym języku albo pośredni krok algebry. Aplikacja identyfikuje błąd i podpowiada następny ruch. Szybkość utrzymuje uwagę przy tym samym pytaniu.
Nie zawsze potrzeba pełnego rozwiązania. Mała wskazówka może być lepsza. Odróżnij poprawną informację od nadmiernej pomocy: czy rozpoznano błąd, zachowano szansę uczenia i dopasowano język? Szybkie wyjaśnienie na złym poziomie również przerywa lekcję.
Zbuduj próbkę z wieloma poprawnymi odpowiedziami i celowo niejednoznacznymi. Poproś najpierw o jedną wskazówkę. Dodaj ucznia zmieniającego odpowiedź i sprawdź reakcję na poprawkę. To bada podążanie za nauką zamiast tworzenia klucza.
W korepetytorze głosowym model tekstowy jest częścią. Rozpoznawanie, obsługa tur i synteza dodają czas i błędy. Testuj pełną rozmowę przed przeliczaniem przepustowości tekstu na responsywność. Szybki etap tworzy zapas, lecz naturalność nadal zależy od audio.
Agenci przeglądarkowi potrzebują zegara i reguły zatrzymania
Trzeci przykład to porównanie obecnych warunków dostawców na publicznych stronach. Agent czyta, wybiera link, wydobywa warunek i sprawdza źródło. Szybsze wywołania ograniczają oczekiwanie, ale kuszą do dalszego przeglądania, bo kolejny krok jest tani.
Zdefiniuj ukończenie przed pomiarem: dla każdego kandydata jest datowana cena, ograniczenie usługi i źródło. Agent powinien skończyć po spełnieniu wymagań albo zgłosić brak po ograniczonym szukaniu. Następne wywołanie jest wartościowe, gdy usuwa nazwaną niewiadomą.
Zadanie wymaga też granic działań. Czytanie publicznego różni się od wysłania formularza, zmiany konta czy zakupu. Wymiana modelu powinna zachować uprawnienia i potwierdzenia. Szybkość przyspiesza błędne działanie, nie czyni go właściwszym.
Porównuj zadania udane i nieudane osobno. Gdy jeden model kończy wcześnie, a drugi eksploruje, średnia może ukryć różnicę. Zachowaj liczbę kroków, awarie narzędzi i braki dowodów obok czasu. Wynik ma wyjaśniać zakończenie, nie sam czas działania.
Tabela cen potrzebuje kolumny po promocji
Strona modeli Inception, sprawdzona 23 października, podaje 0,20 USD za milion tokenów wejścia i 0,70 USD wyjścia, z rabatem startowym do 0,10 i 0,35 USD. Wejście z pamięci podręcznej ma osobne stawki. Strona nie podaje końca promocji, więc budżet powinien zachować wariant cennikowy.
| Kategoria bezpośredniego API | Cena za milion tokenów | Cena startowa za milion |
|---|---|---|
| Wejście | 0,20 USD | 0,10 USD |
| Wejście z pamięci podręcznej | 0,02 USD | 0,01 USD |
| Wyjście | 0,70 USD | 0,35 USD |
Dla przykładowych 100 milionów tokenów wejścia bez cache i 20 milionów wyjścia rachunek wynosi 34 USD zwykle i 17 USD w promocji. Przykład zakłada dokładnie te wolumeny i pomija inne usługi. Porównuje ceny, nie przewiduje kosztu rzeczywistego wsparcia.
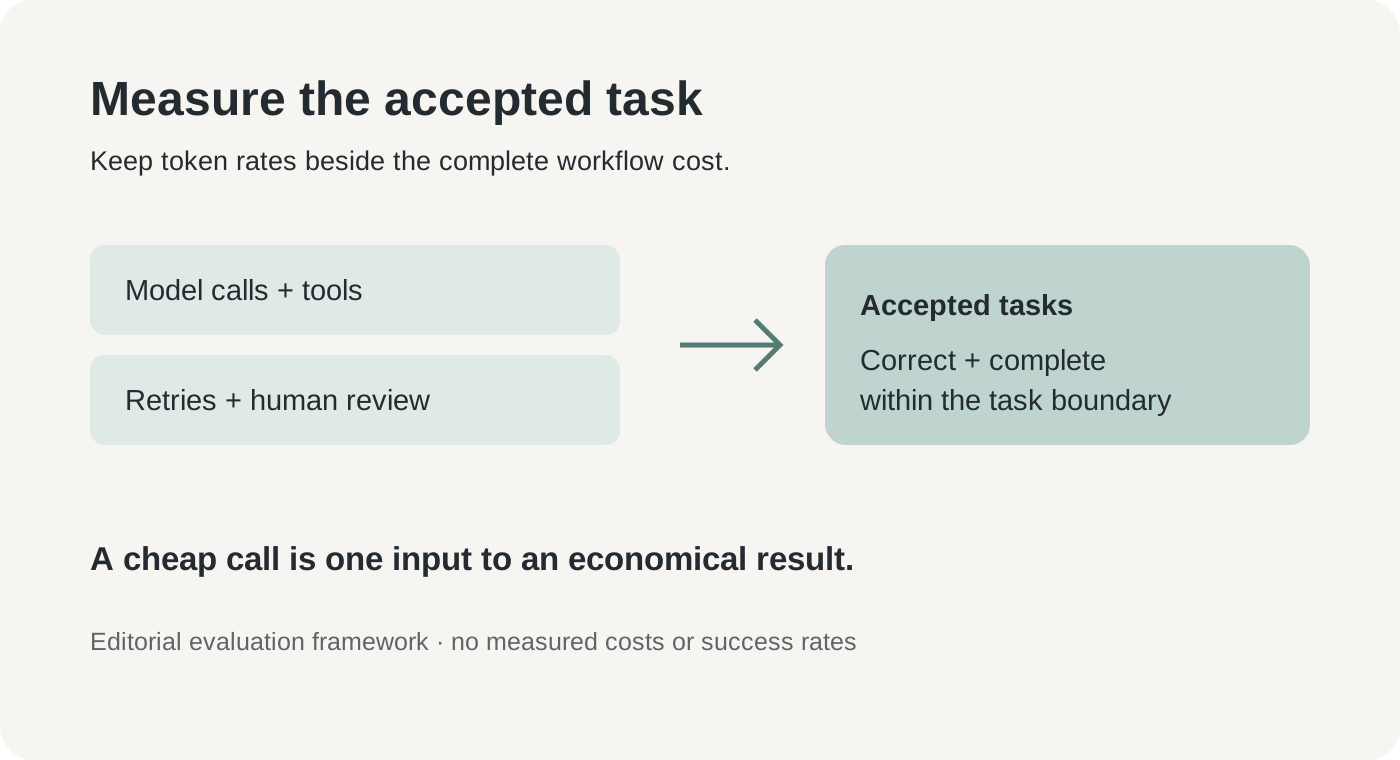
Autorski schemat oceny. Zestawia łączne zasoby z przyjętymi zadaniami; bez zmierzonych kosztów i skuteczności produktu.
Tanie wywołanie może należeć do drogiego procesu. Pobieranie, przeglądarka, mowa, ludzki przegląd i ponowienia zmieniają sumę. Droższe wywołanie może być oszczędne, jeśli unika kilku porażek. Śledź koszt zaakceptowanego zadania obok tokenów.
Cache wymaga tej samej dyscypliny. Nie zakładaj kwalifikacji każdego powtarzanego dokumentu. Rejestruj rzeczywisty rachunek i warunki wybranej ścieżki. Model na kilku platformach może mieć inne warunki, limity i ceny. Zachowaj ścieżkę udostępniania w porównaniu.
Zacznij od małego odtworzenia i zmień jeden komponent
Szybki start Inception, sprawdzony 23 października, wskazuje mercury-3, SDK i zgodny endpoint chat-completions. To praktyczna integracja dla obecnej aplikacji. Zgodność ułatwia pierwszy request, ale zachowanie poleceń i niezawodność wymagają własnej oceny.
- Wybierz odwracalne zadanie. Zacznij od szkicu lub podpowiedzi do sprawdzenia. Zbierz dozwoloną próbkę z kryterium każdego przypadku.
- Zapisz bazę. Zachowaj model, polecenia, rozmiary wejścia, limity wyjścia i wyniki narzędzi, a także przyjęty rezultat i czas.
- Utwórz konto i klucz Inception. Przechowuj klucz w zmiennej środowiska lub menedżerze sekretów. Przed serią sprawdź rozliczenia i kontrolę zużycia.
- Wykonaj udokumentowane żądanie z
mercury-3. Nie zmieniaj zadania i kryteriów. Zapisz ustawienia, w tym reasoning effort i limit wyjścia, dla powtarzalności. - Obejrzyj błędy przed poszerzeniem ruchu. Sprawdź fakty, brak warunków, schematy i zbędne wywołania. Powtórz reprezentatywne przypadki dla zmienności.
- Uruchom pilotaż z powrotem. Zachowaj poprzedniego dostawcę, limit zużycia i monitorowanie czasu oraz kosztu przyjętych zadań.
Minimalny przykład Python oficjalnego SDK można dostosować do niewrażliwego polecenia:
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
Następnym użytecznym materiałem jest arkusz poprawnych wyników i porażek. Udane żądanie potwierdza połączenie, nie identyczność wszystkich ustawień, schematów i poleceń istniejącej aplikacji.
Jakość i kontrola danych należą obok szybkości
Porównania Inception zachęcają w docelowej kategorii, ale zdolność ogólna i dopasowanie do obciążenia to inne pytania. Niezależna strona Mercury 3 w Vals AI, sprawdzona 23 października, pokazuje zadania z własnymi ustawieniami. Wyniki należy czytać w definicjach testów, nie łączyć z przepustowością dostawcy w ranking uniwersalny.
Przydatniejszy nawyk to badanie nierówności. Model bywa świetny w krótkich odpowiedziach strukturalnych i słabszy w specjalistycznym zadaniu uznawanym za rutynowe. Umieść trudne przypadki wcześnie. Zbiór samych sukcesów niewiele mówi o potrzebie pomocy ludziom.
Obsługa danych zależy od usługi i umowy. Warunki Inception opisują rezygnację z treningu w ustawieniach konta, a strona enterprise konfigurowalną retencję i wdrożenie. Sprawdź ścieżkę i kontrakt przed materiałami klientów. Na początek użyj przykładów syntetycznych lub autoryzowanych.
Dla obecnych użytkowników ważna jest data: strona mówi, że klienci używający Mercury 2 lub 2.5 przed 19 października zachowują dostęp do 15 listopada 2026 roku, z enterprise według umów. Migracja wymaga zaplanowanego odtworzenia i powrotu. Znajomość starego polecenia nie zastępuje kontroli na nowym modelu.
Szybsze generowanie powinno kupować przydatniejszy następny krok
Mercury 3 zachęca do traktowania szybkości wnioskowania jako wyboru projektowego. Szansą jest czas na korektę, źródło lub podpowiedź, która wciąż pomaga. Ryzykiem — więcej niesprawdzonej pracy. Kolejnym znaczącym dowodem będzie niezawodność pełnych zadań zlecanych przez ludzi.
Dobry pilotaż kończy się konkretem: proces przyspieszył przy tym samym standardzie albo nie. To skromniejsze od uznania modelu za najszybszy we wszystkim. Zarazem daje zespołowi podstawę do wydania lepszego doświadczenia.
Źródła
- Ogłoszenie Mercury 3 Inception, 19 października 2026; szybkość i kontekst są deklaracjami dostawcy.
- Komunikat premiery, 19 października 2026.
- Modele, ceny i migracja Inception, sprawdzono 23 października 2026.
- Szybki start API Inception, sprawdzono 23 października 2026.
- Artykuł badawczy Mercury, zgłoszony 17 czerwca 2025; wcześniejsza rodzina.
- Benchmark Mercury 3 Vals AI, sprawdzono 23 października 2026.
- Warunki Inception i kontrola enterprise, sprawdzono 23 października 2026.
Zachowaj porównanie do przeglądu
Jeśli potrzebujesz osobnego miejsca na autoryzowane źródła i notatki stojące za wyborem modelu, jedną z możliwości jest Telli.sh. Zacznij od notatki.