Mercury 3 promette risposte più rapide. Il tuo compito finirà prima?
Il nuovo modello linguistico a diffusione di Inception punta al lavoro interattivo. Ecco dove conta la velocità, come confrontare compiti completi e perché separare i prezzi promozionali.
Un cliente chiede se può modificare un ordine prima della spedizione. L'assistente trova l'ordine, legge le condizioni, controlla lo stato in magazzino e prepara una risposta. Ogni passaggio sembra breve. Insieme, le attese possono trasformare uno scambio semplice in una lenta conversazione con qualcuno molto occupato.
Inception ha lanciato Mercury 3 il 19 ottobre, destinando il suo nuovo modello linguistico a diffusione alle applicazioni in cui queste pause si accumulano. L'azienda dichiara 1.068 token di output al secondo su GPU NVIDIA e una finestra di contesto di 1 milione di token. Sono specifiche del produttore, non una garanzia per un'interazione completa con il cliente. Annuncio di Inception.
La domanda interessante è che cosa permetta di cambiare un modello più veloce. Un tutor può offrire un suggerimento mentre lo studente sta ancora lavorando. Un assistente può verificare un'eccezione prima di rispondere. Un agente web può completare un altro passaggio utile nella stessa attesa. Questa guida illustra tali possibilità, i relativi costi e un metodo concreto per valutare se Mercury 3 migliori davvero il vostro compito.
Hardware NVIDIA H100 come contesto per l'inferenza su GPU. Foto: 极客湾Geekerwan, fonte Wikimedia Commons, CC BY 3.0; ridimensionata e convertita in JPEG, filigrana dell'autore conservata. Non mostra l'infrastruttura di Inception né un nostro benchmark e non identifica l'hardware usato per il risultato dichiarato di Mercury 3.

La diffusione offre a Inception una strada diversa verso un testo più rapido
Inception è un'azienda di ricerca e prodotti AI che vende modelli linguistici tramite servizi ospitati. La famiglia Mercury usa la diffusione, un metodo che affina il testo in più posizioni anziché affidarsi interamente a una sequenza da sinistra a destra. Il paper Mercury, presentato il 17 giugno 2025, descrive metodo e valutazione della famiglia precedente. Spiega l'approccio, senza costituire un rapporto di benchmark su Mercury 3.
L'implicazione per il lettore è semplice: l'ordine con cui un modello calcola il testo può influire sul tempo necessario a ottenere una risposta utile. Non rende istantanea ogni risposta e non elimina il ragionamento richiesto dalle domande difficili. Cambia una parte del lavoro di produzione della risposta. L'applicazione deve comunque raccogliere informazioni, decidere come usarle e presentare qualcosa di utilizzabile.
Pensate alla latenza come a un budget di attesa. Uno sviluppatore può spenderlo per una spiegazione più lunga, una fonte aggiuntiva o una risposta più breve restituita prima. Un modello più veloce libera spazio nel budget. Il vantaggio per l'utente dipende da come l'applicazione lo impiega.
Questo conta soprattutto quando il modello viene chiamato ripetutamente. Un assistente che produce una breve risposta offre poche occasioni di recuperare tempo. Un agente che alterna lettura, scelta di un'azione e controllo del risultato paga molte volte il ritardo del modello. Risparmiare in una fase ricorrente può cambiare l'esperienza anche se nessuna singola risposta sembra eccezionale.
I token al secondo misurano soltanto una parte del percorso
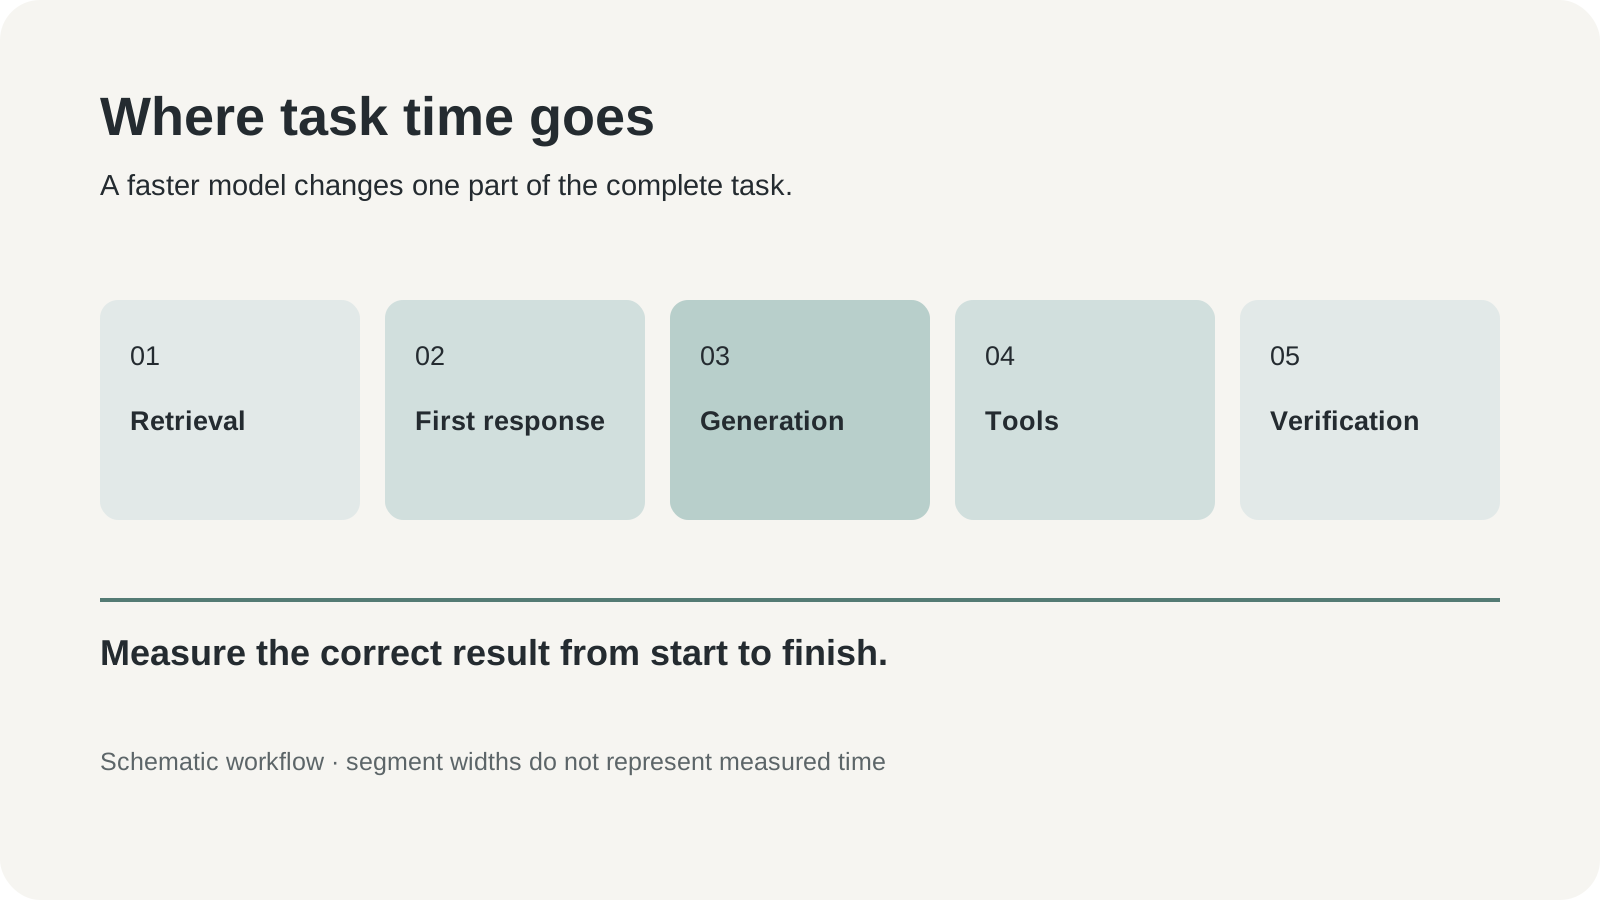
Infografica editoriale originale: fasi che possono contribuire al tempo di completamento. Le dimensioni dei segmenti sono schematiche, senza durate misurate.
Una funzione AI contiene diversi orologi. Il tempo alla prima risposta indica quanto l'interfaccia sembri attendere prima che accada qualcosa di utile. La velocità di output indica quanto rapidamente arriva il testo. La latenza degli strumenti comprende ricerca, database e servizi esterni. Il completamento include tutti i passaggi necessari a un risultato corretto, compresi tentativi e correzioni.
Questi orologi possono divergere. Un sistema può iniziare subito a mostrare parole e impiegare molto a terminare una richiesta complessa. Un altro può aspettare prima di restituire una risposta compatta che non richiede correzioni. Un terzo può generare rapidamente e passare quasi tutto il tempo in attesa del sistema ordini. La misura importante per l'utente dipende dal lavoro.
| Misura | Che cosa dice allo sviluppatore | Che cosa non chiarisce |
|---|---|---|
| Prima risposta utile | Se l'interfaccia riconosce o fa avanzare prontamente la richiesta | Se il risultato finale sarà corretto |
| Token di output al secondo | Quanto rapidamente viene prodotto testo | Ricerca, code dei servizi e attese degli strumenti |
| Tempo del compito completo | Quanto richiede un risultato corretto | Quale componente causa il rallentamento |
| Tempo comprese le correzioni | Il costo pratico di arrivare a un risultato accettabile | Il comportamento su altri compiti |
La nostra lettura: un modello veloce merita spazio quando riduce il lavoro dell'utente. Una generazione più breve conta se accorcia quel lavoro o rende sostenibile una verifica necessaria. Conta meno se il risparmio serve soltanto a produrre più testo del necessario.
Rendete concreto il confronto. Il compito è diventato più rapido a parità di criterio di accettazione? Quale fase è cambiata? Così è più facile distinguere un miglioramento del modello da un prompt più breve, una cache già pronta o un servizio esterno più veloce.
Un assistente può investire il risparmio in una risposta migliore
Consideriamo un esempio ipotetico di assistenza al dettaglio. Un cliente vuole cambiare l'indirizzo di consegna dopo l'ordine. L'assistente deve conoscere stato dell'ordine, regole per le modifiche e dati corretti. Il risultato utile è un passo successivo preciso: effettuare una modifica consentita tramite uno strumento autorizzato oppure spiegare perché occorre l'intervento di una persona.
La velocità aiuta in più punti. Una domanda tempestiva può evitare che il cliente abbandoni la conversazione. Leggere rapidamente la politica può lasciare tempo per verificare l'eccezione di un ordine già in preparazione. Una conclusione concisa può confermare che cosa è cambiato e che cosa resta in sospeso. Nessuno di questi vantaggi richiede messaggi più lunghi.
La valutazione dovrebbe includere gli attriti ordinari. Presentate un cliente che corregge il codice postale, un ordine già spedito e una politica con un'eccezione circoscritta. Verificate che il modello usi il dato aggiornato anziché il primo ricevuto. Tenete distinto il permesso di modificare qualcosa dalla capacità di descrivere la modifica.
L'errore da evitare è una risposta rapida e sicura che genera altro lavoro. Se il cliente deve ricontattare l'assistenza, la prima risposta era efficiente soltanto in apparenza. Registrate il seguito e il passaggio a un operatore insieme alla velocità iniziale. È così che una statistica interessante diventa una decisione operativa utile.
Il tutor aiuta quando il feedback arriva prima che l'attenzione si sposti
Un secondo caso ipotetico è un'app didattica che reagisce a risposte brevi. Lo studente invia una frase in una lingua straniera o un passaggio di algebra. L'app deve individuare l'errore pertinente e proporre una mossa adeguata. Una risposta rapida può mantenerlo concentrato sulla stessa domanda.
Non serve sempre una soluzione completa. Un piccolo indizio può valere più di uno svolgimento integrale. Distinguete feedback corretto e assistenza eccessiva: l'app ha identificato l'errore, preservato l'occasione di imparare e usato un linguaggio adatto? Una spiegazione rapida ma di livello sbagliato interrompe comunque la lezione.
Preparate esempi con più risposte accettabili e altri volutamente ambigui. Chiedete un indizio prima della spiegazione completa. Includete uno studente che cambia risposta e controllate che l'app reagisca alla revisione. Questi casi mostrano se il modello segue l'interazione educativa anziché limitarsi a produrre il risultato.
Per un tutor vocale, il modello testuale è un componente. Riconoscimento vocale, gestione dei turni e sintesi aggiungono tempi ed errori propri. Provate l'interazione parlata completa prima di trasformare la velocità testuale in una promessa di reattività conversazionale. Il testo veloce può creare margine, mentre l'audio continua a determinare la naturalezza dello scambio.
Gli agenti web hanno bisogno di un cronometro e di una regola di arresto
Un terzo caso riguarda un assistente che confronta le condizioni aggiornate di fornitori su pagine pubbliche. Legge una pagina, sceglie un link, estrae una condizione e verifica un'altra fonte. Chiamate più rapide riducono le attese ripetute. Possono anche incoraggiare a navigare ancora, perché un altro passaggio costa poco.
Definite il completamento prima di misurare la velocità. Per esempio, il compito termina quando per ciascun candidato sono disponibili prezzo datato, limitazione del servizio e fonte. L'assistente dovrebbe fermarsi quando soddisfa questi requisiti, oppure segnalare una voce mancante dopo una ricerca limitata. Un'altra chiamata è utile se risolve un'incertezza precisa.
Servono anche confini d'azione. Leggere informazioni pubbliche è diverso da inviare un modulo, modificare un account o comprare. Sostituire il modello deve preservare permessi e conferme esistenti. Eseguire più rapidamente significa anche commettere prima un'azione sbagliata; non la rende più appropriata.
Confrontate separatamente compiti riusciti e falliti. Se un modello si ferma presto e un altro esplora più a lungo, una sola media nasconde la differenza. Affiancate al tempo numero di passaggi, errori degli strumenti e prove mancanti. Il risultato deve spiegare come il compito è finito, non soltanto quanto è durato.
Il listino richiede una colonna per il dopo promozione
Al controllo del 23 ottobre, la pagina modelli di Inception indica 0,20 dollari per milione di token in ingresso e 0,70 in uscita, ridotti dalla promozione a 0,10 e 0,35. L'input in cache ha tariffe distinte. La pagina non indica la scadenza della promozione: il budget dovrebbe conservare anche il caso a listino.
| Categoria dell'API diretta | Listino per 1 milione di token | Lancio per 1 milione di token |
|---|---|---|
| Input | $0.20 | $0.10 |
| Input in cache | $0.02 | $0.01 |
| Output | $0.70 | $0.35 |
Per un carico ipotetico di 100 milioni di token in ingresso non in cache e 20 milioni in uscita, il conto è 34 dollari a listino e 17 in promozione. L'esempio assume esattamente quei volumi ed esclude altri servizi. Serve a confrontare due regimi tariffari, non a stimare la spesa reale dell'assistenza.
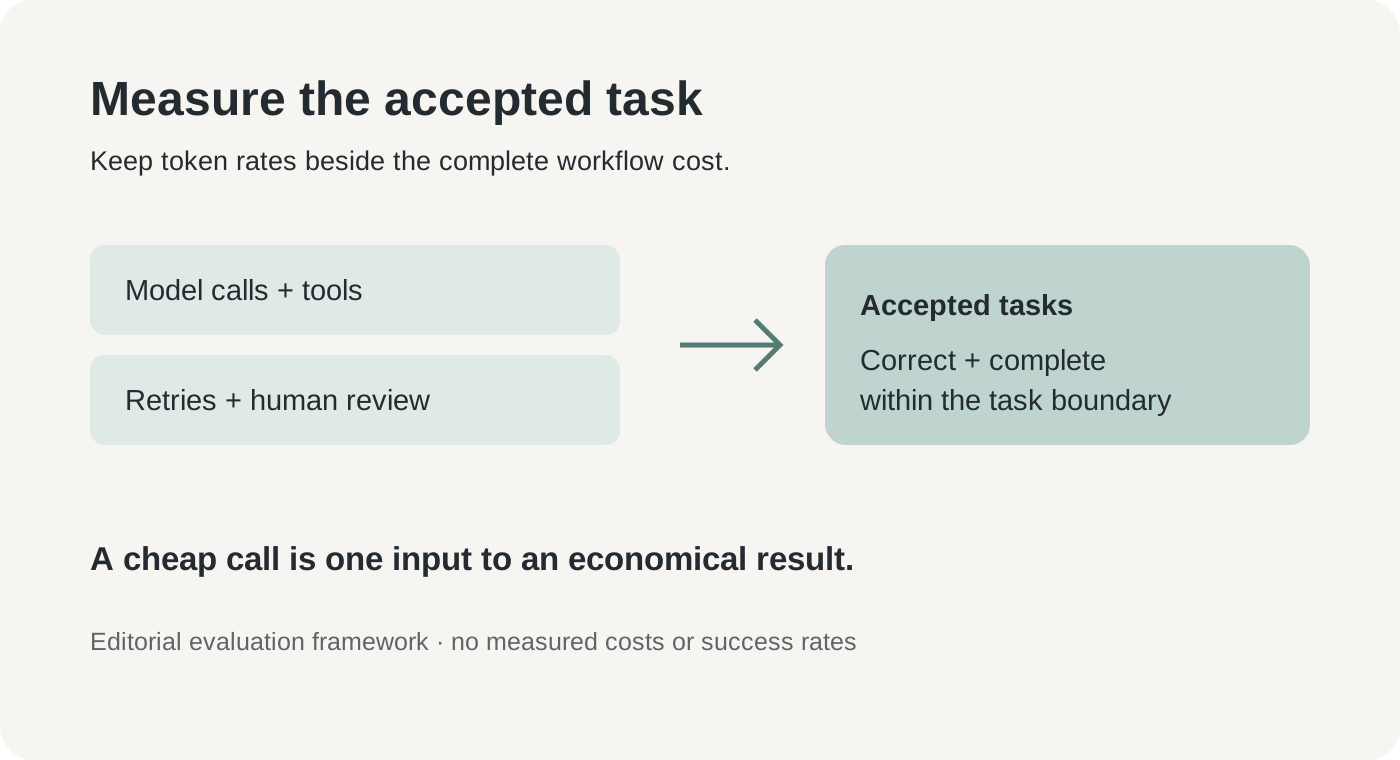
Schema editoriale originale di valutazione. Confrontate risorse totali e numero di compiti accettati; non rappresenta costi o tassi di successo misurati.
Una chiamata economica può appartenere a un flusso costoso. Recupero dei dati, browser, audio, revisione umana e tentativi ripetuti cambiano il totale. Al contrario, una chiamata più cara può convenire se evita vari insuccessi. Misurate il costo per compito accettato oltre al prezzo dei token.
La cache richiede la stessa disciplina. Non presumete che ogni documento ripetuto benefici della tariffa ridotta. Registrate gli addebiti effettivi e applicate le condizioni documentate per il fornitore scelto. Lo stesso modello su piattaforme diverse può avere condizioni, limiti e prezzi diversi. Annotate il percorso di erogazione nel confronto.
Iniziate con una piccola riproduzione, poi cambiate un componente
La guida iniziale di Inception, controllata il 23 ottobre, identifica il modello come mercury-3 e documenta SDK ed endpoint compatibile chat-completions. È un percorso pratico per integrare un'app esistente. La compatibilità facilita la prima richiesta; comportamento dei prompt e affidabilità del flusso richiedono verifiche proprie.
- Scegliete un compito reversibile. Una bozza di risposta o un suggerimento verificabile. Raccogliete un piccolo campione autorizzato con criteri espliciti per ogni caso.
- Salvate il riferimento iniziale. Registrate modello attuale, prompt, dimensioni degli input, limiti di output e risultati degli strumenti. Conservate risposta accettata e tempo per ogni caso.
- Create account e chiave API Inception. Conservate la chiave in una variabile d'ambiente o nel gestore dei segreti. Controllate fatturazione e limiti prima di un lotto di richieste.
- Eseguite la richiesta documentata con
mercury-3. Mantenete invariati compito e criteri. Registrate impostazioni, sforzo di ragionamento e limite di output per poter ripetere il confronto. - Esaminate gli errori prima di ampliare il traffico. Controllate fatti errati, condizioni mancanti, schemi non validi e chiamate inutili. Ripetete casi rappresentativi per capire la variabilità.
- Avviate un progetto pilota con ritorno possibile. Tenete disponibile il vecchio fornitore, fissate un tetto di utilizzo e osservate tempo e costo dei compiti accettati nel traffico normale.
Come punto di partenza minimo in Python, l'esempio SDK ufficiale può essere adattato a un prompt non sensibile:
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
L'artefatto successivo utile è un foglio di confronto con risultati corretti e fallimenti. Una richiesta riuscita prova la connettività. Non prova che ogni impostazione, schema di strumento o prompt dell'app precedente si comporti allo stesso modo.
Qualità e controllo dei dati vanno affiancati alla velocità
I confronti di lancio di Inception sono incoraggianti per la categoria scelta, ma capacità generale e adattamento al lavoro sono questioni diverse. La pagina Mercury 3 di Vals AI, valutatore indipendente, riporta risultati su vari compiti con impostazioni proprie, al controllo del 23 ottobre. Leggeteli entro le definizioni di quei benchmark, senza combinarli con la velocità del produttore in una classifica universale.
È più utile esaminare le disomogeneità. Un modello può eccellere nelle risposte brevi strutturate e risultare più debole in un compito specialistico che per voi è ordinario. Inserite presto i casi difficili nel pilota. Una raccolta di soli successi dice poco su dove servirà aiuto umano.
La gestione dei dati varia secondo servizio e accordo. I termini di Inception descrivono un'opzione per escludere i dati dall'addestramento, mentre la pagina enterprise offre controlli configurabili su conservazione e distribuzione. Verificate percorso e contratto prima di inviare materiale dei clienti. Per il primo confronto usate esempi sintetici o debitamente autorizzati.
Per gli utenti esistenti c'è una data concreta: la pagina modelli dice che chi ha usato Mercury 2 o 2.5 prima del 19 ottobre mantiene l'accesso fino al 15 novembre 2026, con supporto enterprise regolato dagli accordi. La migrazione merita una riproduzione programmata e un piano di ritorno. La familiarità con un vecchio prompt non sostituisce la verifica sul nuovo modello.
La generazione più rapida dovrebbe comprare un passo successivo migliore
Mercury 3 invita a considerare la velocità d'inferenza una scelta progettuale. L'opportunità è usare il tempo recuperato per correggere, verificare una fonte o dare feedback quando serve ancora. Il rischio è produrre più lavoro non revisionato. La prossima prova significativa sarà un comportamento affidabile nei compiti completi richiesti dalle persone.
Un buon pilota termina con una risposta precisa: questo flusso è diventato più rapido allo stesso standard, oppure no. È un'affermazione più circoscritta che dichiarare un modello il più veloce in tutto. È anche quella che permette a un gruppo di migliorare concretamente l'esperienza.
Fonti
- Annuncio Mercury 3 di Inception, 19 ottobre 2026; velocità e contesto sono specifiche del produttore.
- Comunicato di lancio dell'azienda, 19 ottobre 2026.
- Modelli, prezzi e migrazione Inception, verificati il 23 ottobre 2026.
- Guida iniziale all'API, verificata il 23 ottobre 2026.
- Paper Mercury, presentato il 17 giugno 2025; contesto della famiglia precedente.
- Benchmark Mercury 3 di Vals AI, verificati il 23 ottobre 2026.
- Termini Inception e controlli enterprise, verificati il 23 ottobre 2026.
Conservate il confronto per poterlo riesaminare
Se cercate uno spazio separato per fonti autorizzate e note alla base della scelta di un modello, Telli.sh è un'opzione. Iniziate con una nota.