Mercury 3 promet des réponses plus rapides. Votre tâche d’IA sera-t-elle terminée plus tôt ?
Le nouveau modèle de langage à diffusion d’Inception vise les usages interactifs. Voici où sa vitesse peut compter, comment comparer des tâches complètes et pourquoi distinguer le tarif de lancement.
Un client demande s’il peut modifier une commande avant son expédition. L’assistant retrouve la commande, lit les conditions, vérifie l’état de préparation à l’entrepôt et prépare sa réponse. Chaque étape paraît courte. Mais leur accumulation peut donner à un échange simple l’allure d’une connexion lente avec une personne très occupée.
Inception a lancé Mercury 3 le 19 octobre, en destinant son nouveau modèle de langage à diffusion aux applications où ces pauses s’additionnent. L’entreprise annonce 1 068 tokens de sortie par seconde sur des GPU NVIDIA, ainsi qu’une fenêtre de contexte d’un million de tokens. Ce sont les caractéristiques annoncées par le fournisseur, pas une garantie pour une interaction client complète. Annonce d’Inception.
La question intéressante est ce qu’un modèle plus rapide permet de changer. Un tuteur peut donner un indice pendant que l’élève travaille encore. Un agent d’assistance peut vérifier une exception avant de répondre. Un assistant de navigation peut effectuer une étape utile supplémentaire dans le même temps d’attente. Ce guide examine ces possibilités, leurs coûts et une méthode pratique pour déterminer si Mercury 3 améliore la tâche que vous devez réellement accomplir.
Matériel NVIDIA H100 présenté pour illustrer le contexte de l’inférence sur GPU. Photo : 极客湾Geekerwan, source Wikimedia Commons, CC BY 3.0 ; image redimensionnée et convertie en JPEG, filigrane de l’auteur conservé. Il ne s’agit ni de l’infrastructure d’Inception ni de notre banc d’essai, et cette photo n’identifie pas le matériel utilisé pour le résultat annoncé de Mercury 3.

La diffusion offre à Inception une autre voie vers un texte plus rapide
Inception est une entreprise de recherche et de produits d’IA qui commercialise ses modèles de langage par des services hébergés. Sa famille Mercury utilise la diffusion, une approche qui affine le texte à plusieurs positions au lieu de dépendre entièrement d’une séquence de gauche à droite. L’article de recherche sur Mercury, soumis le 17 juin 2025, décrit la méthode et l’évaluation de la famille précédente. Il éclaire l’approche, sans constituer un rapport de performances de Mercury 3.
La conséquence pour l’utilisateur est simple : l’ordre dans lequel un modèle calcule le texte peut modifier le délai nécessaire pour qu’une application obtienne une réponse utile. Cela ne rend pas chaque réponse instantanée et ne supprime pas le raisonnement nécessaire aux questions difficiles. Une partie du travail de production change. Le reste de l’application doit toujours obtenir des informations, décider comment les utiliser et présenter quelque chose d’exploitable.
Pensez à la latence comme à un budget d’attente. Un développeur peut le consacrer à une explication plus longue, à la vérification d’une source supplémentaire ou à une réponse plus courte livrée plus tôt. Un modèle plus rapide libère de la place dans ce budget. Le bénéfice dépend de la manière dont l’application l’utilise.
Cela compte surtout lorsque le modèle est sollicité plusieurs fois. Un assistant qui fournit une seule réponse courte offre relativement peu d’occasions de gagner du temps. Un agent qui alterne lecture, choix d’une action et examen du résultat peut subir à de nombreuses reprises le délai du modèle. Réduire ce délai à une étape récurrente peut transformer l’expérience sans qu’une réponse isolée paraisse spectaculaire.
Les tokens par seconde ne mesurent qu’une partie du parcours
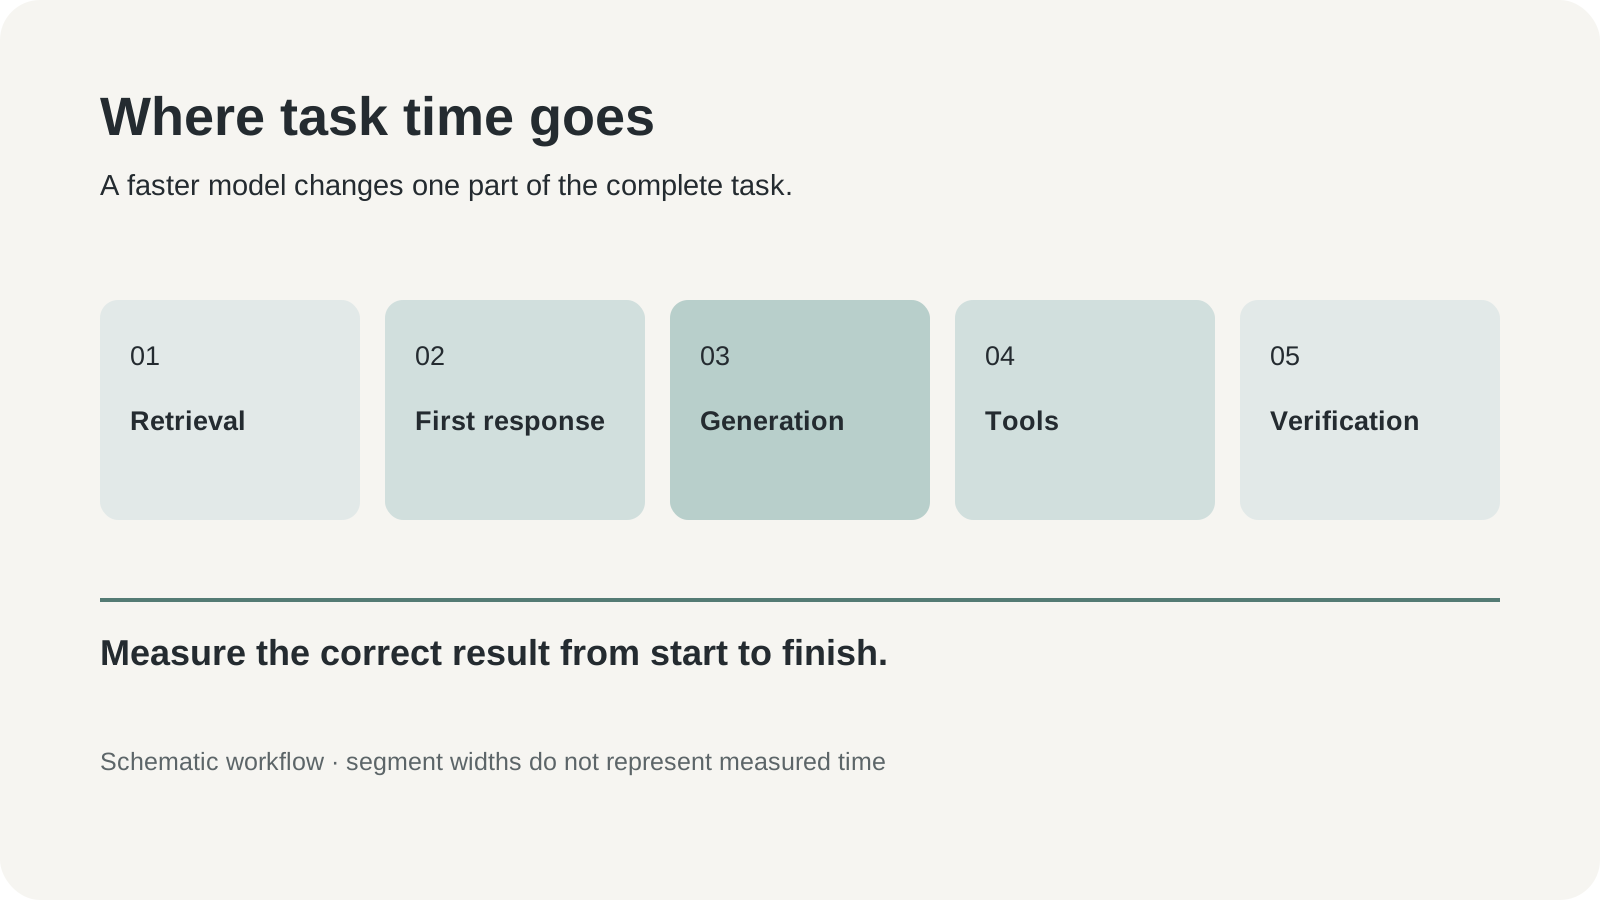
Infographie éditoriale originale : étapes susceptibles de contribuer au temps d’achèvement d’une tâche. La taille des segments est schématique et ne représente aucune durée mesurée.
Une fonctionnalité d’IA comporte plusieurs chronomètres. Le délai avant la première réponse décrit l’attente visible avant qu’un événement utile se produise. Le débit de sortie mesure la vitesse d’arrivée du texte généré. La latence des outils couvre la recherche, la base de données ou le service externe contacté. Le temps d’achèvement inclut toutes les étapes nécessaires à un résultat correct, y compris les tentatives supplémentaires et les corrections.
Ces mesures peuvent évoluer dans des directions différentes. Un système peut afficher ses premiers mots immédiatement et mettre longtemps à terminer une demande complexe. Un autre peut attendre avant de livrer une réponse concise qui ne nécessite aucune correction. Un troisième peut générer rapidement tout en passant l’essentiel de l’interaction à attendre le système de commandes. La mesure qui compte pour l’utilisateur dépend du travail demandé.
| Mesure | Ce qu’elle indique au concepteur | Ce qu’elle ne dit pas |
|---|---|---|
| Première réponse utile | Si l’interface reconnaît la demande ou la fait progresser rapidement | Si le résultat final sera correct |
| Tokens de sortie par seconde | La vitesse de production du texte pendant la génération | Le temps de recherche, les files d’attente et les délais des outils |
| Durée de la tâche complète | Le temps nécessaire à un résultat correct | Le composant responsable d’un ralentissement |
| Durée avec corrections | Le coût pratique pour obtenir un résultat acceptable | Si une autre tâche se comporterait de la même manière |
Notre avis : un modèle rapide mérite sa place lorsqu’il réduit le temps consacré au travail de l’utilisateur. Une génération plus courte est précieuse si elle raccourcit ce travail ou rend une vérification nécessaire possible. Elle l’est moins si l’application emploie le gain à produire davantage de texte que personne ne souhaite lire.
Gardez une question concrète pour le test : la tâche est-elle devenue plus rapide à niveau d’acceptation égal ? Demandez ensuite quelle étape a changé. Cela permet de distinguer une amélioration du modèle d’un prompt plus court, d’un cache déjà alimenté ou d’un service externe plus rapide.
Un assistant d’assistance peut investir ce gain dans une meilleure réponse
Prenons un exemple de service client dans le commerce. Une personne souhaite modifier son adresse de livraison après avoir commandé. L’assistant a besoin de l’état de la commande, des règles de modification et des coordonnées corrigées. Le résultat utile est une prochaine étape exacte : effectuer une modification autorisée au moyen d’un outil habilité ou expliquer pourquoi une intervention humaine est nécessaire.
La vitesse aide à plusieurs moments. Une demande de précision rapide peut éviter que le client quitte la conversation. Une lecture rapide des conditions peut laisser le temps de vérifier l’exception applicable à une commande déjà en préparation. Une réponse finale concise peut confirmer ce qui a changé et ce qui reste en attente. Aucune de ces améliorations ne nécessite un message plus long.
L’évaluation doit inclure les difficultés ordinaires. Proposez un client qui corrige son code postal, une commande déjà expédiée et un document de conditions comportant une exception étroite. Vérifiez que l’assistant emploie la valeur actuelle plutôt que la première reçue. Distinguez l’autorisation de modifier une commande de la capacité à décrire cette modification.
L’échec à éviter est une réponse rapide et assurée qui crée du travail supplémentaire. Si le client doit recontacter l’assistance pour corriger le résultat, la première réponse n’était efficace qu’en apparence. Consignez le suivi et le transfert à un humain avec la vitesse initiale. C’est ainsi qu’une statistique séduisante devient une décision opérationnelle utile.
Un tuteur gagne à répondre avant que l’attention se déplace
Un deuxième exemple est une application d’apprentissage qui réagit à des réponses courtes. L’élève soumet une phrase dans une nouvelle langue ou une étape intermédiaire d’un exercice d’algèbre. L’application doit repérer l’erreur pertinente et proposer une suite adaptée. Une réponse rapide peut maintenir l’attention sur la même question.
La réponse n’a pas toujours besoin d’être complète. Un petit indice peut être préférable à une solution entièrement développée. L’évaluation doit distinguer un retour correct d’une aide excessive : l’application a-t-elle identifié l’erreur, préservé l’occasion d’apprendre et utilisé un langage adapté au niveau de l’élève ? Une explication rapide au mauvais niveau interrompt malgré tout la leçon.
Constituez un échantillon avec plusieurs réponses acceptables et des réponses volontairement ambiguës. Demandez un seul indice avant une explication complète. Incluez un élève qui modifie sa réponse et vérifiez que l’application réagit à cette révision. Ces cas montrent si le modèle suit l’interaction pédagogique au lieu de simplement produire un corrigé.
Pour un tuteur vocal, le modèle de texte n’est qu’un composant. La reconnaissance vocale, la gestion des tours de parole et la synthèse vocale ajoutent leurs propres délais et erreurs. Testez l’échange parlé complet avant de déduire la réactivité d’une conversation à partir du débit de texte. Un traitement textuel rapide peut donner de la marge tandis que les étapes audio déterminent encore le naturel de l’échange.
Les agents de navigation ont besoin d’un chronomètre et d’une règle d’arrêt
Un troisième cas est un assistant qui compare les conditions actuelles de fournisseurs à partir de pages publiques. Il lit une page, choisit le lien pertinent, extrait une condition et vérifie une autre source. Des appels au modèle plus rapides peuvent réduire les attentes répétées. Ils peuvent aussi inciter l’agent à continuer de naviguer parce qu’une étape supplémentaire paraît peu coûteuse.
Définissez l’achèvement avant de mesurer la vitesse. Par exemple, la tâche se termine lorsque l’assistant dispose, pour chaque candidat, d’un prix daté, d’une limite du service et d’un lien source. Il doit s’arrêter dès que ces exigences sont satisfaites ou signaler une information manquante après une recherche bornée. Un appel supplémentaire n’est utile que s’il résout une incertitude identifiée.
Une tâche de navigation doit également délimiter les actions. Lire des informations publiques diffère de soumettre un formulaire, modifier un compte ou acheter un produit. Le remplacement du modèle doit préserver les autorisations et les étapes de confirmation de l’application. Une exécution plus rapide fait survenir une mauvaise action plus tôt ; elle ne la rend pas plus appropriée.
Comparez séparément les tâches réussies et celles qui échouent. Si un modèle s’arrête tôt et qu’un autre explore plus longtemps, une moyenne unique peut masquer la différence. Gardez le nombre d’étapes, les échecs d’outils et les preuves manquantes à côté de la durée. Le résultat doit expliquer comment la tâche s’est achevée, au-delà du temps écoulé.
Le tableau des prix doit prévoir l’après-promotion
Lors de la vérification du 23 octobre, la page des modèles d’Inception affiche Mercury 3 à 0,20 $ par million de tokens d’entrée et 0,70 $ par million de tokens de sortie, avec une remise de lancement ramenant ces tarifs à 0,10 $ et 0,35 $. Les entrées en cache ont des tarifs distincts. La page ne précise pas la date de fin de la promotion : un budget doit donc conserver le scénario au tarif normal.
| Catégorie de tokens de l’API directe | Tarif affiché par million de tokens | Tarif de lancement par million de tokens |
|---|---|---|
| Entrée | 0,20 $ | 0,10 $ |
| Entrée en cache | 0,02 $ | 0,01 $ |
| Sortie | 0,70 $ | 0,35 $ |
Pour un exemple de charge de 100 millions de tokens d’entrée hors cache et 20 millions de tokens de sortie, le calcul donne 34 $ au tarif affiché et 17 $ au tarif de lancement. Cet exemple suppose exactement ces volumes et exclut les autres services. Il permet de comparer les deux régimes tarifaires, sans estimer les dépenses d’un véritable service client.
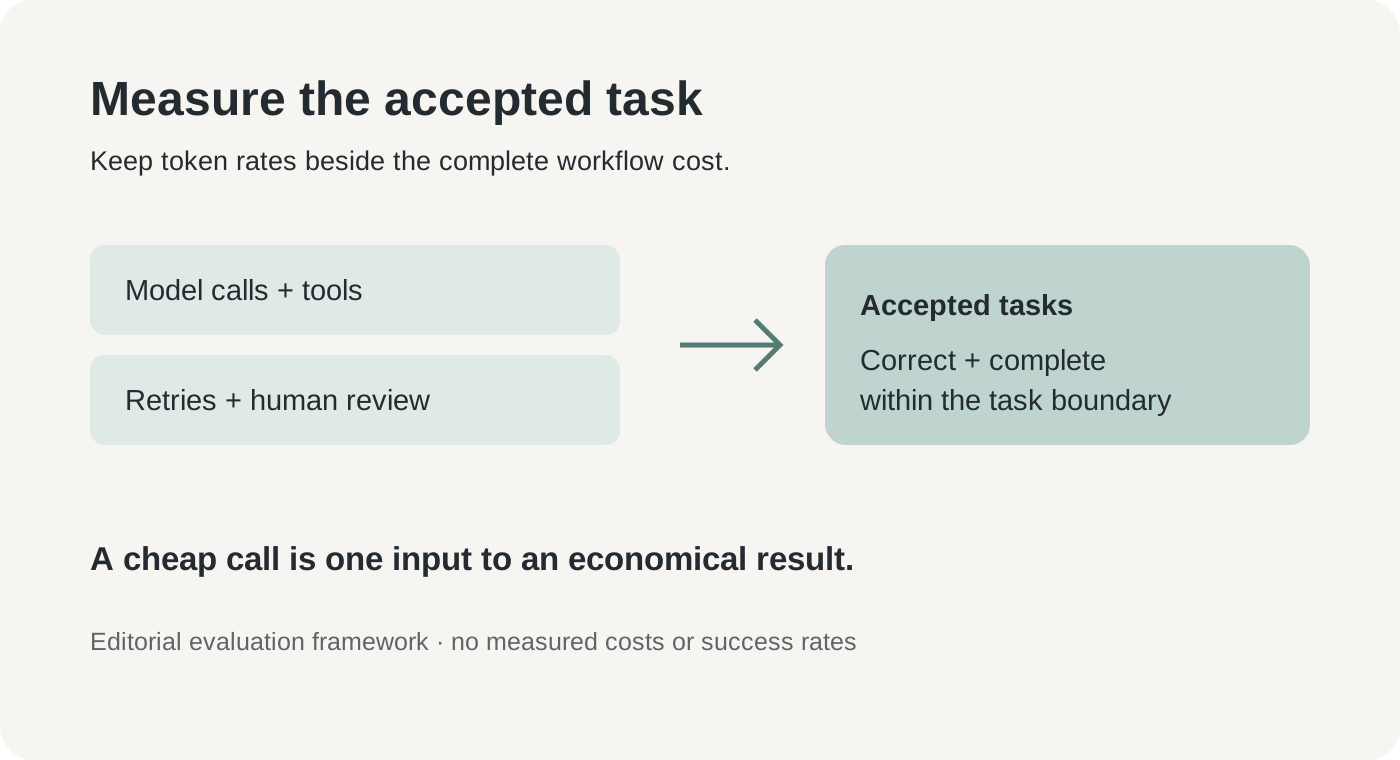
Cadre d’évaluation éditorial original. Comparer l’ensemble des ressources utilisées au nombre de tâches acceptées ; aucun coût de produit ni taux de réussite mesuré n’est représenté.
Un appel peu cher peut appartenir à un processus coûteux. Recherche d’informations, services de navigation, traitement vocal, révision humaine et tentatives répétées peuvent modifier le total. À l’inverse, un appel individuel plus cher peut être économique s’il évite plusieurs échecs. Suivez le coût par tâche acceptée en complément du prix des tokens.
Le cache exige la même rigueur. Ne supposez pas que chaque document répété bénéficie du tarif en cache. Consignez la facturation réelle du fournisseur choisi et appliquez les conditions documentées pour ce canal. Un modèle proposé sur plusieurs plateformes peut aussi avoir des conditions opérationnelles, limites ou prix différents. Gardez le mode d’hébergement dans le relevé de comparaison.
Commencez par rejouer un petit échantillon, puis changez un composant
Le guide de démarrage d’Inception, vérifié le 23 octobre, identifie le modèle comme mercury-3 et documente son SDK ainsi qu’un point de terminaison compatible avec les complétions de chat. Cela offre une voie d’intégration pratique à une application existante. La compatibilité facilite la première requête ; le comportement des prompts et la fiabilité du processus restent à vérifier séparément.
- Choisissez une tâche réversible. Commencez par un brouillon de réponse ou une suggestion pédagogique qu’une personne peut examiner. Réunissez un petit échantillon autorisé avec une règle d’acceptation explicite pour chaque cas.
- Conservez une référence initiale. Relevez le modèle actuel, les prompts, les tailles d’entrée, les limites de sortie et les résultats des outils. Gardez la sortie acceptée et le temps écoulé pour chaque cas.
- Créez un compte Inception et une clé API. Stockez la clé dans une variable d’environnement ou votre gestionnaire de secrets habituel. Vérifiez la facturation et les contrôles d’usage avant un traitement par lot.
- Exécutez la requête documentée avec
mercury-3. Gardez la tâche et ses critères d’acceptation constants. Enregistrez les paramètres, notamment l’effort de raisonnement et la limite de sortie, pour pouvoir reproduire la comparaison. - Examinez les échecs avant d’élargir le trafic. Vérifiez les faits incorrects, conditions manquantes, erreurs de schéma et appels inutiles. Répétez des cas représentatifs pour comprendre la variabilité.
- Menez un pilote avec une possibilité de retour. Gardez le fournisseur précédent disponible, fixez un plafond d’usage et surveillez le temps et le coût par tâche acceptée en trafic normal.
Pour un premier essai minimal en Python, l’exemple du SDK officiel peut être adapté à une consigne de test sans données sensibles :
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
Le prochain livrable utile est un tableau de comparaison contenant les résultats corrects et les cas d’échec. Une requête d’exemple réussie établit la connectivité. Elle ne prouve pas que chaque paramètre, schéma d’outil ou prompt d’une application existante se comporte de manière identique.
La qualité et les contrôles des données accompagnent la vitesse
Les comparaisons de lancement d’Inception sont encourageantes pour la catégorie visée, mais les capacités générales d’un modèle et son adéquation à une charge particulière sont deux questions différentes. La page Mercury 3 de l’évaluateur indépendant Vals AI, vérifiée le 23 octobre, présente plusieurs tâches avec ses propres paramètres. Ses scores doivent être interprétés dans le cadre de ces tests, sans les fusionner avec un débit annoncé par le fournisseur pour produire un classement universel.
L’habitude la plus utile consiste à examiner les irrégularités du modèle. Il peut exceller dans les réponses structurées courtes et être moins bon sur une tâche spécialisée que votre application considère comme courante. Introduisez tôt les cas difficiles dans le pilote. Un recueil composé uniquement de réussites indique peu où les utilisateurs auront besoin d’aide.
Le traitement des données dépend également du service et du contrat. Les conditions d’Inception décrivent une option de refus de l’entraînement dans les réglages du compte, tandis que sa page entreprise propose des contrôles configurables de conservation et de déploiement. Examinez le canal et le contrat applicables avant d’envoyer des données clients. Utilisez des exemples synthétiques ou dûment autorisés pour la première comparaison.
Les utilisateurs existants doivent retenir une date pratique : la page des modèles indique que les clients ayant utilisé Mercury 2 ou 2.5 avant le 19 octobre en conservent l’accès jusqu’au 15 novembre 2026, l’assistance entreprise étant régie par les accords. La migration mérite un rejeu planifié et une possibilité de retour. Un ancien prompt familier ne remplace pas sa vérification avec le nouveau modèle.
Une génération plus rapide doit offrir une prochaine étape plus utile
Mercury 3 invite à traiter la vitesse d’inférence comme un choix de conception. L’occasion consiste à consacrer le temps récupéré à une correction, une vérification de source ou un retour qui arrive encore à propos. La préoccupation est qu’un système plus rapide peut aussi produire davantage de travail non révisé. La prochaine preuve significative sera une performance fiable sur les tâches complètes que les utilisateurs lui confient.
Un bon pilote débouche sur une réponse précise : ce processus est devenu plus rapide au même niveau d’exigence, ou il ne l’est pas. C’est une affirmation plus modeste que de déclarer un modèle le plus rapide en tout. C’est aussi celle dont une équipe peut se servir pour améliorer son produit.
Sources
- Annonce Mercury 3 d’Inception, 19 octobre 2026 ; vitesse et contexte annoncés par le fournisseur.
- Communiqué de lancement de l’émetteur, 19 octobre 2026.
- Modèles, tarifs et avis de migration d’Inception, vérifiés le 23 octobre 2026.
- Démarrage rapide de l’API Inception, vérifié le 23 octobre 2026.
- Article de recherche Mercury, soumis le 17 juin 2025 ; contexte sur la famille précédente.
- Page d’évaluation Mercury 3 de Vals AI, vérifiée le 23 octobre 2026.
- Conditions d’Inception et contrôles entreprise, vérifiés le 23 octobre 2026.
Garder la comparaison disponible pour révision
Si vous souhaitez un espace distinct pour conserver les sources autorisées et les notes qui étayent le choix d’un modèle, Telli.sh est une possibilité. Commencer par une note.