Mercury 3 promete respuestas más rápidas. ¿Terminará antes tu tarea de IA?
El nuevo modelo de lenguaje por difusión de Inception se dirige al trabajo interactivo. Dónde puede importar su velocidad, cómo comparar tareas completas y por qué separar el precio de lanzamiento.
Un cliente pregunta si puede modificar un pedido antes de que se envíe. El asistente localiza el pedido, lee las condiciones, consulta su estado en el almacén y prepara una respuesta. Cada paso parece pequeño. Juntos, los tiempos de espera pueden convertir una conversación sencilla en una conexión lenta con alguien muy ocupado.
Inception lanzó Mercury 3 el 19 de octubre, orientando su nuevo modelo de lenguaje por difusión a aplicaciones donde esas pausas se acumulan. La empresa anuncia 1.068 tokens de salida por segundo en GPU NVIDIA, junto con una ventana de contexto de un millón de tokens. Son especificaciones del proveedor, no una garantía para una interacción completa con el cliente. Anuncio de Inception.
La pregunta interesante es qué permite cambiar un modelo más rápido. Un tutor puede dar una pista mientras el alumno sigue trabajando. Un agente de soporte puede comprobar una excepción antes de responder. Un asistente de navegación puede completar otro paso útil dentro del mismo tiempo de espera. Esta guía examina esas posibilidades, sus costes y una forma práctica de evaluar si Mercury 3 mejora la tarea que realmente necesitas resolver.
Hardware NVIDIA H100 como contexto de la inferencia con GPU. Foto: 极客湾Geekerwan, fuente en Wikimedia Commons, CC BY 3.0; redimensionada y convertida a JPEG, conservando la marca de agua del autor. No representa infraestructura de Inception ni una prueba nuestra, y no identifica el hardware utilizado para el resultado anunciado de Mercury 3.

La difusión ofrece a Inception otra vía hacia un texto más rápido
Inception es una empresa de investigación y productos de IA que vende modelos de lenguaje mediante servicios alojados. Su familia Mercury utiliza difusión, un enfoque que refina texto en varias posiciones en lugar de depender por completo de una secuencia de izquierda a derecha. El artículo de investigación de Mercury, presentado el 17 de junio de 2025, describe el método y la evaluación de la familia anterior. Aporta contexto sobre el enfoque, pero no es un informe de rendimiento de Mercury 3.
La consecuencia para el usuario es sencilla: el orden en el que un modelo calcula texto puede influir en lo que tarda una aplicación en obtener una respuesta útil. Eso no vuelve instantánea cada respuesta ni elimina el razonamiento que requieren las preguntas difíciles. Cambia una parte del trabajo necesario para producirla. El resto de la aplicación todavía debe obtener información, decidir qué hacer con ella y presentar algo que una persona pueda utilizar.
Piensa en la latencia como un presupuesto de espera. Un desarrollador puede gastarlo en generar una explicación más larga, comprobar otra fuente o devolver antes una respuesta más corta. Un modelo más rápido crea margen dentro de ese presupuesto. Que ese margen beneficie al usuario depende de cómo lo aproveche la aplicación.
Esto importa especialmente cuando se llama al modelo repetidamente. Un asistente que necesita una sola respuesta breve ofrece pocas ocasiones de recuperar tiempo. Un agente que alterna lectura, elección de una acción e inspección del resultado puede pagar muchas veces el retraso del modelo. Ahorrar tiempo en una fase repetida puede cambiar la experiencia aunque ninguna respuesta aislada parezca espectacular.
Los tokens por segundo solo miden un tramo del recorrido
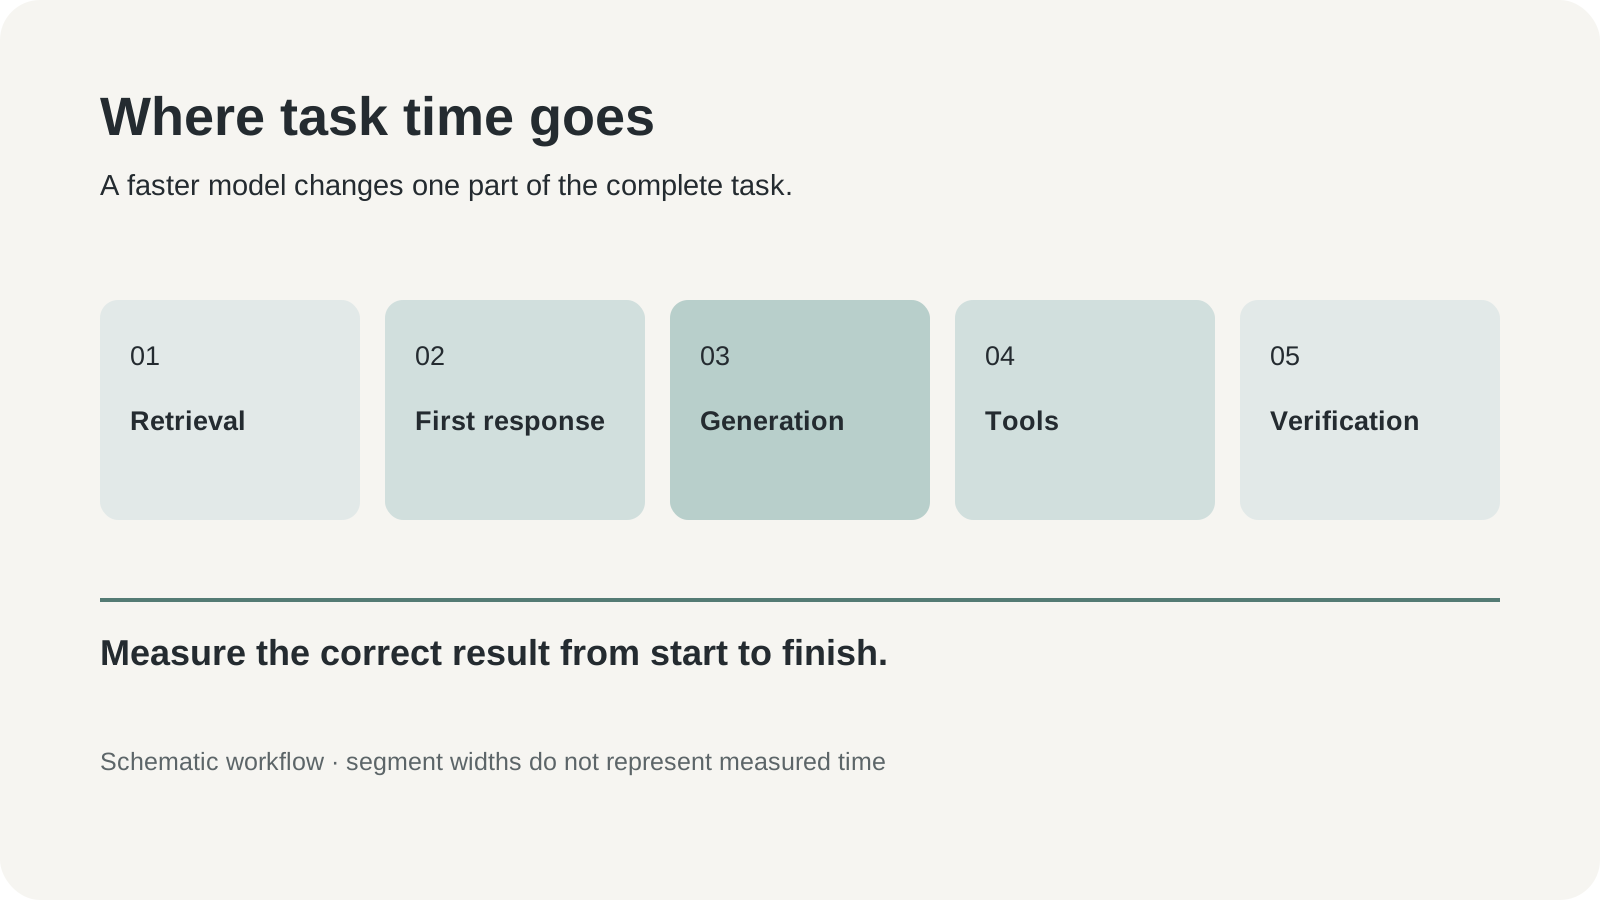
Infografía editorial original: fases que pueden contribuir al tiempo de finalización de una tarea. Los tamaños de los segmentos son esquemáticos y no representan duraciones medidas.
Dentro de una función de IA hay varios relojes. El tiempo hasta la primera respuesta describe lo que parece esperar la interfaz antes de que ocurra algo útil. El rendimiento de salida indica la velocidad a la que llega el texto generado. La latencia de las herramientas cubre la búsqueda, la base de datos o el servicio externo que consulta la aplicación. El tiempo de finalización incluye los pasos necesarios para producir un resultado correcto, con reintentos y correcciones.
Estos relojes pueden apuntar en direcciones distintas. Un sistema puede mostrar las primeras palabras de inmediato y tardar mucho en completar una petición complicada. Otro puede esperar antes de entregar una respuesta compacta que no necesita correcciones. Un tercero puede generar deprisa y dedicar casi toda la interacción a esperar al sistema de pedidos. La cifra que importa al usuario depende del trabajo.
| Medida | Qué indica al equipo que desarrolla | Qué deja sin responder |
|---|---|---|
| Primera respuesta útil | Si la interfaz reconoce o hace avanzar la petición pronto | Si el resultado final será correcto |
| Tokens de salida por segundo | La rapidez con la que se produce texto durante la generación | Tiempo de búsqueda, colas de servicios y demoras de herramientas |
| Duración de la tarea completa | Cuánto tarda un resultado correcto | Qué componente causó una ralentización |
| Tiempo incluidas las correcciones | El coste práctico de llegar a un resultado aceptable | Si otra tarea se comportaría de forma parecida |
Nuestra valoración: un modelo rápido se gana su sitio si reduce tiempo del trabajo del usuario. Una generación más corta aporta valor cuando acorta ese trabajo o permite una comprobación necesaria. Aporta menos si la aplicación utiliza el ahorro para producir más texto del que alguien necesita.
Mantén concreta la pregunta del ensayo. Comprueba si la tarea se aceleró con el mismo criterio de aceptación. Después pregunta qué fase cambió. Así resulta más fácil distinguir una mejora del modelo de un prompt más corto, una caché ya preparada o un servicio externo más rápido.
Un asistente de soporte puede invertir el ahorro en una respuesta mejor
Considera un ejemplo de atención al cliente en comercio. Una persona quiere cambiar la dirección de entrega después de hacer un pedido. El asistente necesita el estado del pedido, la política de cambios y los datos corregidos del cliente. Su resultado útil es un siguiente paso exacto: realizar un cambio permitido mediante una herramienta autorizada o explicar por qué debe intervenir una persona.
La velocidad ayuda en varios momentos. Una aclaración rápida puede evitar que el cliente abandone la conversación. Leer deprisa la política puede dejar tiempo para comprobar la excepción de un pedido que ya se está preparando. Una respuesta final concisa puede confirmar qué cambió y qué sigue pendiente. Ninguna de estas mejoras exige escribir un mensaje más largo.
La evaluación debe incluir dificultades habituales. Presenta un cliente que corrige su código postal, un pedido ya enviado y una política con una excepción limitada. Mide si utiliza el dato vigente en lugar del primero que vio. Mantén separado el permiso para realizar un cambio de la capacidad para describirlo.
El fallo que hay que evitar es una respuesta rápida y segura que crea más trabajo. Si el cliente debe volver a contactar con soporte para corregir el resultado, la respuesta original solo era eficiente en apariencia. Registra el seguimiento y el traspaso a una persona junto con la velocidad inicial. Así una estadística atractiva del modelo se convierte en una decisión operativa útil.
Un tutor gana cuando el comentario llega antes de que cambie la atención
Un segundo ejemplo es una aplicación educativa que responde a contestaciones breves. El alumno envía una frase en un idioma nuevo o un paso intermedio de un ejercicio de álgebra. La aplicación debe identificar el error pertinente y proponer una continuación adecuada. Una respuesta rápida puede mantener al alumno concentrado en la misma pregunta.
La respuesta no siempre debe ser completa. Una pista pequeña puede ser mejor que una solución desarrollada. La evaluación debe distinguir un comentario correcto de una ayuda excesiva: ¿identificó el error, conservó la oportunidad de aprender y utilizó lenguaje adecuado al nivel del alumno? Una explicación rápida con un nivel equivocado también interrumpe la lección.
Prepara una muestra con varias respuestas aceptables y otras deliberadamente ambiguas. Pide una pista antes de una explicación completa. Incluye un alumno que cambia su respuesta y comprueba que la aplicación reacciona a la revisión. Estos casos revelan si el modelo sigue la interacción educativa en lugar de limitarse a producir un solucionario.
En un tutor de voz, el modelo de texto es un componente más. El reconocimiento del habla, la gestión de turnos y la generación de voz añaden su propio tiempo y sus errores. Prueba la conversación hablada completa antes de convertir el rendimiento textual en una afirmación sobre agilidad conversacional. Una fase de texto rápida puede dar margen mientras las fases de audio siguen determinando la naturalidad del intercambio.
Los agentes de navegación necesitan un reloj y una regla para detenerse
Un tercer caso es un asistente que compara condiciones actuales de proveedores en páginas públicas. Lee una página, decide qué enlace importa, extrae una condición y consulta otra fuente. Las llamadas más rápidas al modelo pueden reducir esperas repetidas. También pueden tentar al agente a seguir navegando porque otro paso resulta barato.
Define la finalización antes de medir la velocidad. Por ejemplo, la tarea termina cuando el asistente tiene un precio fechado, una limitación del servicio y un enlace de origen para cada candidato. Debe detenerse cuando cumpla esos requisitos o señalar un dato ausente tras una búsqueda acotada. La utilidad de otra llamada depende de que resuelva una incertidumbre concreta.
Una tarea de navegación también necesita límites de acción. Leer información pública es distinto de enviar un formulario, modificar una cuenta o comprar un producto. Sustituir el modelo debe conservar los permisos y puntos de confirmación de la aplicación. Ejecutar más deprisa hace que una acción equivocada ocurra antes; no la vuelve más apropiada.
Compara por separado las tareas exitosas y las fallidas. Si un modelo se detiene pronto y otro explora más tiempo, un promedio único puede ocultar la diferencia. Conserva el número de pasos, los fallos de herramientas y las pruebas ausentes junto con la duración. El resultado debe explicar cómo terminó la tarea, no solo cuánto duró el proceso.
La tabla de precios necesita una columna para después de la promoción
Según la consulta del 23 de octubre, la página de modelos de Inception anuncia Mercury 3 a 0,20 dólares por millón de tokens de entrada y 0,70 por millón de tokens de salida, con una rebaja de lanzamiento que reduce las tarifas a 0,10 y 0,35 dólares. La entrada en caché tiene precios distintos. La página no indica cuándo termina la promoción, por lo que un presupuesto debe conservar el escenario de tarifa normal.
| Categoría de tokens de la API directa | Tarifa publicada por millón de tokens | Tarifa de lanzamiento por millón de tokens |
|---|---|---|
| Entrada | 0,20 $ | 0,10 $ |
| Entrada en caché | 0,02 $ | 0,01 $ |
| Salida | 0,70 $ | 0,35 $ |
Para una carga ilustrativa de 100 millones de tokens de entrada sin caché y 20 millones de salida, el cálculo da 34 dólares con las tarifas publicadas y 17 con las de lanzamiento. El ejemplo supone exactamente esos volúmenes y excluye otros servicios. Sirve para comparar ambos regímenes, no para estimar lo que gastará una operación real de soporte.
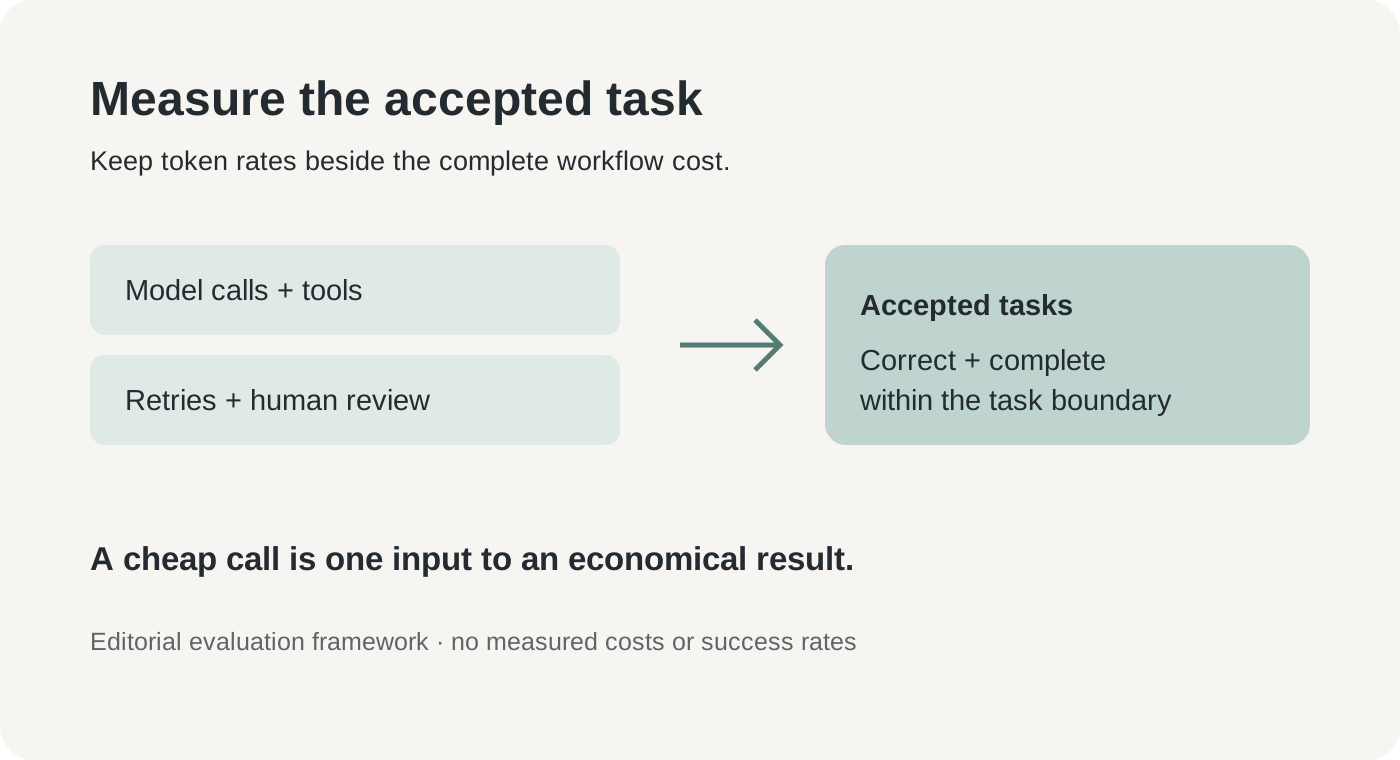
Marco editorial original de evaluación. Compara todos los recursos utilizados con el número de tareas aceptadas; no muestra costes medidos del producto ni tasas de éxito.
Una llamada económica puede formar parte de un proceso caro. La recuperación de información, los servicios de navegación, el procesamiento de voz, la revisión humana y los intentos repetidos pueden cambiar el total. A la inversa, una llamada individual más cara puede resultar económica si evita varios intentos fallidos. Sigue el coste por tarea aceptada además del precio de los tokens.
La caché requiere la misma disciplina. No supongas que todo documento repetido reúne los requisitos de la tarifa en caché. Registra lo que factura el proveedor elegido y aplica las condiciones documentadas para esa vía. Un modelo ofrecido en varias plataformas también puede tener términos operativos, límites o precios distintos. Conserva la vía de servicio en el registro de comparación.
Empieza repitiendo una muestra pequeña y cambia después un componente
La guía de inicio de Inception, consultada el 23 de octubre, identifica el modelo como mercury-3 y documenta su SDK y un endpoint compatible con completado de chat. Eso proporciona una vía práctica de integración para una aplicación existente. La compatibilidad facilita la primera petición; el comportamiento de los prompts y la fiabilidad del proceso merecen sus propias comprobaciones.
- Elige una tarea reversible. Empieza con un borrador de respuesta o una sugerencia educativa que alguien pueda revisar. Reúne una muestra pequeña permitida con una regla de aceptación explícita para cada caso.
- Guarda una referencia inicial. Registra el modelo actual, los prompts, tamaños de entrada, límites de salida y resultados de herramientas. Conserva la salida aceptada y el tiempo de cada caso.
- Crea una cuenta de Inception y una clave API. Guarda la clave en una variable de entorno o en tu gestor habitual de secretos. Comprueba la facturación y los controles de uso antes de ejecutar un lote.
- Ejecuta la petición documentada con
mercury-3. Mantén constantes la tarea y los criterios de aceptación. Registra los ajustes, incluidos esfuerzo de razonamiento y límite de salida, para repetir la comparación. - Inspecciona los fallos antes de ampliar el tráfico. Comprueba hechos incorrectos, condiciones omitidas, errores de esquema y llamadas innecesarias. Repite casos representativos para entender la variabilidad.
- Haz un piloto con posibilidad de volver atrás. Conserva disponible el proveedor anterior, fija un límite de uso y supervisa tiempo y coste por tarea aceptada con tráfico normal.
Como punto de partida mínimo en Python, el ejemplo del SDK oficial puede adaptarse a un prompt de prueba sin información sensible:
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
El siguiente resultado útil es una hoja comparativa con aciertos y casos fallidos. Una petición de muestra exitosa demuestra conectividad. No demuestra que todos los ajustes, esquemas de herramientas o prompts de una aplicación existente se comporten de forma idéntica.
La calidad y los controles de datos deben acompañar a la velocidad
Las comparaciones de lanzamiento de Inception son alentadoras para su categoría objetivo, pero la capacidad general del modelo y su adecuación a una carga concreta son cuestiones distintas. La página de Mercury 3 del evaluador independiente Vals AI, consultada el 23 de octubre, publica resultados de varias tareas con sus propios ajustes. Sus puntuaciones deben interpretarse dentro de las definiciones de esos ensayos, sin combinarlas con un dato de rendimiento del proveedor para crear una clasificación universal.
El hábito más útil es examinar las irregularidades del modelo. Puede ser excelente en respuestas estructuradas cortas y más débil en una tarea especializada que tu aplicación considera habitual. Incluye pronto los casos difíciles en el piloto. Una colección compuesta solo de ejemplos exitosos dice poco sobre dónde necesitarán ayuda las personas.
El tratamiento de los datos también depende del servicio y del acuerdo. Las condiciones de Inception describen una opción para excluirse del entrenamiento desde los ajustes de cuenta, mientras que su página empresarial ofrece controles configurables de conservación y despliegue. Revisa la vía y el contrato aplicables antes de enviar material de clientes. Usa ejemplos sintéticos o debidamente autorizados en la primera comparación.
Los usuarios existentes deben conservar una fecha práctica: la página de modelos indica que los clientes con uso de Mercury 2 o 2.5 anterior al 19 de octubre mantienen acceso hasta el 15 de noviembre de 2026, con soporte empresarial sujeto a sus acuerdos. La migración merece una repetición programada de casos y un plan de vuelta atrás. Que un prompt antiguo resulte familiar no sustituye comprobarlo con el nuevo modelo.
Generar más rápido debería permitir un siguiente paso más útil
Mercury 3 plantea tratar la velocidad de inferencia como una decisión de diseño. La oportunidad consiste en dedicar el tiempo recuperado a una corrección, una verificación de fuente o un comentario que llega cuando aún sirve. La preocupación es que un sistema más rápido también puede generar más trabajo sin revisar. La siguiente evidencia significativa será un rendimiento fiable en las tareas completas que la gente le pide terminar.
Un buen piloto termina con una respuesta concreta: este proceso se volvió más rápido con el mismo nivel de exigencia, o no lo hizo. Es una afirmación más pequeña que declarar un modelo el más rápido en todo. También es la que un equipo puede utilizar para ofrecer una experiencia mejor.
Fuentes
- Anuncio de Mercury 3 de Inception, 19 de octubre de 2026; velocidad y contexto son especificaciones del proveedor.
- Comunicado de lanzamiento del emisor, 19 de octubre de 2026.
- Modelos, precios y aviso de migración de Inception, consultados el 23 de octubre de 2026.
- Inicio rápido de la API de Inception, consultado el 23 de octubre de 2026.
- Artículo de investigación de Mercury, presentado el 17 de junio de 2025; contexto de la familia anterior.
- Página de evaluación de Mercury 3 de Vals AI, consultada el 23 de octubre de 2026.
- Condiciones de Inception y controles empresariales, consultados el 23 de octubre de 2026.
Conserva la comparación para revisarla
Si quieres un lugar separado donde guardar fuentes autorizadas y las notas que respaldan la elección de un modelo, Telli.sh es una opción. Empieza con una nota.