같은 10.0% 오류율, 정반대의 결정: 회의 전사 정확도를 측정하는 법
단어 오류율은 '아니다'라는 단어와 '그'라는 관사에 똑같은 무게를 매깁니다. 두 전사본이 나란히 10.0%를 받고도 그중 하나만 쓸 만한 이유가 여기 있습니다. 회의 사양에 맞춘 12분짜리 테스트 클립, 정규화 규칙을 고정한 기준 전사본, cpWER와 DER 명령어, 그리고 원시 WER에 100점 중 10점만 주는 5개 항목 채점표까지 측정 절차 전체를 정리했습니다.
제품 회의에서 나온 스무 단어짜리 문장 하나를, 기계가 전사한 두 가지 결과입니다.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review" (프리야가 말하길, Helios 이전은 3분기로 밀리고 보안 검토 전에는 벤더 계약서에 서명하면 안 된다)
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review" (프리야가 말하길, Helios 이전은 2분기로 밀리고 보안 검토 전에 벤더 계약서에 서명해야 한다)
실제로 오간 말과 비교하면 두 결과 모두 오류가 정확히 두 개씩 있습니다. 그리고 둘 다 단어 오류율 10.0%를 받습니다. 전사본 A는 관사 "the"를 두 번 빠뜨렸습니다. 전사본 B는 마감을 한 분기 앞당겼고, 약속에서 "not"이라는 단어를 지웠습니다.
평가 절차가 이 두 시스템을 동점으로 매긴다면, 문제는 모델이 아니라 절차입니다.
이 글은 "금요일까지 전사 도구를 하나 골라 오라"는 지시를 받은 사람에게 그대로 건넬 수 있는 측정 절차입니다. 단어 오류율이 정확히 무엇을 세는지, 왜 하필 회의 오디오에서 그 숫자가 사람을 속이는지, 그리고 오픈소스 패키지 두 개와 12분짜리 녹음만 있으면 하루 오후에 돌려 볼 수 있는 5단계 프로토콜을 다룹니다. 전사 정확도는 애초에 최종 산출물이 아니었다는 주장은 따로 정리해 두었습니다. 이 글은 그 짝이 되는 글이고, 주장이 아니라 방법입니다.
요약:
- WER는
(substitutions + deletions + insertions) ÷ reference words이고, 모든 단어가 똑같은 무게를 갖습니다. 부정어 "not"과 관사 "the"의 값이 같습니다.- 공개된 리더보드는 이미 압축됐습니다. 2026년 8월 31일 조회한 Artificial Analysis의 독립 평가에서 상위 5개 모델은 AA-WER 1.7%에서 2.6% 사이에 몰려 있습니다. 승자를 고르기엔 너무 좁은 폭입니다.
- 대신 다섯 항목에 가중치를 두고 채점하세요. 핵심어 30점, 화자 귀속 25점, 숫자와 금액 20점, 구획 15점, 원시 WER 10점입니다. 어려운 항목의 도구는 이미 나와 있습니다.
cpWER와DER는 CHiME 챌린지를 위해 만들어진 MeetEval에 들어 있습니다.
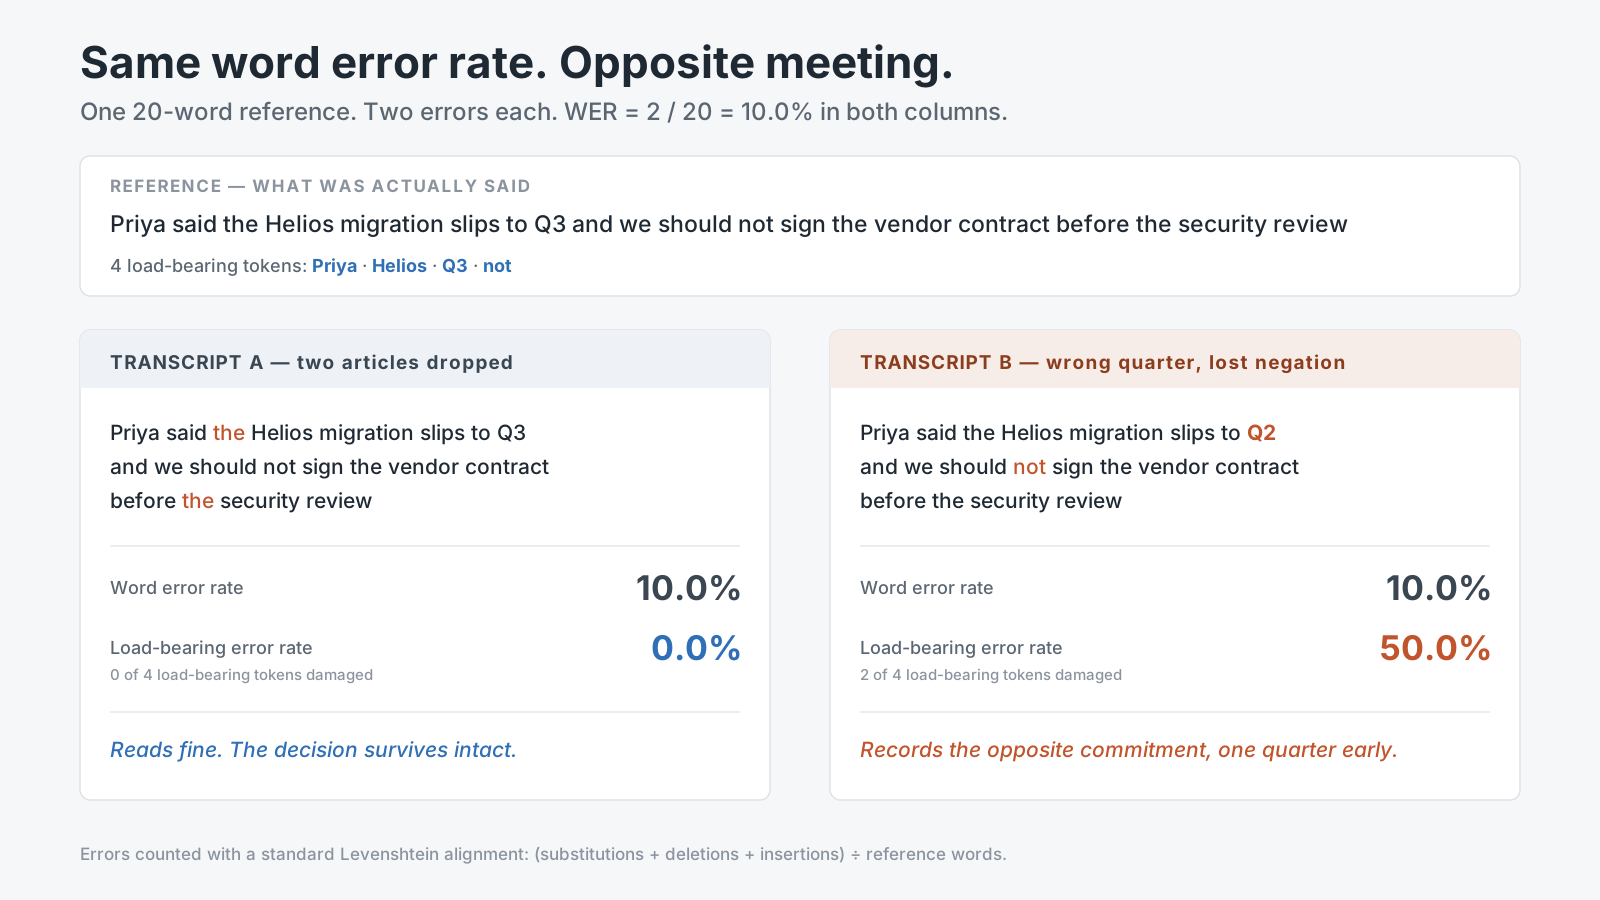
두 열 모두 20단어 기준 전사본을 상대로 오류가 두 개입니다. 하지만 회의실에서 실제로 내려진 결정을 기록에 남긴 쪽은 하나뿐입니다.
단어 오류율이 세는 것을 전부 적어 본다
WER는 단 하나의 정렬에서 나옵니다. 사람들이 이렇게 말했다고 합의한 기준 전사본을 놓고, 기계의 출력을 놓습니다. 고전적인 레벤슈타인 정렬로 한쪽을 다른 쪽으로 바꾸는 가장 값싼 편집 순서를 찾은 뒤, 각 편집에 이름을 붙입니다.
- 모델이 다른 단어를 적었으면 대체 substitution입니다. "deploy"를 "delay"로 들은 경우죠.
- 기준 전사본의 단어가 출력에 아예 없으면 삭제 deletion입니다.
- 아무도 말하지 않은 단어를 모델이 만들어 냈으면 삽입 insertion입니다.
그리고 이렇게 계산합니다.
WER = (substitutions + deletions + insertions) ÷ reference words
분모는 가설 전사본이 아니라 기준 전사본의 길이입니다. WER가 100%를 넘을 수 있는 이유가 여기 있습니다. 자유롭게 환각하는 모델은 원래 있던 단어 수보다 더 많은 삽입을 쌓을 수 있으니까요.
계산을 공개된 출력과 대조할 수 있도록, MeetEval 문서에 실린 예제를 그대로 가져오겠습니다. 기준: "The quick brown fox jumps over the lazy dog" — 아홉 단어입니다. 가설: "The kwick brown fox jump over lazy" — 일곱 단어입니다. 정렬 결과 대체 두 개(quick→kwick, jumps→jump)와 삭제 두 개(the, dog)가 나오고 삽입은 없습니다. 즉 (2 + 2 + 0) ÷ 9 = 0.4444, WER 44.4%이고, MeetEval은 정확히 이렇게 출력합니다. ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2)
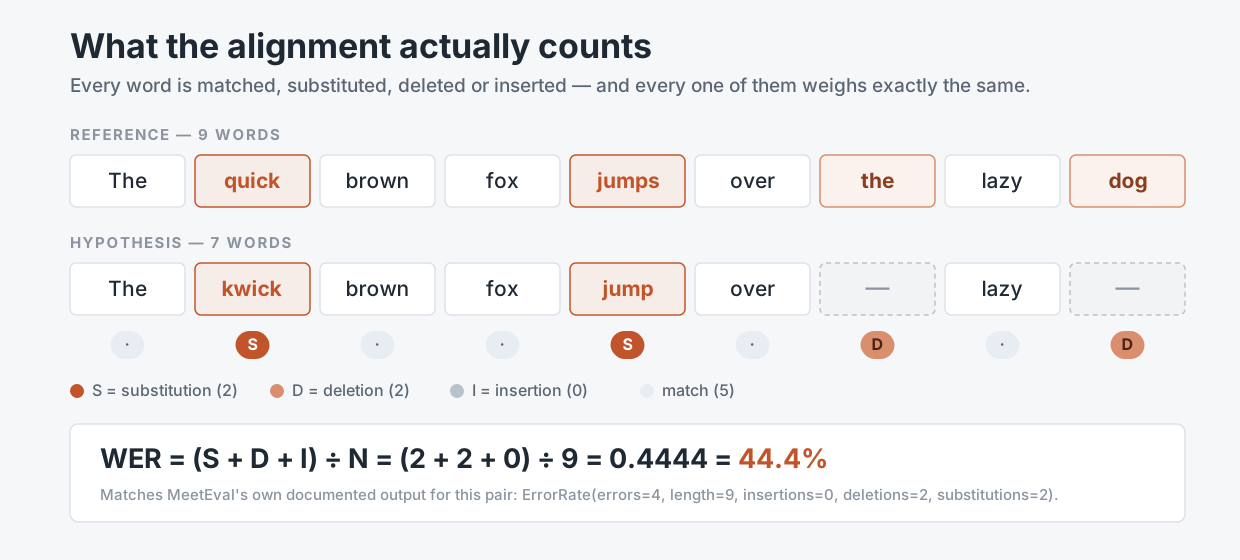
정렬은 기계적이고 재현 가능합니다. 다만 가중치가 없습니다. 출처: MeetEval 문서, 2026년 8월 31일 조회.
이 수식에는 벤더의 랜딩 페이지에 적힌 그 어떤 문구보다 중요한 성질이 둘 있습니다. 첫째, 이 지표는 평평합니다. 어떤 단어가 회의를 떠받치고 어떤 단어가 문법만 담당하는지 구분하는 개념 자체가 없습니다. 둘째, 이 지표는 화자를 보지 못합니다. 표준 WER는 모든 발화를 하나의 흐름으로 이어 붙이기 때문에, 단어는 완벽하게 받아쓰면서 그 절반을 엉뚱한 사람에게 붙여 놓은 시스템도 흠 없는 점수를 받을 수 있습니다.
공개된 숫자로는 이제 후보를 가를 수 없다
리더보드를 열어 보면 문제가 산수로 드러납니다. 벤더의 주장을 옮겨 싣는 대신 직접 평가를 돌리는 Artificial Analysis는 2026년 8월 31일 기준 AA-WER 상위 5개 모델을 이렇게 정리했습니다. Fun-Realtime-ASR-preview 1.7%, ElevenLabs Scribe v2 2.2%, 마이크로소프트 MAI-Transcribe-1.5 2.4%, Smallest AI Pulse Pro 2.4%, Gemini 3.5 Transcribe 2.6%. 오픈 웨이트 중 최고인 미스트랄의 Voxtral Small은 2.8%입니다.
시장 상단 전체가 1.1포인트 폭 안에 들어갑니다. 발화 단어가 대략 6,300개인 45분짜리 회의에서 1위와 5위의 차이는 약 57단어입니다. 전사본 한 화면당 한 단어도 안 됩니다.
두 번째 문제가 있는데, 벤치마크 오디오가 여러분의 오디오가 아니라는 점입니다. AA-WER v2는 세 출처에서 뽑은 약 8시간 분량을 오디오 길이로 가중 평균한 값입니다. AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25%, Earnings22-Cleaned-AA 25%입니다. 의회 연설과 실적 발표는 녹음 상태가 좋고, 순서대로 말하며, 내부 회의를 정의하는 바로 그 요소가 거의 없습니다. 자기들만 아는 프로젝트를 두고 네 사람이 서로 말을 자르는 상황 말입니다.
진짜 대화형 오디오를 다루는 연구는 이미 오래전부터 이 문제를 별개의 분야로 취급해 왔습니다. 2020년 4월 20일 와타나베, 만델, 바커와 열여덟 명의 공저자가 발표한 CHiME-6 챌린지는 저녁 식사 자리 녹음 위에 평가를 세웠습니다. 발화가 겹치고 마이크가 멀리 떨어진 자연스러운 대화가, 낭독 음성에서 좋은 점수를 받는 시스템을 무너뜨리기 때문입니다. 근접 헤드셋과 원거리 회의실 마이크를 함께 써서 100시간을 녹음한 AMI Meeting Corpus도 같은 이유로 존재합니다.
여기서 하고 싶은 말은 이것이고, 에두르지 않겠습니다. 공개된 WER는 그 벤더의 모델이 망가지지 않았다는 사실을 알려 줍니다. 어느 벤더를 사야 하는지는 알려 주지 못합니다.
WER가 잡아내는 것과 구조적으로 못 잡는 것
| 실패 유형 | 원시 WER가 잡아내나? | 무엇을 잃는가 | 실제로 측정하는 방법 |
|---|---|---|---|
| 흔한 단어를 잘못 들음 ("their"/"there") | 네, 온전한 가중치로 | 거의 아무것도 | WER |
| 필러와 말 더듬기가 빠짐 | 네, 삭제로 계산됨 | 없음 — 오히려 개선인 경우가 많음 | WER, 다만 오해를 부르는 방식으로 |
| 고유명사가 뭉개짐 ("Xochitl" → "Societal") | 네, 하지만 단어 하나만큼의 무게로 | 책임자의 이름 | 핵심어 오류율 |
| 숫자나 날짜가 틀림 ("Q3" → "Q2") | 네, 단어 하나만큼의 무게로 | 놓친 마감 | 숫자 정확도, 별도 채점 |
| 부정어가 삭제됨 ("should not" → "should") | 네, 단어 하나만큼의 무게로 | 뒤집힌 결정 | 핵심어 오류율 |
| 단어는 맞는데 화자가 틀림 | 아니요 — WER는 화자를 보지 못함 | 누가 약속했는지 아무도 모름 | cpWER, DER |
| 화자 턴이 한 덩어리로 합쳐짐 | 아니요 | 읽을 수 없는 텍스트 벽 | collar를 적용한 tcpWER, 사람의 통독 |
| 문장 경계가 사라짐 | 아니요 — 구두점은 정규화로 지워짐 | 구조를 추측하는 요약 | 구획 점수, 사람의 통독 |
| 무음 구간에서 문단 전체를 환각함 | 부분적으로 — 삽입으로 | 지어낸 내용이 기록으로 남음 | WER에 더해 삽입 횟수를 따로 확인 |
전사본이 쓸 만한 회의록이 되느냐를 결정하는 건 저 표의 아래쪽 절반이고, 표준 WER는 그중 아무것도 보지 못합니다. 이건 지표의 결함이 아닙니다. WER는 1990년대 받아쓰기 연구가 던진 질문에 정확히 답하고 있습니다. 결함은 2026년에 그것만 쓰는 데 있습니다.
1단계: 진짜 회의처럼 굴러가는 12분짜리 클립을 만든다
벤더 데모 파일로 평가하지 마세요. 그렇다고 자기 아카이브 여덟 시간으로 평가하지도 마세요. 필요한 건 손으로 받아쓸 만큼 짧으면서 시스템을 부술 만큼 빽빽한 클립 하나입니다.
목표는 12분입니다. 분당 약 140단어의 평범한 대화 속도에 발화 밀도 75% 정도를 잡으면 기준 단어가 약 1,260개 나옵니다. 오류율 2% 차이가 통계적 잡음이 아니라 25단어로 드러날 만큼은 많고, 두 사람이 하루 오후에 꼼꼼히 받아쓸 수 있을 만큼은 적습니다.
느낌이 아니라 사양에 맞춰 클립을 만드세요. 저희가 쓰는 사양입니다.
- 화자 네 명 이상. 압축된 오디오 채널로 원격 참여하는 사람이 최소 한 명, 그리고 해당 업무 언어의 비원어민 억양이 최소 하나 있어야 합니다.
- 진짜로 겹치는 구간 90초 이상. 두 사람이 동시에 말하기, 남의 문장을 대신 끝내기, 결정 위로 기침 소리 겹치기 같은 것들입니다. 화자 분리는 크로스토크에서 조용히 무너지고, 그게 없는 클립은 아무것도 측정하지 못합니다.
- 도메인 용어 25개 이상. 제품 코드명, 내부 약어, 고객사 이름, 참석자 이름. 회의실에서 글자당 의미가 가장 높고, 어떤 학습 코퍼스에서도 빈도가 가장 낮은 단어들입니다.
- 숫자 15개 이상. 날짜, 분기, 금액, 버전 번호, 백분율. 일부러 헷갈리게 말해 보세요. 같은 1분 안에 "fifteen"과 "fifty"를 넣는 식으로요.
- 부정형 결정 3개 이상. 자연스러운 문장으로요. "이번 릴리스에서는 그거 안 내보냅니다", "계약은 일단 보류하죠" 같은 말입니다.
- 동시 녹음 두 트랙. 여건이 되면 노트북 자체 마이크와 화자별 헤드셋 트랙을 함께 남기세요. AMI 코퍼스의 설계 방식이고, "모델이 약한 것"과 "회의실이 시끄러운 것"을 분리해 줍니다.
한 번만 녹음하세요. WAV는 16kHz 이상으로 무압축 저장합니다. 이후 평가하는 모든 도구가 영원히 이 동일한 파일을 받습니다.
2단계: 기준 전사본을 쓰고, 채점하기 전에 정규화 규칙을 고정한다
기준 전사본은 측정 도구이고, 그 자체에 오차 막대가 있습니다. Artificial Analysis가 공개 평가 세트의 "정제된" 버전을 따로 유지하는 이유는 원래의 기준 전사본에 전사 오류가 들어 있었기 때문입니다. 이들의 설명은 노골적입니다. 정제 버전은 "기준 텍스트에서 전사 오류를 제거해 모델 평가에 더 정확한 정답을 제공한다"고 되어 있습니다. 벤치마크 운영자조차 공개된 정답을 고쳐야 한다면, 여러분의 초벌 전사본도 성경이 아닙니다.
그러니 두 사람이 각자 받아쓴 뒤 모든 차이를 대조해 맞추세요. 두 사람 합쳐 실시간의 5~8배를 예산으로 잡으면, 12분 클립은 대략 하루치 노동에 해당합니다. 이 절차 전체에서 가장 비싼 항목이고, 우회로는 없습니다.
그다음 점수를 하나라도 계산하기 전에 정규화 정책을 문서로 적어 두세요. 이 선택들만으로도 최종 숫자가 몇 포인트씩 움직이기 때문입니다.
- 숫자: "Q3"와 "Q three"는 같은 토큰인가요? "forty thousand"와 "40,000"은 같은가요?
- 축약형: "we're"는 "we are"와 일치하나요?
- 필러: "um", "uh", 말 더듬기를 기준 전사본에 넣기는 하나요? 넣는다면 채점 대상인가요?
- 대소문자와 구두점: 보통은 채점 전에 제거합니다. 그 말은 구두점을 아름답게 찍는 도구가 여기서는 아무 점수도 못 받는다는 뜻이고, 그건 3단계에서 따로 채점해야 합니다.
결과는 SegLST로 저장하세요. CHiME 챌린지가 쓰고 MeetEval이 기본값으로 삼는 JSON 형식이며, 세그먼트 하나당 session_id, words, speaker, start_time, end_time을 담은 객체 하나입니다. 화자와 시간 필드가 있어야 화자 인식 지표를 쓸 수 있고, 이걸 나중에 소급해서 채워 넣는 일은 정말 괴롭습니다.
3단계: 다섯 항목을 채점하고, 원시 WER에는 100점 중 10점만 준다
도구를 설치하고 — pip install jiwer meeteval — 같은 클립으로 항목별 점수를 냅니다. JiWER는 RapidFuzz의 최소 편집 거리 구현을 써서 WER과 함께 매치 오류율, 단어 정보 손실, 단어 정보 보존, 문자 오류율을 계산합니다. 회의 전용 지표는 MeetEval이 담당합니다.
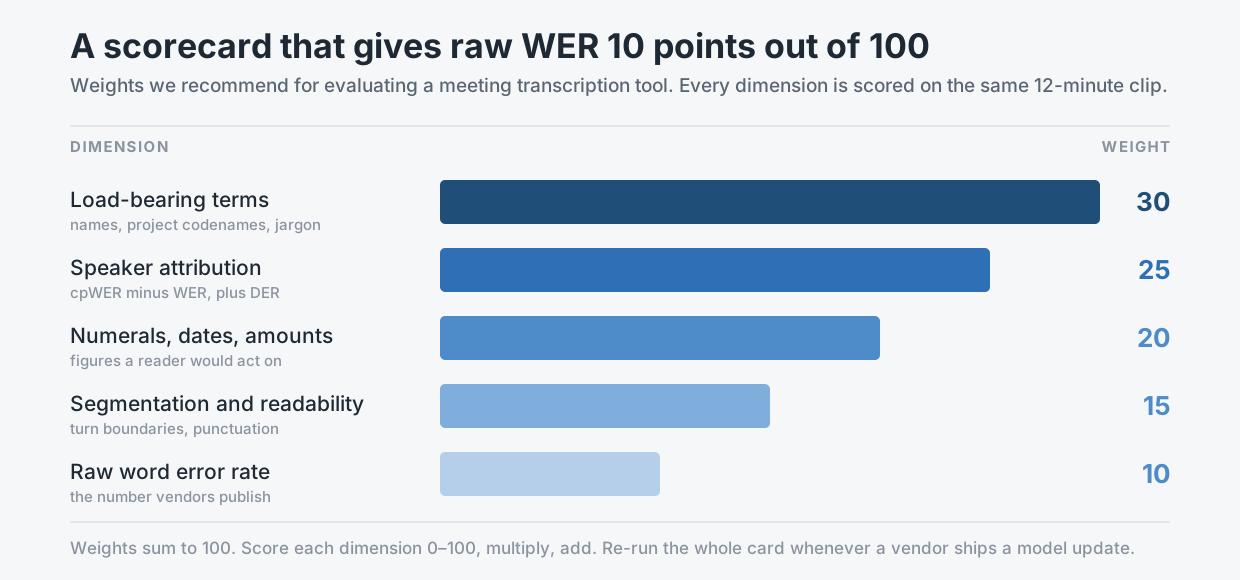
저희가 권장하는 가중치입니다. 모든 벤더가 광고하는 항목이 가장 점수가 낮은 항목입니다.
핵심어 — 30점. 기준 전사본에서 고유명사, 코드명, 도메인 전문 용어를 전부 표시합니다. 그다음 그 토큰들만 대상으로 똑같은 WER 수식을 돌립니다. 저희는 이 결과를 핵심어 오류율이라고 부르고, 이 연습에서 가장 예측력이 높은 단 하나의 숫자입니다. 이 글 맨 앞의 두 전사본에서 핵심 토큰은 Priya, Helios, Q3, not 네 개입니다. 전사본 A는 하나도 훼손하지 않았습니다. 0.0%죠. 전사본 B는 두 개를 훼손했습니다. 50.0%입니다. 전체 WER는 똑같이 10.0%인데, 정작 중요한 지표에서는 50포인트가 벌어집니다.
화자 귀속 — 25점. meeteval-wer cpwer -r ref.stm -h hyp.stm을 돌리세요. 연결 최소 순열 WER는 기준과 가설의 화자 사이에서 최적의 대응을 찾고, 화자별로 단어를 이어 붙인 뒤 채점합니다. 그래서 엉뚱한 사람에게 붙은 단어가 오류로 잡힙니다. 그다음 빼세요. cpWER에서 일반 WER를 뺀 값이 귀속 격차이고, 누가 말했는지 모른다는 사실 하나에서 발생한 손상의 몫입니다. 시간축 관점으로는 화자 분리 오류율을 더하세요. DER은 화자 오류, 오검출 음성, 미검출 음성을 채점 대상 시간에 대한 백분율로 합한 값이며 NIST RT-09 평가 계획서 6.1절에 정의되어 있고, MeetEval이 감싸고 RTTM 파일을 읽는 dscore에 구현돼 있습니다. 후보 도구가 타임스탬프를 지원한다면 cpwer 대신 tcpwer --collar 5를 쓰세요. 단어는 맞았지만 엉뚱한 순간에 붙은 경우가 조용히 눈감아지지 않도록요.
숫자, 날짜, 금액 — 20점. 기준 전사본에서 숫자 토큰을 전부 추출하고, 문서로 적어 둔 정규화 정책을 적용한 뒤 가설과의 정확 일치 정확도를 채점합니다. 결과는 백분율이 아니라 "15개 중 13개 정답" 같은 단순 분수로 보고하세요. 표본 수가 작은데 백분율을 쓰면 있지도 않은 정밀도를 암시하게 됩니다.
구획과 가독성 — 15점. 이 항목은 사람이 합니다. 그 회의에 참석하지 않은 독자 두 명이 원본 출력을 읽으면서 분당 개수를 표시하게 하세요. 엉뚱한 자리에 찍힌 문장 경계, 한 덩어리로 합쳐진 화자 턴, 다시 읽어야 이해되는 문단입니다. 구두점은 WER 계산에서 정규화로 지워졌으니, 여기가 구두점이 채점되는 유일한 자리입니다.
원시 단어 오류율 — 10점. jiwer를 돌려 숫자를 기록합니다. 이건 진짜 바닥 확인용입니다. 깨끗한 근접 마이크 오디오에서 대략 12%를 넘으면 파고들 만한 실제 음향 문제가 있다는 뜻입니다. 그 바닥을 넘어서면 이 숫자는 거의 아무것도 구분하지 못하고, 그래서 80점이 아니라 10점짜리입니다.
각 항목을 0~100으로 채점하고, 가중치를 곱해서 더하세요. 그 결과는 도구 간에도, 시점 간에도 비교할 수 있습니다. 그게 이 작업의 전부입니다.
4단계: 모든 후보를 완전히 같은 파일로 돌리고, "같다"가 무엇이었는지 적어 둔다
팀들이 건너뛰는 단계가 이것이고, 이걸 건너뛰면 앞의 모든 작업이 무효가 됩니다.
같은 WAV, 같은 샘플레이트, 후보 사이에 재인코딩 없음. 같은 기준 전사본, 같은 정규화 정책을 같은 스크립트로 적용. 모든 도구에서 화자 분리를 명시적으로 켜거나 명시적으로 끄고, 어느 쪽이든 기록하세요. 화자 분리를 끈 채 평가한 도구는 켠 채 평가한 도구와 비교 대상이 아닙니다. 키워드나 개체명 바이어싱은 1차 패스에서는 끄고 2차 패스에서는 켜서 양쪽 다 기록하세요. 마이크로소프트는 MAI-Transcribe-1.5에 키워드 목록을 공급하면 WER이 최대 30% 줄어든다고 보고합니다. 바이어싱을 적용한 실행과 적용하지 않은 실행을 섞은 비교는 무의미해질 만큼 큰 폭입니다.
특히 긴 오디오 처리 방식을 눈여겨보세요. Artificial Analysis는 전체 길이 입력을 안정적으로 다루지 못하는 모델을 위해 Earnings22 오디오를 약 9분 단위로 쪼개고, 제한이 더 빡빡한 모델에는 약 30초 단위로 쪼갭니다. 이들이 공개한 설명은 해당 시스템으로 GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B, 알리바바의 Qwen3 ASR Flash를 지목합니다. 오류는 경계에 몰리기 때문에 청킹은 결과를 바꿉니다. 어떤 벤더가 여러분의 파일을 쪼갠다면, 그건 보정해서 없앨 인위적 잡음이 아니라 그 제품의 속성이고 채점표에 들어가야 할 항목입니다.
마지막으로, 모든 실행의 정확한 모델 버전 문자열과 날짜를 남기세요. "Whisper large-v3"는 버전이 아닙니다. whisper-large-v3, run 2026-08-31이 버전입니다.
5단계: 생각날 때가 아니라 벤더가 배포할 때 채점표를 다시 돌린다
호스팅형 음성 모델은 여러분 발밑에서 바뀝니다. 엔드포인트 이름은 그대로인데 그 뒤의 가중치는 그렇지 않고, 회의록이 고유명사에서 조금 더 나빠졌다고 이메일을 보내 주는 사람은 아무도 없습니다.
1단계에서 만든 그 클립으로 채점표 전체를 다시 돌려야 하는 방아쇠는 셋입니다.
- 벤더가 변경 이력을 공개한다. 모델, 화자 분리기, 구두점 및 서식 계층 중 하나라도 건드린 항목이면 해당됩니다.
- 달력상의 주기가 지난다. 대부분의 팀에는 분기마다면 충분하고, 전사 출력이 자동화된 후속 처리로 흘러 들어간다면 매달이 좋습니다.
- 핵심어 오류율이 두 실행 사이에서 5포인트 넘게 움직인다. 이 경우엔 이전을 결정하기 전에 먼저 원인 조사를 시작해야 합니다.
모든 실행을 표 하나에 모으세요. 날짜, 모델 버전 문자열, 다섯 항목 점수, 가중 합계입니다. 서너 번만 쌓이면 어떤 리더보드도 줄 수 없는 자산이 생깁니다. 특정 제품이 우리 회의처럼 들리는 오디오에서 어떻게 작동해 왔는지에 대한 시계열 말입니다.
결론: 정확도는 모델의 속성이 아니라 우리 회의실의 측정값이다
단어 오류율은 어떤 코퍼스 위에서의 모델의 속성입니다. 여러분에게 실제로 필요한 건 우리 오디오에서, 우리 어휘로, 서로 말을 자르는 우리 사람들과 함께한 모델의 속성이고, 그 값은 측정하기 전까지 존재하지 않습니다. 누구도 대신 발표해 줄 수 없습니다. 다른 누구의 기준 전사본에도 여러분의 코드명은 들어 있지 않으니까요.
다행인 건 측정이 싸다는 점입니다. 12분짜리 녹음 하나, 꼼꼼한 전사에 쓰는 하루, pip 설치 두 번, 그리고 한 페이지에 들어가는 채점표. 비싼 대안은 대부분의 팀이 기본값으로 고르는 쪽입니다. 공개된 백분율로 결정하고, 그 차이를 여섯 달 뒤에야 발견하는 것 말입니다. 팀이 명시적으로 거절한 일을 하기로 합의했다고 적힌 회의록에서요.
여러분은 어느 쪽을 틀리고 싶습니까. 소수점 한 자리입니까, 결정입니까.
Telli.sh는 여기에 있습니다: 저희는 이 채점표가 실제로 가중치를 주는 층들을 만듭니다. Telli.sh는 음성 인식 위에 화자 분리, 구획, 정제, 요약을 얹고, 번역은 44개 언어로, 인터페이스는 15개 언어로 제공합니다. 저 채점표에서 원시 WER가 아닌 90점이야말로 전사본이 누군가 실행에 옮길 수 있는 회의록으로 바뀌는 자리이기 때문입니다. 벤치마크가 아니라 진짜 데이터 포인트가 필요하다면, 직접 만든 12분짜리 클립을 넣어 보고 위의 절차로 결과를 채점해 보세요.
출처
- MeetEval — 회의 전사 평가 툴킷 — cpWER, tcpWER, ORC-WER, MIMO-WER, DI-cpWER 명령어, SegLST 형식, 그리고
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2)예제, 2026년 8월 31일 조회 - JiWER — 음성 인식 평가 패키지 — RapidFuzz 최소 편집 거리 기반의 WER, MER, WIL, WIP, CER
- dscore — 화자 분리 채점 도구 — NIST RT-09 평가 계획서 6.1절에 따른 DER, 화자 오류 + 오검출 음성 + 미검출 음성
- Artificial Analysis 음성 인식 리더보드 — AA-WER v2 방법론(AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25%, Earnings22-Cleaned-AA 25%로 구성된 약 8시간), 상위 5개 모델 수치, 정제된 기준 전사본 설명과 Earnings22 청킹 설명, 모두 2026년 8월 31일 조회
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 2020년 4월 20일 — 분할 및 비분할 다화자 트랙, 그리고 저녁 식사 자리 녹음 설계
- The AMI Meeting Corpus — 근접 마이크와 원거리 마이크를 동기화해 녹음한 100시간 분량의 회의 기록
- Azure Speech의 MAI-Transcribe — Microsoft Learn — 키워드 바이어싱과 문서화된 제약 사항
- 전사 정확도는 애초에 최종 산출물이 아니었다는 이전 글