La misma tasa de error del 10,0 %, la decisión contraria: cómo medir la precisión de transcripción de una reunión
La tasa de error de palabra puntúa igual la palabra « no » que la palabra « el ». Por eso dos transcripciones pueden quedarse ambas en el 10,0 % y solo una de ellas servir para algo. Aquí está el procedimiento de medición completo: un fragmento de prueba de 12 minutos construido según un pliego de reunión, una transcripción de referencia con reglas de normalización congeladas, los comandos exactos de cpWER y DER, y una tarjeta de cinco dimensiones que le concede al WER bruto 10 puntos sobre 100.
Aquí tienes dos transcripciones automáticas de la misma frase de veinte palabras, dicha en una reunión de producto.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review" (en esencia: Priya dijo que la migración de Helios se retrasa al T3 y que no deberíamos firmar el contrato con el proveedor antes de la revisión de seguridad.)
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review" (en esencia: Priya dijo que la migración de Helios se retrasa al T2 y que deberíamos firmar el contrato con el proveedor antes de la revisión de seguridad.)
Cada una contiene exactamente dos errores frente a lo que se dijo en realidad. Cada una obtiene una tasa de error de palabra del 10,0 %. La transcripción A perdió dos veces el artículo "the". La transcripción B adelantó un plazo en un trimestre y borró la palabra "not" de un compromiso.
Si tu proceso de evaluación clasifica esos dos sistemas como equivalentes, el problema es el proceso, no los modelos.
Este artículo es el procedimiento de medición que le entregaríamos a alguien a quien le han pedido elegir una herramienta de transcripción para el viernes. Cubre qué cuenta exactamente la tasa de error de palabra, por qué ese número engaña precisamente con el audio de reuniones, y un protocolo de cinco pasos que puedes ejecutar en una tarde con dos paquetes de código abierto y una grabación de 12 minutos. En otro artículo argumentamos que la precisión de transcripción por sí sola nunca fue el entregable. Este es su complemento: no el argumento, sino el método.
En resumen:
- El WER es
(substitutions + deletions + insertions) ÷ reference words, y cada palabra pesa exactamente lo mismo. La negación « no » y el artículo « el » cuestan igual.- Las clasificaciones publicadas se han comprimido. En el tablero independiente de Artificial Analysis, consultado el 31 de agosto de 2026, los cinco mejores modelos se sitúan entre el 1,7 % y el 2,6 % de AA-WER: un margen demasiado estrecho para sacar de ahí un ganador.
- Puntúa cinco dimensiones en su lugar, ponderadas: términos que sostienen el sentido (30), atribución de hablante (25), cifras e importes (20), segmentación (15), WER bruto (10). Las herramientas para las partes difíciles ya existen:
cpWERyDERvienen en MeetEval, el kit nacido de los desafíos CHiME.
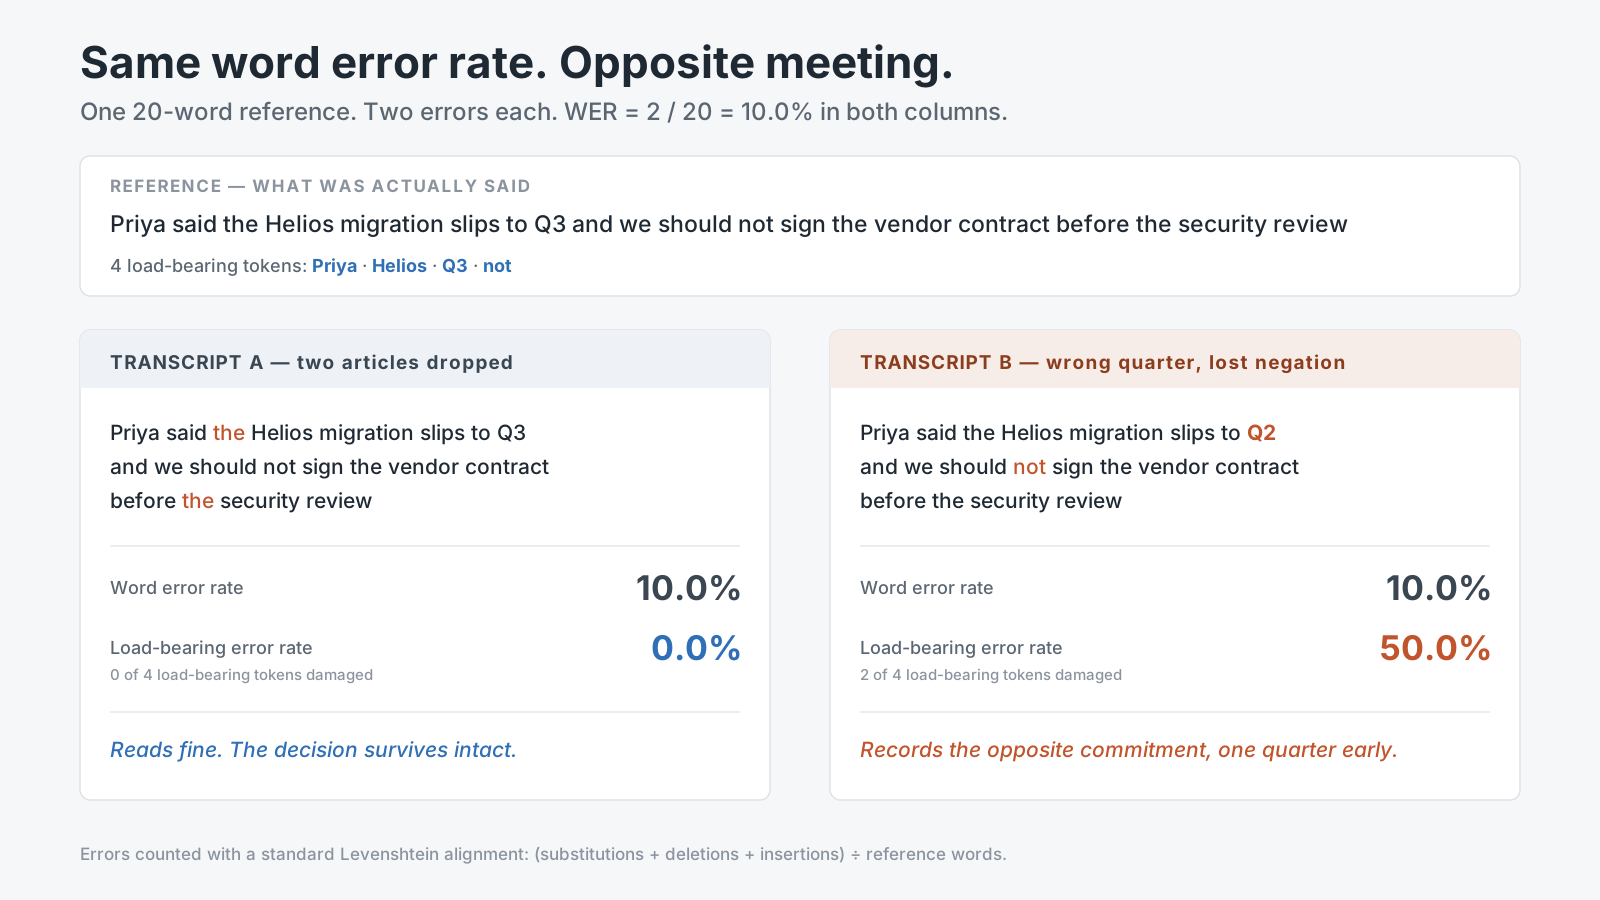
Ambas columnas contienen dos errores frente a una referencia de 20 palabras. Solo una de ellas sigue registrando la decisión que la sala tomó de verdad.
Qué cuenta la tasa de error de palabra, escrito por completo
El WER sale de un único alineamiento. Toma la transcripción de referencia: aquello que los humanos acuerdan que se dijo. Toma la salida de la máquina. Busca la secuencia de ediciones más barata que convierte una en la otra, mediante el alineamiento clásico de Levenshtein, y etiqueta cada edición:
- una sustitución cuando el modelo escribió otra palabra (« deploy » oído como « delay »),
- una eliminación cuando una palabra de la referencia no tiene equivalente en la salida,
- una inserción cuando el modelo produjo una palabra que nadie dijo.
Y entonces:
WER = (substitutions + deletions + insertions) ÷ reference words
El denominador es la longitud de la referencia, no la de la hipótesis, y por eso el WER puede superar legítimamente el 100 %: un modelo que alucina sin freno puede acumular más inserciones que palabras había para empezar.
Un ejemplo resuelto, tomado de la propia documentación de MeetEval para que la aritmética se pueda contrastar con una salida publicada. Referencia: "The quick brown fox jumps over the lazy dog", nueve palabras. Hipótesis: "The kwick brown fox jump over lazy", siete palabras. El alineamiento encuentra dos sustituciones (quick→kwick, jumps→jump) y dos eliminaciones (the, dog), ninguna inserción. Eso da (2 + 2 + 0) ÷ 9 = 0,4444, un WER del 44,4 %, y MeetEval imprime exactamente eso: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
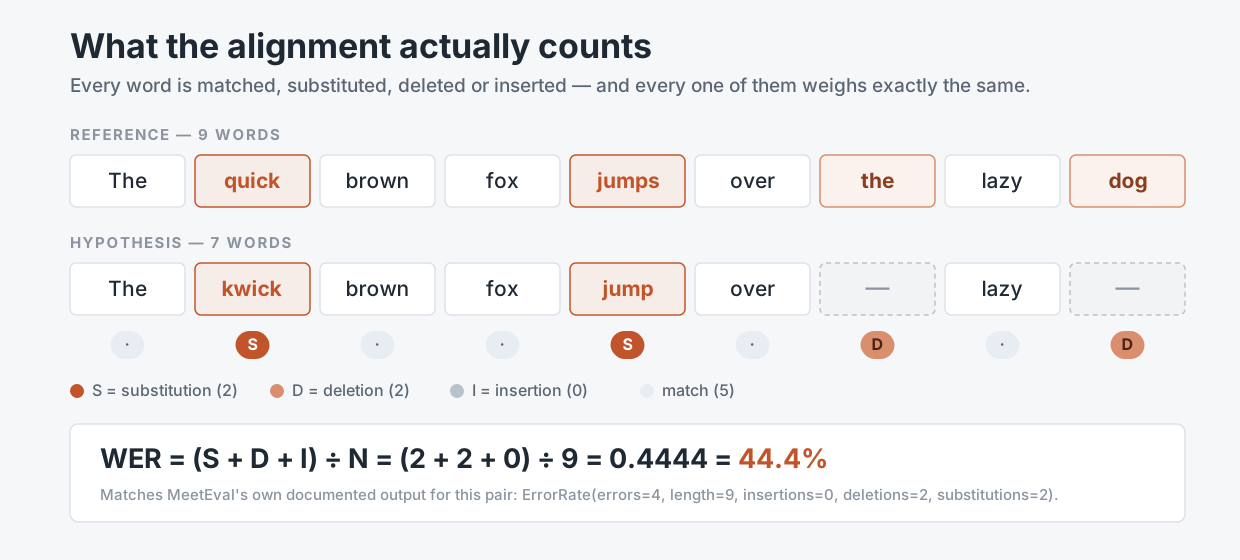
El alineamiento es mecánico y reproducible. Lo que no es, es ponderado. Fuente: documentación de MeetEval, consultada el 31 de agosto de 2026.
Dos propiedades de esa fórmula importan más que nada de lo que ponga la página de inicio de un proveedor. Primera: es plana. La métrica no tiene noción de que unas palabras sostienen la reunión y otras sostienen la gramática. Segunda: es ciega al hablante. El WER estándar concatena todo en un único flujo, así que un sistema que transcribe cada palabra a la perfección y atribuye la mitad a la persona equivocada puede sacar una puntuación inmaculada.
Por qué los números publicados ya no separan a tus candidatos
Saca las clasificaciones y el problema se vuelve aritmética. Artificial Analysis, que hace sus propias evaluaciones en lugar de reimprimir lo que declaran los proveedores, listaba el 31 de agosto de 2026 sus cinco mejores modelos por AA-WER: Fun-Realtime-ASR-preview con 1,7 %, ElevenLabs Scribe v2 con 2,2 %, MAI-Transcribe-1.5 de Microsoft con 2,4 %, Smallest AI Pulse Pro con 2,4 % y Gemini 3.5 Transcribe con 2,6 %. El mejor modelo de pesos abiertos, Voxtral Small de Mistral, está en 2,8 %.
Toda la cabeza del mercado cabe en una banda de 1,1 puntos. En una reunión de 45 minutos con unas 6.300 palabras habladas, la distancia entre el primero y el quinto son unas 57 palabras: menos de una palabra por pantalla de transcripción.
Hay un segundo problema, y es que el audio del benchmark no es tu audio. AA-WER v2 es una media ponderada por duración de audio sobre unas ocho horas procedentes de tres fuentes: AA-AgentTalk al 50 %, VoxPopuli-Cleaned-AA al 25 % y Earnings22-Cleaned-AA al 25 %. Los discursos parlamentarios y las llamadas de resultados están bien grabados, se pronuncian por turnos y carecen casi por completo de aquello que define una reunión interna: cuatro personas interrumpiéndose sobre un proyecto del que solo ellas han oído hablar.
La investigación sobre audio genuinamente conversacional lleva años tratando esto como una disciplina aparte. El desafío CHiME-6, publicado el 20 de abril de 2020 por Watanabe, Mandel, Barker y dieciocho coautores, construyó su evaluación sobre grabaciones de cenas entre amigos precisamente porque la conversación natural, con solapamientos y micrófonos lejanos, rompe sistemas que puntúan muy bien con habla leída. El AMI Meeting Corpus, 100 horas de grabaciones captadas a la vez con auriculares de proximidad y micrófonos de sala, existe por la misma razón.
Aquí está el punto, y lo decimos sin matizar: un WER publicado te dice que el modelo de un proveedor no está roto. No puede decirte a qué proveedor comprarle.
Qué detecta el WER y qué no puede detectar por construcción
| Modo de fallo | ¿Lo detecta el WER bruto? | Qué te cuesta | Qué lo mide de verdad |
|---|---|---|---|
| Palabra común mal oída (« their »/« there ») | Sí, con peso completo | Casi nada | WER |
| Muletillas y arranques en falso eliminados | Sí, contados como eliminaciones | Nada; a menudo es una mejora | WER, de forma engañosa |
| Nombre propio destrozado (« Xochitl » → « Societal ») | Sí, pero con el peso de 1 palabra | El nombre de la persona responsable | Tasa de error en términos que sostienen el sentido |
| Cifra o fecha equivocada (« Q3 » → « Q2 ») | Sí, peso de 1 palabra | Un plazo incumplido | Exactitud numérica, puntuada aparte |
| Negación borrada (« should not » → « should ») | Sí, peso de 1 palabra | La decisión invertida | Tasa de error en términos que sostienen el sentido |
| Palabras correctas, hablante equivocado | No: el WER es ciego al hablante | Nadie sabe quién se comprometió | cpWER, DER |
| Turnos de habla fundidos en un solo bloque | No | Un muro de texto ilegible | tcpWER con collar, lectura humana |
| Faltan los límites de frase | No: la puntuación se normaliza y desaparece | Un resumen que adivina la estructura | Puntuación de segmentación, lectura humana |
| Pasaje entero alucinado durante un silencio | En parte, como inserciones | Contenido inventado presentado como acta | WER más el recuento de inserciones leído aparte |
La mitad inferior de esa tabla es la que decide si una transcripción se convierte en una nota utilizable, y el WER estándar no ve nada de ella. Eso no es un defecto de la métrica: el WER responde a la pregunta para la que se diseñó en la investigación sobre dictado de los años noventa. Es un defecto de usarlo en solitario en 2026.
Paso 1: construye un fragmento de 12 minutos que se comporte como una reunión real
No evalúes sobre el archivo de demostración de un proveedor, y no evalúes sobre ocho horas de tu propio archivo histórico. Necesitas un fragmento lo bastante corto para transcribirlo a mano y lo bastante denso para romper cosas.
Apunta a 12 minutos. A un ritmo conversacional normal de unas 140 palabras por minuto y una densidad de habla en torno al 75 %, eso da alrededor de 1.260 palabras de referencia: suficientes para que una diferencia de 2 puntos en la tasa de error sean 25 palabras en lugar de ruido estadístico, y pocas para que dos personas lo transcriban con cuidado en una tarde.
Construye el fragmento según un pliego, no según la intuición. El nuestro:
- Cuatro hablantes o más, incluida al menos una persona conectada en remoto por un canal de audio comprimido, y al menos un acento no nativo en el idioma de trabajo.
- Noventa segundos o más de solapamiento genuino: dos personas hablando a la vez, alguien terminando la frase de otro, una tos encima de una decisión. En el habla cruzada es donde la diarización se desmorona en silencio, y un fragmento sin ella no mide nada.
- Veinticinco términos de dominio o más: nombres en clave de producto, siglas internas, nombres de clientes, nombres de asistentes. Son las palabras con más significado por carácter en la sala y menos frecuencia en cualquier corpus de entrenamiento.
- Quince cifras o más: fechas, trimestres, importes, números de versión, porcentajes. Pronuncia algunas de forma ambigua a propósito (« quince » y « cincuenta » en el mismo minuto).
- Tres decisiones negadas o más, dichas con naturalidad: « eso no lo lanzamos en esta versión », « el contrato lo dejamos en pausa ».
- Dos grabaciones simultáneas cuando puedas: el micrófono del propio portátil y una pista de auriculares por hablante. Ese es el diseño del corpus AMI, y permite separar « el modelo es flojo » de « la sala es ruidosa ».
Grábalo una vez. Guarda el WAV sin comprimir a 16 kHz o mejor. Cada herramienta que evalúes a partir de ahora recibirá este mismo archivo, para siempre.
Paso 2: escribe la referencia y congela las reglas de normalización antes de puntuar nada
La transcripción de referencia es un instrumento de medida, y tiene barras de error. Artificial Analysis mantiene versiones « limpias » de sus conjuntos públicos de evaluación precisamente porque las transcripciones de referencia originales contenían errores de transcripción propios; su nota es tajante: las versiones limpias "remove transcription errors from the reference text, providing a more accurate ground truth for model evaluation." Si quien opera un benchmark tiene que corregir una verdad de referencia publicada, tu transcripción de primera pasada tampoco es palabra sagrada.
Así que: dos personas transcriben de forma independiente y luego reconcilian cada diferencia. Presupuesta entre cinco y ocho veces el tiempo real para la pareja, lo que sitúa un fragmento de 12 minutos en torno a una jornada laboral de esfuerzo combinado. Ese es, con diferencia, el mayor coste de todo el procedimiento, y no hay forma de esquivarlo.
Después, escribe tu política de normalización antes de calcular una sola puntuación, porque esas decisiones por sí solas mueven el número final varios puntos:
- Números: ¿es « Q3 » el mismo token que « Q tres »? ¿Vale « cuarenta mil » lo mismo que « 40.000 »?
- Contracciones: ¿« we're » casa con « we are »?
- Muletillas: ¿están « eh », « mmm » y los arranques en falso en la referencia, y se puntúan?
- Mayúsculas y puntuación: normalmente se eliminan antes de puntuar, lo que significa que una herramienta que puntúa el texto de maravilla no recibe ningún crédito aquí y tienes que evaluarlo por separado en el paso 3.
Guarda el resultado en SegLST, el formato JSON que usan los desafíos CHiME y que MeetEval toma por defecto: un objeto por segmento con session_id, words, speaker, start_time y end_time. Los campos de hablante y de tiempo son los que hacen posibles las métricas sensibles al hablante, y añadirlos después es un suplicio.
Paso 3: puntúa cinco dimensiones y dale al WER bruto diez puntos de cien
Instala las herramientas — pip install jiwer meeteval — y puntúa cada dimensión sobre el mismo fragmento. JiWER calcula el WER junto con match error rate, word information lost, word information preserved y character error rate, mediante una implementación de distancia mínima de edición basada en RapidFuzz. MeetEval calcula las métricas específicas de reuniones.
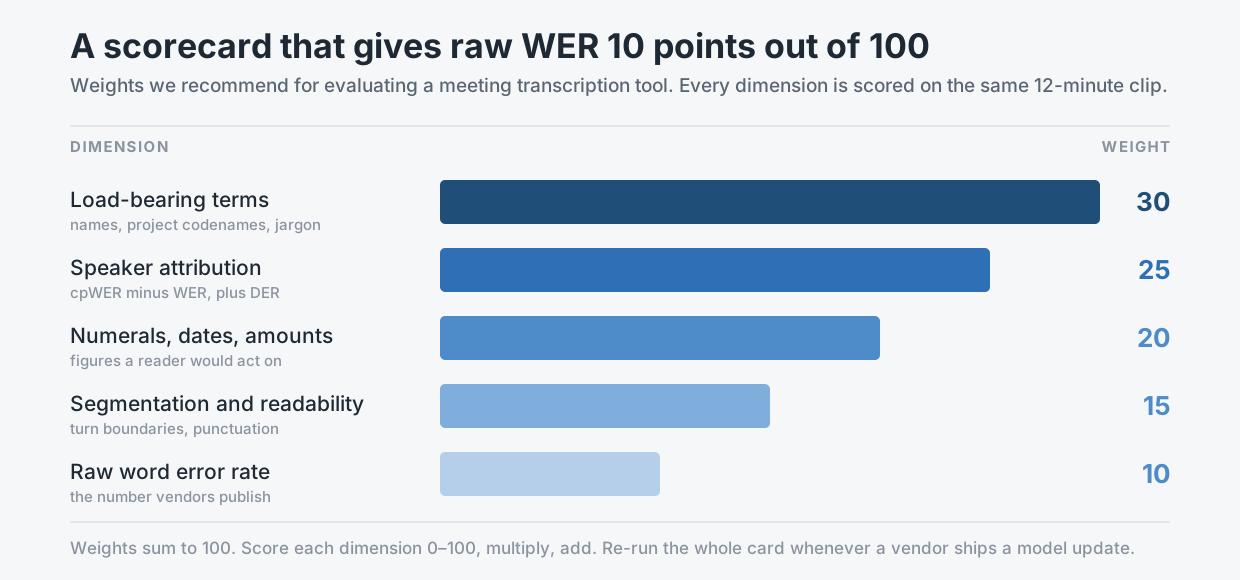
Nuestras ponderaciones recomendadas. La dimensión que anuncia todo proveedor es la que menos puntos vale.
Términos que sostienen el sentido — 30 puntos. Marca en la referencia cada nombre propio, cada nombre en clave y cada pieza de jerga del dominio. Después aplica la misma fórmula del WER únicamente sobre esos tokens. Al resultado lo llamamos la tasa de error en términos que sostienen el sentido, y es el número más predictivo de todo el ejercicio. En la pareja de transcripciones del inicio de este artículo, los cuatro tokens que sostienen el sentido son Priya, Helios, Q3 y not. La transcripción A no daña ninguno: 0,0 %. La transcripción B daña dos: 50,0 %. El mismo WER global del 10,0 %, cincuenta puntos de diferencia en la métrica que importa.
Atribución de hablante — 25 puntos. Ejecuta meeteval-wer cpwer -r ref.stm -h hyp.stm. El concatenated minimum-permutation WER encuentra la mejor correspondencia entre los hablantes de la referencia y los de la hipótesis, concatena las palabras de cada hablante y puntúa el resultado, de modo que las palabras atribuidas a la persona equivocada pasan a ser errores. Luego resta: el cpWER menos el WER simple es la brecha de atribución, la parte del daño que procede únicamente de no saber quién habló. Añade la diarization error rate para la vista temporal; el DER es la suma de error de hablante, habla en falsa alarma y habla omitida como porcentaje del tiempo puntuado, definido en la sección 6.1 del plan de evaluación NIST RT-09 e implementado en dscore, que MeetEval envuelve y que lee ficheros RTTM. Si tu candidato admite marcas de tiempo, usa tcpwer --collar 5 en lugar de cpwer para que una palabra correcta pegada al momento equivocado no quede perdonada en silencio.
Cifras, fechas e importes — 20 puntos. Extrae cada token numérico de la referencia y puntúa la coincidencia exacta con la hipótesis, después de aplicar tu política de normalización escrita. Repórtalo como una fracción llana — « 13 de 15 correctos » — y no como porcentaje, porque los recuentos son pequeños y un porcentaje sugiere una precisión que no tienes.
Segmentación y legibilidad — 15 puntos. Esta dimensión es humana. Pide a dos lectores que no asistieron a la reunión que lean la salida en bruto y marquen, por minuto: límites de frase colocados donde no toca, turnos de habla fundidos en un solo bloque y párrafos que obligan a releer. La puntuación se normalizó fuera de tu cálculo del WER, así que este es el único sitio donde se evalúa.
Tasa de error de palabra bruta — 10 puntos. Ejecuta jiwer y anota el número. Es una comprobación de suelo genuina: cualquier cosa por encima de aproximadamente el 12 % con audio limpio de proximidad indica un problema acústico real que merece investigarse. Por encima de ese suelo no discrimina casi nada, que es exactamente por lo que vale diez puntos y no ochenta.
Puntúa cada dimensión de 0 a 100, multiplica por su peso y suma. El resultado es comparable entre herramientas y a lo largo del tiempo, que es todo el objetivo.
Paso 4: ejecuta cada candidato sobre el archivo idéntico y escribe qué significó « idéntico »
Este es el paso que los equipos se saltan, y que invalida todo lo anterior.
El mismo WAV, la misma frecuencia de muestreo, ninguna recodificación entre candidatos. La misma referencia, la misma política de normalización aplicada por el mismo script. Diarización explícitamente activada o explícitamente desactivada en cada herramienta, y anotado en ambos casos: una herramienta evaluada con la diarización apagada no es comparable con otra evaluada con ella encendida. Sesgo por palabras clave o entidades apagado en la primera pasada y encendido en una segunda, ambas anotadas; Microsoft informa de hasta un 30 % de reducción del WER en MAI-Transcribe-1.5 solo por suministrar una lista de palabras clave, magnitud suficiente para que una comparación que mezcle ejecuciones sesgadas y no sesgadas no signifique nada.
Vigila en particular el tratamiento de audio largo. Artificial Analysis tiene que trocear su audio de Earnings22 en fragmentos de unos nueve minutos para modelos que no manejan de forma fiable la entrada completa, y de unos 30 segundos para modelos con límites más estrechos; su propia nota publicada menciona a GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B y Qwen3 ASR Flash de Alibaba entre los sistemas afectados. El troceado cambia los resultados, porque los errores se agrupan en las fronteras. Si un proveedor trocea tu archivo, eso es una propiedad del producto y pertenece a la tarjeta de puntuación, no a la lista de artefactos que hay que corregir.
Por último, anota la cadena exacta de versión del modelo y la fecha de cada ejecución. « Whisper large-v3 » no es una versión; whisper-large-v3, run 2026-08-31 sí lo es.
Paso 5: repite la tarjeta cuando el proveedor publique, no cuando te acuerdes
Los modelos de voz alojados cambian bajo tus pies. El nombre del endpoint permanece constante, los pesos que hay detrás no, y nadie te manda un correo cuando tus notas de reunión empeoran un poco con los nombres propios.
Tres disparadores deberían activar una nueva ejecución de la tarjeta completa, sobre el mismo fragmento que construiste en el paso 1:
- El proveedor publica una entrada de changelog que toque el modelo, el diarizador o la capa de puntuación y formato.
- Se cumple un intervalo de calendario: trimestral basta para la mayoría de equipos, mensual si la salida de transcripción alimenta algo automatizado aguas abajo.
- Tu tasa de error en términos que sostienen el sentido se mueve más de 5 puntos entre dos ejecuciones cualesquiera, lo que debería disparar una investigación antes que una migración.
Guarda cada ejecución en una única tabla: fecha, cadena de versión del modelo, las cinco puntuaciones dimensionales y el total ponderado. Tras tres o cuatro ejecuciones tendrás algo que ninguna clasificación puede darte: una serie temporal de cómo rinde un producto concreto sobre audio que suena como tus reuniones de verdad.
En el fondo: la precisión es una medición de tu sala, no una propiedad del modelo
La tasa de error de palabra es una propiedad de un modelo sobre un corpus. Lo que de verdad necesitas es una propiedad de un modelo sobre tu audio, para tu vocabulario, con tu gente hablando encima unos de otros, y esa magnitud no existe hasta que la mides. Nadie puede publicarla por ti, porque nadie más tiene tus nombres en clave en su transcripción de referencia.
La buena noticia es que la medición sale barata. Una grabación de 12 minutos, una jornada laboral de transcripción cuidadosa, dos instalaciones con pip y una tarjeta de puntuación que cabe en una página. La alternativa cara es la que la mayoría de equipos elige por defecto: decidir por un porcentaje publicado y descubrir la diferencia seis meses después, en un acta que dice que el equipo aceptó algo que había rechazado de forma explícita.
¿En qué número prefieres equivocarte: en un decimal o en una decisión?
Dónde encaja Telli.sh: construimos justo las capas que esta tarjeta pondera. Telli.sh ejecuta separación de hablantes, segmentación, refinado y resumen encima del reconocimiento de voz, con traducción a 44 idiomas de destino y una interfaz en 15, porque los 90 puntos de esa tarjeta que no son WER bruto son exactamente donde una transcripción se convierte en una nota sobre la que alguien puede actuar. Si quieres un dato real en lugar de un benchmark, pasa por ahí tu propio fragmento de 12 minutos y puntúa el resultado con el procedimiento de arriba.
Empezar una nota con IA en directo
Fuentes
- MeetEval — un kit de evaluación de transcripción de reuniones — los comandos cpWER, tcpWER, ORC-WER, MIMO-WER y DI-cpWER, el formato SegLST y el ejemplo resuelto
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), consultado el 31 de agosto de 2026 - JiWER — paquete de evaluación de reconocimiento de voz — WER, MER, WIL, WIP y CER mediante la distancia mínima de edición de RapidFuzz
- dscore — herramientas de puntuación de diarización — el DER como error de hablante más habla en falsa alarma más habla omitida, según la sección 6.1 del plan de evaluación NIST RT-09
- Clasificación de voz a texto de Artificial Analysis — metodología de AA-WER v2 (unas 8 horas repartidas entre AA-AgentTalk 50 %, VoxPopuli-Cleaned-AA 25 % y Earnings22-Cleaned-AA 25 %), las cifras de los cinco primeros modelos, la nota sobre las referencias limpias y la nota sobre el troceado de Earnings22, todo consultado el 31 de agosto de 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 de abril de 2020 — las pistas multihablante segmentada y no segmentada, y el diseño de grabación en cenas
- The AMI Meeting Corpus — 100 horas de grabaciones de reuniones captadas con micrófonos de proximidad y de campo lejano sincronizados
- MAI-Transcribe en Azure Speech — Microsoft Learn — el sesgo por palabras clave y las limitaciones documentadas
- Nuestro artículo anterior sobre por qué la precisión de transcripción nunca fue el entregable