Dieselbe Fehlerrate von 10,0 %, die gegenteilige Entscheidung: So misst man Transkriptionsgenauigkeit in Meetings
Die Wortfehlerrate bewertet das Wort „nicht“ und das Wort „der“ exakt gleich. Genau deshalb können zwei Transkripte beide bei 10,0 % landen, und nur eines davon ist brauchbar. Hier steht das vollständige Messverfahren: ein 12-minütiger Testausschnitt nach Meeting-Spezifikation, ein Referenztranskript mit eingefrorenen Normalisierungsregeln, die exakten cpWER- und DER-Befehle und eine Bewertungskarte über fünf Dimensionen, die der reinen WER 10 von 100 Punkten gibt.
Hier sind zwei maschinelle Transkripte desselben zwanzig Wörter langen Satzes aus einem Produktmeeting.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review" (sinngemäß: Priya sagte, die Helios-Migration verschiebt sich auf Q3, und wir sollten den Vertrag mit dem Anbieter nicht vor der Sicherheitsprüfung unterschreiben.)
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review" (sinngemäß: Priya sagte, die Helios-Migration verschiebt sich auf Q2, und wir sollten den Vertrag mit dem Anbieter vor der Sicherheitsprüfung unterschreiben.)
Jedes der beiden enthält gegenüber dem tatsächlich Gesagten genau zwei Fehler. Jedes erreicht eine Wortfehlerrate von 10,0 %. Transkript A hat zweimal den Artikel "the" verloren. Transkript B hat eine Frist um ein Quartal vorgezogen und aus einer Zusage das Wort "not" gestrichen.
Wenn Ihr Bewertungsverfahren diese beiden Systeme als gleichwertig einstuft, dann liegt das Problem im Verfahren — nicht in den Modellen.
Dieser Beitrag ist das Messverfahren, das wir jemandem in die Hand geben würden, der bis Freitag ein Transkriptionswerkzeug auswählen soll. Er beschreibt, was die Wortfehlerrate genau zählt, warum die Zahl gerade bei Meeting-Audio in die Irre führt und wie ein Protokoll aus fünf Schritten aussieht, das Sie an einem Nachmittag mit zwei Open-Source-Paketen und einer 12-minütigen Aufnahme durchlaufen können. An anderer Stelle haben wir argumentiert, dass Transkriptionsgenauigkeit allein nie das Ergebnis war. Dies ist das Gegenstück dazu — nicht das Argument, sondern die Methode.
Kurzfassung:
- WER ist
(substitutions + deletions + insertions) ÷ reference words, und jedes Wort trägt dasselbe Gewicht. Die Verneinung „nicht“ und der Artikel „der“ kosten gleich viel.- Die veröffentlichten Ranglisten sind zusammengerückt. Auf der unabhängigen Tafel von Artificial Analysis liegen die fünf besten Modelle, abgerufen am 31. August 2026, zwischen 1,7 % und 2,6 % AA-WER — ein zu schmaler Abstand, um daraus einen Sieger abzuleiten.
- Bewerten Sie stattdessen fünf Dimensionen, gewichtet: bedeutungstragende Begriffe (30), Sprecherzuordnung (25), Zahlen und Beträge (20), Segmentierung (15), reine WER (10). Die Werkzeuge für die schwierigen Teile existieren bereits —
cpWERundDERsind Bestandteil von MeetEval, dem Toolkit aus den CHiME-Wettbewerben.
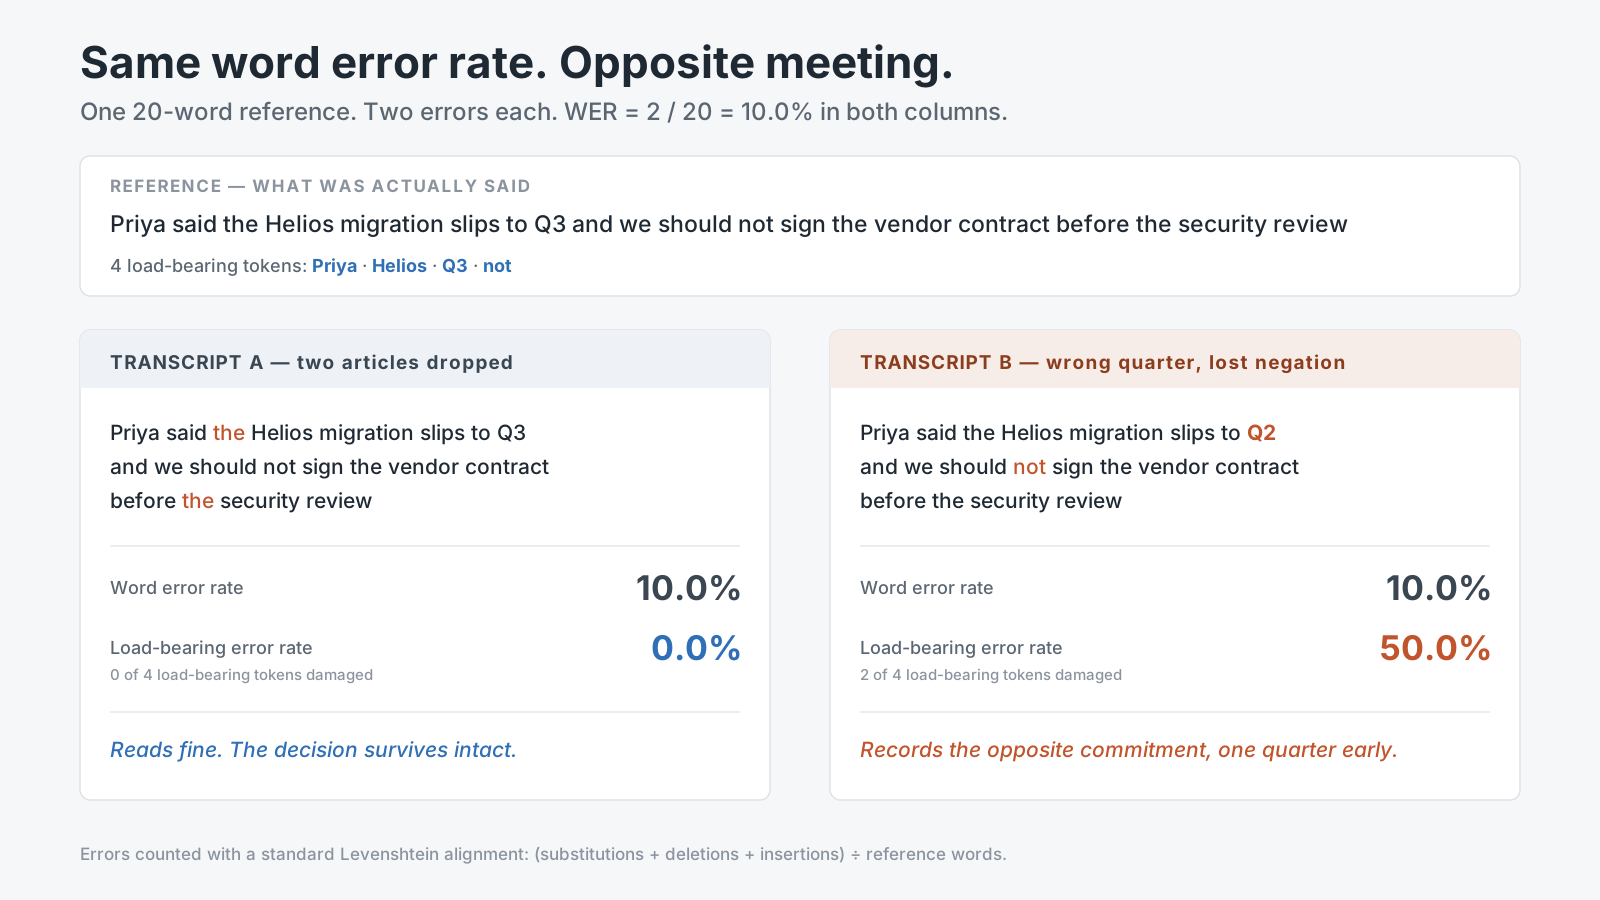
Beide Spalten enthalten zwei Fehler gegenüber einer Referenz aus 20 Wörtern. Nur eine von beiden hält noch fest, was der Raum tatsächlich entschieden hat.
Was die Wortfehlerrate zählt, vollständig ausgeschrieben
WER entsteht aus einer einzigen Ausrichtung. Man nimmt das Referenztranskript — das, worauf sich Menschen als das Gesagte einigen. Man nimmt die Ausgabe der Maschine. Dann sucht man die günstigste Folge von Änderungen, die das eine in das andere überführt, über die klassische Levenshtein-Ausrichtung, und benennt jede Änderung:
- eine Substitution, wenn das Modell ein anderes Wort geschrieben hat („deploy“ als „delay“ gehört),
- eine Deletion, wenn ein Referenzwort in der Ausgabe kein Gegenstück hat,
- eine Insertion, wenn das Modell ein Wort erzeugt hat, das niemand gesagt hat.
Und dann:
WER = (substitutions + deletions + insertions) ÷ reference words
Der Nenner ist die Länge der Referenz, nicht die der Hypothese. Deshalb kann WER legitim über 100 % steigen — ein Modell, das frei halluziniert, kann mehr Einfügungen produzieren, als es überhaupt Wörter gab.
Ein durchgerechnetes Beispiel, entnommen der Dokumentation von MeetEval, damit die Rechnung gegen eine veröffentlichte Ausgabe prüfbar bleibt. Referenz: "The quick brown fox jumps over the lazy dog" — neun Wörter. Hypothese: "The kwick brown fox jump over lazy" — sieben Wörter. Die Ausrichtung findet zwei Substitutionen (quick→kwick, jumps→jump) und zwei Deletionen (the, dog), keine Insertionen. Das ergibt (2 + 2 + 0) ÷ 9 = 0,4444, eine WER von 44,4 %, und MeetEval gibt genau das aus: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
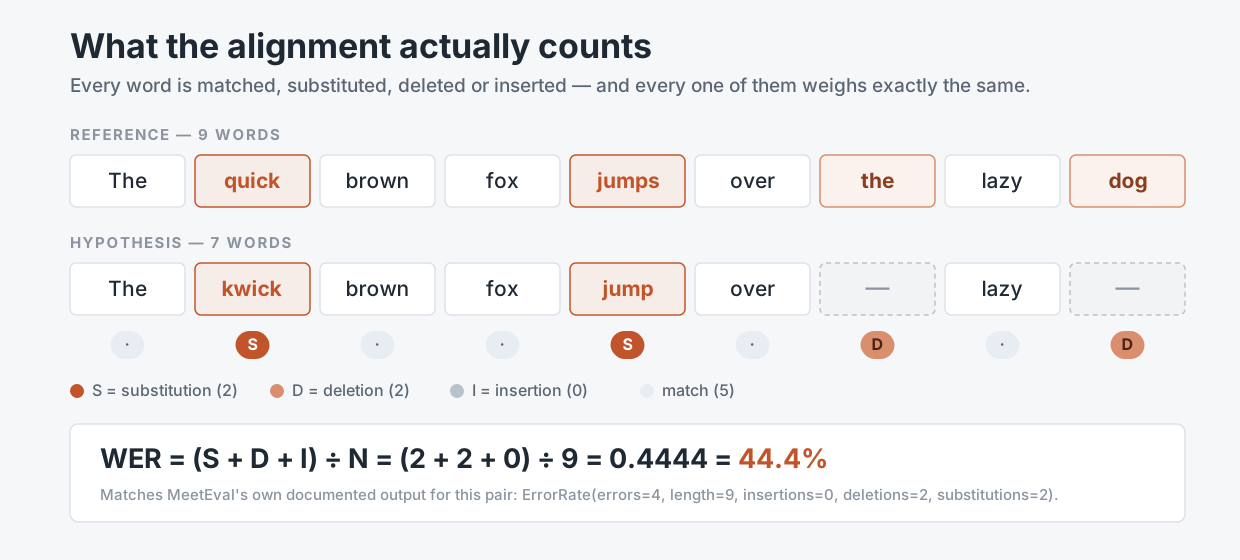
Die Ausrichtung ist mechanisch und reproduzierbar. Was sie nicht ist: gewichtet. Quelle: MeetEval-Dokumentation, abgerufen am 31. August 2026.
Zwei Eigenschaften dieser Formel zählen mehr als alles, was auf der Landingpage eines Anbieters steht. Erstens ist sie flach: Die Kennzahl kennt keinen Unterschied zwischen Wörtern, die das Meeting tragen, und Wörtern, die die Grammatik tragen. Zweitens ist sie sprecherblind: Die Standard-WER fügt alles zu einem einzigen Strom zusammen, weshalb ein System, das jedes Wort perfekt transkribiert und die Hälfte davon der falschen Person zuordnet, ein makelloses Ergebnis erzielen kann.
Warum die veröffentlichten Zahlen Ihre Kandidaten nicht mehr trennen
Zieht man die Ranglisten heran, wird das Problem zu einer Rechenaufgabe. Artificial Analysis, das eigene Evaluationen durchführt statt Herstellerangaben nachzudrucken, führte am 31. August 2026 als die fünf besten Modelle nach AA-WER auf: Fun-Realtime-ASR-preview mit 1,7 %, ElevenLabs Scribe v2 mit 2,2 %, MAI-Transcribe-1.5 von Microsoft mit 2,4 %, Smallest AI Pulse Pro mit 2,4 % und Gemini 3.5 Transcribe mit 2,6 %. Das beste Modell mit offenen Gewichten, Voxtral Small von Mistral, liegt bei 2,8 %.
Die gesamte Marktspitze passt in ein Band von 1,1 Punkten. Auf ein 45-minütiges Meeting mit rund 6.300 gesprochenen Wörtern gerechnet, beträgt der Abstand zwischen Platz eins und Platz fünf etwa 57 Wörter — weniger als ein Wort pro Bildschirmseite Transkript.
Es gibt ein zweites Problem: Das Benchmark-Audio ist nicht Ihr Audio. AA-WER v2 ist ein nach Audiodauer gewichteter Mittelwert über rund acht Stunden aus drei Quellen: AA-AgentTalk mit 50 %, VoxPopuli-Cleaned-AA mit 25 % und Earnings22-Cleaned-AA mit 25 %. Parlamentsreden und Bilanzkonferenzen sind gut aufgenommen, werden in geordneten Redebeiträgen gesprochen und enthalten so gut wie nichts von dem, was ein internes Meeting ausmacht — vier Leute, die einander über ein Projekt ins Wort fallen, von dem sonst niemand je gehört hat.
Die Forschung zu wirklich gesprächsartigem Audio behandelt das seit Jahren als eigene Disziplin. Der CHiME-6-Wettbewerb, veröffentlicht am 20. April 2020 von Watanabe, Mandel, Barker und achtzehn Ko-Autoren, baute seine Evaluation auf Aufnahmen von Abendessen in Privatwohnungen auf, und zwar genau deshalb, weil natürliche Konversation mit Überlappung und entfernten Mikrofonen Systeme zerlegt, die bei vorgelesener Sprache gut abschneiden. Das AMI Meeting Corpus, 100 Stunden Aufnahmen mit Nahbesprechungs-Headsets und Raummikrofonen zugleich, existiert aus demselben Grund.
Und hier der Punkt, den wir ohne Abschwächung formulieren: Eine veröffentlichte WER sagt Ihnen, dass das Modell eines Anbieters nicht kaputt ist. Sie kann Ihnen nicht sagen, bei welchem Anbieter Sie kaufen sollen.
Was WER erfasst und was sie strukturell nicht erfassen kann
| Fehlerart | Von reiner WER erfasst? | Was es Sie kostet | Was es tatsächlich misst |
|---|---|---|---|
| Häufiges Wort verhört („their“/„there“) | Ja, mit vollem Gewicht | So gut wie nichts | WER |
| Füllwörter und Satzabbrüche verschluckt | Ja, gezählt als Deletionen | Nichts — oft sogar eine Verbesserung | WER, aber irreführend |
| Eigenname verstümmelt („Xochitl“ → „Societal“) | Ja, aber mit dem Gewicht von 1 Wort | Der Name der verantwortlichen Person | Fehlerrate bedeutungstragender Begriffe |
| Zahl oder Datum falsch („Q3“ → „Q2“) | Ja, Gewicht von 1 Wort | Eine verpasste Frist | Zahlengenauigkeit, separat bewertet |
| Verneinung gelöscht („should not“ → „should“) | Ja, Gewicht von 1 Wort | Die umgekehrte Entscheidung | Fehlerrate bedeutungstragender Begriffe |
| Wörter richtig, Sprecher falsch | Nein — WER ist sprecherblind | Niemand weiß, wer zugesagt hat | cpWER, DER |
| Sprecherwechsel zu einem Block verschmolzen | Nein | Eine unlesbare Textwand | tcpWER mit Collar, menschliches Durchlesen |
| Satzgrenzen fehlen | Nein — Zeichensetzung wird wegnormalisiert | Eine Zusammenfassung, die die Struktur errät | Segmentierungswert, menschliches Durchlesen |
| Ganze Passage in Stille halluziniert | Teilweise — als Insertionen | Erfundenes, als Protokoll ausgegeben | WER plus separat gelesene Insertionszahl |
Die untere Hälfte dieser Tabelle entscheidet darüber, ob aus einem Transkript eine brauchbare Notiz wird, und die Standard-WER sieht davon nichts. Das ist kein Fehler der Kennzahl — WER beantwortet die Frage, für die sie in der Diktierforschung der 1990er entworfen wurde. Es ist ein Fehler daran, sie 2026 allein zu verwenden.
Schritt 1: Bauen Sie einen 12-Minuten-Ausschnitt, der sich wie ein echtes Meeting verhält
Evaluieren Sie nicht auf einer Demodatei des Anbieters und nicht auf acht Stunden aus dem eigenen Archiv. Sie brauchen einen Ausschnitt, der kurz genug ist, um ihn von Hand zu transkribieren, und dicht genug, um Systeme zu brechen.
Zielgröße: 12 Minuten. Bei einem normalen Gesprächstempo von etwa 140 Wörtern pro Minute und rund 75 % Sprechdichte ergibt das etwa 1.260 Referenzwörter — genug, damit ein Unterschied von 2 Prozentpunkten in der Fehlerrate 25 Wörtern entspricht statt statistischem Rauschen, und wenig genug, dass zwei Personen den Ausschnitt an einem Nachmittag sorgfältig abtippen können.
Bauen Sie den Ausschnitt nach einer Spezifikation, nicht nach Gefühl. Unsere:
- Vier oder mehr Sprecher, darunter mindestens eine Person, die über einen komprimierten Audiokanal aus der Ferne zugeschaltet ist, und mindestens ein nicht-muttersprachlicher Akzent in der Arbeitssprache.
- Neunzig Sekunden oder mehr echte Überlappung — zwei Personen sprechen gleichzeitig, jemand beendet den Satz eines anderen, ein Husten über einer Entscheidung. Bei Crosstalk zerfällt die Diarisierung still und leise, und ein Ausschnitt ohne Crosstalk misst nichts.
- Fünfundzwanzig oder mehr Fachbegriffe: Produkt-Codenamen, interne Abkürzungen, Kundennamen, Namen der Teilnehmenden. Das sind die Wörter mit der höchsten Bedeutung pro Zeichen im Raum und der niedrigsten Häufigkeit in jedem Trainingskorpus.
- Fünfzehn oder mehr Zahlen: Daten, Quartale, Geldbeträge, Versionsnummern, Prozentwerte. Sprechen Sie einige davon absichtlich mehrdeutig aus („fünfzehn“ und „fünfzig“ innerhalb derselben Minute).
- Drei oder mehr verneinte Entscheidungen, natürlich formuliert: „das liefern wir in diesem Release nicht aus“, „mit dem Vertrag warten wir noch“.
- Zwei parallele Aufnahmen, wo es machbar ist — das eingebaute Mikrofon des Notebooks und eine Headset-Spur pro Sprecher. Das ist das Design des AMI-Korpus, und es erlaubt die Trennung zwischen „das Modell ist schwach“ und „der Raum ist laut“.
Nehmen Sie das einmal auf. Speichern Sie die WAV-Datei unkomprimiert mit 16 kHz oder besser. Jedes Werkzeug, das Sie von nun an bewerten, bekommt für immer genau diese Datei.
Schritt 2: Schreiben Sie die Referenz — und frieren Sie die Normalisierungsregeln ein, bevor Sie irgendetwas bewerten
Das Referenztranskript ist ein Messinstrument, und es hat Fehlerbalken. Artificial Analysis pflegt eigens „bereinigte“ Fassungen seiner öffentlichen Evaluationssätze, weil die ursprünglichen Referenztranskripte selbst Transkriptionsfehler enthielten; die zugehörige Notiz ist unmissverständlich: Die bereinigten Fassungen „remove transcription errors from the reference text, providing a more accurate ground truth for model evaluation.“ Wenn schon ein Benchmark-Betreiber veröffentlichte Referenzdaten korrigieren muss, ist Ihr Transkript im ersten Durchgang auch keine heilige Schrift.
Also: Zwei Personen transkribieren unabhängig voneinander und gleichen anschließend jede Abweichung ab. Kalkulieren Sie für das Paar das Fünf- bis Achtfache der Echtzeit ein, was einen 12-Minuten-Ausschnitt auf ungefähr einen Arbeitstag gemeinsamen Aufwands bringt. Das ist der mit Abstand größte Kostenblock dieses gesamten Verfahrens, und daran führt kein Weg vorbei.
Halten Sie danach Ihre Normalisierungsregeln schriftlich fest, bevor Sie einen einzigen Wert berechnen, denn diese Entscheidungen allein verschieben die Endzahl um mehrere Punkte:
- Zahlen: Ist „Q3“ dasselbe Token wie „Q drei“? Ist „vierzigtausend“ gleich „40.000“?
- Verkürzungen: Passt „we're“ auf „we are“?
- Füllwörter: Stehen „ähm“, „öh“ und Satzabbrüche überhaupt in der Referenz, und werden sie bewertet?
- Groß- und Kleinschreibung sowie Zeichensetzung: normalerweise vor der Bewertung entfernt — was bedeutet, dass ein Werkzeug mit hervorragender Zeichensetzung hier keinen Kredit bekommt und Sie das in Schritt 3 gesondert bewerten müssen.
Speichern Sie das Ergebnis in SegLST, dem JSON-Format der CHiME-Wettbewerbe und dem Standard von MeetEval: ein Objekt pro Segment mit session_id, words, speaker, start_time und end_time. Erst die Felder für Sprecher und Zeit machen die sprecherbewussten Kennzahlen möglich, und sie nachträglich zu ergänzen ist eine Qual.
Schritt 3: Bewerten Sie fünf Dimensionen — und geben Sie der reinen WER zehn von hundert Punkten
Installieren Sie die Werkzeuge — pip install jiwer meeteval — und bewerten Sie jede Dimension am selben Ausschnitt. JiWER berechnet WER zusammen mit Match Error Rate, Word Information Lost, Word Information Preserved und Character Error Rate, über eine Implementierung der minimalen Editierdistanz mit RapidFuzz. MeetEval berechnet die meetingspezifischen Kennzahlen.
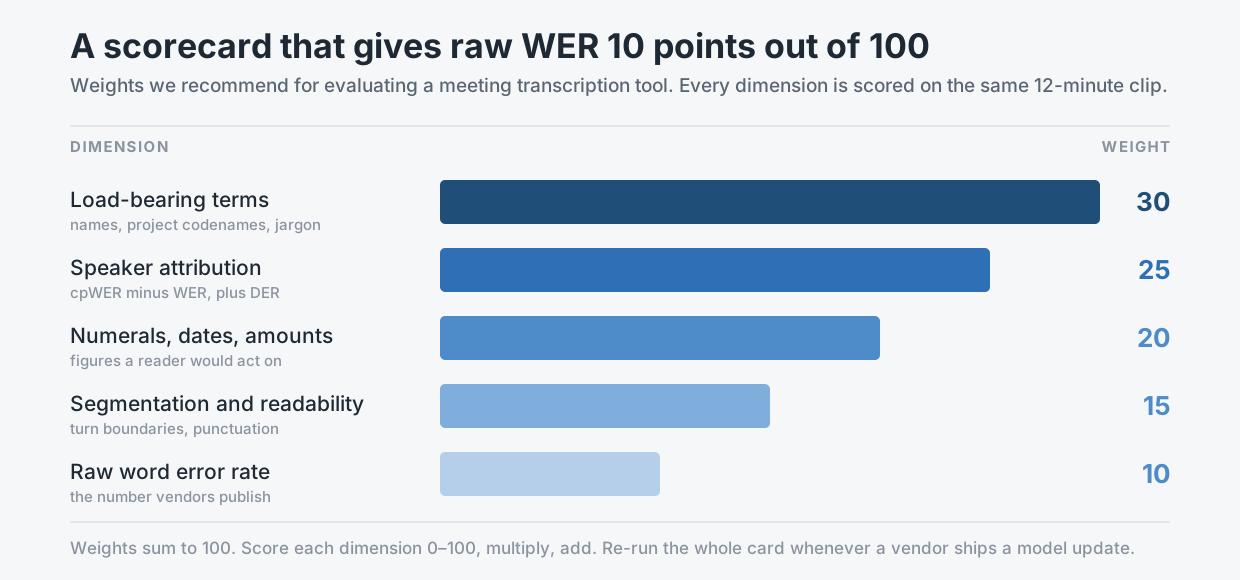
Unsere empfohlene Gewichtung. Die Dimension, mit der jeder Anbieter wirbt, ist die mit den wenigsten Punkten.
Bedeutungstragende Begriffe — 30 Punkte. Markieren Sie in der Referenz jeden Eigennamen, jeden Codenamen und jedes Stück Fachjargon. Berechnen Sie dann dieselbe WER-Formel ausschließlich über diese Tokens. Das Ergebnis nennen wir die Fehlerrate der bedeutungstragenden Begriffe, und es ist die aussagekräftigste einzelne Zahl der ganzen Übung. Im Transkriptpaar am Anfang dieses Beitrags sind die vier bedeutungstragenden Tokens Priya, Helios, Q3 und not. Transkript A beschädigt keines davon: 0,0 %. Transkript B beschädigt zwei: 50,0 %. Dieselbe Gesamt-WER von 10,0 %, fünfzig Punkte Abstand bei der Kennzahl, auf die es ankommt.
Sprecherzuordnung — 25 Punkte. Führen Sie meeteval-wer cpwer -r ref.stm -h hyp.stm aus. Die concatenated minimum-permutation WER sucht die beste Zuordnung zwischen Referenz- und Hypothesensprechern, verkettet die Wörter jedes Sprechers und bewertet das Ergebnis — Wörter, die der falschen Person zugeordnet sind, werden damit zu Fehlern. Dann subtrahieren Sie: cpWER minus einfache WER ist die Zuordnungslücke, also der Teil des Schadens, der ausschließlich daraus entsteht, dass nicht bekannt ist, wer gesprochen hat. Ergänzen Sie die Diarization Error Rate für die zeitliche Sicht; DER ist die Summe aus Sprecherfehler, Falschalarm-Sprache und ausgelassener Sprache als Prozentsatz der bewerteten Zeit, definiert in Abschnitt 6.1 des NIST-RT-09-Evaluationsplans und implementiert in dscore, das MeetEval einbindet und das RTTM-Dateien liest. Wenn Ihr Kandidat Zeitstempel unterstützt, verwenden Sie tcpwer --collar 5 statt cpwer, damit ein korrektes Wort am falschen Zeitpunkt nicht stillschweigend durchgeht.
Zahlen, Daten und Beträge — 20 Punkte. Extrahieren Sie jedes numerische Token aus der Referenz und bewerten Sie die exakte Übereinstimmung mit der Hypothese, nachdem Sie Ihre schriftlich festgehaltene Normalisierungsregel angewendet haben. Berichten Sie das Ergebnis als schlichten Bruch — „13 von 15 richtig“ — und nicht als Prozentwert, denn die Anzahlen sind klein und ein Prozentwert suggeriert eine Präzision, die Sie nicht haben.
Segmentierung und Lesbarkeit — 15 Punkte. Diese Dimension ist menschlich. Lassen Sie zwei Personen, die nicht am Meeting teilgenommen haben, die Rohausgabe lesen und pro Minute markieren: Satzgrenzen an der falschen Stelle, zu einem Block verschmolzene Sprecherwechsel und Absätze, die man zweimal lesen muss. Zeichensetzung wurde aus Ihrer WER-Berechnung herausnormalisiert, deshalb ist dies die einzige Stelle, an der sie überhaupt bewertet wird.
Reine Wortfehlerrate — 10 Punkte. Führen Sie jiwer aus und notieren Sie die Zahl. Sie ist eine echte Untergrenzenprüfung: Alles oberhalb von etwa 12 % bei sauberem Nahbesprechungs-Audio deutet auf ein tatsächliches akustisches Problem hin, das untersucht gehört. Jenseits dieser Untergrenze trennt sie so gut wie nichts, und genau deshalb ist sie zehn Punkte wert und nicht achtzig.
Bewerten Sie jede Dimension von 0 bis 100, multiplizieren Sie mit ihrem Gewicht, addieren Sie. Das Ergebnis ist über Werkzeuge und über die Zeit hinweg vergleichbar, und genau darum geht es.
Schritt 4: Lassen Sie jeden Kandidaten auf der identischen Datei laufen — und schreiben Sie auf, was „identisch“ hieß
Das ist der Schritt, den Teams überspringen, und er entwertet alles, was davor liegt.
Dieselbe WAV-Datei, dieselbe Abtastrate, keine Neukodierung zwischen den Kandidaten. Dieselbe Referenz, dieselbe Normalisierungsregel, angewendet vom selben Skript. Diarisierung bei jedem Werkzeug ausdrücklich ein- oder ausgeschaltet und in beiden Fällen protokolliert — ein mit ausgeschalteter Diarisierung bewertetes Werkzeug ist nicht mit einem vergleichbar, das mit eingeschalteter bewertet wurde. Stichwort- oder Entitäten-Biasing im ersten Durchgang aus und in einem zweiten Durchgang ein, beides protokolliert; Microsoft berichtet für MAI-Transcribe-1.5 von bis zu 30 % WER-Reduktion allein durch die Übergabe einer Stichwortliste, was groß genug ist, dass ein Vergleich mit vermischten Läufen jede Aussage verliert.
Achten Sie besonders auf den Umgang mit langem Audio. Artificial Analysis muss sein Earnings22-Audio für Modelle, die Eingaben in voller Länge nicht zuverlässig verarbeiten, auf rund neun Minuten stückeln und für Modelle mit engeren Grenzen auf rund 30 Sekunden — die eigene veröffentlichte Notiz nennt unter den betroffenen Systemen GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B und Qwen3 ASR Flash von Alibaba. Stückelung verändert die Ergebnisse, weil sich Fehler an den Grenzen häufen. Wenn ein Anbieter Ihre Datei stückelt, ist das eine Eigenschaft des Produkts und gehört in die Bewertungskarte, nicht als Artefakt herausgerechnet.
Notieren Sie schließlich die exakte Modellversion als Zeichenkette und das Datum jedes Laufs. „Whisper large-v3“ ist keine Version; whisper-large-v3, run 2026-08-31 ist eine.
Schritt 5: Wiederholen Sie die Karte, wenn der Anbieter ausliefert — nicht, wenn Sie daran denken
Gehostete Sprachmodelle verändern sich unter Ihnen. Der Name des Endpunkts bleibt konstant, die Gewichte dahinter nicht, und niemand schickt Ihnen eine E-Mail, wenn Ihre Meeting-Notizen bei Eigennamen etwas schlechter werden.
Drei Auslöser sollten einen erneuten Durchlauf der vollständigen Karte anstoßen, auf demselben Ausschnitt, den Sie in Schritt 1 gebaut haben:
- Der Anbieter veröffentlicht einen Changelog-Eintrag, der das Modell, die Diarisierung oder die Schicht für Zeichensetzung und Formatierung betrifft.
- Ein Kalenderintervall läuft ab — quartalsweise reicht für die meisten Teams, monatlich, wenn die Transkriptionsausgabe irgendetwas Automatisiertes weiter unten speist.
- Ihre Fehlerrate bei den bedeutungstragenden Begriffen bewegt sich um mehr als 5 Punkte zwischen zwei Läufen, was zuerst eine Untersuchung auslösen sollte und erst danach eine Migration.
Halten Sie jeden Lauf in einer einzigen Tabelle fest: Datum, Modellversion als Zeichenkette, die fünf Dimensionswerte, die gewichtete Gesamtsumme. Nach drei oder vier Läufen besitzen Sie etwas, das keine Rangliste Ihnen geben kann — eine Zeitreihe darüber, wie sich ein bestimmtes Produkt auf Audio verhält, das nach Ihren tatsächlichen Meetings klingt.
Das Fazit: Genauigkeit ist eine Messung Ihres Raums, keine Eigenschaft des Modells
Die Wortfehlerrate ist eine Eigenschaft eines Modells auf einem Korpus. Was Sie tatsächlich brauchen, ist eine Eigenschaft eines Modells auf Ihrem Audio, für Ihr Vokabular, mit Ihren Leuten, die durcheinanderreden — und diese Größe existiert nicht, bevor Sie sie messen. Niemand kann sie für Sie veröffentlichen, weil niemand sonst Ihre Codenamen im Referenztranskript stehen hat.
Die gute Nachricht: Die Messung ist billig. Eine 12-minütige Aufnahme, ein Arbeitstag sorgfältiges Transkribieren, zwei pip-Installationen und eine Bewertungskarte, die auf eine Seite passt. Die teure Alternative ist die, für die sich die meisten Teams standardmäßig entscheiden: nach einem veröffentlichten Prozentwert auszuwählen und den Unterschied sechs Monate später zu entdecken, in einer Notiz, laut der das Team etwas zugesagt hat, was es ausdrücklich abgelehnt hatte.
Bei welcher Zahl möchten Sie lieber falschliegen — bei einer Nachkommastelle oder bei einer Entscheidung?
Wo Telli.sh hineinpasst: Wir bauen genau die Schichten, die diese Bewertungskarte gewichtet. Telli.sh setzt Sprechertrennung, Segmentierung, Nachbearbeitung und Zusammenfassung auf die Spracherkennung auf, übersetzt in 44 Zielsprachen und stellt die Oberfläche in 15 Sprachen bereit, weil die 90 Punkte dieser Karte, die nicht reine WER sind, genau dort liegen, wo aus einem Transkript eine Notiz wird, mit der jemand arbeiten kann. Wenn Sie einen echten Datenpunkt statt eines Benchmarks wollen, schicken Sie Ihren eigenen 12-Minuten-Ausschnitt hindurch und bewerten Sie das Ergebnis mit dem Verfahren oben.
Quellen
- MeetEval — ein Toolkit zur Evaluation von Meeting-Transkription — die Befehle cpWER, tcpWER, ORC-WER, MIMO-WER und DI-cpWER, das SegLST-Format und das durchgerechnete Beispiel
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), abgerufen am 31. August 2026 - JiWER — Paket zur Evaluation von Spracherkennung — WER, MER, WIL, WIP und CER über die minimale Editierdistanz von RapidFuzz
- dscore — Werkzeuge zur Bewertung von Diarisierung — DER als Sprecherfehler plus Falschalarm-Sprache plus ausgelassene Sprache, gemäß Abschnitt 6.1 des NIST-RT-09-Evaluationsplans
- Speech-to-Text-Rangliste von Artificial Analysis — Methodik von AA-WER v2 (rund 8 Stunden aus AA-AgentTalk 50 %, VoxPopuli-Cleaned-AA 25 %, Earnings22-Cleaned-AA 25 %), die Werte der fünf besten Modelle, die Notiz zu den bereinigten Referenzen und die Notiz zur Earnings22-Stückelung, alle abgerufen am 31. August 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20. April 2020 — die segmentierten und unsegmentierten Mehrsprecher-Tracks und das Aufnahmedesign der Abendgesellschaften
- The AMI Meeting Corpus — 100 Stunden Meeting-Aufnahmen, synchron mit Nahbesprechungs- und Raummikrofonen aufgezeichnet
- MAI-Transcribe in Azure Speech — Microsoft Learn — Stichwort-Biasing und die dokumentierten Einschränkungen
- Unser früherer Beitrag dazu, warum Transkriptionsgenauigkeit nie das Ergebnis war