Zachowaj agenta programistycznego. Przenieś jego model na swojego Maca.
macMLX 0.11.0 łączy lokalną inferencję na Apple Silicon z Codex i Claude Code. Jak ścieżki API, aliasy modeli, pamięć i uprawnienia narzędzi wpływają na eksperyment.
Interfejs edytujący repozytorium i model decydujący, co zmienić, nie muszą pochodzić z tego samego miejsca. Agent programistyczny może zachować znajomy sposób pracy, kierując część zapytań inferencyjnych do modelu działającego na twoim Macu.
macMLX 0.11.0, wydany 17 listopada 2026 roku, nadaje takiemu układowi konkretne ścieżki API. Codex może korzystać z endpointu Responses, a Claude Code z endpointów Messages i liczenia tokenów. Backend działa na Apple Silicon z macOS 14 lub nowszym.
Zaletą jest kontrola nad miejscem wykonywania wybranej inferencji. Decyzja jest jednak bardziej złożona niż podmiana adresu URL: możliwości modelu, obsługa rozmowy, szeregowanie zapytań i uprawnienia samego narzędzia programistycznego nadal decydują o użyteczności konfiguracji.
Zanim zaczniesz: wybierz obsługiwany lokalny model zdolny do wywoływania narzędzi, zaplanuj miejsce na wagi i kontekst w pamięci zunifikowanej i traktuj poprawną odpowiedź czatu jako pierwszy test, a nie dowód działania całego procesu programistycznego.
Agent pozostaje z przodu, a lokalne API działa za nim
macMLX jest aplikacją i serwerem lokalnej inferencji napisanym w Swift, opartym na ekosystemie MLX firmy Apple. Domyślna ścieżka inferencji działa w procesie Swift, zamiast wymagać środowiska Python. To opis silnika domyślnego, a nie twierdzenie o każdej opcjonalnej integracji czy podprocesie, które projekt może obsługiwać.
Nowe wydanie jest ważne, ponieważ agenci programistyczni używają czegoś więcej niż prostego schematu prompt–tekst. Mogą poprosić model o wywołanie narzędzia, wykonać dozwoloną operację, zwrócić wynik i zapytać o następny krok. Serwer musi przenosić przez tę pętlę odpowiednią historię i struktury zapytań.
Wersja 0.11.0 dodaje zgodną z OpenAI powierzchnię /v1/responses dla Codex, a także zmiany dla Claude Code przez /v1/messages i /v1/messages/count_tokens. Dokumentacja wsparcia wersji opisuje też ponowne przekazywanie wcześniejszego rozumowania do szablonu czatu modelu i ponowne wykorzystanie historii tur agenta w modelach hybrydowych i z przesuwanym oknem uwagi. Te szczegóły integracji mają praktyczną konsekwencję: backend odpowiadający na powitanie niekoniecznie poradzi sobie z następną turą narzędziową.
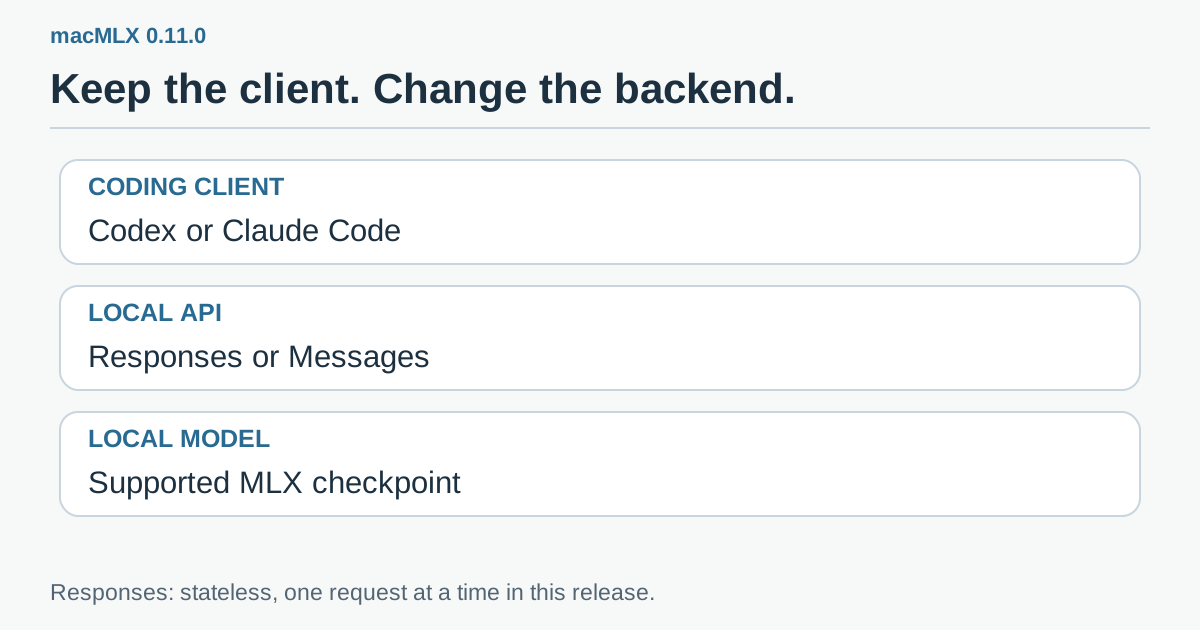 Autorska grafika wyjaśniająca: klient programistyczny zarządza swoim procesem pracy, macMLX obsługuje zgodne zapytania API, a wybrany lokalny model wykonuje inferencję. Uruchamianie narzędzi stanowi osobną granicę uprawnień.
Pomyśl o API jak o przejściówce. Pozwala połączyć dwa elementy, ale nie zrównuje ich mocy, pojemności ani zachowania. Znajomy interfejs Codex lub Claude Code nie zamienia mniejszego modelu lokalnego w wcześniej używany model zdalny.
Bezstanowy endpoint Responses zmienia sposób skalowania
Endpoint Responses w 0.11.0 nie przechowuje stanu między zapytaniami. Klient musi przesłać rozmowę potrzebną w następnej turze. README oznaczonej wersji mówi, że Codex to robi, natomiast previous_response_id jest odrzucany, zamiast służyć do pobrania zapisanej odpowiedzi serwera.
Bezstanowa obsługa zapytań nie oznacza braku buforowania w środowisku wykonawczym. Stan rozmowy i wielokrotnie używany bufor inferencji rozwiązują różne problemy. Klient nadal przekazuje wymaganą historię; zgodny bufor może ograniczyć pracę, gdy część przesłanego wejścia pasuje do wcześniejszego prefiksu.
Ten nowy endpoint ma również jawny limit współbieżności: obsługuje jedno zapytanie naraz. README wyjaśnia, że podagenci Codex trafiają więc do kolejki. Uruchomienie kilku agentów może wydłużyć kolejkę, zamiast zwielokrotnić użyteczną przepustowość Maca. Projekt ma inne możliwości przetwarzania wsadowego, ale nie należy przypisywać ich ścieżce, dla której udokumentowano wykonanie szeregowe.
Wpływa to na projekt pierwszej próby. Łatwiej ocenić jednego asystenta wykonującego ograniczone zadanie w repozytorium niż rój otwierający kilka długich rozmów. Zapisuj czas całego zadania, łącznie z oczekiwaniem, ładowaniem i użyciem narzędzi. Tokeny na sekundę podczas jednego aktywnego generowania to tylko część tego czasu.
Zacznij od małego zadania w repozytorium ze znaną odpowiedzią
Przykładowym pierwszym zadaniem jest poproszenie agenta o wyjaśnienie małego modułu i zaproponowanie testu jednostkowego bez zmieniania plików. Możesz sprawdzić, czy wyjaśnienie odpowiada kodowi i czy test dotyczy rzeczywistego kontraktu. Daje to punkt odniesienia przed przyznaniem uprawnień zapisu lub powłoki.
Drugie zadanie może pozwolić na zmianę w jednorazowej gałęzi: przemianowanie jasno ograniczonego symbolu wewnętrznego, dostosowanie wywołań i uruchomienie istniejącego testu celowanego. Kryteria sukcesu są konkretne. Czy zmieniono tylko zamierzone pliki, zachowano publiczny kontrakt i podano rzeczywisty wynik testu? Długie, pewne siebie wyjaśnienie nie zastępuje tych kontroli.
Trzeci scenariusz to praca z naciskiem na tryb offline nad poufnym szkicem lub prywatnym fragmentem kodu. Lokalna inferencja może zatrzymać zapytanie modelowe na Macu, zależnie od konfiguracji klienta, ale cały agent nie staje się automatycznie offline. Operacje repozytorium, menedżery pakietów, wyszukiwarki, serwery MCP i inne integracje nadal mogą łączyć się z zewnętrznymi usługami. Sprawdź je oddzielnie przed obietnicą dotyczącą miejsca przetwarzania danych.
To proponowane zadania oceniające. Wyniki zgodności w wydaniu pochodzą z własnych testów integracyjnych dewelopera, a nie z naszej instalacji.
Skonfiguruj endpoint bez utraty działającego dostawcy
Użyj Maca z Apple Silicon i macOS 14 lub nowszym, zainstaluj oznaczoną wersję udokumentowaną drogą i postępuj zgodnie z aktualnymi wskazówkami projektu dotyczącymi Gatekeepera. Nie wyłączaj zabezpieczeń całego systemu tylko po to, by otworzyć aplikację. Wybierz model z obsługiwanych ścieżek projektu i przed pobraniem sprawdź jego własną licencję pod kątem planowanego zastosowania.
README wersji 0.11.0 dokumentuje macmlx serve i lokalne API na porcie 8000. Użyj identyfikatora modelu faktycznie obecnego na swoim komputerze. Poniższe przykłady klientów odtwarzają udokumentowany schemat konfiguracji; nie dowodzą, że przykładowy checkpoint jest już zainstalowany na twoim Macu.
- Uruchom backend i sprawdź listę modeli. Wykonaj udokumentowane polecenie serwera lub załaduj model w aplikacji. Sprawdź rzeczywisty adres serwera i identyfikatory udostępniane przez
/v1/models. - Zachowaj kopię bieżącej konfiguracji klienta. Świadomie dodaj lokalnego dostawcę, zamiast nadpisywać działający układ, który możesz chcieć porównać lub przywrócić.
- Podłącz jednego klienta. Zacznij od Codex albo Claude Code, a nie obu jednocześnie. Potwierdź krótkie zapytanie tekstowe, zanim przejdziesz do zadania z narzędziem.
- Ogranicz pierwszy zestaw uprawnień. Zacznij od odczytu i proponowania zmian. Rozszerzaj dostęp dopiero wtedy, gdy wymaga tego proces pracy.
Dla Codex przykład dostawcy z README wygląda tak:
model = "Qwen3.6-27B-4bit"
model_provider = "macmlx"

[model_providers.macmlx]
name = "macMLX"
base_url = "http://127.0.0.1:8000/v1"
wire_api = "responses"
Jeśli włączysz uwierzytelnianie bearer w backendzie, zastosuj wskazówki env_key z README i przechowuj klucz w przeznaczonej do tego zmiennej środowiskowej. Przykład localhost nie jest zaleceniem wystawienia nieuwierzytelnionej usługi inferencji do sieci.
Udokumentowane połączenie Claude Code używa bazowego URL-a bez końcówki /v1 i mapuje aliasy modeli:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_API_KEY=sk-local
export ANTHROPIC_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_SMALL_FAST_MODEL=Qwen3.6-27B-4bit
claude
Tutaj sk-local jest przykładowym symbolem zastępczym projektu dla serwera bez uwierzytelniania bearer, a nie prawdziwym poświadczeniem usługi. Gdy uwierzytelnianie bearer jest włączone, README wskazuje zamiast tego ANTHROPIC_AUTH_TOKEN ze skonfigurowanym kluczem. Wskazówki dotyczące aliasów mają znaczenie: niezamapowany alias może wysłać nazwę modelu claude-* do serwera posiadającego wyłącznie lokalne checkpointy i spowodować błąd 404.
Wsparcie modeli wymaga precyzyjniejszej odpowiedzi niż „zgodne z MLX”
Deklarowane w wydaniu testy całościowe obejmują Xcode 27 z Qwen3.6-27B oraz klienta Foundation Models firmy Apple z tym modelem i Gemma 4 E4B. Sprawdzano tekst. Nie należy przedstawiać tego jako dowodu, że działa każdy klient programistyczny, wariant modelu lub zapytanie obrazowe.
Dokumentacja wsparcia osobno opisuje wejście obrazowe dla checkpointów Gemma 4 o obsługiwanej strukturze E4B oraz gęstych checkpointów Qwen3.5/3.6 zawierających swój moduł wizyjny. Mówi też, że zapytanie obrazowe nie zapisuje wpisu w buforze promptów. Obecność modelu na liście rozpoznawanych architektur nie gwarantuje działania procesora wejścia, wag ani ścieżki multimodalnej dowolnego checkpointu.
W zadaniu programistycznym ze zrzutem ekranu sprawdź ścieżkę obrazu niezależnie. Poproś o opis z widoczną, znaną odpowiedzią, zanim zlecisz agentowi przeprojektowanie na tej podstawie komponentu. Zachowaj zadanie czysto tekstowe jako wariant zapasowy, aby odróżnić problem ładowania wizji od ogólnego problemu pętli narzędziowej.
Ta sama zasada dotyczy formatów wyjścia i narzędzi. Checkpoint musi emitować struktury narzędziowe oczekiwane przez klienta, a nie tylko wspomnieć o poleceniu w tekście. Sprawdź jedno wywołanie narzędzia, zwrócony wynik i użyteczną odpowiedź następczą. Niepowodzenie w drugiej turze może powiedzieć o przydatności integracji więcej niż udane pierwsze wygenerowanie.
Pamięć zunifikowana sprawia, że kontekst ma rzeczywisty budżet
CPU i GPU Maca współdzielą pamięć fizyczną. Eliminuje to część jawnych transferów, ale nie usuwa kosztu wag modelu, aktywacji, bufora KV i działających obok aplikacji. Edytor, przeglądarka i lokalny model mogą rywalizować o tę samą pojemność.
Nie szacuj wymagań na podstawie samej liczby parametrów. Liczą się precyzja wag, rzeczywisty rozmiar checkpointu, długość kontekstu i zachowanie środowiska wykonawczego. Zacznij od obsługiwanego checkpointu pozostawiającego miejsce na normalną pracę, a następnie mierz presję na pamięć i responsywność podczas reprezentatywnego zadania.
Warto sprawdzić konkretny szczegół aktualizacji: dokumentacja wydania mówi, że zapytanie chat-completion bez jawnego limitu tokenów może teraz trwać do 32,768 tokenów zamiast 2,048. Dotyczy to udokumentowanego zachowania chat-completion, a nie uniwersalnej gwarancji wyniku dla każdej ścieżki API. Mimo to jawne limity ułatwiają kontrolowanie zadań eksperymentalnych. Zapytanie, które przypadkowo generuje znacznie dłużej, niż planowano, zużywa czas i może przeszkadzać w pracy, którą Mac miał wykonywać.
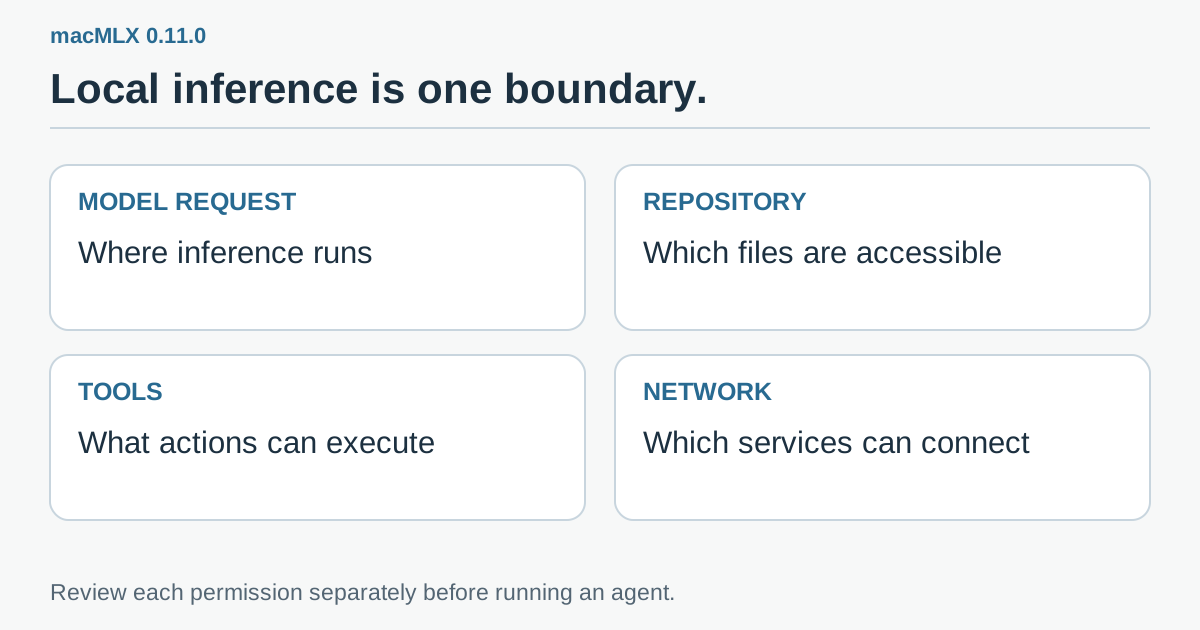 Autorska lista kontrolna: zapytania do modelu, dostęp do repozytorium, uruchamianie narzędzi i połączenia zewnętrzne wymagają osobnych decyzji. Lokalny endpoint modelu nie ogranicza automatycznie trzech pozostałych obszarów.
Porównuj całe zadania, zanim porównasz abonamenty
Oczywistą zaletą jest mniejsza zależność od zdalnej inferencji przy wybranych zadaniach. Mniej oczywistym kosztem jest czas operatora. Ładowanie modelu, oczekiwanie w szeregowej kolejce, poprawianie niewystarczającej zmiany i utrzymanie środowiska należą do tego samego porównania.
Porównując obecnego dostawcę z lokalnym backendem, użyj tego samego ograniczonego zadania i tych samych testów odbiorczych. Zapisz zimne ładowanie, pierwszą odpowiedź, czas całego zadania, udane tury narzędziowe, końcowe wyniki testów i zakres ludzkich poprawek. Zachowaj w notatce model, kontekst i wersje klienta, aby przyszła aktualizacja była porównywalna.
Przy częstym, niewielkim zadaniu lokalny układ może być wygodny, nawet gdy przegrywa wyścig szybkości. Przy trudnej zmianie wymagającej kilku nieudanych rund model zdalny może nadal kosztować mniej łącznej uwagi. To decyzja na poziomie zadania, a nie twierdzenie, że jedno miejsce wdrożenia wygrywa każdą pracę.
Sprzęt, który już posiadasz, jest dobrym miejscem do eksperymentowania. Udany test zgodności to powód do rozszerzenia kontrolowanego procesu, a nie natychmiastowego kupna większego Maca.
Znajome narzędzie programistyczne może stać się elastyczniejszym warsztatem
macMLX 0.11.0 ułatwia próby z lokalną inferencją bez wymiany całego interfejsu programistycznego. Jego najcenniejszym wkładem jest jawne powiązanie klientów, formatów API i obsługiwanych ścieżek modeli.
Zacznij od jednego klienta, jednego modelu i jednego zadania z weryfikowalnym wynikiem. Zachowaj lokalny endpoint, traktuj uprawnienia narzędzi jako osobną decyzję i uwzględnij w pomiarach oczekiwanie oraz poprawki. Użytecznym rezultatem jest warsztat, który potrafi wybrać właściwy backend do zadania, zamiast znajomego interfejsu ukrywającego niesprawdzone założenie.
Źródła i oficjalne materiały
- Wydanie macMLX 0.11.0 z 17 listopada 2026 roku.
- README wersji 0.11.0: instalacja, lokalne udostępnianie i konfiguracja klientów.
- Oficjalna dokumentacja zgodności i historii wydań.
- Oficjalna grafika wprowadzająca macMLX. Rzeczywisty produkt jest podlinkowany; schematy w artykule są autorskimi wyjaśnieniami.
Testy zgodności są przypisane projektowi. Przykłady zadań i procedura porównania stanowią propozycje ćwiczeń dla czytelnika.
Rekomendacja Telli.sh: Przechowuj model, ustawienia klienta i wyniki zadań w jednym miejscu, aby każdy eksperyment z lokalną AI miał odtwarzalny punkt wyjścia. Utwórz pierwszą notatkę w Telli.sh.