Tieni il tuo agente di programmazione. Sposta il suo modello sul Mac.
macMLX 0.11.0 collega l'inferenza locale su Apple Silicon a Codex e Claude Code. Ecco come percorsi API, alias dei modelli, memoria e permessi degli strumenti cambiano la prova.
L'interfaccia che modifica il repository e il modello che decide cosa modificare non devono necessariamente provenire dallo stesso posto. Un agente di programmazione può conservare il flusso di lavoro abituale e inviare alcune richieste di inferenza a un modello in esecuzione sul tuo Mac.
macMLX 0.11.0, pubblicato il 17 novembre 2026, offre percorsi API concreti per questa configurazione. Codex può usare l'endpoint Responses, mentre Claude Code può usare gli endpoint Messages e di conteggio dei token. Il backend funziona su Apple Silicon con macOS 14 o successivo.
Il vantaggio è il controllo su dove avviene l'inferenza di determinate richieste al modello. La scelta è più articolata della sostituzione di un URL: capacità del modello, gestione della conversazione, serializzazione delle richieste e permessi dello strumento di programmazione continuano a determinare l'utilità della configurazione.
Prima di iniziare: scegli un modello locale supportato che sappia chiamare strumenti, prevedi lo spazio per pesi e contesto nella memoria unificata e considera una risposta in chat riuscita come il primo test, anziché come prova del funzionamento dell'intero flusso di programmazione.
L'agente resta in primo piano; dietro c'è un'API locale
macMLX è un'applicazione e un server di inferenza locale in Swift, costruito intorno all'ecosistema MLX di Apple. Il percorso di inferenza predefinito viene eseguito nel processo Swift, senza richiedere un runtime Python. Questa descrizione riguarda il motore predefinito, non ogni integrazione facoltativa o sottoprocesso che il progetto potrebbe supportare.
La nuova versione conta perché gli agenti di programmazione usano interazioni più articolate di un semplice prompt in ingresso e testo in uscita. Possono chiedere al modello una chiamata a uno strumento, eseguire un'operazione consentita, restituirne l'esito e chiedere il passo successivo. Il server deve trasportare la cronologia e le strutture delle richieste pertinenti lungo tutto il ciclo.
La versione 0.11.0 aggiunge una superficie API /v1/responses compatibile con OpenAI per Codex, insieme a modifiche per Claude Code tramite /v1/messages e /v1/messages/count_tokens. Il registro di supporto delle versioni descrive anche la riproposizione dei ragionamenti precedenti nel template di chat del modello e il riutilizzo della cronologia dei turni dell'agente sui modelli ibridi e a finestra scorrevole. Sono dettagli di integrazione con una conseguenza pratica: un backend che risponde a un saluto non è necessariamente capace di superare il turno successivo con uno strumento.
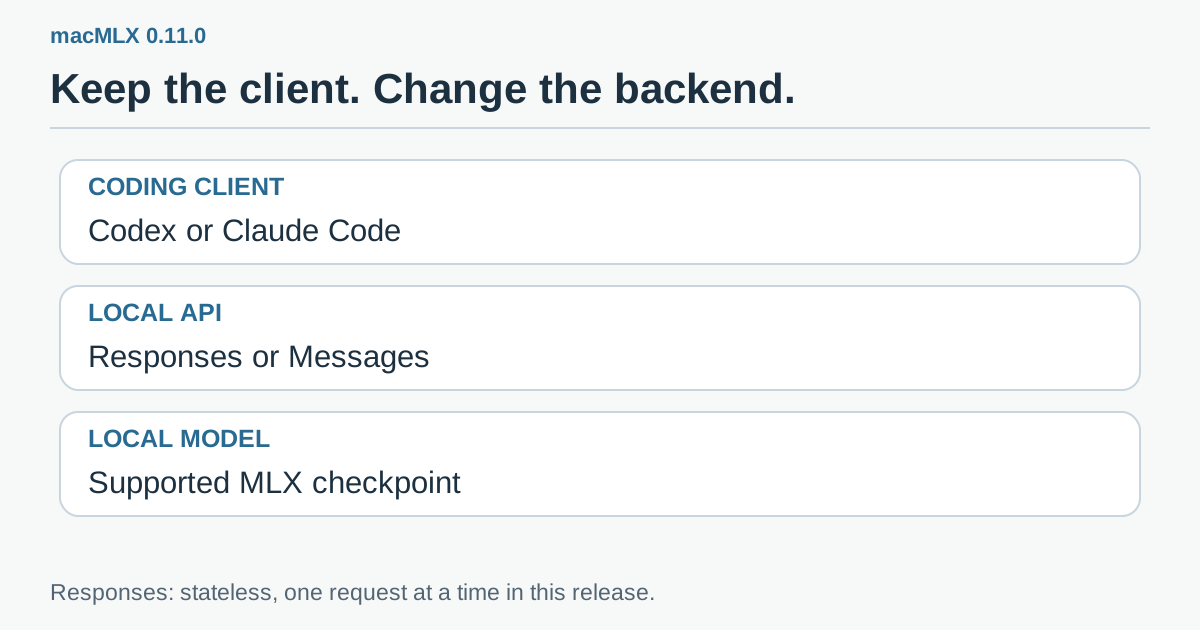 Grafico esplicativo originale: il client di programmazione gestisce il proprio flusso, macMLX serve richieste API compatibili e il modello locale selezionato fornisce l'inferenza. L'esecuzione degli strumenti ha un confine di autorizzazione separato.
Pensa all'API come a un adattatore per prese. Permette a due componenti di collegarsi, ma non ne rende identiche potenza, capacità o comportamento. L'interfaccia familiare di Codex o Claude Code non trasforma un modello locale più piccolo nel modello remoto che usavi prima.
Un endpoint Responses senza stato cambia il problema della scalabilità
L'endpoint Responses della 0.11.0 non conserva lo stato tra le richieste. Il client deve inviare la conversazione necessaria per il turno successivo. Il README associato al tag spiega che Codex lo fa, mentre previous_response_id viene rifiutato anziché usato per recuperare una risposta memorizzata dal server.
Una gestione delle richieste senza stato non significa che il runtime sia privo di cache. Lo stato della conversazione e una cache di inferenza riutilizzabile risolvono problemi diversi. Il client continua a fornire la cronologia richiesta; una cache compatibile può ridurre il lavoro quando una parte di quell'input corrisponde a un prefisso precedente.
Il nuovo endpoint ha anche un limite esplicito di concorrenza: serve una richiesta alla volta. Il README chiarisce quindi che i sottoagenti di Codex si mettono in coda. Avviare più agenti può allungare la fila anziché moltiplicare la capacità utile del Mac. Il progetto dispone di altre funzioni di elaborazione in batch, ma non vanno attribuite a un percorso che documenta l'esecuzione seriale come proprio limite.
Questo influisce sul modo di impostare la prima prova. Un assistente che svolge un compito circoscritto nel repository è più semplice da valutare di uno sciame che apre diverse conversazioni lunghe. Registra il tempo dell'intero compito, includendo attesa, caricamento ed esecuzione degli strumenti. I token al secondo durante una generazione attiva rappresentano soltanto una parte della durata.
Parti da un piccolo compito nel repository di cui conosci la risposta
Un primo compito illustrativo consiste nel chiedere all'agente di spiegare un piccolo modulo e proporre un test unitario senza modificare file. Puoi verificare che la spiegazione corrisponda al codice e che il test proposto controlli un contratto reale. Ottieni così una base di confronto prima di concedere permessi di scrittura o di esecuzione della shell.
Un secondo compito potrebbe consentire una modifica in un branch provvisorio: rinominare un simbolo interno dal perimetro chiaro, adeguare chi lo richiama ed eseguire un test mirato già esistente. I criteri di successo sono concreti. Ha toccato soltanto i file previsti, preservato il contratto pubblico e riportato il risultato effettivo del test? Una spiegazione lunga e sicura di sé non sostituisce queste verifiche.
Un terzo scenario è il lavoro orientato all'uso offline su una bozza riservata o un estratto di codice privato. L'inferenza locale può mantenere la richiesta al modello sul Mac, a seconda della configurazione del client, ma non rende automaticamente offline l'intero agente. Operazioni sul repository, gestori di pacchetti, strumenti di ricerca, server MCP e altre integrazioni possono ancora collegarsi altrove. Esaminali separatamente prima di fare promesse sulla localizzazione dei dati.
Questi esempi sono proposte di compiti di valutazione. I risultati di compatibilità riportati nella versione sono test di integrazione dello sviluppatore, non esiti della nostra installazione.
Configura l'endpoint senza perdere il provider che già funziona
Usa un Mac Apple Silicon con macOS 14 o successivo, installa la versione contrassegnata dal tag seguendo il percorso documentato dal progetto e consulta le sue indicazioni attuali su Gatekeeper. Non disattivare i controlli di sicurezza dell'intero sistema soltanto per aprire l'applicazione. Scegli un modello tra i percorsi supportati dal progetto e verifica la licenza del modello prima di scaricarlo per l'uso previsto.
Il README del tag 0.11.0 documenta macmlx serve e un'API locale sulla porta 8000. Usa l'identificativo del modello effettivamente presente sul tuo computer. Gli esempi seguenti riproducono la struttura di configurazione documentata dal progetto; non dimostrano che il checkpoint di esempio sia già installato sul tuo Mac.
- Avvia il backend e verifica l'elenco dei modelli. Esegui il comando del server documentato oppure carica il modello nell'applicazione. Controlla l'indirizzo effettivo del server e gli ID esposti da
/v1/models. - Conserva una copia della configurazione attuale del client. Aggiungi intenzionalmente un provider locale, senza sovrascrivere una configurazione funzionante che potresti voler confrontare o ripristinare.
- Collega un solo client. Inizia con Codex oppure Claude Code, non con entrambi insieme. Verifica una breve richiesta testuale prima di provare un compito con strumenti.
- Mantieni limitati i permessi iniziali. Parti dalla lettura e dalla proposta di modifiche. Amplia l'accesso soltanto quando il flusso di lavoro lo richiede.
Per Codex, l'esempio di provider del README è:
model = "Qwen3.6-27B-4bit"
model_provider = "macmlx"

[model_providers.macmlx]
name = "macMLX"
base_url = "http://127.0.0.1:8000/v1"
wire_api = "responses"
Se attivi l'autenticazione bearer del backend, segui le indicazioni del README su env_key e conserva la chiave nella variabile d'ambiente prevista. Un esempio su localhost non è un invito a esporre sulla rete un servizio di inferenza senza autenticazione.
Il collegamento documentato per Claude Code usa un URL di base senza il suffisso /v1 e mappa gli alias dei modelli:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_API_KEY=sk-local
export ANTHROPIC_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_SMALL_FAST_MODEL=Qwen3.6-27B-4bit
claude
Qui sk-local è il segnaposto di esempio del progetto per un server senza autenticazione bearer, non una vera credenziale di servizio. Quando l'autenticazione bearer è attiva, il README indica invece di usare ANTHROPIC_AUTH_TOKEN con la chiave configurata. Le istruzioni sugli alias contano: un alias non mappato può inviare un nome di modello claude-* a un server che dispone solo di checkpoint locali, causando un errore 404.
Il supporto dei modelli richiede una risposta più precisa di «compatibile con MLX»
Le verifiche end-to-end dichiarate nella versione includono Xcode 27 con Qwen3.6-27B e il client Foundation Models di Apple con quel modello e Gemma 4 E4B. Le prove riguardavano il testo. Non vanno ripresentate come dimostrazione che funzioni ogni client di programmazione, variante di modello o richiesta con immagini.
Il registro di supporto descrive separatamente l'input di immagini per i checkpoint Gemma 4 nella forma E4B supportata e i checkpoint densi Qwen3.5/3.6 che includono il proprio modulo visivo. Specifica inoltre che una richiesta con immagini non registra una voce nella cache dei prompt. La presenza di un modello nell'elenco delle architetture rilevate non garantisce il funzionamento del processore, dei pesi o del percorso multimodale di un checkpoint qualsiasi.
Per un compito di programmazione che include uno screenshot, verifica il percorso delle immagini in modo indipendente. Chiedi una descrizione con una risposta visibile già nota, prima di domandare all'agente di riprogettare un componente a partire dall'immagine. Conserva un compito alternativo di solo testo, così da distinguere un problema di caricamento della visione da un problema generale del ciclo degli strumenti.
La stessa disciplina vale per i formati di output e gli strumenti. Un checkpoint deve emettere le strutture degli strumenti attese dal client, non limitarsi a citare un comando in prosa. Verifica una chiamata a uno strumento, il risultato restituito e una risposta successiva utile. Un fallimento al secondo turno può rivelare sull'idoneità dell'integrazione più di una prima risposta riuscita.
La memoria unificata rende il contesto una voce di spesa concreta
CPU e GPU del Mac condividono la memoria fisica. Questo evita alcuni trasferimenti espliciti, ma non elimina il costo di pesi del modello, attivazioni, cache KV e applicazioni in esecuzione accanto a loro. Editor, browser e modello locale possono contendersi la stessa capacità.
Non stimare il fabbisogno soltanto dal numero di parametri. Precisione dei pesi, dimensione effettiva del checkpoint, lunghezza del contesto e comportamento del runtime sono tutti fattori importanti. Parti da un checkpoint supportato che lasci spazio al lavoro abituale, poi misura pressione sulla memoria e reattività durante un compito rappresentativo.
C'è un dettaglio specifico dell'aggiornamento da controllare: il registro delle versioni afferma che una richiesta di completamento chat senza limite esplicito di token può ora arrivare a 32,768 token anziché 2,048. Riguarda il comportamento documentato del completamento chat, non una garanzia universale sull'output di ogni percorso API. Limiti espliciti rendono comunque più controllabili i compiti esplorativi. Una richiesta che genera accidentalmente molto più testo del previsto consuma tempo e può interferire con il lavoro che volevi far svolgere al Mac.
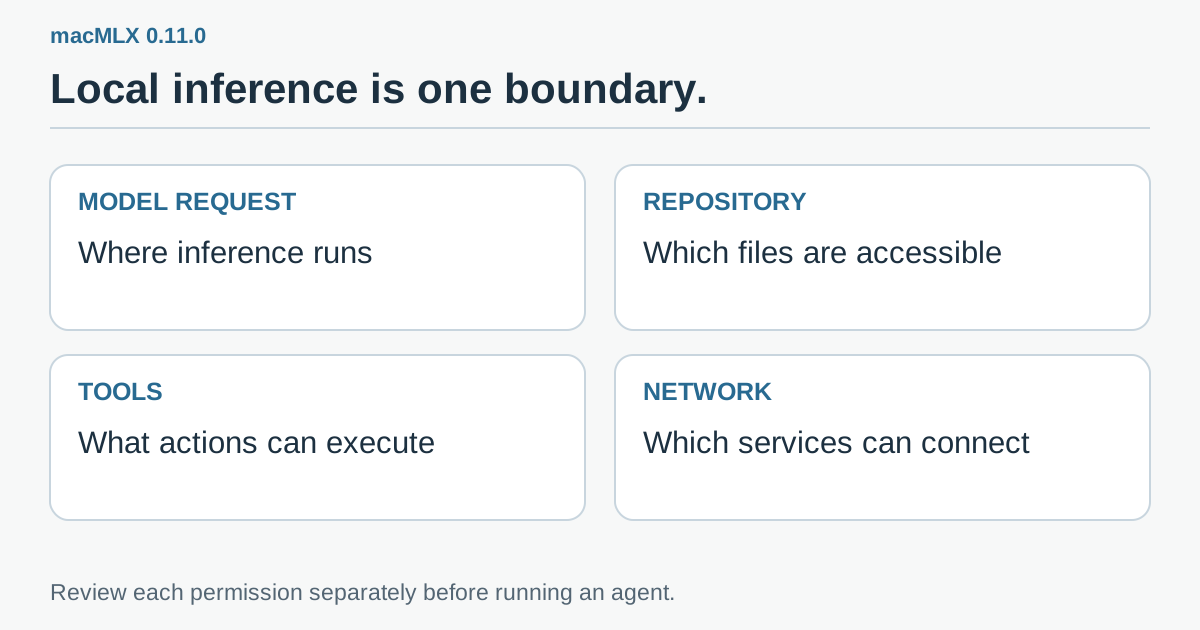 Lista di controllo originale: richieste al modello, accesso al repository, esecuzione degli strumenti e connessioni esterne richiedono decisioni separate. Un endpoint locale del modello non limita automaticamente gli altri tre aspetti.
Confronta i compiti completi prima di confrontare gli abbonamenti
Il vantaggio evidente è ridurre la dipendenza dall'inferenza remota per determinati lavori. Il costo meno evidente è il tempo di chi gestisce il sistema. Caricare un modello, aspettare in una coda seriale, correggere una patch inadeguata e mantenere sano l'ambiente devono tutti rientrare nel confronto.
Usa lo stesso compito circoscritto e gli stessi test di accettazione per confrontare il provider esistente con il backend locale. Registra caricamento a freddo, prima risposta, durata totale, turni con strumenti riusciti, risultati finali dei test e quantità di correzioni umane. Conserva nella nota modello, contesto e versioni del client, per rendere confrontabile un aggiornamento futuro.
Per un compito frequente e modesto, la configurazione locale può essere comoda anche se perde una gara di velocità. Per una modifica difficile che richiede diverse iterazioni fallite, un modello remoto può ancora costare meno in termini di attenzione complessiva. È una decisione sul singolo compito, non l'affermazione che una modalità di distribuzione vinca per ogni lavoro.
L'hardware che possiedi già è un buon punto di partenza per sperimentare. Un test di compatibilità riuscito è un motivo per ampliare un flusso controllato, non per comprare immediatamente un Mac più grande.
Uno strumento di programmazione familiare può diventare un banco di lavoro più flessibile
macMLX 0.11.0 rende più semplice provare l'inferenza locale senza sostituire l'intera interfaccia di programmazione. Il suo contributo più utile è il collegamento esplicito tra client, strutture API e percorsi dei modelli supportati.
Parti da un client, un modello e un compito il cui risultato sia verificabile. Mantieni locale l'endpoint, considera i permessi degli strumenti come una decisione separata e includi attesa e correzioni nelle misurazioni. Il risultato utile è un banco di lavoro capace di scegliere il backend adatto a un compito, anziché un'interfaccia familiare che nasconde un'ipotesi mai verificata.
Fonti e materiali ufficiali
- Versione macMLX 0.11.0, 17 novembre 2026.
- README del tag 0.11.0: installazione, server locale e configurazione dei client.
- Registro ufficiale di compatibilità e delle versioni precedenti.
- Immagine ufficiale di presentazione di macMLX. Il soggetto effettivo è raggiungibile dal link; i diagrammi dell'articolo sono spiegazioni originali.
Le verifiche di compatibilità sono attribuite al progetto. Gli esempi di compiti e la procedura di confronto sono esercizi proposti al lettore.
Consiglio di Telli.sh: Conserva modello, impostazioni dei client e risultati dei compiti in un unico posto, affinché ogni esperimento di IA locale abbia un punto di partenza riproducibile. Crea la tua prima nota con Telli.sh.