Gardez votre agent de code. Faites tourner son modèle sur votre Mac.
macMLX 0.11.0 relie l'inférence locale sur Apple Silicon à Codex et Claude Code. Ce que les API, les alias de modèles, la mémoire et les permissions changent dans l'expérience.
L'interface qui modifie votre dépôt et le modèle qui décide des modifications ne doivent pas nécessairement venir du même fournisseur. Un agent de code peut conserver son fonctionnement habituel tout en envoyant certaines requêtes d'inférence à un modèle exécuté sur votre Mac.
macMLX 0.11.0, publié le 17 novembre 2026, donne à cette organisation des points d'accès API concrets. Codex peut utiliser son endpoint Responses, tandis que Claude Code peut passer par les endpoints Messages et de comptage des tokens. Le moteur fonctionne sur Apple Silicon avec macOS 14 ou version ultérieure.
L'intérêt est de choisir où certaines inférences ont lieu. La décision dépasse toutefois le remplacement d'une URL : les capacités du modèle, la gestion des conversations, l'exécution séquentielle des requêtes et les permissions de l'outil de code déterminent toujours l'utilité de l'ensemble.
Avant de commencer : choisissez un modèle local pris en charge capable d'appeler des outils, prévoyez les poids et le contexte dans la mémoire unifiée, et considérez une réponse de chat réussie comme un premier test, pas comme la preuve qu'un travail de programmation fonctionne.
L'agent reste au premier plan ; une API locale travaille derrière
macMLX est une application et un serveur d'inférence locale écrits en Swift, construits autour de l'écosystème MLX d'Apple. Son chemin d'inférence par défaut s'exécute dans le processus Swift sans nécessiter d'environnement Python. Cela décrit le moteur par défaut, pas toutes les intégrations ou tous les sous-processus facultatifs que le projet pourrait prendre en charge.
Cette version compte parce qu'un agent de code ne se limite pas à recevoir une consigne et à renvoyer du texte. Il peut demander un appel d'outil au modèle, exécuter une opération autorisée, lui transmettre le résultat et demander l'étape suivante. Le serveur doit préserver l'historique et les structures de requêtes nécessaires à cette boucle.
La version 0.11.0 ajoute une interface compatible OpenAI /v1/responses pour Codex, ainsi que des changements pour Claude Code via /v1/messages et /v1/messages/count_tokens. L'historique de compatibilité décrit aussi la réintroduction du raisonnement antérieur dans le gabarit de chat du modèle et la réutilisation de l'historique des tours d'agent sur les modèles hybrides et à fenêtre glissante. Ces détails d'intégration ont une conséquence pratique : répondre à une salutation ne prouve pas que le serveur saura gérer le prochain tour avec un outil.
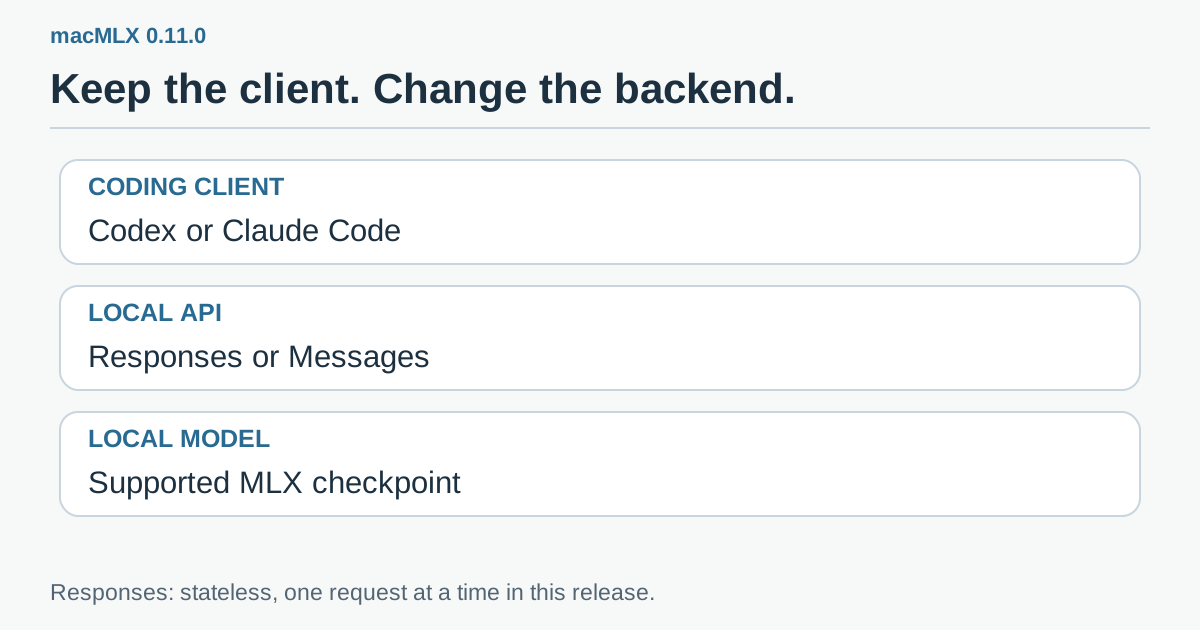 Schéma explicatif original : le client de code gère son fonctionnement, macMLX répond aux requêtes API compatibles et le modèle local choisi fournit l'inférence. L'exécution des outils constitue une frontière de permissions distincte.
Pensez à l'API comme à un adaptateur de prise. Il relie deux composants sans rendre identiques leur puissance, leur capacité ou leur comportement. L'interface familière de Codex ou Claude Code ne transforme pas un petit modèle local en modèle distant que vous utilisiez auparavant.
Un endpoint Responses sans état change la question du passage à l'échelle
L'endpoint Responses de 0.11.0 est sans état entre les requêtes. Le client doit envoyer la conversation nécessaire au tour suivant. Le README de cette version précise que Codex le fait, tandis que previous_response_id est rejeté au lieu de servir à retrouver une réponse conservée par le serveur.
Une gestion sans état ne signifie pas l'absence de cache dans le moteur. L'état conversationnel et un cache d'inférence réutilisable répondent à des problèmes différents. Le client transmet toujours l'historique requis ; un cache compatible peut réduire le travail lorsqu'une partie de cet historique correspond à un préfixe précédent.
Ce nouvel endpoint a aussi une limite explicite de concurrence : il traite une requête à la fois. Le README explique que les sous-agents Codex attendent donc dans une file. Lancer plusieurs agents peut allonger l'attente plutôt que multiplier le débit utile du Mac. Le projet possède d'autres capacités de traitement par lots, mais elles ne doivent pas être attribuées à un chemin documenté comme séquentiel.
Cela influence le premier essai. Un assistant chargé d'une tâche limitée sur un dépôt est plus facile à évaluer qu'un groupe d'agents ouvrant plusieurs longues conversations. Notez la durée de la tâche complète, attente, chargement et outils compris. Le nombre de tokens par seconde pendant une génération active ne représente qu'une partie de cette durée.
Commencez par une petite tâche dont vous pouvez vérifier la réponse
Un premier travail possible consiste à expliquer un petit module et à proposer un test unitaire sans modifier les fichiers. Vous pouvez vérifier si l'explication correspond au code et si le test vise un véritable contrat. Cela crée une référence avant d'accorder l'écriture ou l'accès au shell.
Une deuxième tâche pourrait autoriser une modification dans une branche jetable : renommer un symbole interne bien délimité, adapter ses appelants et lancer un test ciblé existant. Les critères sont concrets. L'agent a-t-il seulement touché les fichiers prévus, préservé le contrat public et rapporté le vrai résultat du test ? Une explication longue et assurée ne remplace pas ces vérifications.
Un troisième scénario concerne un travail orienté hors ligne sur un brouillon sensible ou un extrait de code privé. L'inférence locale peut garder la requête du modèle sur le Mac, selon la configuration du client, mais l'agent complet n'est pas automatiquement hors ligne. Opérations sur le dépôt, gestionnaires de paquets, recherche, serveurs MCP et autres intégrations peuvent toujours se connecter ailleurs. Examinez-les séparément avant de promettre où restent les données.
Ces exemples sont des tâches d'évaluation proposées. Les résultats de compatibilité de la version proviennent des tests d'intégration du développeur, pas de notre installation.
Configurez l'endpoint sans perdre votre fournisseur actuel
Utilisez un Mac Apple Silicon sous macOS 14 ou plus récent, installez la version indiquée par la méthode documentée et suivez les consignes Gatekeeper actuelles du projet. Ne désactivez pas les protections de tout le système pour ouvrir l'application. Sélectionnez un modèle parmi les chemins pris en charge et vérifiez sa propre licence avant de le télécharger pour l'usage prévu.
Le README de 0.11.0 documente macmlx serve et une API locale sur le port 8000. Utilisez l'identifiant du modèle réellement présent sur votre machine. Les exemples clients suivants reproduisent la forme de configuration documentée ; ils ne prouvent pas que le checkpoint cité est déjà installé sur votre Mac.
- Démarrez le serveur et vérifiez ses modèles. Lancez la commande documentée ou chargez le modèle dans l'application. Vérifiez l'adresse réelle et les identifiants exposés par
/v1/models. - Conservez la configuration actuelle du client. Ajoutez volontairement un fournisseur local plutôt que d'écraser un fonctionnement opérationnel que vous pourriez vouloir comparer ou restaurer.
- Connectez un seul client. Commencez avec Codex ou Claude Code, pas les deux simultanément. Validez une courte requête textuelle avant de tester un outil.
- Limitez les premières permissions. Commencez par la lecture et les propositions de modifications. Étendez les accès seulement lorsque le travail l'exige.
Pour Codex, l'exemple de fournisseur du README est :
model = "Qwen3.6-27B-4bit"
model_provider = "macmlx"

[model_providers.macmlx]
name = "macMLX"
base_url = "http://127.0.0.1:8000/v1"
wire_api = "responses"
Si vous activez l'authentification bearer du serveur, suivez les indications env_key du README et gardez la clé dans la variable d'environnement prévue. Un exemple localhost n'est pas une recommandation d'exposer un service d'inférence sans authentification au réseau.
La connexion documentée de Claude Code utilise une URL de base sans suffixe /v1 et associe ses alias de modèles :
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_API_KEY=sk-local
export ANTHROPIC_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_SMALL_FAST_MODEL=Qwen3.6-27B-4bit
claude
Ici, sk-local est la valeur d'exemple du projet pour un serveur sans authentification bearer, pas un véritable identifiant de service. Lorsque cette authentification est active, le README demande d'utiliser ANTHROPIC_AUTH_TOKEN avec la clé configurée. Les alias comptent : un alias non associé peut envoyer un nom de modèle claude-* à un serveur qui ne possède que des checkpoints locaux et provoquer une erreur 404.
La compatibilité doit être plus précise que « compatible MLX »
Les vérifications de bout en bout annoncées pour cette version comprennent Xcode 27 avec Qwen3.6-27B et le client Foundation Models d'Apple avec ce modèle et Gemma 4 E4B. Elles portaient sur le texte. Elles ne prouvent pas que tous les clients de code, variantes de modèles ou requêtes d'images fonctionnent.
L'historique de compatibilité décrit séparément les images pour les checkpoints Gemma 4 de forme E4B prise en charge et les checkpoints denses Qwen3.5/3.6 comprenant leur composant de vision. Il indique aussi qu'une requête d'image ne crée pas d'entrée dans le cache des prompts. La présence d'un modèle dans une liste d'architectures détectées ne garantit pas le prétraitement, les poids ou le chemin multimodal d'un checkpoint arbitraire.
Pour une tâche de code avec capture d'écran, testez la voie image séparément. Demandez une description dont la réponse visible est connue avant de demander une refonte du composant. Gardez une tâche de repli purement textuelle pour distinguer un problème de chargement de vision d'un problème général dans la boucle d'outils.
La même rigueur vaut pour les formats de sortie et les outils. Un checkpoint doit émettre les structures d'outils attendues par le client, pas seulement citer une commande dans un paragraphe. Vérifiez un appel, son résultat et une réponse de suivi utile. Un échec au deuxième tour peut révéler davantage sur l'intégration qu'une première réponse réussie.
La mémoire unifiée fait du contexte un vrai poste de dépense
Le CPU et le GPU du Mac partagent la mémoire physique. Cela évite certains transferts explicites sans supprimer le coût des poids, activations, cache KV et applications voisines. Éditeur, navigateur et modèle local peuvent tous se disputer cette capacité.
N'estimez pas le besoin avec le seul nombre de paramètres. La précision des poids, la taille réelle du checkpoint, la longueur de contexte et le comportement du moteur comptent. Commencez avec un checkpoint pris en charge qui laisse de la place au travail habituel, puis mesurez la pression mémoire et la réactivité pendant une tâche représentative.
Un détail de mise à jour mérite vérification : l'historique indique qu'une requête de complétion de chat sans limite explicite peut désormais aller jusqu'à 32,768 tokens au lieu de 2,048. Cela concerne le comportement documenté des complétions de chat, pas une garantie universelle pour toutes les API. Fixer des limites explicites aide néanmoins à maîtriser les essais. Une requête beaucoup plus longue que prévu consomme du temps et peut gêner le travail confié au Mac.
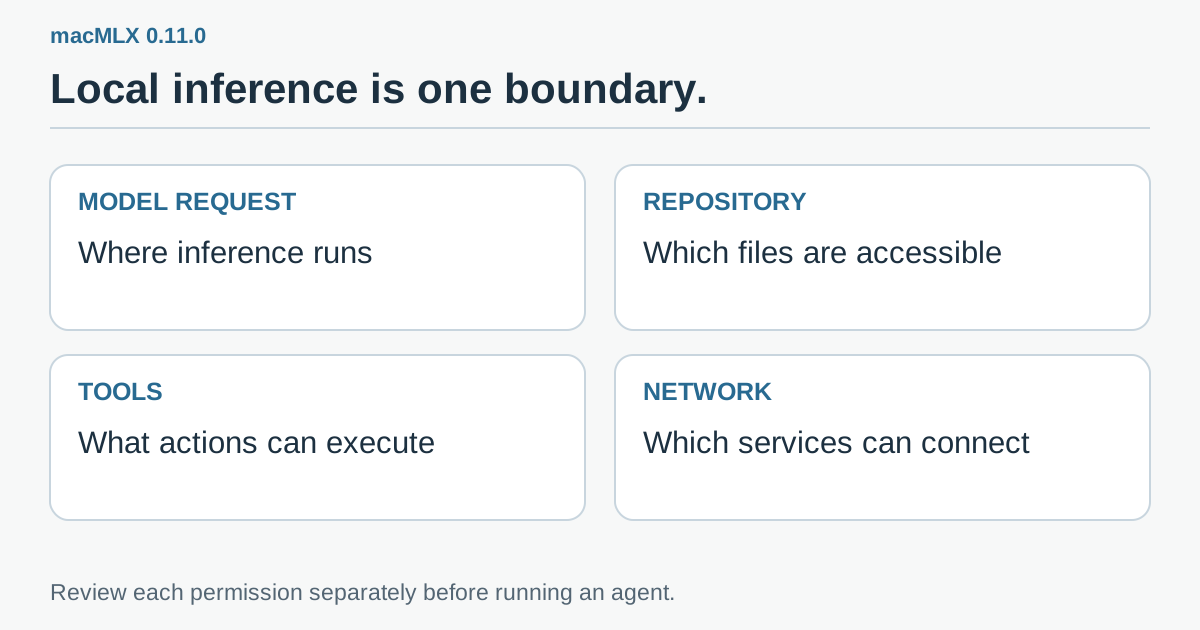 Liste de contrôle originale : requêtes du modèle, accès au dépôt, exécution d'outils et connexions externes appellent des décisions séparées. Un endpoint local ne limite pas automatiquement les trois autres.
Comparez les tâches complètes avant les abonnements
L'intérêt évident est de moins dépendre de l'inférence distante pour certaines tâches. Le coût moins visible est le temps de l'opérateur. Chargement du modèle, file séquentielle, correction d'un patch insuffisant et maintien de l'environnement doivent entrer dans la comparaison.
Utilisez la même tâche délimitée et les mêmes tests d'acceptation pour comparer votre fournisseur actuel au serveur local. Notez le chargement à froid, la première réponse, la durée totale, les tours d'outils réussis, les résultats finaux et la correction humaine nécessaire. Conservez les versions du modèle, du contexte et du client pour comparer une future mise à jour.
Pour une tâche fréquente et modeste, le local peut être pratique même sans gagner en vitesse. Pour une modification difficile nécessitant plusieurs tentatives infructueuses, un modèle distant peut encore coûter moins d'attention au total. C'est une décision par tâche, pas l'affirmation qu'un lieu de déploiement gagne partout.
Le matériel déjà disponible est un bon terrain d'essai. Un test de compatibilité réussi justifie d'élargir un travail contrôlé, pas d'acheter immédiatement un Mac plus puissant.
Un outil familier peut devenir un atelier plus flexible
macMLX 0.11.0 facilite l'essai de l'inférence locale sans remplacer toute l'interface de programmation. Son apport le plus utile est la connexion explicite entre clients, formes d'API et chemins de modèles pris en charge.
Commencez avec un client, un modèle et une tâche vérifiable. Gardez l'endpoint local, traitez les permissions des outils séparément et incluez attente et correction dans les mesures. Le résultat utile est un atelier capable de choisir le bon moteur pour une tâche, plutôt qu'une interface familière masquant une hypothèse non testée.
Sources et médias officiels
- Version macMLX 0.11.0 du 17 novembre 2026.
- README de 0.11.0 : installation, serveur local et configuration des clients.
- Historique officiel de compatibilité et des versions.
- Image officielle de présentation de macMLX. Le sujet réel est accessible par ce lien ; les schémas de cet article sont des explications originales.
Les vérifications de compatibilité sont attribuées au projet. Les exemples de tâches et la méthode de comparaison sont des exercices proposés aux lecteurs.
Recommandation Telli.sh : Gardez modèle, réglages du client et résultats au même endroit pour que chaque essai d'IA locale commence sur une base reproductible. Créez votre première note avec Telli.sh.