Conserva el agente de programación. Lleva su modelo a tu Mac.
macMLX 0.11.0 conecta la inferencia local en Apple Silicon con Codex y Claude Code. Cómo cambian el experimento las API, los alias de modelos, la memoria y los permisos de las herramientas.
La interfaz que edita tu repositorio y el modelo que decide qué editar no tienen por qué venir del mismo lugar. Un agente de programación puede conservar su funcionamiento habitual mientras envía algunas solicitudes de inferencia a un modelo que se ejecuta en tu propio Mac.
macMLX 0.11.0, publicado el 17 de noviembre de 2026, aporta rutas API concretas para esa combinación. Codex puede usar su endpoint Responses, mientras Claude Code utiliza los endpoints Messages y de recuento de tokens. El backend funciona en Apple Silicon con macOS 14 o posterior.
El atractivo está en controlar dónde se realiza determinada inferencia. La decisión exige más que sustituir una URL: la capacidad del modelo, la gestión de conversaciones, el procesamiento secuencial de solicitudes y los permisos de la herramienta siguen determinando si la configuración resulta útil.
Antes de empezar: elige un modelo local compatible que pueda llamar a herramientas, reserva memoria unificada para pesos y contexto, y considera una respuesta de chat correcta como la primera prueba, no como demostración de que funciona un flujo de programación.
El agente sigue delante; una API local trabaja detrás
macMLX es una aplicación y servidor de inferencia local desarrollado en Swift sobre el ecosistema MLX de Apple. Su ruta de inferencia predeterminada se ejecuta dentro del proceso Swift sin necesitar un entorno Python. Esto describe el motor predeterminado, no todas las integraciones o subprocesos opcionales que pueda admitir el proyecto.
La nueva versión importa porque los agentes de programación hacen más que recibir una instrucción y devolver texto. Pueden pedir al modelo una llamada a una herramienta, ejecutar una operación permitida, devolver el resultado y solicitar el siguiente paso. El servidor debe conservar el historial y las estructuras pertinentes durante ese ciclo.
La versión 0.11.0 añade una superficie compatible con OpenAI en /v1/responses para Codex, junto con cambios para Claude Code mediante /v1/messages y /v1/messages/count_tokens. El registro de compatibilidad también describe la reinserción del razonamiento anterior en la plantilla de chat del modelo y la reutilización del historial de turnos en modelos híbridos y de ventana deslizante. Son detalles con una consecuencia práctica: un backend que responde a un saludo no necesariamente resiste el siguiente turno con una herramienta.
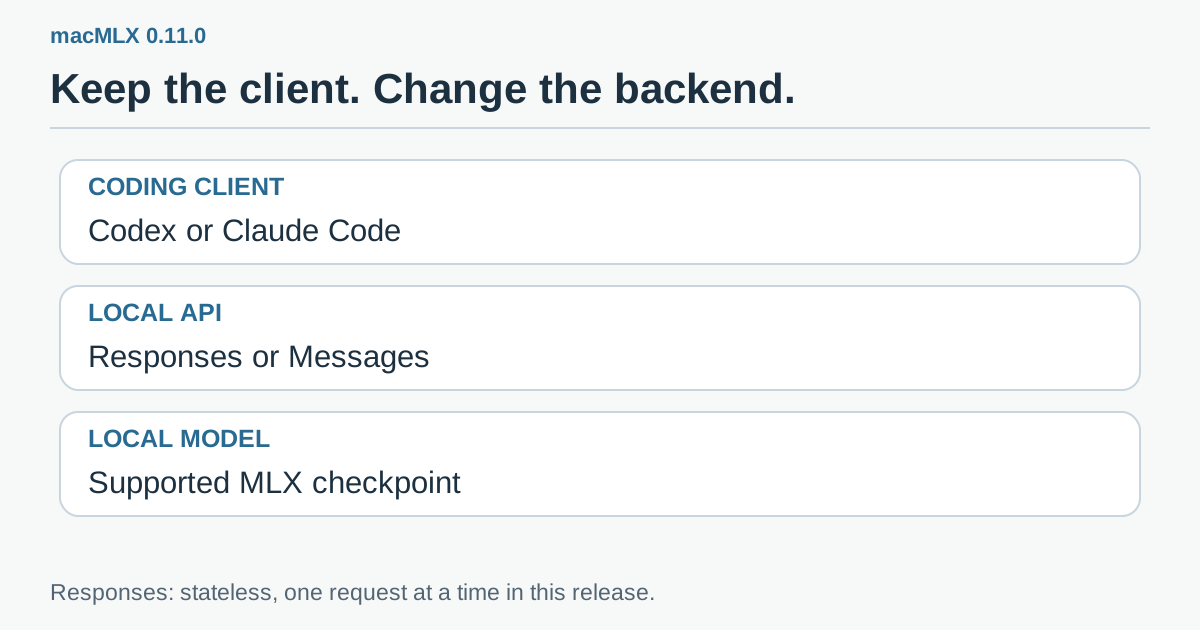 Gráfico explicativo original: el cliente controla su flujo de trabajo, macMLX atiende las solicitudes API compatibles y el modelo local aporta la inferencia. La ejecución de herramientas tiene una frontera de permisos independiente.
Piensa en la API como un adaptador de enchufe. Permite conectar dos componentes, pero no iguala su potencia, capacidad o comportamiento. La interfaz familiar de Codex o Claude Code no convierte un modelo local más pequeño en el modelo remoto que utilizabas antes.
Un endpoint Responses sin estado cambia la cuestión de la escala
El endpoint Responses de 0.11.0 no mantiene estado entre solicitudes. El cliente debe enviar la conversación necesaria para el siguiente turno. El README de esa versión dice que Codex lo hace, mientras que previous_response_id se rechaza en vez de utilizarse para recuperar una respuesta almacenada en el servidor.
Procesar sin estado no significa que el entorno carezca de caché. El estado de la conversación y una caché de inferencia reutilizable resuelven problemas distintos. El cliente sigue aportando el historial necesario; una caché compatible puede ahorrar trabajo cuando parte de esa entrada coincide con un prefijo anterior.
Este endpoint tiene además un límite explícito de concurrencia: atiende una solicitud cada vez. El README explica que, por ello, los subagentes de Codex esperan en una cola. Lanzar varios agentes puede alargar la espera en vez de multiplicar el rendimiento útil del Mac. El proyecto tiene otras funciones de procesamiento por lotes, pero no deben atribuirse a una ruta cuyo límite documentado es la ejecución en serie.
Esto cambia cómo plantear la primera prueba. Es más fácil evaluar un asistente con una tarea acotada sobre un repositorio que un grupo que abre varias conversaciones largas. Registra el tiempo de la tarea completa, incluidas espera, carga y ejecución de herramientas. Los tokens por segundo durante una generación activa solo representan parte de esa duración.
Empieza por una tarea pequeña cuya respuesta puedas comprobar
Un primer trabajo ilustrativo es pedir al agente que explique un módulo pequeño y proponga una prueba unitaria sin cambiar archivos. Puedes comprobar si la explicación coincide con el código y si la prueba aborda un contrato real. Así obtienes una referencia antes de conceder permisos de escritura o de shell.
Una segunda tarea podría permitir cambios en una rama desechable: renombrar un símbolo interno bien delimitado, adaptar sus referencias y ejecutar una prueba específica existente. Los criterios son concretos. ¿Solo modificó los archivos previstos, conservó el contrato público e informó del resultado real? Una explicación larga y segura no sustituye esas comprobaciones.
Un tercer escenario es trabajar con intención de hacerlo sin conexión sobre un borrador sensible o un fragmento de código privado. La inferencia local puede mantener la solicitud del modelo en el Mac, según la configuración del cliente, pero el agente completo no queda automáticamente sin conexión. Las operaciones del repositorio, gestores de paquetes, búsquedas, servidores MCP y otras integraciones pueden seguir comunicándose con el exterior. Revísalas por separado antes de prometer una ubicación para los datos.
Estos ejemplos son tareas de evaluación propuestas. Los resultados de compatibilidad de la versión proceden de pruebas de integración del desarrollador, no de nuestra instalación.
Configura el endpoint sin perder el proveedor que ya funciona
Utiliza un Mac Apple Silicon con macOS 14 o posterior, instala la versión indicada por la vía documentada y sigue las instrucciones actuales del proyecto sobre Gatekeeper. No desactives las protecciones de todo el sistema solo para abrir la aplicación. Selecciona un modelo por las vías compatibles y revisa su propia licencia antes de descargarlo para el uso previsto.
El README de 0.11.0 documenta macmlx serve y una API local en el puerto 8000. Usa el identificador del modelo realmente presente en tu equipo. Los siguientes ejemplos reproducen la forma de configuración documentada; no demuestran que el checkpoint de ejemplo ya esté instalado en tu Mac.
- Inicia el backend y comprueba sus modelos. Ejecuta el comando documentado o carga el modelo en la aplicación. Revisa la dirección real y los identificadores que expone
/v1/models. - Guarda la configuración actual del cliente. Añade deliberadamente un proveedor local en vez de sobrescribir una configuración funcional que quizá quieras comparar o restaurar.
- Conecta un cliente. Empieza con Codex o Claude Code, no ambos a la vez. Confirma una petición breve de texto antes de probar herramientas.
- Limita los primeros permisos. Empieza por leer y proponer cambios. Amplía el acceso solo cuando el trabajo lo necesite.
Para Codex, el ejemplo de proveedor del README es:
model = "Qwen3.6-27B-4bit"
model_provider = "macmlx"

[model_providers.macmlx]
name = "macMLX"
base_url = "http://127.0.0.1:8000/v1"
wire_api = "responses"
Si activas la autenticación bearer del backend, sigue la indicación env_key del README y guarda la clave en la variable de entorno prevista. Un ejemplo con localhost no recomienda exponer un servicio de inferencia sin autenticación a la red.
La conexión documentada de Claude Code utiliza una URL base sin el sufijo /v1 y asigna sus alias de modelos:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_API_KEY=sk-local
export ANTHROPIC_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_SMALL_FAST_MODEL=Qwen3.6-27B-4bit
claude
Aquí sk-local es el marcador de ejemplo del proyecto para un servidor sin autenticación bearer, no una credencial real. Cuando se activa esa autenticación, el README indica usar ANTHROPIC_AUTH_TOKEN con la clave configurada. Los alias importan: uno sin asignación puede enviar un nombre claude-* a un servidor que solo tiene checkpoints locales y provocar un 404.
La compatibilidad exige más precisión que «compatible con MLX»
Las comprobaciones completas declaradas para la versión incluyen Xcode 27 con Qwen3.6-27B y el cliente Foundation Models de Apple con ese modelo y Gemma 4 E4B. Esas pruebas cubrieron texto. No deben presentarse como demostración de que funcionan todos los clientes, variantes de modelos o solicitudes con imágenes.
El registro de compatibilidad describe por separado imágenes para checkpoints Gemma 4 con la estructura E4B admitida y checkpoints densos Qwen3.5/3.6 que incluyen su componente visual. También señala que una solicitud con imagen no registra una entrada en la caché de prompts. Aparecer en una lista de arquitecturas detectadas no garantiza el procesador, los pesos o la vía multimodal de cualquier checkpoint.
Para una tarea con captura de pantalla, prueba la vía visual por separado. Solicita una descripción con una respuesta visible conocida antes de pedir que el agente rediseñe un componente a partir de ella. Conserva una tarea alternativa solo de texto para distinguir un problema al cargar visión de un problema general del ciclo de herramientas.
El mismo cuidado se aplica a formatos y herramientas. Un checkpoint debe emitir las estructuras que espera el cliente, no simplemente mencionar un comando en prosa. Comprueba una llamada, el resultado devuelto y una respuesta posterior útil. Un fallo en el segundo turno puede revelar más sobre la integración que una primera respuesta correcta.
La memoria unificada convierte el contexto en un presupuesto real
La CPU y la GPU del Mac comparten memoria física. Eso evita algunas transferencias explícitas, pero no elimina el coste de pesos, activaciones, caché KV y aplicaciones acompañantes. Un editor, un navegador y un modelo local pueden competir por la misma capacidad.
No calcules la necesidad solo a partir del número de parámetros. Importan la precisión de los pesos, el tamaño real del checkpoint, la longitud del contexto y el comportamiento del entorno. Empieza con un checkpoint compatible que deje espacio para el trabajo habitual y mide la presión de memoria y la respuesta del sistema durante una tarea representativa.
Hay un detalle de actualización que conviene revisar: el registro dice que una solicitud de chat-completion sin límite explícito puede llegar ahora a 32,768 tokens en vez de 2,048. Esto afecta al comportamiento documentado de chat-completion, no garantiza esa salida en todas las rutas API. Aun así, los límites explícitos ayudan a controlar las pruebas. Una solicitud que genera mucho más de lo previsto consume tiempo y puede interferir con el trabajo que querías realizar.
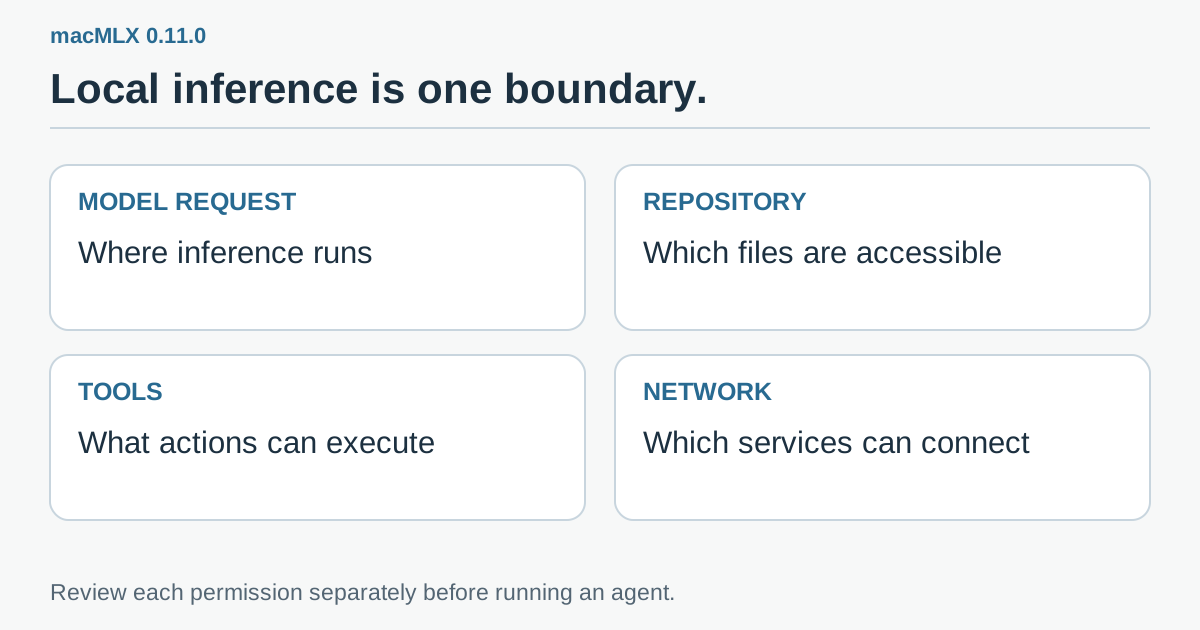 Lista de revisión original: las solicitudes al modelo, acceso al repositorio, ejecución de herramientas y conexiones externas exigen decisiones distintas. Un endpoint local no limita automáticamente las otras tres.
Compara tareas completas antes de comparar suscripciones
El atractivo evidente es reducir la dependencia de la inferencia remota para determinados trabajos. El coste menos visible es el tiempo de quien opera el sistema. Cargar un modelo, esperar una cola en serie, corregir un parche insuficiente y mantener el entorno forman parte de la comparación.
Usa la misma tarea acotada y pruebas de aceptación al comparar el proveedor actual con el backend local. Registra la carga en frío, primera respuesta, duración total, turnos correctos con herramientas, resultados finales y corrección humana necesaria. Guarda las versiones del modelo, contexto y cliente para comparar futuras actualizaciones.
Para una tarea frecuente y modesta, el entorno local puede ser cómodo aunque pierda en velocidad. Para un cambio difícil con varias rondas fallidas, un modelo remoto puede seguir costando menos atención total. Es una decisión por tarea, no la afirmación de que una ubicación gane en todos los trabajos.
El hardware que ya tienes es un buen lugar para experimentar. Una prueba de compatibilidad correcta justifica ampliar un flujo controlado, no comprar inmediatamente un Mac más grande.
Una herramienta familiar puede convertirse en un taller más flexible
macMLX 0.11.0 facilita probar inferencia local sin sustituir toda la interfaz de programación. Su aportación más útil es la conexión explícita entre clientes, formas de API y configuraciones de modelo compatibles.
Empieza por un cliente, un modelo y una tarea cuyo resultado puedas verificar. Mantén el endpoint local, trata los permisos de herramientas como decisión separada e incluye espera y corrección en las mediciones. El resultado útil es un taller capaz de elegir el backend adecuado para cada tarea, en vez de una interfaz familiar que oculte una suposición sin comprobar.
Fuentes y material oficial
- macMLX 0.11.0, 17 de noviembre de 2026.
- README de 0.11.0: instalación, servicio local y configuración de clientes.
- Registro oficial de compatibilidad y versiones.
- Imagen oficial de presentación de macMLX. El producto real está enlazado; los diagramas del artículo son explicaciones originales.
Las comprobaciones de compatibilidad se atribuyen al proyecto. Los ejemplos y el procedimiento comparativo son ejercicios propuestos al lector.
Recomendación de Telli.sh: Guarda juntos el modelo, los ajustes del cliente y los resultados para que cada experimento de IA local tenga un punto de partida reproducible. Crea tu primera nota con Telli.sh.