앤트로픽이 클로드의 글에 워터마크를 넣기 시작했다 — 그리고 1,922건의 판결이 보여주는 한계
Claude의 텍스트 워터마크가 모델 관여 가능성을 식별하면서도 사실의 정확성은 검증하지 못하는 이유를 설명합니다. 탐지의 한계, 잘못된 의혹, 기록된 환각 관련 1,922건의 사례를 통해 출처와 진실의 차이를 살펴봅니다.
2026년 8월 14일, 앤트로픽은 앞으로 출시될 Claude 모델에서 텍스트 워터마크가 어떻게 작동할지 설명했습니다. FAQ는 이 적용을 8월 2일부터 시행된 EU AI법의 투명성 요건과 연결합니다. 그 날짜 전에 출시된 모델은 전환 기간에 걸쳐 업데이트될 예정이며, 발표가 모든 Claude 응답에 이미 워터마크가 있다는 뜻은 아닙니다.
핵심 아이디어는 모델이 고르는 단어 속에 신호를 넣는 것입니다. 적절한 조건에서는 독자가 보는 텍스트 형식을 바꾸지 않고도 어떤 모델이 관여했는지 식별하는 데 도움이 될 수 있습니다.
생성된 텍스트에 조작된 근거가 들어 있다면 이 구분은 중요합니다. 아래에서 다룰 공개 데이터베이스 스냅샷에는 AI 환각 콘텐츠가 관련된 법원 사건 1,922건이 기록되어 있었습니다. 이 사건들은 워터마크 탐지 테스트가 아니며, 특정 탐지기가 그 텍스트를 찾아냈을지도 입증하지 않습니다. 이들이 보여주는 것은 별개의 문제입니다. 출처 신호만으로 인용된 사건, 연구, 사실이 실제로 존재하는지 확인할 수는 없습니다. 그 간극을 이해하면 워터마크 결과를 더 유용하게, 그리고 오용하기는 더 어렵게 해석할 수 있습니다.
한눈에 보기
- 텍스트에 뭔가를 덧붙이는 게 아닙니다. 비밀 키가 눈에 보이는 형식이 아니라 단어 선택의 무작위성에 영향을 줍니다. 앤트로픽은 전 세계 적용을 계획하고 있으며, 이전 모델은 시간이 지나면서 추가할 예정입니다.
- 탐지 성공은 약한 증거고, 탐지 실패는 거의 아무 증거도 아닙니다. 앤트로픽 스스로 이 표식으로는 "클로드가 이걸 썼다"와 "클로드가 이걸 많이 손봤다"를 구분할 수 없고, 짧은 글·코드·사실 나열 문단에서는 약하며, 다시 쓰면 지워진다고 밝혔습니다. 2024년 연구자들은 50달러도 안 되는 비용으로 이 표식을 지우는 것과 사람이 쓴 글에 가짜로 붙이는 것 둘 다 가능함을 보였습니다.
- 출처는 검증이 아닙니다. 탐지 결과는 모델이 관여했을 가능성을 나타낼 수 있지만, 텍스트에 언급된 판례나 인용, 책이 실제로 존재하는지는 검증하지 않습니다.
이미지: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. 진위 확인 표식으로 가득한 한 페이지. 도장 하나하나가 국경을 넘었다는 사실을 증명합니다. 그중 무엇도 이 여행자가 진실을 말했는지에 대해서는 한마디도 하지 않습니다.
앤트로픽이 실제로 바꾼 것, 그리고 바꾸지 않은 것
작동 원리부터 봅시다. 이후의 오해는 거의 다 여기서 시작되니까요.
언어 모델은 글을 쓸 때 단어를 하나씩 내놓는데, 대부분의 자리에서는 정답이 하나가 아닙니다. "회의는 생산적이었다"와 "회의는 유익했다"는 둘 다 괜찮죠. 모델은 받아들일 만한 다음 단어들의 목록을 들고 있다가 무작위 추첨으로 하나를 고릅니다. 같은 프롬프트를 두 번 넣으면 조금씩 다른 답이 나오는 이유가 이겁니다.
텍스트 워터마크는 그 무작위 추첨을, 비밀 키로 굴러가는 유사 무작위 추첨으로 바꿉니다. 모델은 여전히 자기가 똑같이 괜찮다고 판단한 단어들 중에서만 고르기 때문에 품질은 그대로입니다. 하지만 수백 단어가 쌓이면 매번 어느 단어가 뽑혔는지의 패턴이 더는 우연으로 보이지 않게 되고, 키를 가진 쪽은 그 패턴을 측정할 수 있습니다.
숨겨진 문자나 제거할 수 있는 텍스트 메타데이터는 없습니다. 신호는 단어 선택에서 나오며, 앤트로픽은 토큰이 추가되지 않고 속도 영향도 미미하다고 말합니다. 출시 정책은 지역별이 아니라 전 세계 적용을 지향하지만, 모델별 적용 범위는 여전히 순차 배포에 달려 있습니다. 전 세계 적용 정책만으로 특정 응답에 워터마크가 있는지 단정할 수는 없습니다.
새로운 과학은 아닙니다. 스콧 애런슨이 2022년에 이 접근을 제안했고, 커첸바우어 연구진이 2023년 ICML에서 작동하는 방식을 발표했으며, 구글 딥마인드는 2024년 10월 네이처에 SynthID-Text를 실었습니다. 앤트로픽의 구현은 그 변형판입니다. 구글은 2024년부터 제미나이에 이걸 돌리면서 약 2천만 건의 실제 응답에서 품질 차이가 감지되지 않았다고 보고했고, 이후 100억 건 이상의 콘텐츠에 워터마크를 넣었다고 주장합니다.
2026년 10월 12일 업데이트: 앤트로픽의 9월 1일 FAQ 업데이트에 따르면 탐지 API는 자격을 갖춘 조직을 대상으로 비공개 프리뷰 중이며, 더 넓은 제공 범위도 계획되어 있습니다. 따라서 8월 당시의 "API 출시 예정"이라는 설명은 더 이상 최신 상태가 아닙니다. 워터마크는 Claude의 관여 가능성을 추정할 뿐, 텍스트가 사실인지 확인하지 않습니다.
워터마크는 복사·붙여넣기를 견딘다. 다시 쓰기는 못 견딘다.
신호는 어떤 단어가 선택됐는가에 담겨 있습니다. 그러니 단어 선택을 보존하는 행위는 표식도 보존하고, 단어를 갈아치우는 행위는 표식을 없앱니다. 앤트로픽은 상한선을 딱 잘라 말합니다. "모든 단어를 바꾸는 완전한 재작성은" 이것을 제거한다고요. 그런데 사람들이 자주 헷갈리는 예외가 두 가지 있습니다.
짧은 글과 사실 나열 문단은 거의 아무것도 못 담습니다. 워터마크는 숨을 선택지가 필요합니다. 한두 문장으로는 패턴을 이룰 만한 결정이 모이지 않고, 사실 위주의 내용에서는 애초에 선택의 여지가 없을 수도 있습니다. 앤트로픽이 든 예가 좋습니다. "뉴턴의 프린키피아" 다음에 올 단어는 "마테마티카"일 수밖에 없고, 여기엔 어떤 키도 끼어들 자리가 없습니다. 같은 논리로 문법이 대부분의 토큰을 정해버리는 코드도 약하고, 모델이 손대는 단어가 너무 적은 교정 작업도 마찬가지입니다.
번역은 워터마크를 온전히 지닙니다. 이건 직관을 거스릅니다. 클로드에게 문서를 일본어로 번역해 달라고 하면, 그 일본어 텍스트는 클로드가 단어 하나하나를 평소의 선택 자유를 가지고 새로 생성한 것입니다. 그러니 원문이 표식 없는 사람의 글이었더라도 결과물에는 표식이 완전히 찍힙니다. 이것은 딥마인드 연구진이 네이처에서 설명한 내용, 즉 워터마크가 찍힌 텍스트를 다른 언어로 옮기면 탐지 신뢰도가 크게 떨어진다는 것과 정반대로 보이죠. 둘 다 사실입니다. 상황이 다르기 때문입니다. 표식이 찍힌 텍스트를 바깥에서 번역하면 표식이 씻겨나가고, 모델이 직접 번역하면 새 표식이 찍힙니다.
| 텍스트에 하는 일 | 표식이 살아남는가 |
|---|---|
| 어디로든 복사해서 붙여넣기 | 예 — 붙여넣기로 떨어져 나갈 무언가가 애초에 없음 |
| 가벼운 편집: 오타, 제목, 문단 삭제 | 예 — 대부분의 단어 선택이 그대로임 |
| 모델에게 번역을 시키기 | 예 — 번역문은 새로 생성되므로 표식이 온전히 찍힘 |
| 내 말로 크게 바꿔 쓰기 | 아니오 — 신호를 담고 있던 선택 자체를 갈아치움 |
| 모든 단어를 바꾸는 완전한 재작성 | 아니오 — 앤트로픽이 제거된다고 명시 |
| 한두 문장짜리 짧은 발췌 | 거의 없음 — 패턴을 이룰 선택지가 부족함 |
| 코드, 또는 사실 나열 문단 | 약함 — 문법과 사실이 선택의 자유를 남기지 않음 |
| 모델에게 내 초고를 교정시키기 | 거의 없음 — 바뀌는 단어가 너무 적음 |
2026년 8월 14일 앤트로픽 FAQ와 2024년 10월 네이처에 실린 SynthID-Text 논문 저자들이 밝힌 내용을 정리.
탐지 성공은 약한 증거고, 탐지 실패는 거의 아무 증거도 아니다
탐지기가 결과를 내놓았다면, 합리적으로 무엇을 결론 내릴 수 있을까요?
양성이 나왔다면, 이 텍스트의 일부가 해당 업체의 모델을 거쳐 갔다는 것. 그게 전부입니다. 앤트로픽은 이 표식으로 "클로드가 이걸 썼다"와 "클로드가 이걸 많이 손봤다"를 구분할 수 없다고 명시하고, 안에 있는 어떤 주장이 참인지에 대해서는 아무 말도 하지 않으며, 다른 AI가 쓴 글은 알아보지 못합니다. 오직 자기 키만 알기 때문입니다.
음성이 나왔다면 알게 된 것은 거의 없습니다. 깨끗한 결과는 크게 바꿔 쓴 글, 짧은 발췌, 코드 블록, 경쟁사 모델, 그리고 아무 표식도 없이 누군가의 노트북에서 돌아가는 오픈 웨이트 모델에서도 똑같이 나옵니다.
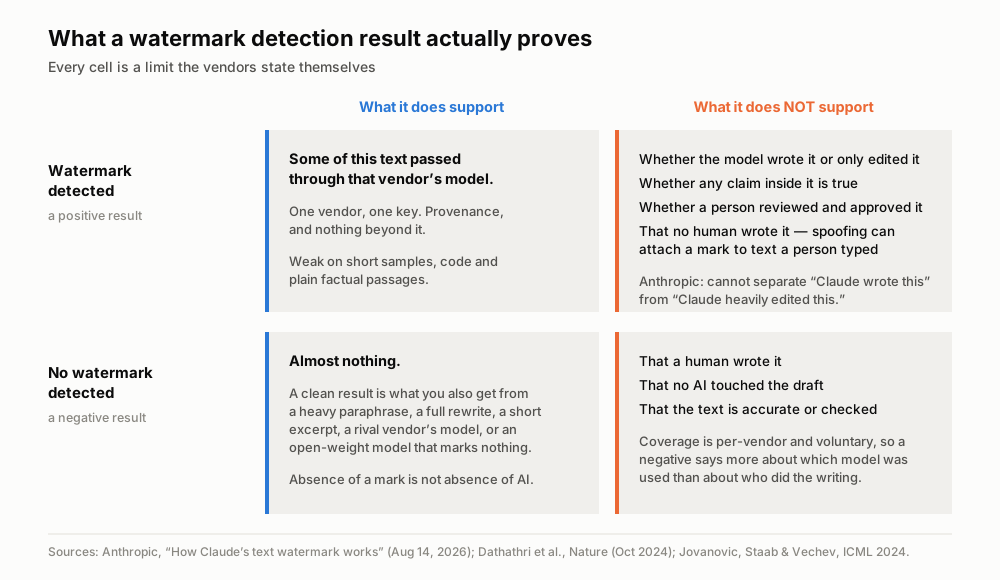
여기 있는 모든 칸은 업체들이 스스로 공개한 한계입니다. 출처: 앤트로픽 워터마크 FAQ(2026년 8월 14일, 9월 1일 업데이트), Dathathri 외, 네이처(2024년 10월), Jovanović·Staab·Vechev, ICML 2024.
아무도 대비하지 않는 공격은 방향이 반대다
지우기는 누구나 떠올리는 위험입니다. 누군가 AI 텍스트를 세탁해 출처를 감추는 것이죠. 그런데 화살표가 반대로 향하는 두 번째 공격이 있고, 정작 걱정해야 할 쪽은 이겁니다.
스푸핑은 사람이 쓴 글에 남의 워터마크를 입히는 것입니다. 뭘 감추는 게 아니라 심는 겁니다. 표적은 AI를 썼다고 몰리게 될 사람이거나, 만든 적도 없는 출력물 때문에 비난받게 될 업체입니다.
2024년 ICML에서 Jovanović, Staab, Vechev는 최신 방식들을 상대로 두 공격 모두를 50달러 미만의 연산 비용으로 80% 이상 성공률로 시연했습니다. 딥마인드 저자들도 자신들의 네이처 논문에서 같은 지점을 인정합니다. 워터마크는 "완전한 해법을 제공하지 않으며", 존재하려면 모델 제공자의 협조가 필요하고, 누구나 그대로 돌릴 수 있는 오픈 웨이트 모델에는 강제할 수 없으며, "탈취·스푸핑·지우기 공격에 취약하다"고요. 마지막 구절이 이 논쟁 전체입니다. 그 기술을 만든 팀이 직접 써놓은 문장이고요.
초기 AI 탐지기는 엉뚱한 학생들을 지목했다
탐지 도구는 이미 존재합니다. 그리고 그건 피해 이력이 문서로 남아 있는 다른 기술입니다. 워터마크는 모델 소유자가 생성 시점에 키를 써서 심는 것입니다. 분류기는 제3자가 사후에 글 자체의 특징으로 추측하는 것이고요. 단어 선택이 얼마나 예측 가능한지, 어휘가 얼마나 다양한지 같은 것들이죠. 앞의 것은 무언가를 알고 있습니다. 뒤의 것은 문체를 패턴 매칭할 뿐입니다. 측정과 프로파일링의 차이입니다.
오픈AI는 2023년 1월 31일 AI 텍스트 분류기를 내놨다가 같은 해 7월 20일 "정확도가 낮다는 이유로" 접었습니다. 자체 수치로 AI 텍스트는 26%만 잡아냈고, 사람이 쓴 글의 9%를 잘못 표시했습니다.
그리고 2023년 7월, Liang 연구진이 패턴스에 이 분야를 끝냈어야 마땅한 결과를 발표합니다. 영어가 모국어가 아닌 사람들이 쓴 토플 에세이에 탐지기 일곱 개를 돌린 결과, 평균 오탐률은 61.3%. 어떤 탐지기는 그중 97.8%를 기계가 쓴 글로 표시했습니다. 그런데 같은 에세이를 더 풍부한 어휘로 다시 쓰게 하자 오탐률이 11.6%로 떨어졌습니다. 탐지기는 애초에 저작 여부를 재고 있지 않았습니다. 유창함을 재고 있었고, 영어가 단순한 사람에게 벌을 주고 있었습니다.
밴더빌트 대학교는 2023년 8월 16일 턴잇인의 AI 탐지기를 비활성화했습니다. 학교가 설명한 계산은 가정에 따른 것이었습니다. 주장된 오탐률 1%를 제출 논문 약 7만 5천 편에 적용하면 약 750편의 논문이 잘못 표시될 수 있다는 위험 추정치였습니다. 실제로 부당한 의혹을 받은 학생 수를 뜻하지는 않습니다. 밴더빌트 대학교 공지.
워터마크 탐지는 글쓰기 스타일로 저자를 추정하는 대신, 정해진 생성 패턴을 검사합니다. 결과는 여전히 확률적이며, 짧거나 많이 편집된 글은 결론을 내리기 어려울 수 있습니다. 모델 관여 여부에 관한 결과를 특정 개인에 대한 비난으로 바꿔서는 안 됩니다. 스푸핑 연구도 탐지만으로 저자를 확정할 수 없는 이유를 보여줍니다.
규제가 도구보다 먼저 도착했다
이 모든 게 2주 안에 몰려 벌어진 이유는 입법이 먼저 움직였기 때문입니다.
EU AI법은 의무를 둘로 나눕니다. 제50조 2항은 제공자를 묶습니다. 생성형 시스템을 만든 쪽은 텍스트를 포함한 출력물을 기계가 읽을 수 있게 표시해야 합니다. 제50조 4항은 여러분을 묶습니다. "공익에 관한 사안에 대해 대중에게 알리는" AI 생성 텍스트를 게재하는 이용자는 그 사실을 공개해야 합니다.
그런데 두 번째 조항에는 대다수 독자에게 이 제도의 실질적 핵심인 면제 조항이 붙어 있습니다. 해당 콘텐츠가 사람의 검토 또는 편집상의 통제를 거쳤고, 그에 대해 편집 책임을 지는 사람이 있는 경우에는 적용되지 않습니다. 두 번 읽어보세요. AI 생성 텍스트에 대한 유럽의 답은 탐지기가 아닙니다. 그것을 검토했고 그에 대해 책임지는, 이름이 있는 사람입니다.
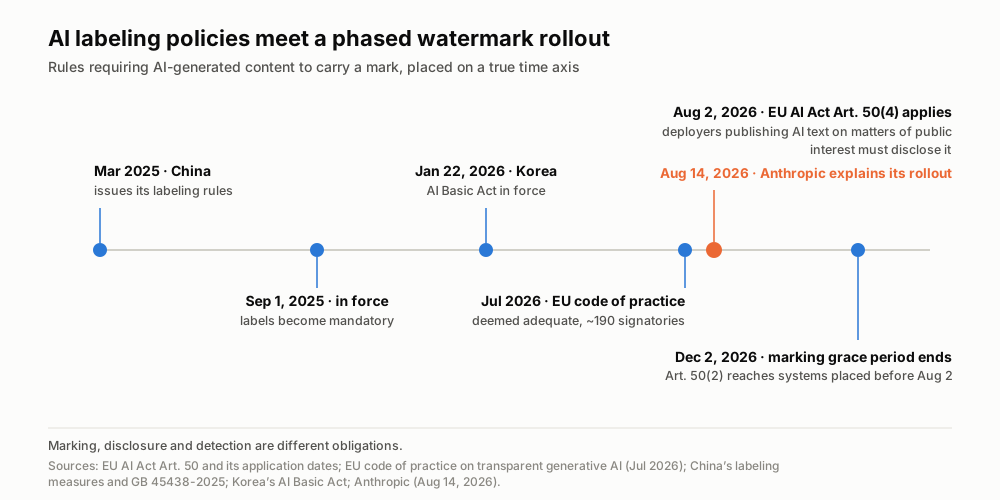
라벨링 의무는 일정표대로 도착했지만, 쓸 만한 탐지 수단은 그렇지 않았습니다. 출처: EU AI법과 그 적용 일정, EU 투명성 실천규약(2026년 7월), 중국의 라벨링 조치와 GB 45438-2025, 한국의 AI 기본법, 앤트로픽 발표.
유럽연합 집행위원회는 투명성 실천규약을 법을 대체하지 않는 자발적 준수 체계로 설명합니다. 2026년 7월 말 기준 약 190개 기관이 서명했습니다. 집행위원회 FAQ에 따르면 8월 2일 전에 시장에 출시된 시스템은 2026년 12월 2일까지 전환 기간을 적용받습니다. 서명 기관의 이행 일정과 법적 의무는 서로 바꿔 쓸 수 있는 개념이 아닙니다. 집행위원회 개요, 집행위원회 FAQ.
다른 지역에는 서로 다른 규칙이 적용됩니다. 중국의 표시 조치는 2025년 9월 1일 발효됐으며, GB 45438-2025 표준에 따라 눈에 보이는 표시와 내장 표시를 요구합니다. 한국의 AI 기본법은 2026년 1월 22일 시행됐습니다. 준수 여부를 판단할 때는 하나의 전 세계 공통 표시 규칙이 있다고 가정하기보다 해당 관할권과 콘텐츠 유형을 확인해야 합니다.
여기 덧붙일 부재가 하나 더 있습니다. 월스트리트 저널은 2024년, 오픈AI가 내부적으로 정확도 약 99.9%라고 설명한 텍스트 워터마킹 기법을 만들어 뒀다고 보도했습니다. 이건 사실이 아니라 보도로 다뤄야 합니다. 그 수치는 독립적으로 검증된 적이 없고, 오픈AI는 텍스트 표시를 출시한 적이 없습니다. 2026년 6월 11일 자사의 EU 준수 관련 글에서도 이미지 출처 표시만 다루면서, 일반적인 한계를 스스로 인정합니다. "메타데이터는 제거될 수 있고, 워터마크는 열화될 수 있다."
워터마크로 환각된 인용의 진위를 확인할 수는 없다
다미앵 샤를로탱은 판사가 AI 환각이 포함된 콘텐츠를 다뤄야 했던 전 세계 법원 판결을 공개 데이터베이스로 관리합니다. 2026년 8월 16일 확인 시점에 1,922건이었습니다. 궤적은 이렇습니다. 2025년 중반 약 200건, 2026년 1월 719건, 4월 1,227건, 6월 9일 1,598건, 그리고 오늘 1,922건. 최근 10주 동안에만 324건이 늘었습니다.
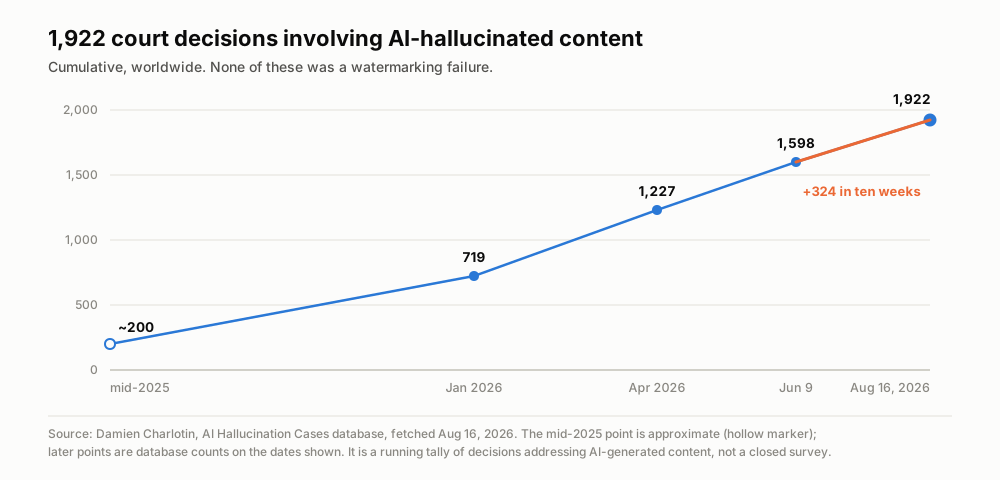
이 사례들은 환각을 기록한 것이지 워터마크 탐지 결과를 시험한 것이 아닙니다. 출처 표시는 주장의 사실 여부를 확인해주지 않습니다. 출처: 다미앵 샤를로탱의 AI 환각 사례 데이터베이스, 2026년 8월 16일 확인.
원형은 2023년 6월 22일 뉴욕 남부지방법원이 선고한 마타 대 아비앙카 사건입니다. 존재하지 않는 판결 여섯 건을 인용한 서면, 그리고 5,000달러의 제재금.
가장 무게 있게 다뤄야 할 사례는 앤트로픽 자신의 일입니다. 2025년 5월 Concord Music v. Anthropic에서 회사 변호인단은 Claude가 환각한 연구를 인용한 전문가 진술서를 제출했습니다. 수작업 검토에서도 이를 놓쳤고, 변호인은 법원에 사과했습니다. 지금 텍스트 워터마크를 제공하는 회사도 자사 모델의 출력을 비판적으로 확인하지 않고 인용해, 자사 소송에서 자사 변호인의 검토를 거쳤는데도 문제를 겪었습니다. 워터마크가 양성으로 나왔더라도 인용된 연구가 실제로 존재하는지 입증하지는 못했을 것입니다.
법정 밖으로도 이어집니다. 딜로이트 오스트레일리아는 2025년 10월, 존재하지 않는 참고문헌과 판결문에서 지어낸 인용구가 들어간 44만 호주달러짜리 정부 보고서에 대해 일부 환불에 합의했습니다. 2025년 5월 18일에는 시카고 선타임스와 필라델피아 인콰이어러가 여름 추천 도서 목록을 신디케이트로 실었는데, 열다섯 권 중 실제로 존재하는 책은 다섯 권뿐이었습니다. Liang 연구진은 arXiv:2404.01268에서 논문 950,965편을 분석해, LLM이 손댄 내용이 컴퓨터과학 초록에서 최대 17.5%에 달하는 반면 수학과 네이처 계열 저널에서는 6.3% 이하라는 것을 확인했습니다.
분량 문제도 자극적인 숫자보다는 정직한 숫자가 필요합니다. 2025년 10월 공개된 그래파이트의 커먼 크롤 분석은 2025년 5월 표본 신규 기사의 약 51.7%가 AI로 작성됐다고 봤습니다. 그리고 이를 보도한 액시오스가 붙인 단서가 중요합니다. 그 비율은 계속 오르지 않고 절반 근처에서 정체됐다는 것이죠. 홍수가 아닙니다. 새로운 표준입니다.
여기서 핵심입니다. 위 목록 중 워터마킹 실패는 하나도 없습니다. 모든 사례에서 출처는 애초에 논란거리가 아니었습니다. 모델이 관여했다는 걸 다들 알았거나, 알려줬으면 곧바로 받아들였을 겁니다. 실패한 건 아무도 그 인용을 열어서 그 판례가, 그 연구가, 그 책이 실제로 존재하는지 확인하지 않았다는 점입니다.
결론: 출처는 검증이 아니다
이것을 소인(postmark)의 착각이라고 부릅시다. 소인은 어느 우체국이 그 편지를 취급했는지를 증명합니다. 편지 내용이 참인지에 대해서는 한 번도 의견을 가진 적이 없죠. 우리는 방금 상당한 공학적 노력을 들여 아주 훌륭한 소인을 만들었고, 공론장의 일부는 이제 그것을 팩트체커로 착각하려 하고 있습니다.
세 가지를 동시에 기억해야 합니다. 양성 탐지는 저자나 진실이 아니라 모델 관여 가능성에 관한 증거입니다. 음성 결과로 사람이 썼다고 입증할 수는 없습니다. 적용 범위는 제공업체와 그 키, 워터마크를 사용하는 모델에 달려 있으므로 보편적이지 않습니다. 앤트로픽의 업데이트된 비공개 프리뷰 API에도 무제한 공개 접근이 아니라 자격 요건이 있습니다.
정말로 검증을 견디는 것은 출력물에 찍힌 표식이 아닙니다. 원천에서 다시 끌어낼 수 있는 기록입니다. 여전히 남아 있는 녹음, 언제든 그 순간으로 되돌아갈 수 있는 타임스탬프 붙은 전사본, 실제로 그 말을 한 사람에게 귀속된 한 줄, 직접 열어볼 수 있는 원본 문서까지 이어지는 근거. 우리는 유창한 출력보다 검토 가능한 노트가 중요한 실시간 번역에 대해, 그리고 누군가 이의를 제기했을 때 기록이 버텨줘야 하는 경찰 조사 전사에 대해 같은 이야기를 해왔습니다. 워터마크 시대는 그 주장을 바꾸는 게 아니라 더 날카롭게 만듭니다. 표시가 보편화되면 "AI가 관여했다"는 말은 아무것도 구분해주지 못하게 되니까요.
워터마크는 텍스트가 어디에서 왔는지에 답합니다. 그것이 참인지에 답하는 물건은 아직 아무도 만들지 못했습니다. 그건 탐지기가 아니기 때문입니다. 되돌아가 볼 수 있는 원천입니다.
Telli.sh는 여기에 있습니다: 우리는 되돌아가 볼 수 있는 원천을 만듭니다. Telli.sh는 회의를 녹음하고, 화자가 구분된 타임스탬프 전사본을 만들며, 요약을 그것이 나온 오디오에 붙들어 둡니다. 그래서 노트의 어떤 줄이든 몇 달 뒤에도 누가 그 말을 한 그 순간으로 되짚어갈 수 있습니다. 이건 AI를 탐지한다는 주장이 아닙니다. 문제의 나머지 절반입니다. 요약이 무언가를 주장할 때, 그 문장을 믿는 대신 녹음과 대조해볼 수 있다는 것.
출처
- Anthropic, "How Claude's text watermark works" (2026년 8월)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (2024년 10월)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (2023년 7월)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, AI Hallucination Cases 데이터베이스
- 유럽연합 집행위원회, AI법 제50조: 투명성 의무
- Wikimedia Commons 이미지 페이지
