Anthropic marca el texto de Claude: qué prueban realmente 1.922 casos judiciales
La marca de agua textual de Claude puede indicar una posible intervención del modelo, pero no verifica la exactitud de los hechos. Qué permite concluir una detección, cuáles son sus límites y qué enseñan 1.922 casos documentados de alucinaciones sobre la diferencia entre procedencia y verdad.
El 14 de agosto de 2026, Anthropic explicó cómo funcionaría la marca de agua textual en futuros modelos Claude. Sus preguntas frecuentes relacionan el despliegue con los requisitos de transparencia del Reglamento de IA de la UE, aplicables desde el 2 de agosto. Los modelos publicados antes de esa fecha se están actualizando durante un periodo de transición; el anuncio no significa que todas las respuestas de Claude ya lleven marca de agua.
La idea útil es una señal dentro de las palabras que elige el modelo. En las condiciones adecuadas, puede ayudar a identificar la intervención de un modelo sin cambiar el aspecto del texto para quien lo lee.
La distinción importa cuando un texto generado contiene pruebas inventadas. Una instantánea de una base de datos pública citada más adelante registró 1.922 casos judiciales relacionados con contenido alucinado por IA. No son pruebas de detección de marcas de agua ni demuestran si un detector concreto habría identificado esos textos. Muestran otro problema: una señal de procedencia no puede confirmar que exista el caso, estudio o dato citado. Entender esa diferencia hace que el resultado de una marca de agua sea mucho más útil y mucho más difícil de usar mal.
En resumen:
- No se añade nada al texto. Una clave secreta cambia la aleatoriedad al elegir palabras, no el formato visible. Anthropic prevé un despliegue global y añadir los modelos antiguos con el tiempo.
- Un positivo es prueba débil y un negativo casi no es prueba. Anthropic dice que la marca no distingue "Claude escribió esto" de "Claude editó mucho esto", que es débil en textos cortos, código y pasajes puramente factuales, y que una reescritura la borra. En 2024 unos investigadores demostraron que con menos de 50 dólares se pueden tanto eliminar estas marcas como falsificarlas sobre texto escrito por una persona.
- La procedencia no es verificación. Un resultado de detección puede indicar una probable intervención del modelo, pero no validar un caso, una cita o un libro mencionado en el texto.
Imagen: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Una página llena de marcas de autenticidad. Cada una prueba que se cruzó una frontera. Ninguna dice una palabra sobre si el viajero decía la verdad.
Qué cambió realmente Anthropic y qué no
Empecemos por el mecanismo, porque casi todos los malentendidos posteriores nacen de equivocarse aquí.
Cuando un modelo de lenguaje escribe, produce una palabra cada vez, y en la mayoría de posiciones no hay una única opción correcta. "La reunión fue productiva" y "La reunión fue útil" valen igual. El modelo mantiene una lista de palabras siguientes aceptables y elige una mediante un sorteo aleatorio. Por eso el mismo prompt te da respuestas ligeramente distintas dos veces.
Una marca de agua textual sustituye ese sorteo por uno pseudoaleatorio gobernado por una clave secreta. El modelo sigue eligiendo solo entre palabras que ya consideraba igual de buenas, así que la calidad queda intacta. Pero a lo largo de unos cientos de palabras, el patrón de qué palabra aceptable ganó cada vez deja de parecer casualidad, y quien tiene la clave puede medirlo.
No hay caracteres ocultos ni metadatos de texto que puedan eliminarse. La señal procede de las palabras elegidas y, según Anthropic, no añade tokens y apenas afecta a la velocidad. Su política de lanzamiento es global, no regional, pero la cobertura depende del despliegue: esa política por sí sola no demuestra que una respuesta concreta lleve marca de agua.
Nada de esto es ciencia nueva. Scott Aaronson propuso el enfoque en 2022, Kirchenbauer y sus colegas publicaron un esquema funcional en ICML en 2023, y Google DeepMind publicó SynthID-Text en Nature en octubre de 2024; la implementación de Anthropic es una versión de aquello. Google lo ejecuta en Gemini desde 2024, informa de unos 20 millones de respuestas en producción sin diferencia de calidad detectable, y afirma haber marcado desde entonces más de 10.000 millones de contenidos.
Actualización, 12 de octubre de 2026: la actualización del 1 de septiembre de las preguntas frecuentes de Anthropic describe una API de detección en vista previa privada para organizaciones que cumplan los requisitos, con una ampliación de acceso prevista. Esto sustituye el estado de API futura de la instantánea original de agosto. La marca estima la intervención de Claude; no comprueba si el texto es cierto.
La marca sobrevive a copiar y pegar. No sobrevive a una reescritura.
La señal vive en qué palabras se eligieron, así que todo lo que conserva esas elecciones conserva la marca, y todo lo que las sustituye la destruye. Anthropic enuncia el techo sin rodeos: "una reescritura completa en la que se sustituya cada palabra" la eliminará. Dos casos rompen ese patrón de una forma que pilla a mucha gente.
El texto corto y el factual apenas llevan nada. La marca de agua necesita elecciones donde esconderse. Una o dos frases no ofrecen decisiones suficientes para formar un patrón, y el contenido muy factual puede no ofrecer elección real alguna: el ejemplo de Anthropic es que después de "los Principia de Newton" la siguiente palabra va a ser "Mathematica", y ninguna clave tiene voto. La misma lógica debilita el código, donde la sintaxis dicta la mayoría de los tokens, y la corrección de estilo, donde el modelo cambia demasiadas pocas palabras para dejar señal.
La traducción lleva una marca de agua completa. Esto va contra la intuición. Si pides a Claude que traduzca un documento al japonés, ese texto japonés lo genera Claude de nuevo, palabra a palabra, con la libertad de elección habitual, así que sale plenamente marcado aunque las ideas vinieran de un original humano sin marca. Es lo contrario de lo que describen los investigadores de DeepMind en Nature, donde traducir texto marcado a otro idioma reduce mucho la confianza de detección. Ambas cosas son ciertas porque son escenarios distintos: traducir en otro sitio un texto marcado lava la marca, mientras que hacer que traduzca el propio modelo estampa una nueva.
| Qué le haces al texto | ¿Sobrevive la marca? |
|---|---|
| Copiar y pegar en cualquier sitio | Sí — no hay nada incrustado que pegar pueda arrancar |
| Edición ligera: erratas, títulos, recortes | Sí — la mayoría de las elecciones de palabra siguen intactas |
| Pedirle al modelo que lo traduzca | Sí — la traducción se genera de nuevo, así que va plenamente marcada |
| Parafrasear a fondo con tus palabras | No — sustituyes las elecciones que llevaban la señal |
| Reescritura completa, cada palabra sustituida | No — Anthropic afirma que esto la elimina |
| Un extracto corto, una o dos frases | Débil o nula — muy pocas elecciones para formar un patrón |
| Código o pasajes puramente factuales | Débil — sintaxis y hechos no dejan libertad al modelo |
| Que el modelo corrija tu borrador | Débil o nula — cambian demasiadas pocas palabras |
Comportamiento según lo declarado por Anthropic en sus preguntas frecuentes del 14 de agosto de 2026 y por los autores de SynthID-Text en Nature, octubre de 2024.
Un positivo es prueba débil. Un negativo casi no es prueba.
Si un detector devuelve un resultado, ¿qué puedes concluir razonablemente?
Si es positivo: que parte de ese texto pasó por el modelo de ese proveedor. Eso es todo. Anthropic afirma con claridad que la marca no distingue "Claude escribió esto" de "Claude editó mucho esto", no dice nada sobre si alguna afirmación del texto es cierta, y no reconoce texto de otra IA, porque solo conoce su propia clave.
Si es negativo, no ha averiguado casi nada. Un resultado limpio es exactamente lo que también obtienes de una paráfrasis, un extracto corto, un bloque de código, el modelo de un competidor o un modelo de pesos abiertos corriendo en el portátil de alguien sin marcado alguno.
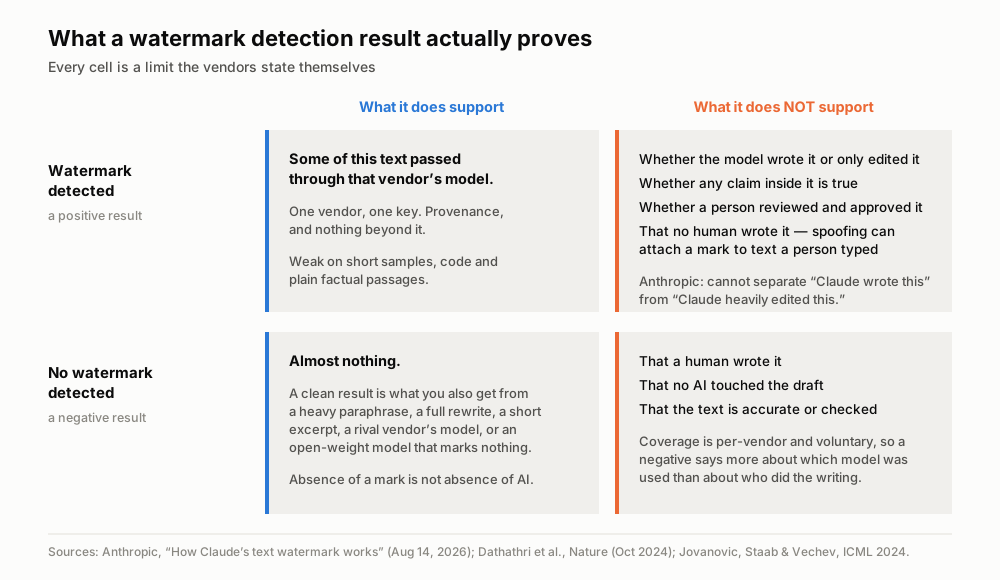
Cada celda es un límite publicado por los propios proveedores. Fuentes: preguntas frecuentes de Anthropic sobre la marca de agua (14 de agosto de 2026, actualizadas el 1 de septiembre); Dathathri et al., Nature (octubre de 2024); Jovanović, Staab y Vechev, ICML 2024.
El ataque que nadie presupuesta va en sentido contrario
El borrado es el riesgo que todos imaginan: alguien blanquea texto de IA para ocultar su origen. De acuerdo. Pero hay un segundo ataque con la flecha en sentido inverso, y es el que debería preocuparte.
La suplantación consiste en hacer que un texto escrito por una persona lleve la marca de agua de otro. Nadie oculta nada: se está plantando algo. El objetivo es alguien a quien luego se acusará de usar IA, o un proveedor al que se culpará de salidas que jamás produjo.
En ICML 2024, Jovanović, Staab y Vechev demostraron ambos ataques contra esquemas de última generación con más del 80 % de éxito y menos de 50 dólares de cómputo. Los autores de DeepMind conceden lo mismo en su propio artículo de Nature: las marcas de agua "no ofrecen una solución completa", requieren la cooperación del proveedor del modelo para siquiera existir, no son exigibles en modelos de pesos abiertos que cualquiera puede ejecutar tal cual, y son "vulnerables a ataques de robo, suplantación y borrado". Esa última cláusula es todo el argumento, y la escribió el equipo que construyó la tecnología.
Los primeros detectores de IA acusaron a los estudiantes equivocados
Las herramientas de detección ya existen, y son otra tecnología con un historial de daños documentado. Una marca de agua la coloca el dueño del modelo en el momento de generar, con una clave. Un clasificador adivina a posteriori a partir de rasgos del propio texto: cuán predecibles son las elecciones de palabras, cuán variado es el vocabulario. El primero sabe algo. El segundo hace reconocimiento de patrones de estilo. Esa es la diferencia entre medir y perfilar.
OpenAI lanzó un AI Text Classifier el 31 de enero de 2023 y lo retiró el 20 de julio del mismo año "debido a su baja tasa de acierto". Sus propias cifras: detectó el 26 % del texto de IA y marcó erróneamente el 9 % del texto humano.
Después, Liang y sus colegas publicaron en Patterns en julio de 2023 el hallazgo que debería haber cerrado la categoría. Con siete detectores aplicados a redacciones TOEFL de hablantes no nativos de inglés, la tasa media de falsos positivos fue del 61,3 %; un detector marcó el 97,8 % de ellas. Al pedir que reformularan esas mismas redacciones con vocabulario más rico, la tasa cayó al 11,6 %. Los detectores nunca midieron la autoría: medían fluidez, y penalizaban a quien tuviera un inglés más sencillo.
La Universidad de Vanderbilt desactivó el detector de IA de Turnitin el 16 de agosto de 2023. Su explicación planteó un cálculo hipotético: aplicar una tasa de falsos positivos del 1 % declarada a unos 75.000 trabajos presentados podría señalar por error alrededor de 750 trabajos. Era una estimación del riesgo, no el recuento de estudiantes realmente acusados. Anuncio de Vanderbilt.
La detección de marcas de agua comprueba un patrón definido de generación, en vez de inferir la autoría a partir del estilo de escritura. El resultado sigue siendo probabilístico, y los pasajes breves o muy editados pueden no ser concluyentes. Un resultado sobre la intervención de un modelo no debería convertirse en una acusación contra una persona concreta; las investigaciones sobre suplantación también muestran por qué la detección por sí sola no puede establecer la autoría.
La regulación llegó antes que las herramientas
Todo esto se acumula en una quincena porque los legisladores se movieron primero.
El Reglamento de IA de la UE parte el deber en dos. El artículo 50, apartado 2 obliga a los proveedores: quien construye un sistema generativo debe marcar sus salidas de forma legible por máquina, texto incluido. El artículo 50, apartado 4 te obliga a ti: quien despliega y publica texto generado por IA que "informa al público sobre asuntos de interés público" debe revelarlo.
Y ese segundo apartado lleva una exención que es, para la mayoría de lectores, el corazón práctico de todo el régimen. No se aplica cuando el contenido ha sido objeto de revisión humana o control editorial y una persona asume la responsabilidad editorial. Léelo dos veces. La respuesta europea al texto generado por IA no es un detector. Es una persona con nombre que lo revisó y responde por ello.
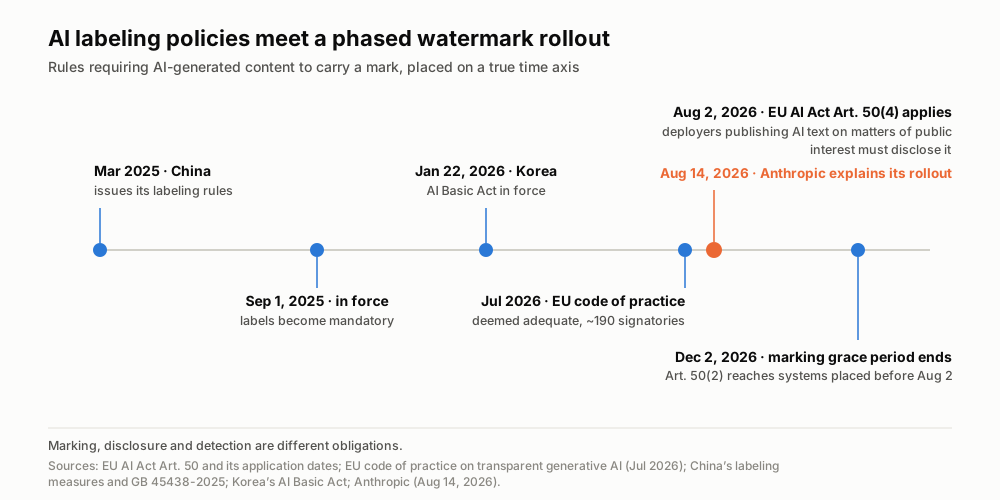
Las obligaciones de etiquetado llegaron según calendario; una detección utilizable, no. Fuentes: el Reglamento de IA de la UE y sus fechas de aplicación, el código de buenas prácticas europeo sobre transparencia (julio de 2026), las medidas chinas de etiquetado y la norma GB 45438-2025, la Ley Marco de IA de Corea y el anuncio de Anthropic.
La Comisión describe su código de transparencia como un marco voluntario de cumplimiento, no como sustituto de la ley; a finales de julio de 2026 lo habían firmado unas 190 organizaciones. Sus preguntas frecuentes conceden a los sistemas comercializados antes del 2 de agosto un periodo de transición hasta el 2 de diciembre de 2026. La distinción importa: el calendario de aplicación de un signatario y una obligación legal no son intercambiables. Resumen de la Comisión, preguntas frecuentes de la Comisión.
Otras jurisdicciones tienen normas distintas. Las medidas de China sobre el etiquetado entraron en vigor el 1 de septiembre de 2025, con etiquetas visibles e integradas conforme a la norma GB 45438-2025. La Ley Básica de IA de Corea entró en vigor el 22 de enero de 2026. Para evaluar el cumplimiento, hay que considerar la jurisdicción aplicable y el tipo de contenido, no una supuesta norma global única.
Aquí encaja otra ausencia. El Wall Street Journal informó en 2024 de que OpenAI había construido un método de marca de agua textual descrito internamente como de en torno al 99,9 % de precisión. Trátalo como una información periodística, no como un hecho: la cifra nunca se ha verificado de forma independiente y OpenAI nunca ha lanzado marcado de texto. Su propia entrada del 11 de junio de 2026 sobre cumplimiento en la UE documenta solo la procedencia de imágenes, y concede el límite general con sus propias palabras: "los metadatos pueden eliminarse, las marcas de agua pueden degradarse".
Una marca de agua no puede validar una cita alucinada
Damien Charlotin mantiene una base de datos pública de resoluciones judiciales de todo el mundo en las que un juez tuvo que abordar contenido generado por IA con alucinaciones. Consultada el 16 de agosto de 2026, marcaba 1.922 resoluciones. La trayectoria: unas 200 a mediados de 2025, 719 en enero de 2026, 1.227 en abril, 1.598 el 9 de junio y 1.922 hoy; 324 añadidas solo en las últimas diez semanas.
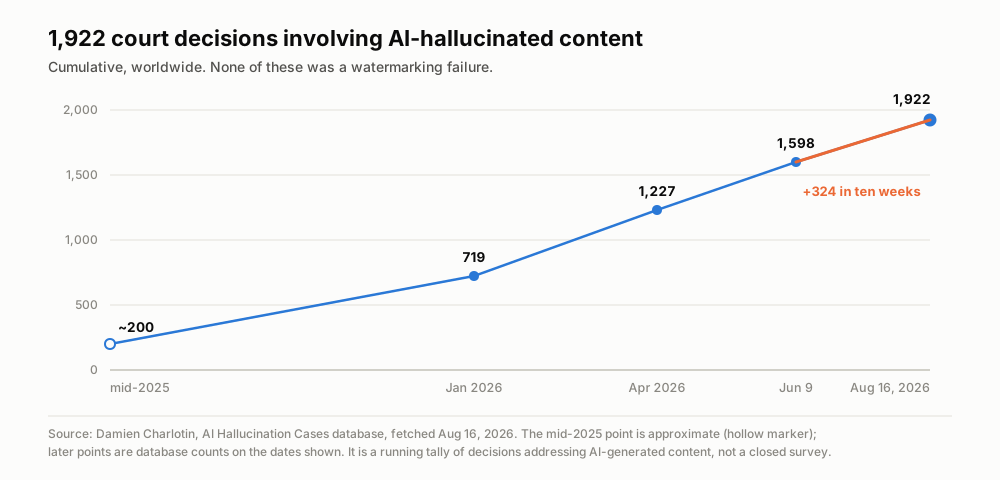
Estos casos documentan alucinaciones, no resultados comprobados de detección de marcas de agua. Una marca de procedencia no puede validar sus afirmaciones fácticas. Fuente: base de datos de casos de alucinación de IA de Damien Charlotin, consultada el 16 de agosto de 2026.
El arquetipo es Mata v. Avianca, resuelto en el Distrito Sur de Nueva York el 22 de junio de 2023: un escrito que citaba seis resoluciones judiciales inexistentes y una sanción de 5.000 dólares.
Pero el ejemplo que más debería pesar es de Anthropic. En mayo de 2025, en Concord Music v. Anthropic, los propios abogados de la empresa presentaron una declaración pericial que citaba un estudio alucinado por Claude. Una comprobación manual no lo detectó; el letrado pidió disculpas al tribunal. La empresa que ahora lanza una marca de agua textual se quemó ella misma citando sin espíritu crítico la salida de su propio modelo, en su propio litigio, con sus propios abogados revisando. Una marca de agua en esa declaración no habría permitido determinar si el estudio citado existía.
Va más allá de los tribunales. Deloitte Australia aceptó en octubre de 2025 reembolsar parcialmente un informe gubernamental de 440.000 dólares australianos con referencias inexistentes y una cita inventada de una sentencia. El 18 de mayo de 2025, el Chicago Sun-Times y el Philadelphia Inquirer publicaron una lista de lecturas de verano distribuida por sindicación en la que solo cinco de los quince libros existían. Liang y sus colegas, analizando 950.965 artículos en arXiv:2404.01268, encontraron contenido modificado por LLM hasta en un 17,5 % de los resúmenes de informática, frente a un 6,3 % o menos en matemáticas y en el portafolio de Nature.
La cuestión del volumen también merece una cifra honesta y no una alarmante. Un análisis de Common Crawl de Graphite publicado en octubre de 2025 halló que en torno al 51,7 % de los artículos nuevos muestreados estaban escritos por IA en mayo de 2025, y Axios, al informarlo, añadió la salvedad que importa: esa proporción se estancó cerca de la paridad en lugar de seguir subiendo. No es una inundación. Es una nueva normalidad.
Aquí está el punto. Nada de esa lista es un fallo de la marca de agua. En todos los casos la procedencia nunca estuvo en duda: todo el mundo sabía que había un modelo de por medio, o lo habría aceptado al instante. Lo que falló es que nadie abrió la referencia y comprobó si aquel caso, aquel estudio o aquel libro existía.
La conclusión: la procedencia no es verificación
Llamémoslo la falacia del matasellos. Un matasellos prueba qué oficina tramitó la carta. Nunca ha tenido opinión sobre si la carta es cierta. Acabamos de dedicar un esfuerzo de ingeniería considerable a construir un matasellos muy bueno, y una parte de la conversación pública está a punto de confundirlo con un verificador de datos.
Ten presentes tres cosas a la vez. Una detección positiva aporta indicios sobre una posible intervención del modelo, no demuestra la autoría ni la verdad. Un resultado negativo no demuestra que el texto lo escribiera una persona. La cobertura depende del proveedor, de su clave y de los modelos que usen su marca; no es universal. La API de Anthropic en vista previa privada también exige cumplir ciertos requisitos, así que no está abierta al público sin restricciones.
Lo que de verdad resiste el escrutinio no es una marca en la salida. Es un registro que puedas volver a derivar desde su origen: una grabación que sigue existiendo, una transcripción con marcas de tiempo a la que puedas saltar en el momento exacto, una frase atribuida a quien realmente la dijo, una afirmación rastreable hasta un documento primario que puedas abrir. Ya lo defendimos hablando de la traducción en directo, donde la nota revisable importa más que la salida fluida, y de la transcripción de interrogatorios policiales, donde el registro tiene que aguantar cuando alguien lo discute. La era de la marca de agua no cambia ese argumento, lo afila: cuando el marcado sea universal, "hubo IA de por medio" dejará de distinguir nada.
Las marcas de agua responden de dónde vino el texto. Nadie ha construido lo que responde si es cierto, porque eso no es un detector. Es una fuente a la que puedes volver.
Dónde encaja Telli.sh: nosotros construimos esa fuente a la que volver. Telli.sh graba la reunión, produce una transcripción con marcas de tiempo y hablantes identificados, y mantiene el resumen anclado al audio del que salió, de modo que cualquier línea de tus notas se puede rastrear meses después hasta el segundo en que alguien la dijo. No es una promesa sobre detectar IA. Es la otra mitad del problema: cuando un resumen afirma algo, puedes contrastarlo con la grabación en lugar de fiarte de la frase.
Empezar una nota de IA en directo
Fuentes
- Anthropic, "How Claude's text watermark works" (agosto de 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (octubre de 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (julio de 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, base de datos de casos de alucinación de IA
- Comisión Europea, artículo 50 de la Ley de IA: obligaciones de transparencia
- Página de la imagen en Wikimedia Commons
