Anthropic versieht Claudes Texte mit einem Wasserzeichen — und 1.922 Gerichtsfälle zeigen, was das nicht löst
Am 11. August 2026 begann Anthropic, Claudes Ausgaben so zu markieren, dass sie sich später zurückverfolgen lassen. Die Markierung übersteht Kopieren und sogar Übersetzung, verschwindet aber beim Umschreiben. Eine verständliche Einführung: wie Text-Wasserzeichen funktionieren, was ein Treffer beweist und was nicht, warum die Geschichte der Falschbeschuldigungen zählt und warum alle 1.922 dokumentierten Halluzinationsfälle die Prüfung bestanden hätten.
Am 11. August 2026 begann Anthropic, den Text mit einem Wasserzeichen zu versehen, den Claude schreibt. Drei Tage später erschien eine verständlich formulierte FAQ dazu. Der Auslöser ist kein Geheimnis: Artikel 50 der KI-Verordnung der EU, der Anbieter verpflichtet, maschinell erzeugte Ausgaben maschinenlesbar zu kennzeichnen, gilt seit dem 2. August.
Damit ist eine echte Fähigkeit angekommen. Ein erheblicher Teil des KI-geschriebenen Textes, der jetzt im Umlauf ist, trägt ein Signal, das sich unter den richtigen Bedingungen bis zu dem Modell zurückverfolgen lässt, das ihn erzeugt hat.
Und jetzt der Teil, bei dem man kurz innehalten sollte. Am selben Tag, an dem diese Markierung ausgeliefert wurde, stand eine öffentliche Datenbank mit Gerichtsentscheidungen zu KI-halluzinierten Inhalten bei 1.922 Fällen. Kein einziger davon war ein Versagen des Wasserzeichens. Jeder einzelne war ein Versagen der Überprüfung — jemand hat Modellausgaben eingereicht, veröffentlicht oder in Rechnung gestellt, ohne nachzusehen, ob das Behauptete überhaupt existiert. Ein Wasserzeichen hätte sie alle erkannt und keinen einzigen verhindert. Um genau diese Lücke geht es hier: wie die Markierung in einfachen Worten funktioniert, was ein Prüfergebnis tatsächlich beweist und was es nicht beweisen kann, egal wie gut die Technik noch wird.
Kurzfassung:
- Dem Text wird nichts hinzugefügt. Das Modell verschiebt lediglich mit einem geheimen Schlüssel, welches von mehreren gleich guten nächsten Wörtern es wählt. Keine versteckten Zeichen, keine Metadaten, kein Tempo- oder Kostenaufschlag — und es gilt für alle, überall.
- Ein Treffer ist ein schwaches Indiz, ein Nicht-Treffer fast gar keins. Anthropic schreibt selbst, die Markierung könne "Claude hat das geschrieben" nicht von "Claude hat das stark überarbeitet" unterscheiden, sei schwach bei kurzen Texten, Code und reinen Faktenpassagen und werde durch Umschreiben gelöscht. 2024 zeigten Forschende, dass unter 50 Dollar genügen, um solche Markierungen sowohl zu entfernen als auch auf menschlich geschriebenen Text zu fälschen.
- Herkunft ist keine Überprüfung. Die Markierung sagt Ihnen, welches Modell den Text bearbeitet hat. Sie sagt nie, ob das darin genannte Urteil, Zitat oder Buch existiert.
Bild: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Eine Seite voller Echtheitsmarken. Jede beweist, dass eine Grenze überquert wurde. Keine sagt ein Wort darüber, ob der Reisende die Wahrheit gesagt hat.
Was Anthropic tatsächlich geändert hat — und was nicht
Beginnen wir mit dem Mechanismus, denn fast jedes Missverständnis danach entsteht daraus, dass man ihn falsch versteht.
Wenn ein Sprachmodell schreibt, produziert es ein Wort nach dem anderen, und an den meisten Stellen gibt es keine einzig richtige Wahl. "Das Meeting war produktiv" und "Das Meeting war nützlich" sind beide in Ordnung. Das Modell hält eine Liste akzeptabler nächster Wörter bereit und wählt per Zufallsziehung eines aus. Deshalb bekommen Sie auf denselben Prompt zweimal leicht unterschiedliche Antworten.
Ein Text-Wasserzeichen ersetzt diese Zufallsziehung durch eine pseudo-zufällige, die von einem geheimen Schlüssel gesteuert wird. Das Modell wählt weiterhin nur unter Wörtern, die es ohnehin als gleich gut eingestuft hat, die Qualität bleibt also unberührt. Über einige hundert Wörter hinweg sieht das Muster, welches akzeptable Wort jeweils gewann, aber nicht mehr nach Zufall aus, und wer den Schlüssel hat, kann es messen.
Anthropics eigene Formulierung räumt die beiden häufigsten Fehlannahmen gleich ab: "dem Text wird nichts hinzugefügt, es gibt keine versteckten Zeichen." Kein unsichtbares Unicode, keine Nullbreiten-Leerzeichen, kein Metadatenblock, den man durch Einfügen in einen Texteditor abstreifen könnte. Auch keine Änderung bei Kosten oder Tempo. Und es läuft weltweit: Anthropic gibt an, noch keinen belastbaren Weg zu haben, dieses Verhalten regional einzugrenzen — wer in São Paulo sitzt, wird behandelt wie jemand in Stockholm.
Neu ist daran wissenschaftlich nichts. Scott Aaronson schlug den Ansatz 2022 vor, Kirchenbauer und Kolleginnen veröffentlichten 2023 auf der ICML ein funktionierendes Verfahren, und Google DeepMind publizierte SynthID-Text im Oktober 2024 in Nature — Anthropics Umsetzung ist eine Variante davon. Google betreibt es seit 2024 in Gemini und berichtet von rund 20 Millionen Live-Antworten ohne feststellbaren Qualitätsunterschied; inzwischen beansprucht das Unternehmen, mehr als 10 Milliarden Inhalte markiert zu haben.
Damit kommt zur Sprache, was nicht ausgeliefert wurde. Anthropic sagt, eine Erkennungs-API komme "bald". Sie existiert nicht. Preise, Falsch-Positiv-Raten und die Frage, welche Modelle abgedeckt sind, sind sämtlich noch nicht veröffentlicht, und Googles im Mai 2025 angekündigtes öffentliches SynthID-Portal läuft weiterhin über eine Warteliste. Die Markierung steckt in Milliarden Dokumenten; die Möglichkeit, eines davon zu prüfen, ist für praktisch alle Leserinnen und Leser noch ein Versprechen.
Die Markierung übersteht Kopieren. Umschreiben übersteht sie nicht.
Das Signal steckt darin, welche Wörter gewählt wurden. Alles, was die Wortwahl bewahrt, bewahrt also auch die Markierung, und alles, was sie ersetzt, zerstört sie. Anthropic benennt die Obergrenze unmissverständlich: "eine vollständige Neufassung, bei der jedes Wort ersetzt wird, wird" sie entfernen. Zwei Fälle durchbrechen dieses Muster auf eine Weise, die Leute regelmäßig überrascht.
Kurze und faktenlastige Texte tragen fast nichts. Das Wasserzeichen braucht Wahlmöglichkeiten, in denen es sich verstecken kann. Ein, zwei Sätze bieten nicht genug Entscheidungen für ein Muster, und stark faktische Inhalte bieten unter Umständen gar keine echte Wahl — Anthropics Beispiel: Nach "Newtons Principia" kommt "Mathematica", und kein Schlüssel der Welt hat da ein Mitspracherecht. Dieselbe Logik schwächt Code, wo die Syntax die meisten Token vorgibt, und das Korrekturlesen, bei dem das Modell zu wenige Wörter ändert, um ein Signal zu hinterlassen.
Übersetzungen tragen ein vollständiges Wasserzeichen. Das läuft der Intuition zuwider. Lassen Sie Claude ein Dokument ins Japanische übersetzen, ist der japanische Text neu von Claude erzeugt, Wort für Wort, mit der üblichen Wahlfreiheit — er kommt also vollständig markiert heraus, obwohl die Gedanken aus einem unmarkierten menschlichen Original stammen. Das ist das Gegenteil dessen, was die DeepMind-Forschenden in Nature beschreiben, wo das Übersetzen markierten Textes in eine andere Sprache die Erkennungssicherheit stark senkt. Beides stimmt, es sind verschiedene Szenarien: Markierten Text anderswo zu übersetzen wäscht die Markierung aus, das Modell selbst übersetzen zu lassen drückt eine frische auf.
| Was Sie mit dem Text machen | Bleibt die Markierung? |
|---|---|
| Überallhin kopieren und einfügen | Ja — es ist nichts eingebettet, was Einfügen abstreifen könnte |
| Leichte Bearbeitung: Tippfehler, Überschriften, Kürzungen | Ja — die meisten Wortentscheidungen bleiben unangetastet |
| Das Modell übersetzen lassen | Ja — die Übersetzung wird neu erzeugt und ist voll markiert |
| Starkes Umformulieren in eigenen Worten | Nein — Sie ersetzen genau die Entscheidungen, die das Signal trugen |
| Vollständige Neufassung, jedes Wort ersetzt | Nein — Anthropic gibt an, dass dies sie entfernt |
| Ein kurzer Auszug von ein, zwei Sätzen | Schwach bis gar nicht — zu wenige Entscheidungen für ein Muster |
| Code oder reine Faktenpassagen | Schwach — Syntax und Fakten lassen dem Modell keine Freiheit |
| Das Modell den eigenen Entwurf korrigieren lassen | Schwach bis gar nicht — zu wenige geänderte Wörter |
Verhalten wie von Anthropic in der FAQ vom 14. August 2026 und von den SynthID-Text-Autoren in Nature, Oktober 2024, angegeben.
Ein Treffer ist ein schwaches Indiz. Ein Nicht-Treffer fast gar keins.
Jemand lässt einen Detektor über ein Dokument laufen und bekommt ein Ergebnis. Was hat diese Person erfahren?
Ist es positiv: dass ein Teil dieses Textes durch das Modell dieses Anbieters gelaufen ist. Mehr nicht. Anthropic hält ausdrücklich fest, dass die Markierung "Claude hat das geschrieben" nicht von "Claude hat das stark überarbeitet" unterscheiden kann, sie sagt nichts darüber, ob irgendeine Behauptung darin zutrifft, und sie erkennt keinen Text einer anderen KI, weil sie immer nur ihren eigenen Schlüssel kennt.
Ist es negativ, hat die Person so gut wie nichts erfahren. Ein sauberes Ergebnis bekommen Sie genauso bei einer starken Umformulierung, einem kurzen Auszug, einem Codeblock, dem Modell eines Wettbewerbers oder einem Open-Weight-Modell, das auf irgendjemandes Laptop läuft und überhaupt nichts markiert.
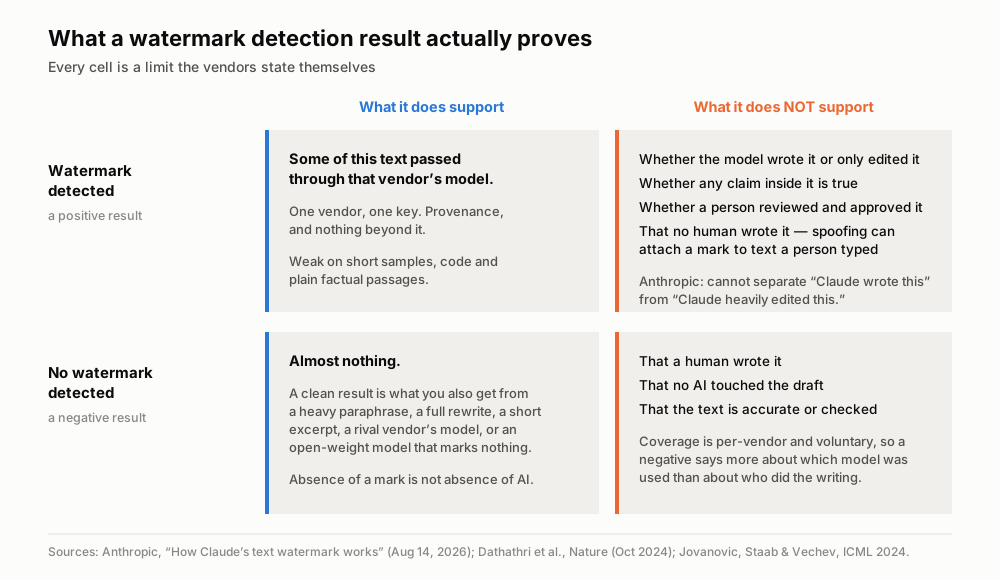
Jedes Feld hier ist eine Grenze, die die Anbieter selbst veröffentlicht haben. Quellen: Anthropics Wasserzeichen-FAQ (14. August 2026); Dathathri et al., Nature (Oktober 2024); Jovanović, Staab und Vechev, ICML 2024.
Der Angriff, für den niemand budgetiert, läuft in die Gegenrichtung
Das Entfernen ist das Risiko, an das alle denken: Jemand wäscht KI-Text, um seine Herkunft zu verbergen. Geschenkt. Es gibt aber einen zweiten Angriff mit umgekehrtem Vorzeichen, und der sollte Ihnen Sorgen machen.
Spoofing heißt, Text, den ein Mensch geschrieben hat, mit dem Wasserzeichen eines anderen zu versehen. Niemand versteckt hier etwas, es wird etwas untergeschoben. Das Ziel ist eine Person, der anschließend KI-Nutzung vorgeworfen wird, oder ein Anbieter, dem Ausgaben angelastet werden, die er nie produziert hat.
Auf der ICML 2024 führten Jovanović, Staab und Vechev beide Angriffe gegen Verfahren auf dem Stand der Technik vor, mit über 80 Prozent Erfolgsquote und weniger als 50 Dollar Rechenkosten. Die DeepMind-Autoren räumen dasselbe in ihrem eigenen Nature-Papier ein: Wasserzeichen "bieten keine vollständige Lösung", sie brauchen die Mitwirkung des Modellanbieters, um überhaupt zu existieren, sie sind bei Open-Weight-Modellen, die jeder unverändert betreiben kann, nicht durchsetzbar, und sie sind "anfällig für Diebstahl-, Spoofing- und Scrubbing-Angriffe". Dieser letzte Halbsatz ist das ganze Argument, geschrieben von dem Team, das die Technik gebaut hat.
Das Experiment "KI erkennen" gab es schon. Es hat die Falschen durchfallen lassen.
Erkennungswerkzeuge gibt es längst, und sie sind eine andere Technik mit einer dokumentierten Schadensgeschichte. Ein Wasserzeichen wird beim Erzeugen vom Modellbetreiber mit einem Schlüssel gesetzt. Ein Klassifikator rät im Nachhinein anhand von Merkmalen des Textes selbst: wie vorhersagbar die Wortwahl ist, wie vielfältig das Vokabular. Das Erste weiß etwas. Das Zweite gleicht Stilmuster ab. Das ist der Unterschied zwischen Messen und Profiling.
OpenAI startete am 31. Januar 2023 einen AI Text Classifier und stellte ihn am 20. Juli desselben Jahres "wegen seiner geringen Treffergenauigkeit" ein. Die eigenen Zahlen: 26 Prozent des KI-Textes erkannt, 9 Prozent des menschlichen Textes fälschlich markiert.
Dann veröffentlichten Liang und Kolleginnen im Juli 2023 in Patterns den Befund, der die Kategorie hätte beenden müssen. Über sieben Detektoren hinweg, angewendet auf TOEFL-Aufsätze von Nicht-Muttersprachlern, lag die durchschnittliche Falsch-Positiv-Rate bei 61,3 Prozent; ein Detektor markierte 97,8 Prozent davon als maschinengeschrieben. Ließ man dieselben Aufsätze mit reicherem Vokabular formulieren, fiel der Wert auf 11,6 Prozent. Die Detektoren maßen nie die Urheberschaft. Sie maßen Sprachgewandtheit und bestraften alle, deren Englisch schlichter war.
Die Institutionen rechneten nach. Am 16. August 2023 — heute vor genau drei Jahren — schaltete die Vanderbilt University Turnitins KI-Detektor ab, mit der Begründung, eine behauptete Falsch-Positiv-Rate von einem Prozent bedeute bei 75.000 Arbeiten im Jahr rund 750 zu Unrecht beschuldigte Studierende pro Jahr.
Wasserzeichen sind hier deutlich besser, sie raten nicht. Aber sehen Sie, was sich übertragen hat. Der Fehlerfall eines Erkennungssystems ist nie ein sauberes "unklar", sondern eine überzeugte Aussage über eine bestimmte Person. Wasserzeichen verbessern die Genauigkeit von Treffern. Angesichts von Spoofing beseitigen sie die Falschbeschuldigung nicht, sondern industrialisieren die Fähigkeit, eine herzustellen.
Die Regulierung kam vor den Werkzeugen
Dass sich all das in einer Woche ballt, liegt daran, dass der Gesetzgeber zuerst gehandelt hat.
Die KI-Verordnung teilt die Pflicht in zwei Hälften. Artikel 50 Absatz 2 bindet die Anbieter: Wer ein generatives System baut, muss dessen Ausgaben maschinenlesbar kennzeichnen, Text eingeschlossen. Artikel 50 Absatz 4 bindet Sie: Wer KI-erzeugten Text veröffentlicht, der "die Öffentlichkeit über Angelegenheiten von öffentlichem Interesse informiert", muss dies offenlegen.
Diese zweite Pflicht trägt eine Ausnahme, die für die meisten Leserinnen und Leser der praktische Kern der ganzen Regelung ist. Sie gilt nicht, wenn der Inhalt einer menschlichen Überprüfung oder redaktionellen Kontrolle unterzogen wurde und eine Person die redaktionelle Verantwortung dafür trägt. Lesen Sie das zweimal. Europas Antwort auf KI-erzeugten Text ist kein Detektor. Sie ist ein namentlich benannter Mensch, der die Sache geprüft hat und dafür geradesteht.
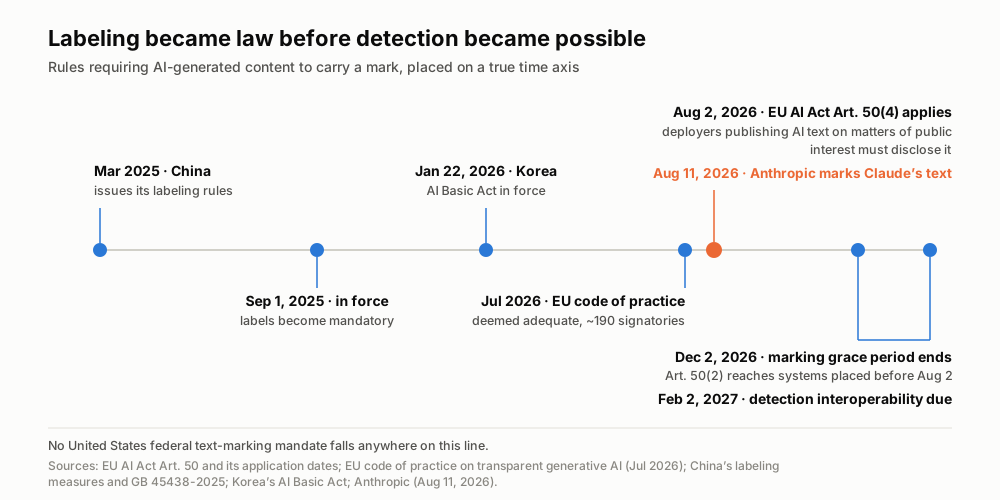
Die Kennzeichnungspflichten kamen nach Zeitplan, brauchbare Erkennung nicht. Quellen: die KI-Verordnung der EU und ihre Anwendungstermine, der EU-Verhaltenskodex zur Transparenz (Juli 2026), Chinas Kennzeichnungsvorschriften und GB 45438-2025, Koreas KI-Rahmengesetz sowie Anthropics Ankündigung.
Der Rest des Kalenders ist kurz. Der EU-Verhaltenskodex zur Transparenz wurde am 8. und 9. Juli 2026 als angemessen bewertet und zog rund 190 Unterzeichner an, darunter Anthropic, Google, Meta, Microsoft, Mistral und OpenAI. Am 2. Dezember 2026 endet die Übergangsfrist und die Kennzeichnungspflicht erstreckt sich auf Systeme, die vor dem 2. August in Verkehr gebracht wurden; am 2. Februar 2027 ist die Interoperabilität der Erkennung fällig. Chinas Kennzeichnungsvorschriften gelten seit dem 1. September 2025 und verlangen nach dem Standard GB 45438-2025 sowohl sichtbare als auch eingebettete Labels; Artikel 10 verbietet es, ein Label zu entfernen oder zu fälschen. Koreas KI-Rahmengesetz trat am 22. Januar 2026 in Kraft, mit Kennzeichnungspflichten und Bußgeldern bis 30 Millionen Won. Die Vereinigten Staaten haben überhaupt keine bundesweite Pflicht zur Textkennzeichnung — das gehört ausdrücklich gesagt, denn eine Regel, die ein großer Teil der Modelle am Markt ignoriert, ist keine globale Regel.
Eine weitere Leerstelle gehört hierher. Das Wall Street Journal berichtete 2024, OpenAI habe ein Verfahren zur Textmarkierung entwickelt, das intern als etwa 99,9 Prozent genau beschrieben wurde. Behandeln Sie das als Bericht, nicht als Tatsache: Die Zahl wurde nie unabhängig überprüft, und OpenAI hat nie eine Textmarkierung ausgeliefert. Der eigene Beitrag vom 11. Juni 2026 zur EU-Konformität dokumentiert nur Bildherkunft und räumt die allgemeine Grenze mit eigenen Worten ein — "Metadaten können entfernt werden, Wasserzeichen können sich abnutzen."
Jeder einzelne dieser Fälle hätte die Wasserzeichenprüfung bestanden
Damien Charlotin pflegt eine öffentliche Datenbank mit Gerichtsentscheidungen weltweit, in denen sich ein Gericht mit KI-erzeugten Inhalten samt Halluzinationen befassen musste. Am 16. August 2026 abgerufen, stand sie bei 1.922 Entscheidungen. Die Kurve: rund 200 Mitte 2025, 719 im Januar 2026, 1.227 im April, 1.598 am 9. Juni und heute 1.922 — allein in den letzten zehn Wochen kamen 324 dazu.
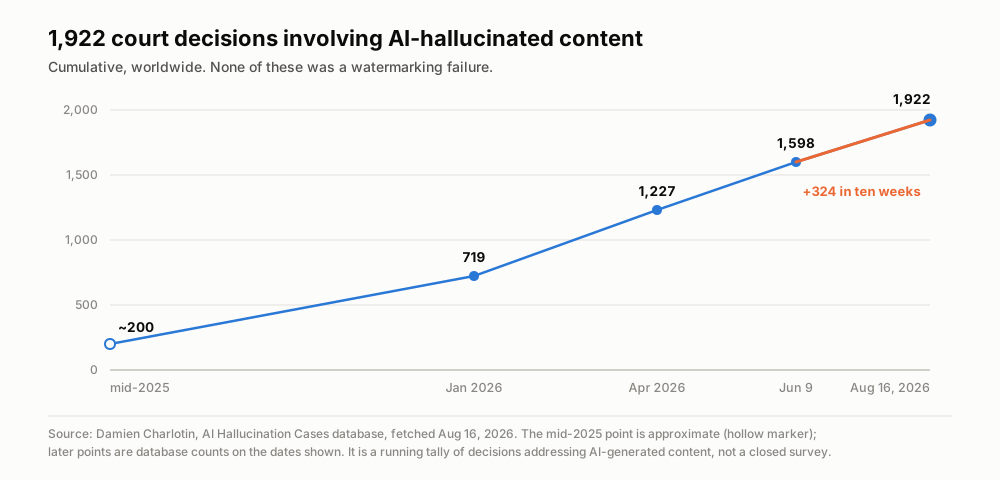
Jeder Punkt auf dieser Kurve hätte ein gültiges Wasserzeichen getragen. Quelle: Damien Charlotins Datenbank zu KI-Halluzinationsfällen, abgerufen am 16. August 2026.
Der Archetyp ist Mata v. Avianca, entschieden am 22. Juni 2023 im Southern District of New York: ein Schriftsatz, der sechs nicht existierende Gerichtsentscheidungen zitierte, und eine Sanktion von 5.000 Dollar.
Das Beispiel mit dem größten Gewicht gehört allerdings Anthropic. Im Mai 2025 reichten die eigenen Anwälte des Unternehmens im Verfahren Concord Music v. Anthropic eine Sachverständigenerklärung ein, die eine von Claude halluzinierte Studie zitierte. Die manuelle Prüfung übersah es, der Rechtsbeistand entschuldigte sich beim Gericht. Das Unternehmen, das jetzt ein Text-Wasserzeichen ausliefert, hat sich selbst am unkritischen Zitieren verbrannt — an der Ausgabe des eigenen Modells, im eigenen Verfahren, mit den eigenen Anwälten als Prüfinstanz. Ein Wasserzeichen auf dieser Erklärung hätte ein sauberes, überzeugtes Positiv geliefert und nichts geändert.
Das reicht über die Gerichte hinaus. Deloitte Australien stimmte im Oktober 2025 einer teilweisen Rückerstattung für einen Regierungsbericht über 440.000 australische Dollar zu, der nicht existierende Quellenangaben und ein erfundenes Zitat aus einem Urteil enthielt. Am 18. Mai 2025 druckten die Chicago Sun-Times und der Philadelphia Inquirer eine im Syndikat vertriebene Sommer-Leseliste, auf der von fünfzehn Büchern nur fünf existierten. Liang und Kolleginnen fanden bei der Analyse von 950.965 Arbeiten in arXiv:2404.01268 LLM-bearbeitete Inhalte in bis zu 17,5 Prozent der Abstracts aus der Informatik, gegenüber höchstens 6,3 Prozent in der Mathematik und im Nature-Portfolio.
Auch die Mengenfrage verdient eine ehrliche statt einer alarmierenden Zahl. Eine im Oktober 2025 veröffentlichte Graphite-Analyse von Common Crawl fand, dass im Mai 2025 rund 51,7 Prozent der untersuchten neuen Artikel KI-geschrieben waren — und Axios fügte in der Berichterstattung die entscheidende Einschränkung hinzu: Der Anteil verharrte nahe der Hälfte, statt weiter zu steigen. Das ist keine Flut. Das ist eine neue Normalität.
Und hier der Punkt. Nichts auf dieser Liste ist ein Versagen des Wasserzeichens. In jedem Fall stand die Herkunft nie in Frage — alle wussten, dass ein Modell beteiligt war, oder hätten es sofort geglaubt. Versagt hat, dass niemand die Quellenangabe geöffnet und nachgesehen hat, ob dieser Fall, diese Studie, dieses Buch existiert.
Fazit: Herkunft ist keine Überprüfung
Nennen wir es den Poststempel-Irrtum. Ein Poststempel beweist, welches Amt den Brief bearbeitet hat. Zum Wahrheitsgehalt des Briefes hat er sich noch nie geäußert. Wir haben gerade beträchtlichen Ingenieursaufwand in einen sehr guten Poststempel gesteckt, und ein Teil der öffentlichen Debatte ist im Begriff, ihn für einen Faktenprüfer zu halten.
Halten Sie drei Dinge gleichzeitig fest. Ein positiver Befund ist ein schwaches Indiz: Er belegt einen Weg, keine Urheberschaft und schon gar keine Tatsache. Ein negativer Befund ist so gut wie kein Indiz. Und die Abdeckung ist konstruktionsbedingt strukturell unvollständig — sie hängt davon ab, dass jeder Anbieter freiwillig mitmacht und seinen eigenen Schlüssel hält, während Open-Weight-Modelle, die jeder herunterladen und unverändert betreiben kann, an gar nichts teilnehmen. Und vorerst liegt die Möglichkeit zur Prüfung nicht einmal in Ihren Händen; sie steckt hinter einer Warteliste und einem "bald".
Was der Prüfung tatsächlich standhält, ist keine Markierung auf der Ausgabe. Es ist ein Nachweis, den Sie aus seiner Quelle neu herleiten können: eine Aufnahme, die es noch gibt, ein Transkript mit Zeitstempeln, in das Sie an die fragliche Stelle zurückspringen können, eine Aussage, die der Person zugeordnet ist, die sie getroffen hat, eine Behauptung, die sich bis zu einem Primärdokument zurückverfolgen lässt, das Sie öffnen können. Wir haben das schon zur Live-Übersetzung vertreten, wo die überprüfbare Notiz mehr zählt als die flüssige Ausgabe, und zur Transkription polizeilicher Vernehmungen, wo der Nachweis halten muss, wenn ihn jemand bestreitet. Die Wasserzeichen-Ära ändert dieses Argument nicht, sie schärft es: Sobald Markierung universell ist, unterscheidet "KI war beteiligt" gar nichts mehr.
Wasserzeichen beantworten, woher ein Text kommt. Das, was beantwortet, ob er stimmt, hat noch niemand gebaut, denn dieses Etwas ist kein Detektor. Es ist eine Quelle, zu der Sie zurückgehen können.
Wo Telli.sh hineinpasst: Wir bauen genau diese Quelle, zu der Sie zurückgehen können. Telli.sh nimmt das Meeting auf, erstellt ein Transkript mit Zeitstempeln und zugeordneten Sprechern und verankert die Zusammenfassung in dem Audio, aus dem sie stammt — jede Zeile Ihrer Notizen lässt sich noch Monate später auf die Sekunde zurückverfolgen, in der jemand sie gesagt hat. Das ist keine Behauptung über KI-Erkennung. Es ist die andere Hälfte des Problems: Wenn eine Zusammenfassung etwas behauptet, können Sie es gegen die Aufnahme prüfen, statt dem Satz zu glauben.
Quellen
- Anthropic, "How Claude's text watermark works" (August 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (Oktober 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (Juli 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, Datenbank zu KI-Halluzinationsfällen
- KI-Verordnung der EU, Artikel 50 — Transparenzpflichten
- Bildseite auf Wikimedia Commons
