Llama Windows: pierwszy lokalny czat AI bez konfiguracji terminala
Bezpiecznie zainstaluj Llama Windows, wybierz model GGUF pasujący do Twojego komputera, wypróbuj trzy praktyczne polecenia i połącz się z lokalnym API bez ujawniania serwera.
Pierwsze zadanie dla lokalnej AI powinno być niewielkie: zamień sześć fikcyjnych notatek ze spotkania na trzy zadania do wykonania. Nie powinno być konieczne kompilowanie silnika wnioskowania, zgadywanie kilkunastu parametrów uruchomienia ani przesyłanie prywatnego dokumentu tylko po to, by sprawdzić, czy komputer potrafi odpowiedzieć.
Llama Windows, ogłoszony przez Hugging Face 13 października 2026 r., udostępnia środowisko uruchomieniowe llama.cpp za pośrednictwem aplikacji w obszarze powiadomień systemu Windows. Aplikacja wyszukuje i pobiera modele, a następnie zapewnia lokalny interfejs czatu oraz API dla innych aplikacji. Nazwa opisuje aplikację, a nie ograniczenie jej do modeli Llama firmy Meta. Ogłoszenie premiery
Ten poradnik prowadzi przez bezpieczną instalację, rozsądny wybór pierwszego modelu i pierwszą rozmowę, której wynik można sprawdzić. Następnie omówimy trzy przydatne zadania i opcjonalne zapytanie do lokalnego API. Zacznij od publicznego lub wymyślonego tekstu; materiały wrażliwe wprowadź dopiero wtedy, gdy poznasz cały proces.
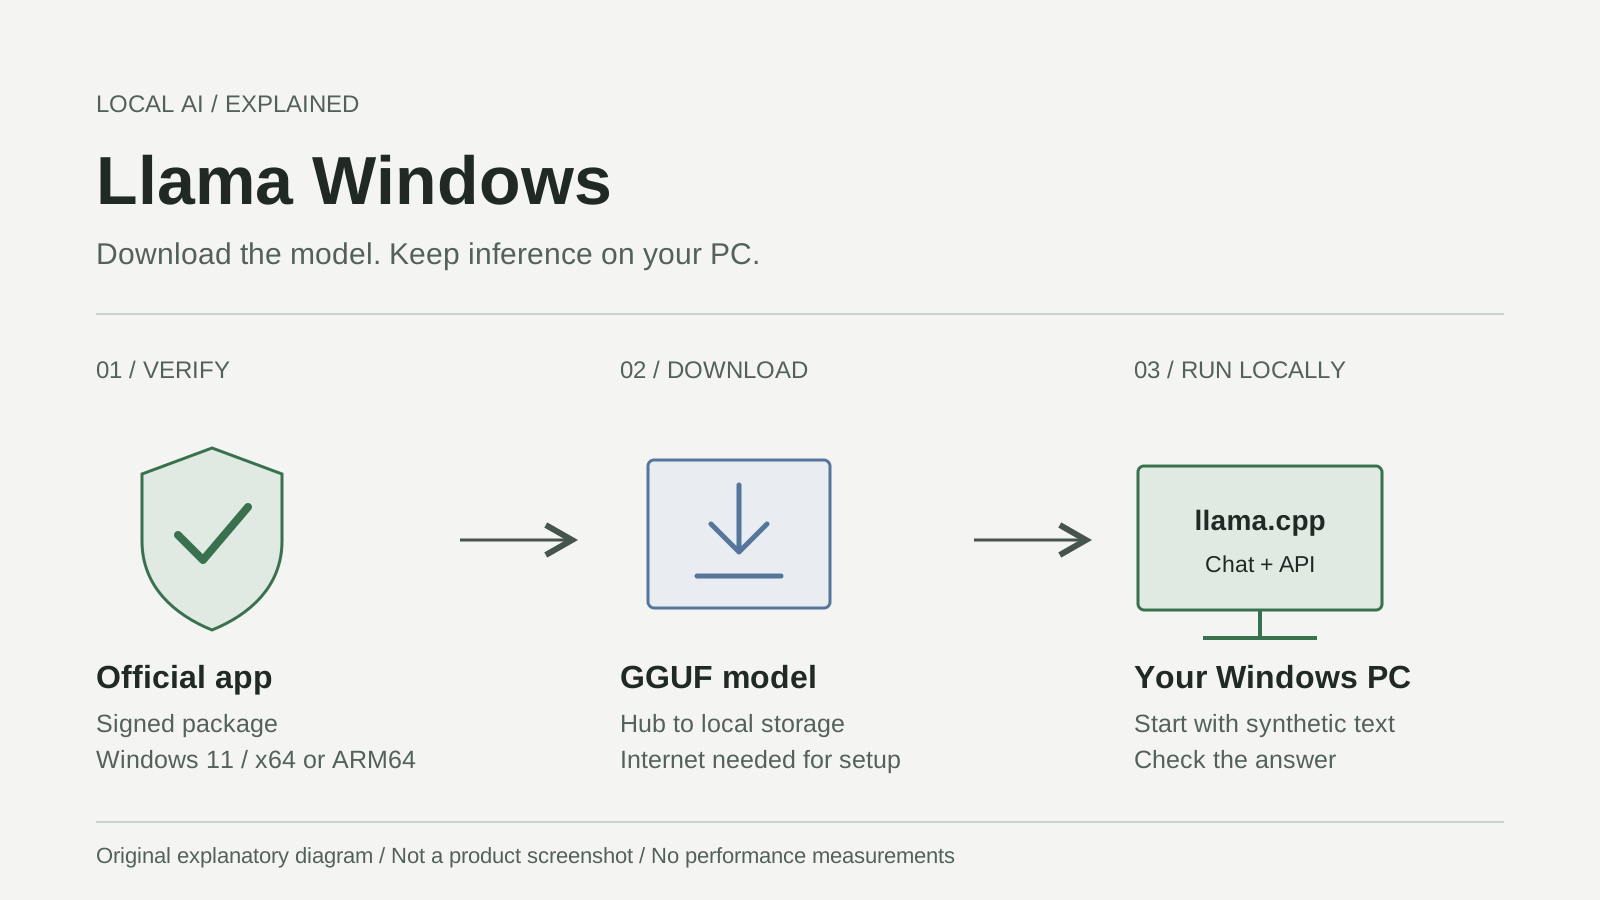
Oryginalna grafika objaśniająca, a nie zrzut ekranu produktu. Pobieranie plików podczas konfiguracji i lokalne wnioskowanie to osobne etapy. Na podstawie oficjalnego przewodnika instalacji dla Windows.
Przed wyborem modelu sprawdź kompilację systemu Windows
Według stanu na 20 października najnowszym wydaniem dla Windows jest v0.12.0. Manifest pakietu wymaga Windows.Desktop 10.0.26100.0 lub nowszego. Kompilacja 26100 odpowiada Windows 11 w wersji 24H2; korzystaj z aktualnie serwisowanej wersji Windows, a nie tylko z najstarszej, która przechodzi instalację. Wydanie, manifest wydania, informacje Microsoft o wydaniach
Wyszukaj w Windows polecenie winver, aby sprawdzić kompilację. W Ustawieniach systemu Windows otwórz System > Informacje, by sprawdzić typ systemu i ilość zainstalowanej pamięci RAM. Oficjalny plik .msixbundle zawiera kompilacje x64 i ARM64: x64 to typowa opcja dla komputerów z Windows i procesorem Intel/AMD, a ARM64 jest przeznaczony dla Windows na Arm. Pakiet dobiera architekturę. Wśród bieżących plików wydania nie ma pakietu dla 32-bitowej architektury x86. Repozytorium Windows, pakowanie zestawu
Dokumentacja instalacji w Windows nie określa jednego uniwersalnego minimum pamięci RAM, VRAM ani dedykowanej karty graficznej. Wymagania zależą od modelu i kontekstu. llama.cpp obsługuje wnioskowanie na CPU i kilka backendów GPU, ale nie gwarantuje jednakowego przyspieszenia na każdym komputerze. Konkretnie model RTX Spark nie jest wymagany. Możliwości llama.cpp
Na Macu skorzystaj z osobnej opcji Download for Mac na stronie llama.app. Nie instaluj pakietu Windows ani nie korzystaj z instrukcji dotyczących sterowników Windows. Podane na stronie rozmiary aplikacji na Maca również nie są wymaganiami instalatora Windows.
Zainstaluj podpisaną aplikację bez osłabiania zabezpieczeń Windows
Zwykła instalacja pakietu nie wymaga kompilowania czegokolwiek ani instalowania .NET SDK. Wymagania wstępne kompilacji ze źródeł dotyczą programistów, a nie procedury pierwszego uruchomienia czatu. Oficjalna dokumentacja instalacji
- Otwórz llama.app i wybierz Download for Windows 11 albo skorzystaj z odnośnika Releases w repozytorium. Upewnij się, że wydanie pochodzi z
ggml-org/Llama-Windows, a nie z witryny o podobnej nazwie. - Wybierz aktualny plik
.msixbundle, a nie archiwum kodu źródłowego z GitHuba. W sprawdzonym wydaniu plik nosi nazwęLlamaApp-v0.12.0.msixbundle. Podczas instalacji miej otwartą stronę wydania. - Otwórz pakiet w Windows App Installer. Przed wybraniem Install sprawdź informacje o wydawcy i podpisie. Tożsamość podpisująca w manifeście v0.12.0 to Hugging Face, a wyświetlana nazwa wydawcy to Morgan Funtowicz. Sama znajoma nazwa wyświetlana nie potwierdza podpisu; system Windows musi ufać podpisowi pakietu. Tożsamość pakietu
- Jeśli Windows zgłosi nieznanego wydawcę, nieprawidłowy podpis lub ograniczenie organizacyjne, zatrzymaj instalację. Ponownie sprawdź oficjalny plik, zaktualizuj Windows lub App Installer przez kanały Microsoft albo skontaktuj się z administratorem. Nie wyłączaj Defendera ani SmartScreen, nie obchodź zasad wykonywania i nie importuj nieznanego certyfikatu, by wymusić instalację. Rozwiązywanie problemów z Microsoft App Installer
- Uruchom Llama i poszukaj ikony w obszarze powiadomień obok zegara; w razie potrzeby sprawdź strzałkę ukrytych ikon. Jeśli brakuje zarządzanego środowiska llama.cpp, aplikacja może je zainstalować, więc pierwsze uruchomienie może wymagać dostępu do internetu. Instrukcja pobierania dla Windows, konfiguracja środowiska uruchomieniowego
Nie zmieniaj ustawień udostępniania sieci. W wersji v0.12.0 adres serwera określa ustawienie Settings > Llama > Listen On; domyślnie jest to localhost. Pierwszy czat nie wymaga wyjątku dla połączeń przychodzących ani adresu dostępnego z innego komputera. Uwagi o zabezpieczeniach wydania
Model mieszczący się na dysku może nie zmieścić się w pamięci
GGUF to format plików modeli zawierający wagi i metadane dla silników wnioskowania, takich jak llama.cpp. To nie marka chatbota ani ocena jakości. Do rozmowy najlepiej zacząć od modelu dostrojonego do wykonywania instrukcji lub czatu; model bazowy służy innym celom. Przeczytaj kartę modelu, zamiast wybierać wyłącznie na podstawie liczby pobrań. Dokumentacja GGUF Hugging Face, wskazówki dotyczące kart modeli
Liczba parametrów opisuje wyuczone wartości numeryczne modelu: 3B oznacza w przybliżeniu trzy miliardy parametrów, a nie plik pobierany o wielkości 3 GB. Kwantyzacja zapisuje te wartości w bardziej kompaktowej postaci. Nazwy takie jak Q4_K_M i Q8_0 oznaczają różne metody kwantyzacji, a nie wersje aplikacji. Niższa precyzja może zmniejszyć zapotrzebowanie na miejsce i pamięć, lecz kompromisy dotyczące jakości i szybkości zależą od modelu oraz sprzętu. Nie jest to automatycznie najszybszy ani najlepszy wybór. Przewodnik kwantyzacji llama.cpp
Rozróżniaj cztery wielkości:
| Wielkość | Na co przeznaczasz zasoby | Decyzja dla początkujących |
|---|---|---|
| Miejsce na dysku | Pobrane pliki modelu, środowisko uruchomieniowe i tymczasowe miejsce na pobieranie | Przed pobraniem sprawdź dysk docelowy |
| Pamięć RAM systemu | Windows, inne aplikacje, dane modelu i praca środowiska uruchomieniowego | Zostaw zapas na zwykłe korzystanie z komputera |
| Pamięć VRAM GPU | Praca przypisana do dedykowanego procesora graficznego | Nie utożsamiaj jej z pamięcią RAM systemu |
| Kontekst | Tokeny przechowywane na potrzeby instrukcji, rozmowy i generowanej odpowiedzi | Zacznij od krótkiego ustawienia, zamiast wybierać maksimum |
Kontekst to biurko robocze rozmowy. Większe pomieści więcej materiału, ale zajmuje też więcej pamięci. Tokeny są fragmentami tekstu, a nie stałą liczbą słów; różne języki i kod są tokenizowane w różny sposób. Wagi modelu to tylko część przydzielanej pamięci: znaczenie mają też pamięć podręczna key/value i bufory środowiska uruchomieniowego. Parametry serwera llama.cpp
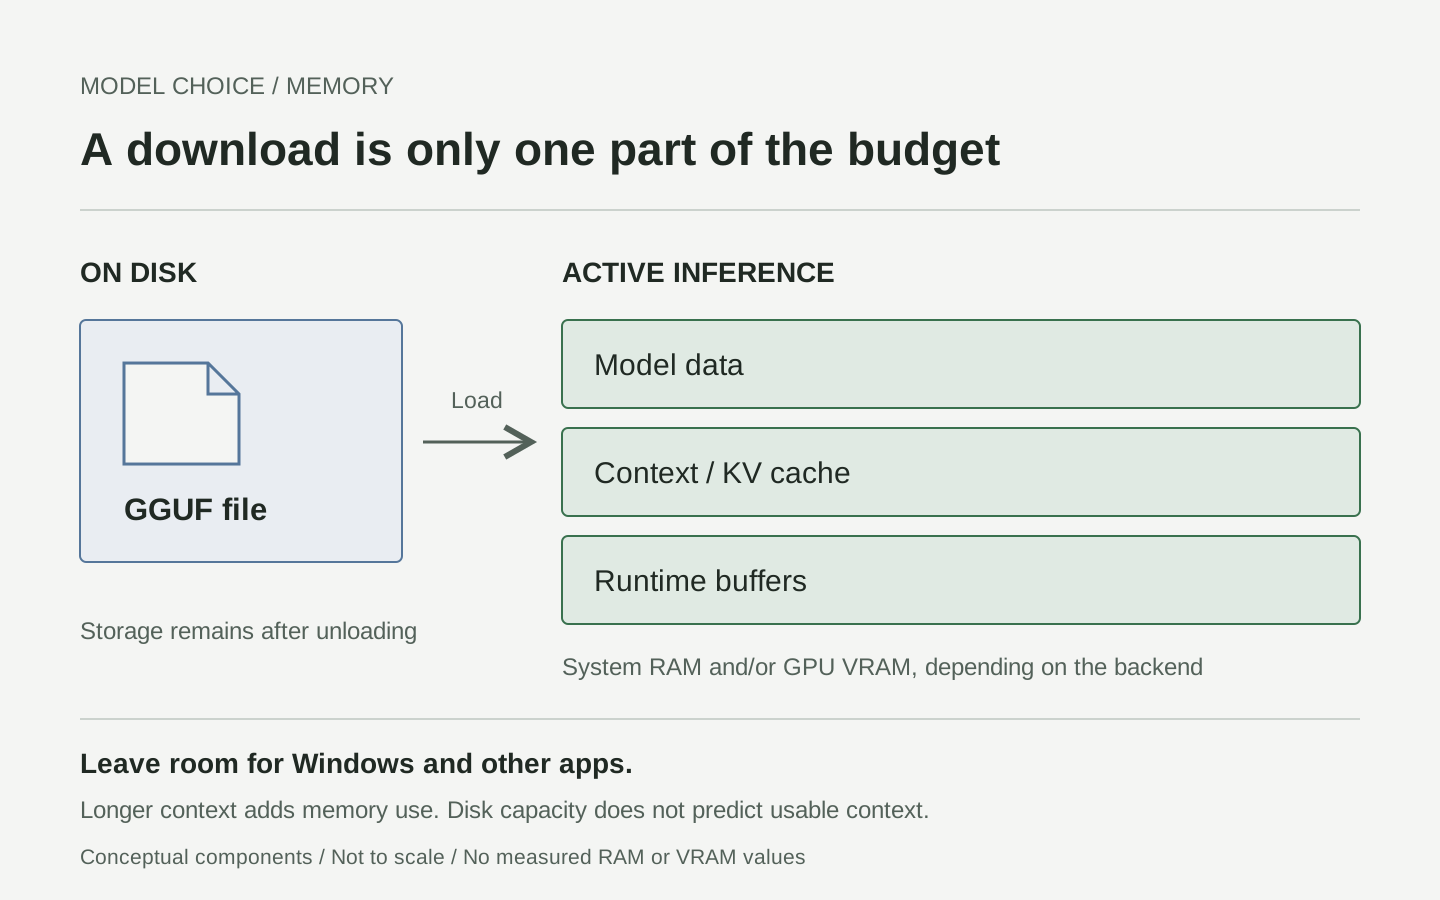
Oryginalny diagram koncepcyjny, a nie zmierzony przydział pamięci. Źródło szczegółów modelu szacuje pamięć dla modelu i kontekstu; całkowite użycie pamięci przez komputer jest większe.
Otwórz szczegóły modelu i sprawdź szacowane zużycie pamięci dla długości kontekstu. Wybierz niewielki, polecany model czatu i krótkie ustawienie kontekstu, pozostawiając zapas. Hipotetyczny plik o wielkości 4 GB na komputerze z pamięcią 16 GB nie dowodzi, że zmieści się na nim długa rozmowa. Jeśli później będziesz porównywać kwantyzacje, zachowaj ten sam model, polecenie i kontekst, aby wiedzieć, co się zmieniło. Przed użyciem komercyjnym sprawdź licencję samego modelu; licencja MIT aplikacji nie obejmuje wszystkich modeli do pobrania.
Przygotuj pierwszą rozmowę tak, by łatwo było ją zweryfikować
W artykule o premierze panele nazwano Recommended Models i Available. W sprawdzonym kodzie źródłowym v0.12.0 użyto jednak nazw Models, separatora Browse more oraz podpowiedzi ikon, takich jak Download model, Load model, Open WebUI i Stop model. Korzystaj z elementów sterujących dostępnych w Twoim wydaniu, zamiast bez końca szukać nazwy starszego panelu. Wersjonowane źródło interfejsu Windows
- Otwórz menu aplikacji w obszarze powiadomień i sprawdź rozmiar oraz szczegóły polecanego modelu. Przy pierwszym uruchomieniu wybierz model publiczny, który nie wymaga specjalnego dostępu.
- Użyj przycisku pobierania i zaczekaj na jego zakończenie. Zakończone pobieranie oznacza, że plik został pobrany, a nie że działa już wnioskowanie.
- W szczegółach modelu wybierz krótki kontekst, a następnie Load model. Po załadowaniu wybierz Open WebUI, by przejść do lokalnego czatu. Oficjalna instrukcja szybkiego startu również opisuje wybór kontekstu przed rozpoczęciem czatu. Szybki start
- Wklej poniższe syntetyczne polecenie i wyślij je. Porównaj odpowiedź z podanymi faktami; nie oceniaj powodzenia wyłącznie na podstawie tego, czy pojawił się tekst.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
Użyteczna odpowiedź zachowuje obie daty, a termin zadania Sama oznacza jako nieokreślony. Wymyślony termin to błąd dokładności, nawet jeśli instalacja działa bez zarzutu. Zapisz polecenie i identyfikator modelu na potrzeby porównań, a po zakończeniu wybierz Stop model. Aplikacja dokumentuje też nakładkę czatu otwieraną skrótem Alt+Space; jest opcjonalna, a nie niezbędna. README Windows
Trzy niewielkie zadania pokazują, do czego przydaje się model lokalny
To przykładowe ćwiczenia z wymyślonymi danymi, a nie zarejestrowane wyniki modelu. Każde zawiera zadanie, pytanie uzupełniające i konkretne kryterium odbioru.
Zamień luźne notatki w przekazanie zadań, nie wymyślając decyzji
Załóżmy, że grupa wolontariuszy przygotowuje wydarzenie weekendowe. Wklej następujące polecenie:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
Ważne jest odróżnienie zobowiązania od sugestii. Dopytaj: „Które działania zostały wyraźnie przypisane, a które są tylko propozycjami?”. Zaakceptuj wynik wyłącznie wtedy, gdy zadanie June jest przypisane, propozycja Omara pozostaje niewiążąca i nie pojawia się żadna godzina rozpoczęcia. Zachowaj oryginalne notatki obok przekazania, aby inna osoba mogła sprawdzić podstawę.
Ucz się na podstawie tekstu, z pytaniami, które nie wykraczają poza źródło
Wykorzystaj krótki tekst z domeny publicznej lub własne syntetyczne objaśnienie. Oto kompletne ćwiczenie:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
Sprawdź każdy cytat, a nie tylko wiarygodność odpowiedzi. Dobre pytanie bez odpowiedzi może dotyczyć progów temperatury, ale model nie może wymyślać żadnego progu. W drugim podejściu poproś o prostsze sformułowania przy zachowaniu wszystkich faktów. Dzięki temu przeróbkę można kontrolować zdanie po zdaniu, zamiast zachęcać do dopisania ogólnego poradnika o szklarniach.
Napisz odpowiedź w sprawie usługi, nie składając nieuprawnionych obietnic
Zanim użyjesz prawdziwej wiadomości klienta, przećwicz na fikcyjnym zgłoszeniu:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
Odrzuć wersję, która twierdzi, że zwrot został przetworzony, albo gwarantuje rozwiązanie sprawy tego samego dnia. Poproś model o podkreślenie każdej złożonej obietnicy, a następnie samodzielnie je sprawdź. Działanie na koncie może potwierdzić tylko osoba mająca dostęp do rzeczywistego systemu obsługi klienta. Uruchomienie lokalne zmienia miejsce przygotowywania tekstu, ale nie uprawnia modelu do wydawania zwrotów.
Lokalne API może korzystać z tego samego modelu
Możesz poprzestać na czacie. Jeśli korzystasz z edytora, skryptu lub prototypu, zarządzany serwer jest udostępniony pod adresem http://localhost:9931, a żądania zgodne z OpenAI są obsługiwane pod ścieżką /v1. To lokalna zgodność, a nie połączenie z chmurą OpenAI. Jeśli port został zmieniony, sprawdź go w Ustawieniach. Dokumentacja API Llama
Gdy aplikacja działa, a model jest już załadowany, otwórz PowerShell. Najpierw wyświetl modele dostępne w routerze: /models zawiera stan ładowania, a /v1/models to zgodny z OpenAI punkt końcowy metadanych. Skopiuj dokładny identyfikator modelu, który celowo załadowałeś. Nie wybieraj arbitralnie pierwszego wpisu, bo może to spowodować załadowanie innego modelu.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
Przed uruchomieniem drugiego bloku zastąp znajdujący się w nim symbol zastępczy dokładnym identyfikatorem modelu. Blok wysyła wyłącznie syntetyczny tekst i nie wymaga dodatkowego SDK:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
Struktura żądania i pole wyniku odpowiadają oficjalnej dokumentacji serwera llama.cpp. Pozostaw ustawienie Listen On na localhost i nigdy nie wklejaj do tego przykładu klucza API do chmury. Błąd 401 oznacza, że trzeba sprawdzić lokalne uwierzytelnianie, a nie usuwać zabezpieczenia. W wersji v0.12.0 wybranie adresu spoza loopback dodaje klucz wygenerowany przez aplikację i wymaga potwierdzenia. Zabezpieczenia Windows
Lokalne wnioskowanie nie eliminuje wszystkich operacji sieciowych
README dla Windows informuje, że polecenia i wnioskowanie pozostają lokalne, a aplikacja nie wysyła telemetrii. Dokumentuje również żądania sieciowe podczas pobierania modeli i sprawdzania aktualizacji, z nagłówkiem User-Agent zawierającym wersję aplikacji, kompilację Windows i architekturę. To różne działania, a nie sprzeczne definicje trybu „offline”. Informacja o prywatności
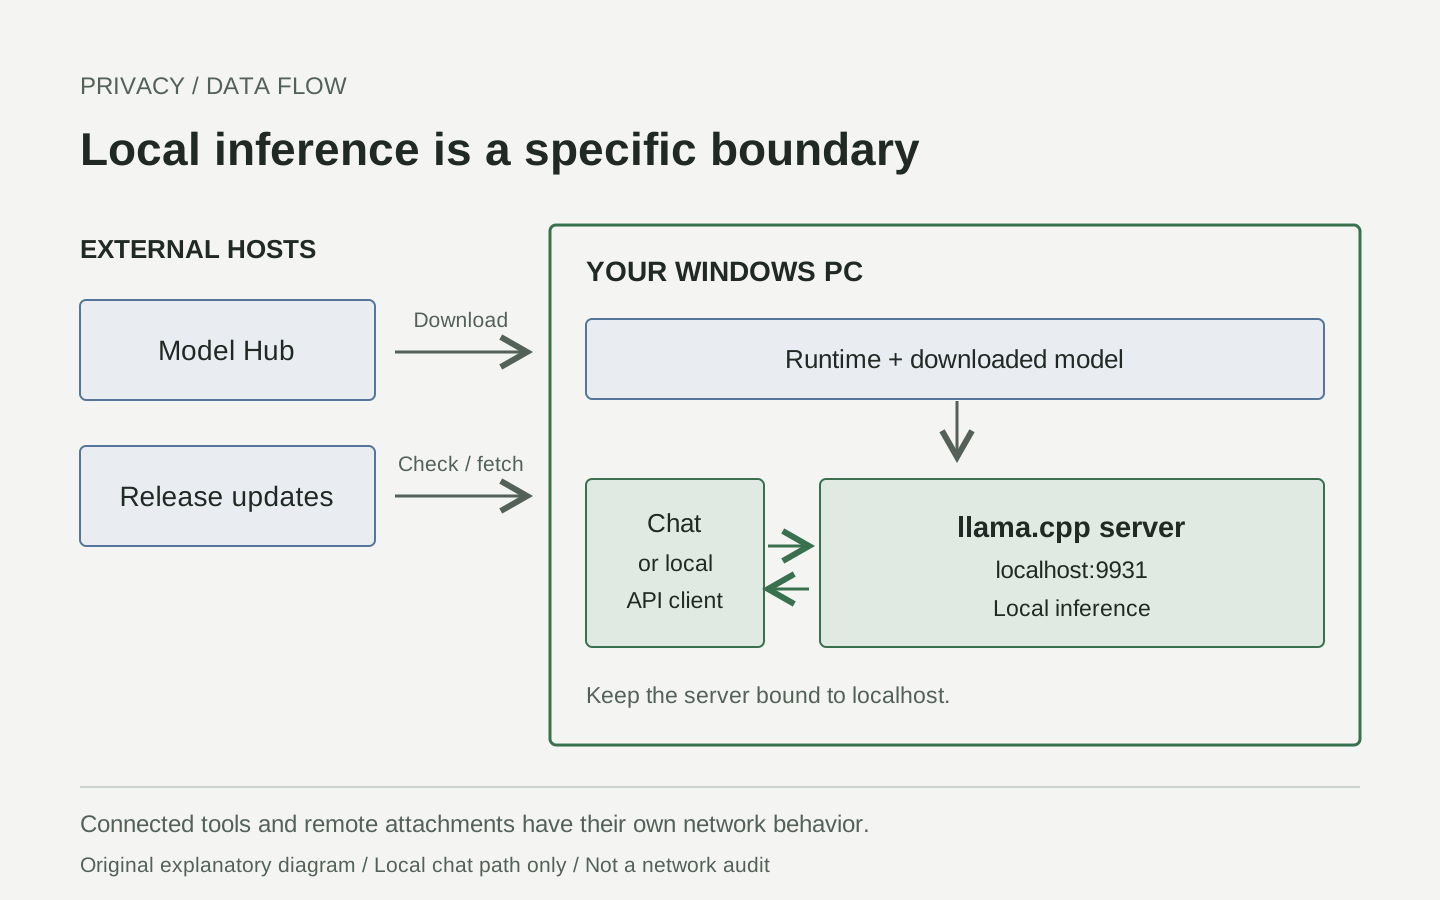
Oryginalne objaśnienie przepływu danych. Serwery pobierania są zewnętrzne; przedstawiona ścieżka czatu jest lokalna. Źródła: dokumentacja prywatności Windows i referencja API.
Pobrany, obsługiwany model może przeprowadzać wnioskowanie bez połączenia z internetem, ale nowy model nadal trzeba pobrać. Połączony edytor, rozszerzenie przeglądarki, zdalny adres URL załącznika lub włączone narzędzie zewnętrzne ma własne zachowanie sieciowe. Nie zakładaj, że podlega lokalnym ograniczeniom serwera.
Przed pracą z informacjami poufnymi sprawdź przechowywanie rozmów, rozszerzenia przeglądarki, lokalizacje kopii zapasowych i synchronizacji oraz zasady swojej organizacji. Syntetyczna rozmowa offline jest po konfiguracji użytecznym testem działania, ale nie dowodzi, że wszystkie elementy zostały poddane audytowi. Nigdy nie umieszczaj tokenów ani prywatnych poleceń w publicznych logach diagnostycznych.
Napraw konkretny etap, zamiast diagnozować całą instalację
| Objaw | Co sprawdzić najpierw | Przydatny następny krok |
|---|---|---|
| Nie można zainstalować pakietu | Minimalna kompilacja 26100, architektura, podpis, zasady urządzenia | Zapisz dokładny błąd App Installer; skorzystaj z oficjalnych aktualizacji lub pomocy administratora |
| Nie widać okna aplikacji | Obszar powiadomień i ukryte ikony | Otwórz ikonę aplikacji w obszarze powiadomień; stałe okno na pasku zadań nie jest oczekiwane |
| Nie udaje się pobrać modelu | Miejsce docelowe, połączenie, wymagany dostęp, wyświetlony błąd | Przed ponowieniem usuń przyczynę; zacznij od modelu publicznego |
| Pobieranie się kończy, ale model nie chce się załadować | Szacowane zużycie kontekstu, wolna pamięć, błąd środowiska uruchomieniowego | Zatrzymaj inne załadowane modele i zmniejsz kontekst lub model |
| Odpowiedzi są powolne | Rozmiar modelu, długość kontekstu, faktycznie używany backend CPU/GPU | Porównaj jedno krótkie polecenie; nie zakładaj, że rekomendacja katalogu gwarantuje szybkość |
| API nie może się połączyć | Działająca aplikacja, skonfigurowany port, lokalny adres | Sprawdź stan serwera, zanim uruchomisz drugi |
| Płynna odpowiedź zawiera nieprawdziwe szczegóły | Tekst źródłowy i przydatność modelu | Skróć zadanie i wymagaj cytatów potwierdzających odpowiedź |
Aktualne README wskazuje %LOCALAPPDATA%\Llama jako lokalizację ustawień i logów; w poście premierowym podano inną ścieżkę logów. Zamiast zgadywać, użyj w aplikacji przycisku otwierającego folder logów. Opisany punkt końcowy /health ułatwia odróżnienie gotowego serwera modelu od serwera, który nadal ładuje model, chociaż działający router nie dowodzi, że wybrany model został załadowany. Aktualna dokumentacja miejsca zapisu, stan serwera
Pierwszą konfigurację uznaj za udaną dopiero po zaliczeniu tych kontroli
- Oficjalny, podpisany pakiet instaluje się bez wyłączania zabezpieczeń.
- Jeden celowo wybrany model kończy pobieranie i ładuje się poprawnie.
- Czat otwiera się pod lokalnym adresem i odpowiada na syntetyczne zadanie.
- Daty, imiona i brakujące informacje są zgodne z dostarczonym tekstem.
- Możesz zatrzymać model i załadować go ponownie.
- Jeśli korzystasz z API, odpowiada właściwy model, a serwer pozostaje dostępny wyłącznie przez localhost.
Podsumowanie: lokalna AI to proces, który możesz skontrolować
Naszym zdaniem najważniejsza poprawa nie polega na unikaniu jednego polecenia terminala. Chodzi o to, by wybór modelu, zużycie pamięci, materiały źródłowe i otrzymana odpowiedź były na tyle zrozumiałe, żeby dało się cały proces powtórzyć. Zacznij od jednego niewielkiego zadania, którego wynik możesz sprawdzić. Rozszerzaj zakres dopiero wtedy, gdy wiesz, jak rozpoznać powodzenie.
Źródła i materiały
Stan na 20 października 2026 r. Ten poradnik opisuje udokumentowane procesy; nie twierdzimy, że przeprowadzono instalację próbną, uruchomienie modelu, płatne zapytanie ani benchmark. Wszystkie trzy pliki SVG to oryginalne grafiki objaśniające, a nie odwzorowania interfejsu. Rzeczywisty interfejs pokazano na oficjalnym zrzucie ekranu aplikacji w obszarze powiadomień i w demonstracji nakładki wydawcy. Te materiały są podlinkowane, a nie opublikowane ponownie.
- Ogłoszenie Hugging Face, 13 października
- Wydanie Windows, pakiet i zmiany dotyczące zabezpieczeń
- Oficjalna instalacja i szybki start
- Format GGUF i metadane
- Lokalne API i dokumentacja punktów końcowych
- Środowisko uruchomieniowe i dokumentacja serwera llama.cpp
Zachowuj eksperymenty do ponownego wykorzystania
Przechowuj linki do źródeł, polecenia, identyfikatory modeli i notatki z weryfikacji razem, zamiast zapisywać wyłącznie końcową odpowiedź. Telli.sh może porządkować notatki z researchu; nie jest integracją z Llama Windows ani obietnicą, że notatki pozostaną offline. Utwórz konto Telli.sh