Llama Windows: 터미널 설정 없이 시작하는 첫 로컬 AI 채팅
Llama Windows를 안전하게 설치하고, PC 사양에 맞는 GGUF 모델을 선택해 실용적인 프롬프트 세 가지를 사용해 보세요. 서버를 외부에 노출하지 않고 로컬 API에 연결하는 방법도 안내합니다.
첫 로컬 AI 작업은 간단한 것이어야 합니다. 가상의 회의 메모 여섯 줄을 실행 항목 세 개로 정리해 보세요. 컴퓨터가 답변할 수 있는지 확인하는 데 추론 엔진을 컴파일하거나, 실행 옵션을 열두 개씩 추측하거나, 비공개 문서를 업로드할 필요는 없습니다.
Hugging Face가 2026년 10월 13일 발표한 Llama Windows는 llama.cpp 런타임을 Windows 시스템 트레이 앱으로 제공합니다. 앱에서 모델을 찾고 다운로드할 수 있으며, 로컬 채팅 인터페이스와 다른 애플리케이션용 API도 사용할 수 있습니다. 이름은 앱을 가리키며 Meta의 Llama 모델만 지원한다는 뜻은 아닙니다. 출시 발표
이 가이드에서는 안전한 설치 방법과 적절한 첫 모델, 직접 확인할 수 있는 첫 대화를 차례로 살펴봅니다. 이어서 유용한 작업 세 가지와 선택 사항인 로컬 API 요청을 다룹니다. 먼저 공개 텍스트나 직접 만든 예시를 사용하고, 전체 워크플로를 파악한 다음 민감한 정보를 입력하세요.
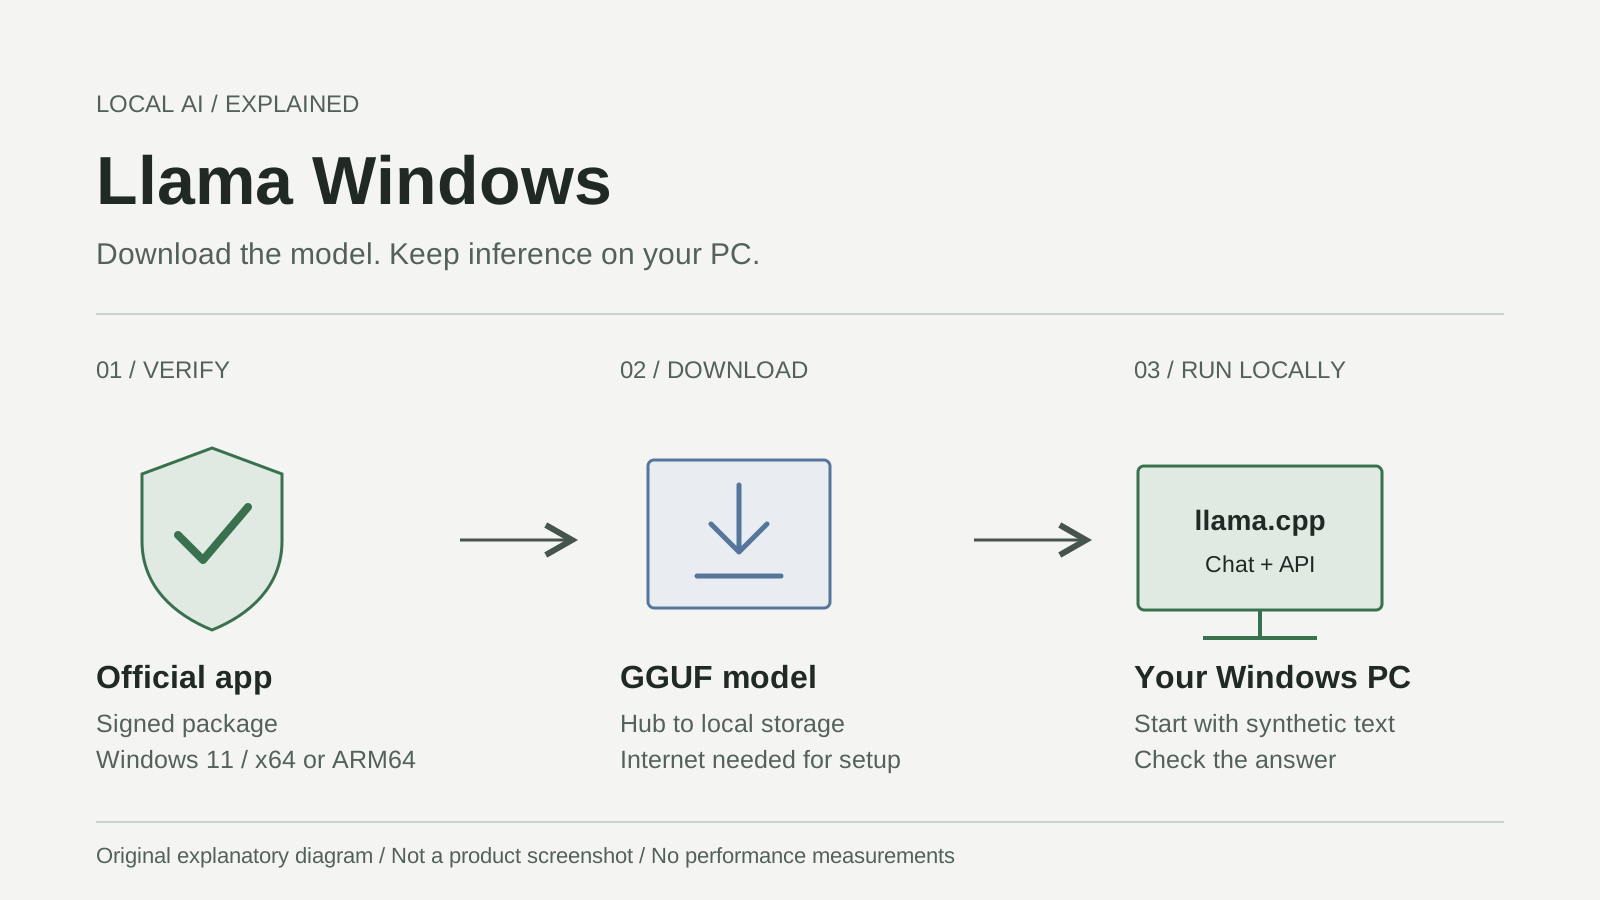
제품 화면이 아닌 설명용으로 직접 제작한 그림입니다. 설정 파일 다운로드와 로컬 추론은 별개의 단계입니다. 공식 Windows 설치 가이드를 바탕으로 했습니다.
모델을 고르기 전에 Windows 빌드를 확인한다
2026년 10월 20일 기준 최신 공개 Windows 릴리스는 v0.12.0입니다. 패키지 매니페스트는 Windows.Desktop 10.0.26100.0 이상을 요구합니다. 빌드 26100은 Windows 11 버전 24H2에 해당합니다. 설치를 통과하는 가장 오래된 버전이 아니라 현재 지원 중인 Windows 릴리스를 사용하세요. 릴리스, 릴리스 매니페스트, Microsoft 릴리스 정보
Windows 검색에서 winver를 실행해 빌드를 확인하세요. Windows 설정에서 시스템 > 정보로 이동하면 시스템 유형과 설치된 RAM을 볼 수 있습니다. 공식 .msixbundle에는 x64 및 ARM64 빌드가 포함됩니다. x64는 일반적인 Intel/AMD Windows PC용이고 ARM64는 Arm 기반 Windows용입니다. 번들에서 아키텍처를 선택합니다. 현재 릴리스 자산에는 32비트 x86 패키지가 없습니다. Windows 저장소, 번들 패키징
Windows 설치 문서에는 보편적으로 적용되는 RAM, VRAM 또는 전용 GPU 최소 사양이 명시되어 있지 않습니다. 필요한 사양은 모델과 컨텍스트에 따라 달라집니다. llama.cpp는 CPU 추론과 여러 GPU 백엔드를 지원하지만 모든 PC에서 동일한 가속을 보장하지는 않습니다. RTX Spark가 반드시 필요한 것도 아닙니다. llama.cpp 기능
Mac에서는 llama.app의 별도 Mac용 다운로드 경로를 이용하세요. Windows 번들을 설치하거나 Windows 드라이버 안내를 가져다 쓰지 마세요. 사이트에 나온 Mac 앱 용량도 Windows 설치 프로그램의 요구 사항이 아닙니다.
보안을 약화시키지 않고 서명된 앱을 설치한다
일반 패키지 설치 경로에서는 직접 컴파일하거나 .NET SDK를 설치할 필요가 없습니다. 소스 빌드 사전 요건은 개발자용이며 첫 채팅을 위한 절차와는 무관합니다. 공식 설치 문서
- llama.app을 열어 Download for Windows 11을 선택하거나 저장소의 Releases 링크를 이용합니다. 비슷한 이름의 다운로드 사이트가 아닌
ggml-org/Llama-Windows의 릴리스인지 확인하세요. - GitHub의 소스 코드 압축 파일이 아니라 최신
.msixbundle을 선택합니다. 확인 당시 릴리스 파일 이름은LlamaApp-v0.12.0.msixbundle입니다. 설치하는 동안 릴리스 페이지도 열어 두세요. - Windows App Installer로 번들을 엽니다. 설치를 선택하기 전에 게시자와 서명 정보를 살펴보세요. v0.12.0 매니페스트의 서명 ID는 Hugging Face이고, 게시자 표시 이름은 Morgan Funtowicz입니다. 익숙한 표시 이름만으로 서명을 검증할 수는 없습니다. Windows가 패키지 서명을 신뢰해야 합니다. 패키지 ID
- Windows에서 알 수 없는 게시자, 유효하지 않은 서명 또는 조직 정책 위반을 알리면 중단하세요. 공식 파일인지 다시 확인하고 Microsoft 채널을 통해 Windows 또는 App Installer를 업데이트하거나 관리자에게 문의합니다. 설치를 강행하려고 Defender나 SmartScreen을 끄거나, 실행 정책을 우회하거나, 알 수 없는 인증서를 가져오지 마세요. Microsoft App Installer 문제 해결
- Llama를 실행한 뒤 시계 옆 알림 영역에서 아이콘을 찾습니다. 필요하면 숨겨진 아이콘 표시를 확인하세요. 관리되는 llama.cpp 런타임이 없으면 앱이 설치할 수 있으므로 첫 실행에 인터넷이 필요할 수 있습니다. Windows 다운로드 안내, 런타임 설정
네트워크 공유 설정은 그대로 두세요. v0.12.0에서는 Settings > Llama > Listen On에서 서버 주소를 제어하며 기본값은 localhost입니다. 첫 채팅에는 인바운드 네트워크 예외나 다른 컴퓨터에서 접근 가능한 주소가 필요하지 않습니다. 릴리스 보안 안내
디스크에 들어가는 모델도 메모리에는 맞지 않을 수 있다
GGUF는 llama.cpp와 같은 추론 엔진에서 쓸 가중치와 메타데이터를 담는 모델 파일 형식입니다. 챗봇 브랜드나 품질 등급은 아닙니다. 대화를 시작하려면 지시 조정 또는 채팅 모델이 적합하며, 베이스 모델은 용도가 다릅니다. 다운로드 횟수만 보지 말고 모델 카드를 읽으세요. Hugging Face GGUF 문서, 모델 카드 안내
매개변수 수는 모델이 학습한 수치 값을 가리킵니다. 3B는 대략 매개변수 30억 개라는 뜻이지 다운로드 용량이 3GB라는 뜻은 아닙니다. 양자화는 이 값을 더 간결한 형태로 저장합니다. Q4_K_M, Q8_0 같은 이름은 앱 버전이 아니라 각기 다른 양자화 방식을 나타냅니다. 낮은 정밀도를 사용하면 저장 공간과 메모리 요구량을 줄일 수 있지만, 품질과 속도의 균형은 모델과 하드웨어에 따라 달라집니다. 자동으로 가장 빠르거나 좋은 선택이 되는 것은 아닙니다. llama.cpp 양자화 가이드
다음 네 가지 용량을 구분하세요.
| 항목 | 예산을 세울 대상 | 초보자를 위한 결정 |
|---|---|---|
| 디스크 공간 | 다운로드 모델, 런타임, 임시 다운로드 공간 | 다운로드 전에 저장할 드라이브를 확인합니다 |
| 시스템 RAM | Windows, 다른 앱, 모델 데이터, 런타임 작업 | 일반적인 PC 사용을 위한 여유를 남깁니다 |
| GPU VRAM | 전용 GPU에 할당되는 작업 | 시스템 RAM과 같다고 여기지 않습니다 |
| 컨텍스트 | 지시문, 대화, 생성 결과를 담는 토큰 | 최댓값 대신 짧게 시작합니다 |
컨텍스트는 대화의 작업 책상입니다. 책상이 크면 더 많은 자료를 올릴 수 있지만 메모리도 더 많이 차지합니다. 토큰은 텍스트 조각이며 단어 수와 일정한 비율을 이루지 않습니다. 언어와 코드에 따라 토큰화 방식도 달라집니다. 모델 가중치만 메모리를 쓰는 것이 아니라 키·값 캐시와 런타임 버퍼도 필요합니다. llama.cpp 서버 매개변수
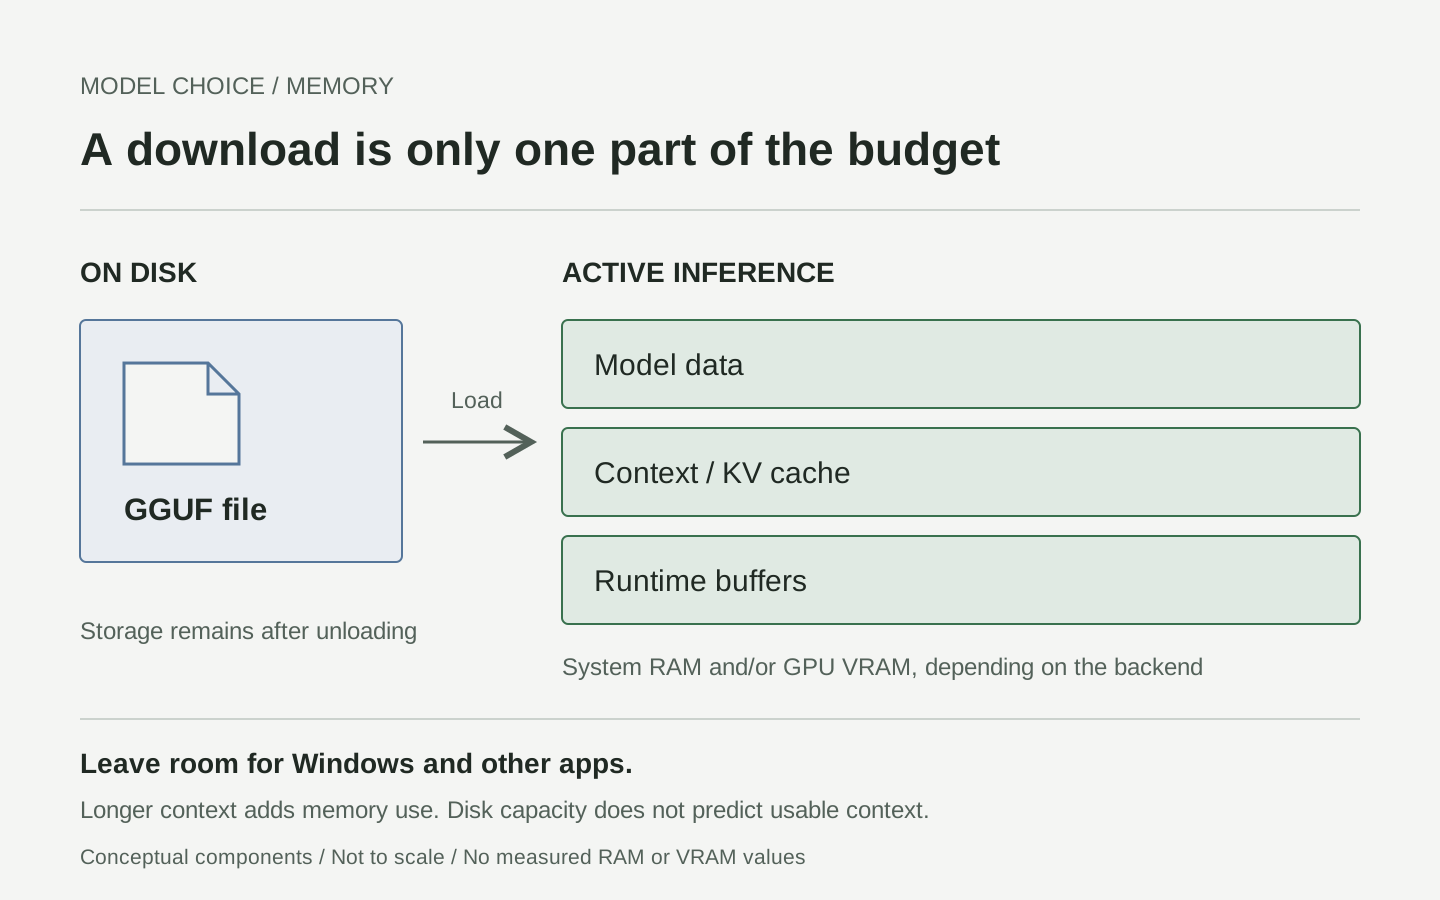
실측 메모리 배분이 아닌 개념도입니다. 모델 세부 정보 출처는 모델과 컨텍스트의 메모리를 추정합니다. PC 전체 사용량에는 그 밖의 요소도 포함됩니다.
모델 세부 정보를 열어 컨텍스트 길이에 따른 메모리 추정치를 살펴보세요. 권장 채팅 모델 중 작은 모델과 여유가 남는 짧은 컨텍스트 설정을 고릅니다. 예를 들어 16GB PC에서 용량 4GB짜리 파일을 쓸 수 있다고 해서 긴 대화까지 실행된다는 보장은 없습니다. 나중에 양자화 버전을 비교할 때는 모델, 프롬프트, 컨텍스트를 동일하게 유지해 무엇이 달라졌는지 확인하세요. 상업적으로 사용하기 전에 해당 모델의 라이선스도 확인해야 합니다. 앱의 MIT 라이선스가 다운로드 가능한 모든 모델에 적용되는 것은 아닙니다.
첫 대화는 확인하기 쉬운 과제로 시작한다
출시 글에서는 패널을 Recommended Models와 Available이라고 부릅니다. 확인한 v0.12.0 소스에서는 Models, Browse more 구분선, Download model, Load model, Open WebUI, Stop model 등의 아이콘 툴팁을 사용합니다. 이전 버전의 패널 이름을 계속 찾지 말고 사용하는 릴리스에 표시된 컨트롤을 따르세요. 버전별 Windows UI 소스
- 트레이 패널을 열고 추천 모델 하나의 용량과 세부 정보를 확인합니다. 첫 실행에서는 접근 승인 절차가 필요 없는 공개 모델을 선택합니다.
- 다운로드 컨트롤을 사용해 다운로드를 완료합니다. 파일이 도착했다는 것은 추론이 실행 중이라는 뜻이 아닙니다.
- 모델 세부 정보에서 짧은 컨텍스트를 선택한 뒤 Load model을 누릅니다. 모델이 로드되면 Open WebUI를 선택해 로컬 채팅을 엽니다. 공식 빠른 시작에서도 채팅 전 컨텍스트를 고르는 방법을 안내합니다. 빠른 시작
- 아래의 합성 프롬프트를 붙여 넣고 전송합니다. 글이 출력됐는지만 보지 말고 제공한 사실과 답변을 대조하세요.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
유용한 답변이라면 두 날짜를 모두 유지하고 Sam의 마감일은 지정되지 않았다고 표시합니다. 설치가 완벽하더라도 마감일을 지어낸다면 정확성 측면에서 실패한 것입니다. 비교를 위해 프롬프트와 모델 ID를 저장하고 완료 후에는 Stop model을 선택하세요. 앱에서는 Alt+Space 채팅 오버레이도 제공하지만 필수 기능은 아닙니다. Windows README
작은 작업 세 가지가 로컬 모델의 쓸모를 보여 준다
아래 내용은 직접 만든 입력을 사용하는 예시이며 실제 모델 출력을 기록한 것이 아닙니다. 각 예시에는 과제, 후속 요청, 구체적인 통과 기준이 있습니다.
거친 메모에서 결정을 지어내지 않는 인계 문서 만들기
자원봉사 단체에서 주말 행사를 준비한다고 해 보겠습니다. 다음 요청을 입력합니다.
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
중요한 점은 약속과 제안을 구별하는 것입니다. “명시적으로 담당자가 정해진 작업은 무엇이고, 제안에 그치는 것은 무엇인가요?”라고 후속 질문을 해 보세요. June에게 맡긴 작업이 지정되고, Omar의 제안은 확정되지 않은 상태로 남고, 시작 시각이 추가되지 않은 경우에만 결과를 받아들이세요. 다른 사람도 근거를 살필 수 있도록 원래 메모를 인계 문서와 함께 보관합니다.
출처 안에서 답을 찾는 학습 질문 만들기
짧은 퍼블릭 도메인 지문이나 직접 쓴 합성 설명을 사용하세요. 아래는 자체 완결된 연습 예시입니다.
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
답변이 그럴듯한지만 볼 것이 아니라 인용문을 하나씩 확인하세요. 답할 수 없는 질문으로 온도 임계값을 물을 수는 있지만, 모델이 그 값을 지어내서는 안 됩니다. 두 번째로 더 쉬운 문장으로 바꾸되 사실은 모두 유지하도록 요청해 보세요. 일반적인 온실 안내를 덧붙일 기회가 아니라 문장 단위로 확인 가능한 재작성 과제가 됩니다.
약속을 함부로 하지 않으면서 고객 응답 초안 작성하기
실제 고객 문구를 쓰기 전에 가상의 문의로 연습해 보세요.
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
환불 처리가 끝났다고 하거나 당일 처리를 보장하는 초안은 거절하세요. 모델에게 본인이 한 모든 약속을 표시해 달라고 요청한 뒤 직접 검토합니다. 실제 고객 지원 시스템에서 계정 조치가 완료됐는지는 접근 권한이 있는 사람만 확인할 수 있습니다. 로컬에서 실행한다고 해서 모델에 환불 권한이 생기는 것은 아닙니다.
같은 모델을 로컬 API에서 재사용할 수 있다
채팅만 사용해도 괜찮습니다. 편집기, 스크립트, 시제품에 연결하려면 관리 서버 주소는 **http://localhost:9931**이며 /v1 아래에서 OpenAI 호환 요청을 지원합니다. 이는 로컬 호환 인터페이스이지 OpenAI 클라우드에 요청하는 것이 아닙니다. 포트를 변경했다면 설정에서 확인하세요. Llama API 문서
앱을 실행하고 모델을 로드한 상태에서 PowerShell을 엽니다. 먼저 라우터에서 사용할 수 있는 모델을 나열합니다. /models에는 로드 상태가 포함되며 /v1/models는 OpenAI 호환 메타데이터 엔드포인트입니다. 직접 로드한 모델의 정확한 ID를 복사하세요. 첫 번째 항목을 임의로 선택하면 다른 모델이 로드될 수 있으니 주의합니다.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
두 번째 블록을 실행하기 전에 아래 자리표시자를 앞서 확인한 정확한 ID로 바꾸세요. 합성 텍스트만 전송하며 추가 SDK는 필요하지 않습니다.
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
요청 형식과 출력 필드는 공식 llama.cpp 서버 참조를 따릅니다. Listen On은 localhost로 유지하고 이 예시에 클라우드 API 키를 붙여 넣지 마세요. 401 오류가 발생하면 보호 기능을 없애지 말고 로컬 인증 설정을 확인하세요. v0.12.0에서는 루프백이 아닌 주소를 선택할 경우 앱에서 생성한 키와 확인 절차를 추가합니다. Windows 보안 동작
로컬 추론도 모든 네트워크 작업을 없애지는 않는다
Windows README에 따르면 프롬프트와 추론은 로컬에서 처리되며 앱은 텔레메트리를 보내지 않습니다. 모델 다운로드와 릴리스 업데이트 확인에는 네트워크 요청이 발생합니다. 여기에는 앱 버전, Windows 빌드, 아키텍처를 담은 User-Agent가 포함됩니다. 이는 서로 다른 작업이며 “오프라인”을 서로 다른 의미로 해석할 필요는 없습니다. 개인정보 안내
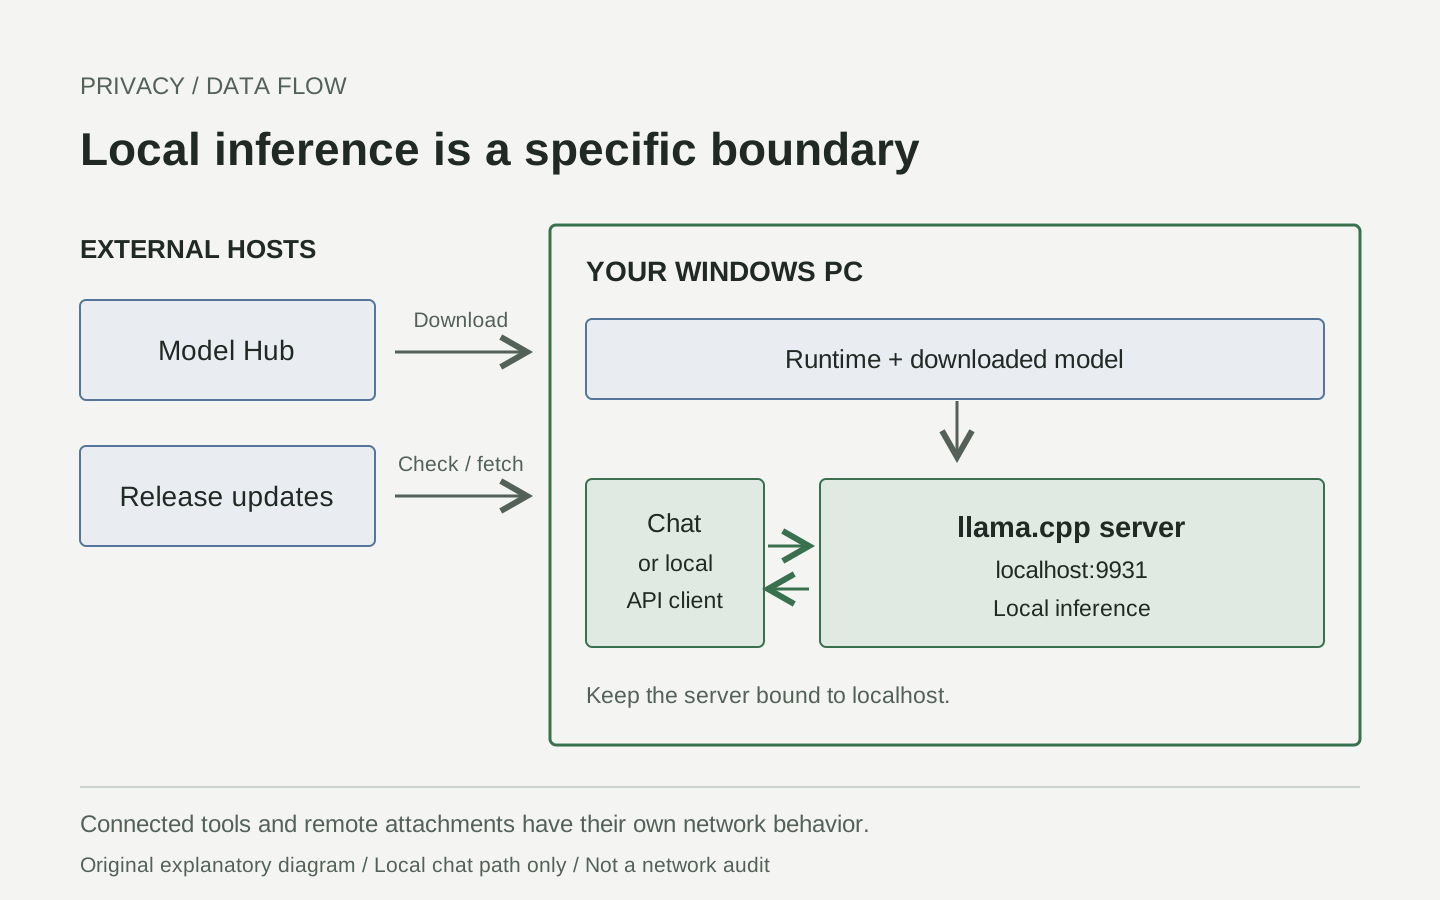
직접 제작한 데이터 흐름 설명입니다. 다운로드 호스트는 외부에 있고 그림의 채팅 경로는 로컬입니다. 출처: Windows 개인정보 문서, API 참조.
다운로드한 지원 모델은 인터넷 연결 없이 추론할 수 있지만 새 모델을 받으려면 다운로드가 필요합니다. 연결된 편집기, 브라우저 확장 프로그램, 원격 첨부 URL, 활성화된 외부 도구는 각각 별도의 네트워크 동작을 합니다. 서버가 로컬 전용이라는 이유로 이들도 같은 경계를 따른다고 가정하지 마세요.
기밀 작업을 시작하기 전에 대화 저장 위치, 브라우저 확장 프로그램, 백업 및 동기화 위치, 조직 정책을 확인하세요. 설정 후 오프라인에서 합성 대화를 실행하는 것은 기능 확인에는 유용하지만 모든 구성 요소를 감사했다는 증거는 아닙니다. 토큰이나 비공개 프롬프트를 공개 진단 로그에 넣지 마세요.
전체 설치보다 실패한 단계부터 점검한다
| 증상 | 먼저 확인할 항목 | 다음으로 해볼 일 |
|---|---|---|
| 번들이 설치되지 않음 | 최소 빌드 26100, 아키텍처, 서명, 기기 정책 | 정확한 App Installer 오류를 보관하고 공식 업데이트나 관리자 지원을 이용합니다 |
| 앱 창이 보이지 않음 | 알림 영역과 숨겨진 아이콘 | 트레이 아이콘을 엽니다. 작업 표시줄에 상시 창이 뜨는 방식은 아닙니다 |
| 모델 다운로드 실패 | 대상 공간, 연결, 접근 제한, 표시된 오류 | 원인을 해결한 뒤 다시 시도하고 공개 모델로 시작합니다 |
| 다운로드는 끝났지만 로드 실패 | 컨텍스트 추정치, 가용 메모리, 런타임 오류 | 다른 로드 모델을 중지하고 컨텍스트나 모델 크기를 줄입니다 |
| 응답이 느림 | 모델 크기, 컨텍스트 길이, 실제 사용 중인 CPU/GPU 백엔드 | 짧은 프롬프트 하나로 비교하고 카탈로그 추천이 속도 보장이라고 가정하지 않습니다 |
| API 연결 불가 | 앱 실행 여부, 설정 포트, 로컬 주소 | 서버 상태를 살피고 두 번째 서버를 실행하지 않습니다 |
| 자연스럽지만 틀린 내용이 포함된 답변 | 원문과 모델의 적합성 | 과제를 줄이고 근거 인용을 요구합니다 |
현재 README는 설정과 로그 위치를 **%LOCALAPPDATA%\Llama**로 안내합니다. 출시 글에는 다른 로그 경로가 나와 있습니다. 경로를 추측하지 말고 앱의 로그 폴더 컨트롤을 사용하세요. 문서화된 /health 엔드포인트는 모델 서버가 준비됐는지 아직 로딩 중인지 구분하는 데 유용합니다. 단, 라우터가 동작한다고 선택한 모델까지 로드됐다는 뜻은 아닙니다. 현재 저장소 문서, 서버 상태 동작
이 항목을 확인해야 첫 설정이 끝난다
- 공식 서명 패키지가 보안 제어를 끄지 않고 설치됩니다.
- 의도적으로 고른 모델 하나가 다운로드와 로드를 마칩니다.
- 로컬 주소에서 채팅이 열리고 합성 과제에 답합니다.
- 이름, 날짜, 누락된 정보가 제공된 내용과 일치합니다.
- 모델을 중지했다가 다시 로드할 수 있습니다.
- API를 사용한다면 의도한 모델이 응답하고 서버가 localhost 전용으로 유지됩니다.
로컬 AI의 핵심은 점검할 수 있는 워크플로다
저희가 주목하는 개선은 터미널 명령 하나를 줄이는 일이 아닙니다. 모델 선택, 메모리 사용, 입력 자료, 결과를 반복 가능한 방식으로 이해할 수 있게 되는 점입니다. 답을 검증할 수 있는 작은 과제 하나로 시작하세요. 성공의 기준을 알고 난 뒤에만 범위를 넓히면 됩니다.
출처 및 미디어
2026년 10월 20일 확인. 이 가이드는 문서화된 워크플로를 설명하며 설치 시험, 모델 실행, 유료 요청, 벤치마크를 수행했다고 주장하지 않습니다. SVG 세 개는 모두 인터페이스 재현이 아닌 설명용 원본 그림입니다. 실제 인터페이스는 게시자의 공식 트레이 스크린샷과 오버레이 시연을 확인하세요. 해당 자료를 재게시하지 않고 링크만 제공합니다.
- Hugging Face 발표, 10월 13일
- Windows 릴리스, 패키지, 보안 변경 사항
- 공식 설치 및 빠른 시작
- GGUF 형식 및 메타데이터
- 로컬 API 및 엔드포인트 문서
- llama.cpp 런타임 및 서버 참조
실험은 다시 쓸 수 있는 기록으로 남긴다
최종 답변만 저장하지 말고 출처 링크, 프롬프트, 모델 ID, 검토 메모를 함께 보관하세요. Telli.sh는 조사 노트를 정리하는 데 도움이 됩니다. Llama Windows 통합 기능도 아니고, 노트가 오프라인으로 유지된다는 보장도 아닙니다. Telli.sh 계정 만들기