Llama Windows: la prima chat con IA locale, senza configurare il terminale
Installa Llama Windows in sicurezza, scegli un modello GGUF adatto al PC, prova tre prompt pratici e collegati all’API locale senza esporre il server.
Il primo compito da affidare a un’IA locale dovrebbe essere semplice: trasformare sei note immaginarie di una riunione in tre azioni da svolgere. Per scoprire se il computer è in grado di rispondere non dovresti dover compilare un motore di inferenza, indovinare una dozzina di opzioni di avvio o caricare un documento privato.
Llama Windows, presentato da Hugging Face il 13 ottobre 2026, integra il runtime llama.cpp in un’app per la barra delle applicazioni di Windows. Consente di trovare e scaricare modelli e offre un’interfaccia di chat locale e un’API per altre applicazioni. Il nome si riferisce all’app, non a una limitazione ai modelli Llama di Meta. Annuncio del lancio
Questa guida illustra un’installazione sicura, la scelta di un primo modello adatto e una prima conversazione che puoi verificare. Poi vedremo tre attività utili e, facoltativamente, una richiesta tramite API locale. Comincia con testo pubblico o inventato; usa materiale sensibile solo dopo aver compreso l’intero flusso.
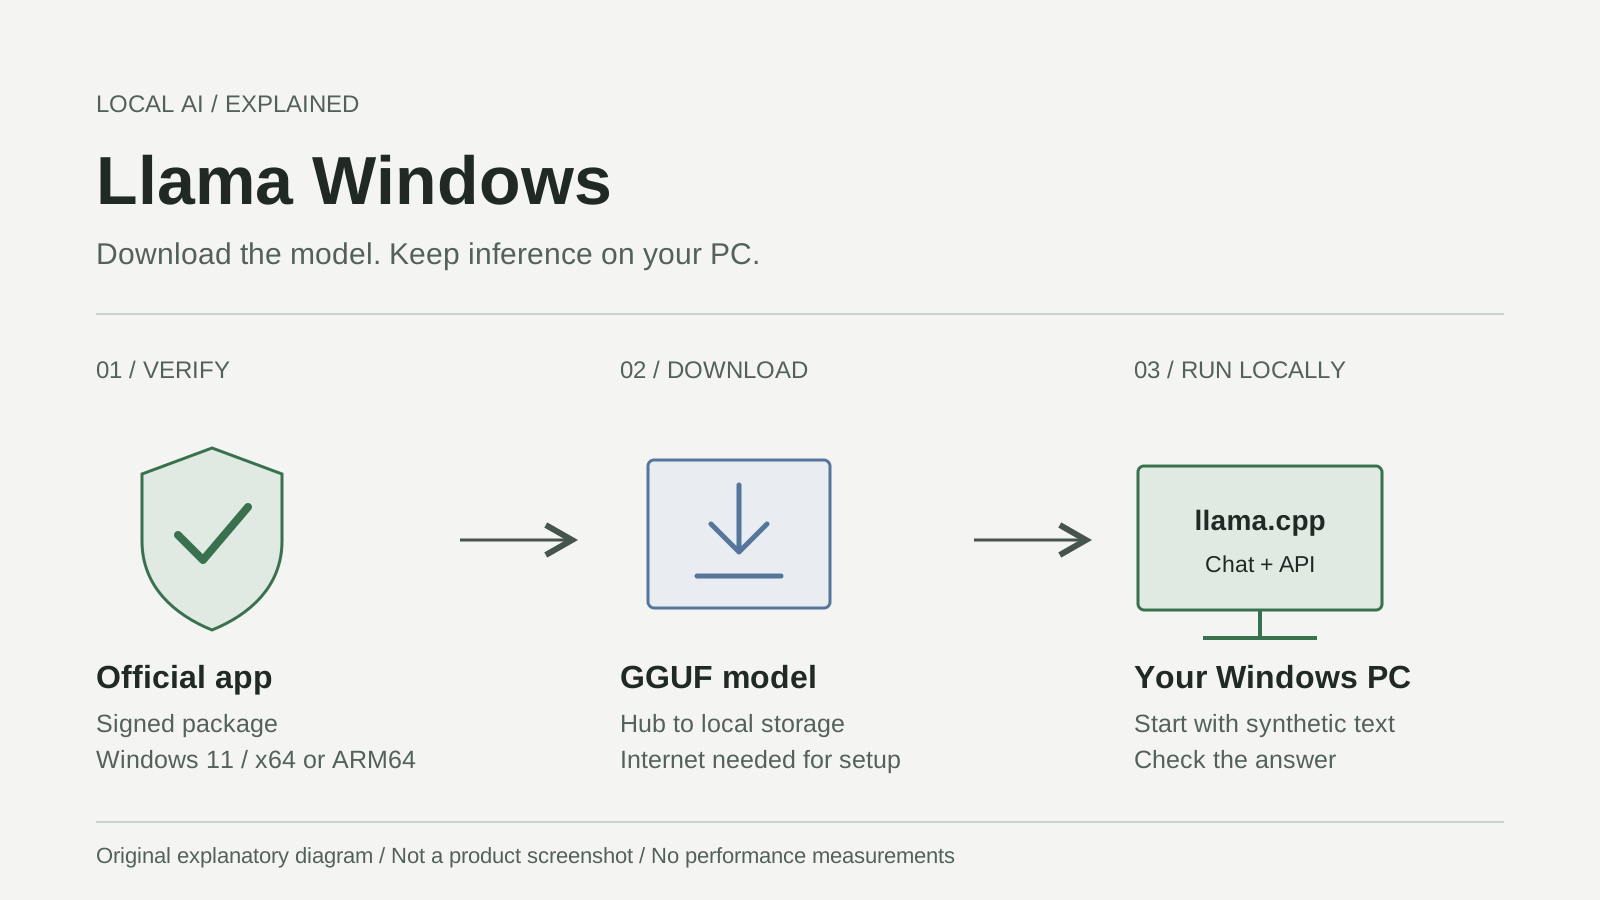
Grafica esplicativa originale, non uno screenshot del prodotto. Il download necessario alla configurazione e l’inferenza locale sono fasi distinte. Basata sulla guida ufficiale all’installazione per Windows.
Verifica la versione di Windows prima di scegliere un modello
Alla verifica del 20 ottobre, l’ultima versione pubblicata per Windows è v0.12.0. Il manifesto del pacchetto richiede Windows.Desktop 10.0.26100.0 o successivo. La build 26100 corrisponde a Windows 11 versione 24H2; usa una versione di Windows attualmente supportata, non soltanto quella più vecchia che supera l’installazione. Release, manifesto della release, informazioni sulle release Microsoft
Cerca winver in Windows per controllare la build. Nelle Impostazioni di Windows, apri Sistema > Informazioni per verificare il tipo di sistema e la RAM installata. Il file .msixbundle ufficiale contiene build x64 e ARM64: x64 è la scelta abituale per i PC Windows Intel/AMD; ARM64 è destinato ai dispositivi Windows su Arm. Il bundle seleziona l’architettura. Tra gli asset della release attuale non è incluso un pacchetto x86 a 32 bit. Repository Windows, pacchettizzazione del bundle
La documentazione di installazione per Windows non indica un requisito minimo universale di RAM, VRAM o GPU dedicata. Il fabbisogno dipende dal modello e dal contesto. llama.cpp supporta l’inferenza su CPU e diversi backend GPU, ma ciò non garantisce la stessa accelerazione su ogni PC. Non è necessario avere proprio una RTX Spark. Funzionalità di llama.cpp
Su Mac, segui il percorso separato Download for Mac su llama.app. Non installare il bundle per Windows né riutilizzare le istruzioni dei driver Windows. Nemmeno le dimensioni dell’app Mac riportate sul sito sono requisiti per l’installer Windows.
Installa l’app firmata senza indebolire la sicurezza di Windows
Il normale percorso con pacchetto non richiede compilazioni né l’installazione dell’SDK .NET. I prerequisiti per compilare dai sorgenti servono agli sviluppatori, non per questa procedura iniziale. Documentazione ufficiale d’installazione
- Apri llama.app e scegli Download for Windows 11, oppure segui il collegamento Releases nel repository. Verifica che la release provenga da
ggml-org/Llama-Windows, non da un sito di download dal nome simile. - Scegli il file
.msixbundleattuale, non l’archivio del codice sorgente su GitHub. Per la release verificata, il file si chiamaLlamaApp-v0.12.0.msixbundle. Durante l’installazione, tieni aperta la pagina della release. - Apri il bundle con Windows App Installer. Prima di selezionare Installa, controlla le informazioni sul publisher e sulla firma. Nel manifesto v0.12.0 l’identità di firma è Hugging Face, mentre il nome visualizzato del publisher è Morgan Funtowicz. Un nome visualizzato familiare non basta a verificare una firma: Windows deve considerare attendibile la firma del pacchetto. Identità del pacchetto
- Se Windows segnala un publisher sconosciuto, una firma non valida o un vincolo dell’organizzazione, fermati. Ricontrolla l’asset ufficiale, aggiorna Windows o App Installer tramite i canali Microsoft oppure chiedi all’amministratore. Non disattivare Defender o SmartScreen, non aggirare i criteri di esecuzione e non importare un certificato sconosciuto per forzare l’installazione. Risoluzione dei problemi di App Installer Microsoft
- Avvia Llama e cerca l’icona nell’area di notifica accanto all’orologio; se serve, controlla la freccia delle icone nascoste. Se manca, l’app può installare il runtime llama.cpp gestito, quindi il primo avvio potrebbe richiedere una connessione Internet. Procedura di download per Windows, configurazione del runtime
Lascia invariate le impostazioni di condivisione in rete. In v0.12.0, Settings > Llama > Listen On controlla l’indirizzo del server; l’impostazione predefinita è localhost. La prima chat non richiede un’eccezione per il traffico di rete in ingresso né un indirizzo raggiungibile da un altro computer. Note sulla sicurezza della release
Un modello che entra sul disco potrebbe non entrare in memoria
GGUF è un formato di file per modelli che contiene pesi e metadati da usare con motori d’inferenza come llama.cpp. Non è un marchio di chatbot né una valutazione di qualità. Per conversare, conviene iniziare con un modello ottimizzato per le istruzioni o per la chat; un modello base ha un altro scopo. Leggi la scheda del modello invece di scegliere solo in base al numero di download. Documentazione GGUF di Hugging Face, indicazioni sulle schede dei modelli
Il numero di parametri descrive i valori numerici appresi dal modello: 3B significa circa tre miliardi di parametri, non un download da 3 GB. La quantizzazione memorizza quei valori in modo più compatto. Nomi come Q4_K_M e Q8_0 identificano diverse ricette di quantizzazione, non versioni dell’app. Una precisione inferiore può ridurre le esigenze di memoria e spazio di archiviazione; i compromessi tra qualità e velocità dipendono dal modello e dall’hardware. Non è automaticamente la scelta più veloce o migliore. Guida alla quantizzazione di llama.cpp
Tieni distinti quattro valori:
| Voce | Cosa devi considerare nel budget | Scelta per principianti |
|---|---|---|
| Spazio su disco | File del modello scaricati, runtime e spazio temporaneo per il download | Controlla l’unità di destinazione prima di scaricare |
| RAM di sistema | Windows, altre applicazioni, dati del modello e attività del runtime | Lascia spazio per il normale uso del PC |
| VRAM della GPU | Lavoro assegnato a una GPU dedicata | Non confonderla con la RAM di sistema |
| Contesto | Token mantenuti per istruzioni, conversazione e testo generato | Inizia con un valore breve invece del massimo |
Il contesto è la scrivania di lavoro della conversazione. Una scrivania più grande contiene più materiale, ma occupa anche più memoria. I token sono frammenti di testo, non corrispondono a un numero fisso di parole; lingue e codice diversi vengono tokenizzati in modo diverso. I pesi del modello sono solo una parte della memoria necessaria: contano anche la cache key/value e i buffer del runtime. Parametri del server llama.cpp
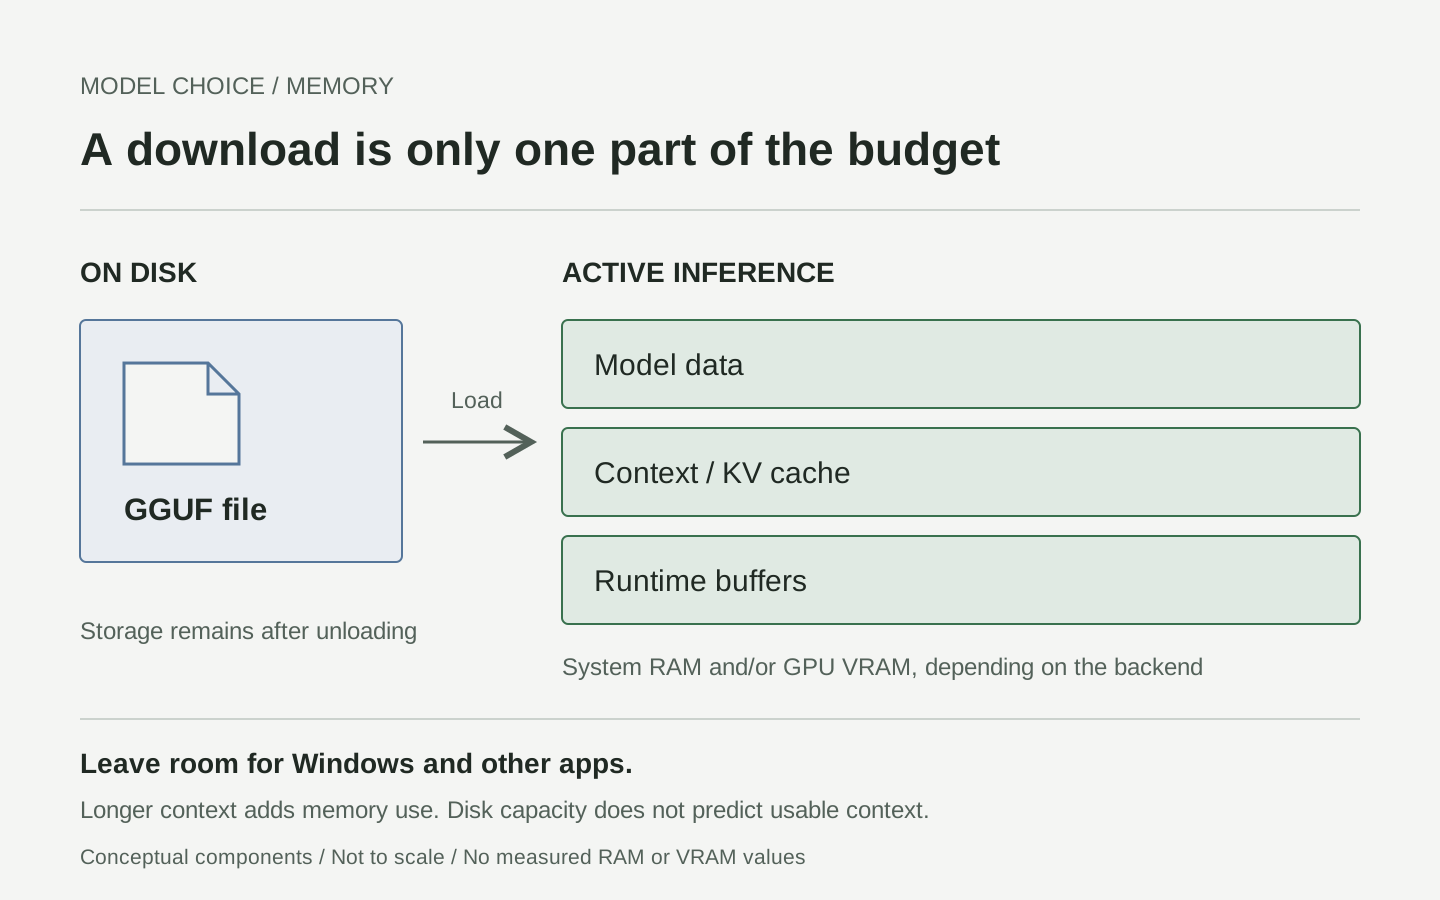
Diagramma concettuale originale, non una misurazione dell’allocazione. La fonte dei dettagli del modello stima la memoria per modello e contesto; l’uso totale del PC comprende altro.
Apri i dettagli di un modello e controlla le stime di memoria in base alla lunghezza del contesto. Scegli un modello chat consigliato di dimensioni contenute e un’opzione di contesto breve che lasci margine. Un file ipotetico da 4 GB su un PC con 16 GB di RAM non dimostra che ci starà anche una conversazione lunga. Se in seguito confronti quantizzazioni diverse, mantieni invariati modello, prompt e contesto per capire cosa è cambiato. Prima di un uso commerciale, verifica la licenza del modello: la licenza MIT dell’app non copre tutti i modelli scaricabili.
Rendi la prima conversazione facile da verificare
L’articolo di lancio chiama i pannelli Recommended Models e Available. Il codice sorgente v0.12.0 verificato usa invece Models, un separatore Browse more e suggerimenti per le icone come Download model, Load model, Open WebUI e Stop model. Segui i controlli presenti nella tua versione, senza cercare all’infinito il nome di un vecchio pannello. Codice sorgente dell’interfaccia Windows per versione
- Apri il pannello dell’area di notifica e controlla dimensioni e dettagli di un modello consigliato. Per il primo avvio, scegli un modello pubblico che non richieda accesso con autorizzazione.
- Usa il comando di download e attendi che termini. Il completamento del download significa che il file è arrivato, non che l’inferenza sia in corso.
- Nei dettagli del modello seleziona un contesto breve, quindi usa Load model. Dopo il caricamento, seleziona Open WebUI per aprire la chat locale. Anche la guida rapida ufficiale consiglia di scegliere il contesto prima di avviare la chat. Guida rapida
- Incolla il prompt sintetico qui sotto e invialo. Confronta la risposta con i fatti forniti; la sola comparsa di testo non dimostra che il test sia riuscito.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
Una risposta utile mantiene entrambe le date e lascia quella di Sam come non specificata. Inventare una scadenza è un errore di precisione, anche se l’installazione funziona perfettamente. Conserva il prompt e l’ID del modello per confrontarli, poi usa Stop model quando hai finito. L’app documenta anche una sovrapposizione di chat con Alt+Space: è facoltativa, non necessaria. README di Windows
Tre piccoli incarichi mostrano a cosa serve un modello locale
Sono esercizi illustrativi con input inventati, non risultati registrati del modello. Ognuno include un’attività, una domanda successiva e un criterio di accettazione concreto.
Trasforma appunti grezzi in un passaggio di consegne senza inventare decisioni
Immagina che un gruppo di volontari stia preparando un evento per il fine settimana. Inserisci questa richiesta:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
La distinzione utile è quella tra un impegno e una proposta. Chiedi: “Quali azioni sono state assegnate esplicitamente e quali sono solo proposte?”. Accetta il risultato solo se l’incarico di June è assegnato, l’offerta di Omar resta provvisoria e non compare un orario di inizio. Conserva gli appunti originali insieme al passaggio di consegne, così un’altra persona può controllare le prove.
Studia un brano con domande che restano entro i limiti della fonte
Usa un breve brano di pubblico dominio o una spiegazione sintetica che hai scritto tu. Ecco un esercizio autonomo:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
Controlla tutte le citazioni, non solo la plausibilità delle risposte. Una buona domanda senza risposta potrebbe riguardare le soglie di temperatura, ma il modello non deve inventarle. In un secondo passaggio, chiedi una formulazione più semplice che conservi tutti i fatti. Così ottieni una riscrittura verificabile frase per frase, invece di invitare il modello ad aggiungere un tutorial generico sulle serre.
Prepara una risposta al cliente senza fare promesse avventate
Prima di usare il testo di un cliente reale, esercitati con una richiesta inventata:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
Rifiuta una bozza che dichiari che il rimborso è stato elaborato o garantisca un risultato in giornata. Chiedi al modello di evidenziare ogni promessa formulata, poi esaminale personalmente. Solo una persona con accesso al sistema di assistenza effettivo può confermare un’azione sull’account. L’esecuzione locale cambia il luogo in cui si prepara la bozza, ma non autorizza il modello a emettere rimborsi.
Puoi riutilizzare lo stesso modello tramite l’API locale
Puoi limitarti alla chat. Per collegare un editor, uno script o un prototipo, il server gestito è documentato all’indirizzo http://localhost:9931, con richieste compatibili con OpenAI sotto /v1. È una compatibilità locale, non una richiesta al cloud di OpenAI. Se hai modificato la porta, verifica il valore nelle Impostazioni. Documentazione dell’API Llama
Con l’app in esecuzione e il modello già caricato, apri PowerShell. Per prima cosa elenca i modelli disponibili nel router: /models include lo stato di caricamento, mentre /v1/models è l’endpoint dei metadati compatibile con OpenAI. Copia l’ID esatto del modello che hai caricato intenzionalmente. Non selezionare una voce qualsiasi per prima: potrebbe causare il caricamento di un altro modello.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
Prima di eseguire il secondo blocco, sostituisci il segnaposto con quell’ID esatto. Invia solo testo sintetico e non richiede SDK aggiuntivi:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
La struttura della richiesta e il campo di output seguono il riferimento ufficiale al server llama.cpp. Lascia Listen On su localhost e non inserire mai in questo esempio una chiave API cloud. Un errore 401 richiede di controllare l’autenticazione locale, non di rimuovere la protezione. In v0.12.0, scegliendo un indirizzo diverso da loopback, l’app genera una chiave e richiede conferma. Comportamento di sicurezza su Windows
L’inferenza locale non elimina ogni attività di rete
Il README per Windows dichiara che prompt e inferenza restano locali e che l’app non invia telemetria. Documenta inoltre richieste di rete per scaricare modelli e controllare gli aggiornamenti delle release, con un User-Agent che contiene versione dell’app, build di Windows e architettura. Sono attività diverse e non c’è contraddizione: dipende da cosa si intende per “offline”. Informativa sulla privacy
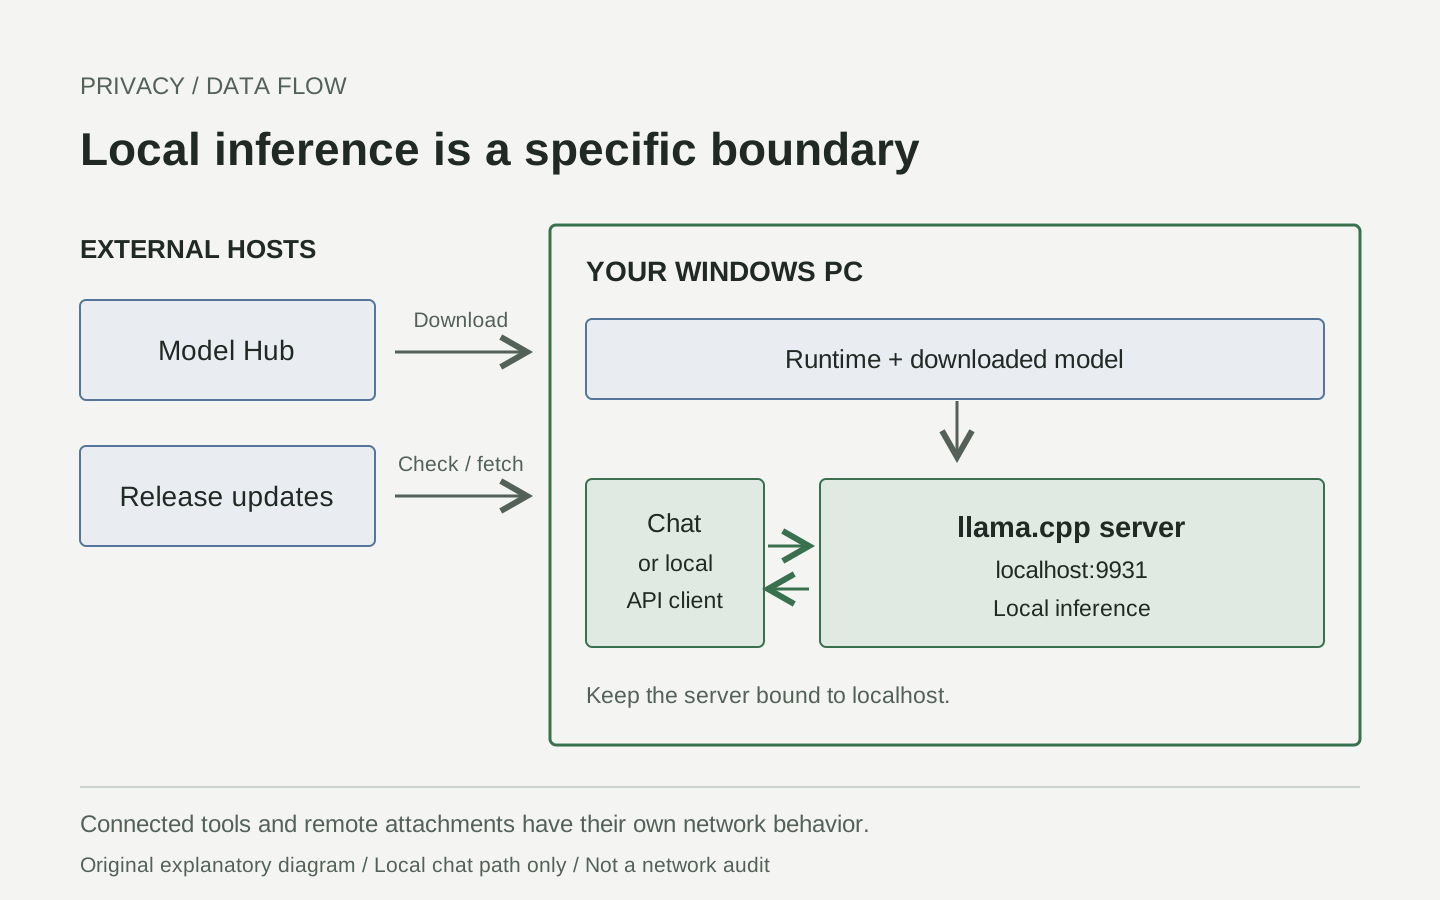
Spiegazione originale del flusso dei dati. Gli host di download sono esterni; il percorso di chat illustrato è locale. Fonti: documentazione sulla privacy per Windows e riferimento API.
Un modello supportato, una volta scaricato, può eseguire inferenze senza connessione a Internet; un nuovo modello va comunque scaricato. Un editor collegato, un’estensione del browser, un URL remoto per gli allegati o uno strumento esterno abilitato hanno un proprio comportamento di rete. Non presumere che ereditino il confine locale del server.
Prima di lavorare con informazioni riservate, controlla l’archiviazione delle conversazioni, le estensioni del browser, i percorsi di backup e sincronizzazione e le regole della tua organizzazione. Una chat sintetica offline è un utile test funzionale dopo la configurazione, non la prova che ogni componente sia stato sottoposto a verifica. Non inserire mai token o prompt privati nei log diagnostici pubblici.
Risolvi il problema nella fase interessata, non nell’intera installazione
| Problema | Prima verifica | Passo successivo utile |
|---|---|---|
| Il bundle non si installa | Build minima 26100, architettura, firma, criteri del dispositivo | Conserva l’errore esatto di App Installer; usa gli aggiornamenti ufficiali o chiedi all’amministratore |
| Non è visibile alcuna finestra dell’app | Area di notifica e icone nascoste | Apri l’icona nell’area di notifica; non è prevista una finestra permanente sulla barra delle applicazioni |
| Il download del modello non riesce | Spazio di destinazione, connessione, accesso limitato, errore visualizzato | Risolvi la causa prima di riprovare; inizia con un modello pubblico |
| Il download termina ma il caricamento non riesce | Stima del contesto, memoria libera, errore del runtime | Arresta gli altri modelli caricati e riduci contesto o dimensioni del modello |
| Le risposte sono lente | Dimensioni del modello, lunghezza del contesto, backend CPU/GPU effettivamente in uso | Confronta un prompt breve; un modello consigliato nel catalogo non garantisce una determinata velocità |
| L’API non si collega | App in esecuzione, porta configurata, indirizzo locale | Controlla lo stato del server prima di avviarne un secondo |
| Una risposta fluida contiene dettagli falsi | Testo sorgente e adeguatezza del modello | Riduci l’ampiezza del task e chiedi citazioni a supporto |
Il README attuale colloca impostazioni e log in %LOCALAPPDATA%\Llama; l’articolo di lancio riportava un percorso diverso per i log. Usa il comando dell’app per aprire la cartella dei log invece di indovinarne il percorso. L’endpoint documentato /health aiuta a distinguere un server del modello pronto da uno ancora in caricamento, anche se la disponibilità del router non dimostra che il modello scelto sia stato caricato. Documentazione attuale dei dati archiviati, comportamento di stato del server
Considera riuscita la prima configurazione solo dopo queste verifiche
- Il pacchetto ufficiale firmato si installa senza disattivare i controlli di sicurezza.
- Un modello scelto intenzionalmente termina il download e si carica.
- La chat si apre su un indirizzo locale e risponde all’attività sintetica.
- Date, nomi e informazioni mancanti corrispondono al testo fornito.
- Puoi arrestare il modello e caricarlo di nuovo.
- Se usi l’API, risponde il modello desiderato e il server resta accessibile solo tramite localhost.
In breve: l’IA locale è un flusso di lavoro che puoi verificare
Secondo noi, il miglioramento importante non consiste nell’evitare un comando da terminale. Consiste nel rendere la scelta del modello, l’uso della memoria, il materiale sorgente e la risposta abbastanza comprensibili da poterli riutilizzare. Inizia con una piccola attività di cui puoi verificare la risposta. Amplia il lavoro solo quando sai come si presenta il successo.
Fonti e contenuti multimediali
Verificato il 20 ottobre 2026. Questa guida descrive flussi documentati; non dichiara di aver effettuato installazioni di prova, eseguito modelli o richieste a pagamento, né realizzato benchmark. Tutte e tre le immagini SVG sono illustrazioni esplicative originali, non riproduzioni dell’interfaccia. Per vedere l’interfaccia effettiva, consulta lo screenshot ufficiale della barra delle applicazioni e la dimostrazione dell’overlay del publisher. I materiali sono collegati, non ripubblicati.
- Annuncio di Hugging Face, 13 ottobre
- Release Windows, pacchetto e modifiche alla sicurezza
- Installazione e guida rapida ufficiali
- Formato GGUF e metadati
- Documentazione dell’API locale e degli endpoint
- Riferimento al runtime e al server llama.cpp
Rendi riutilizzabili i tuoi esperimenti
Conserva insieme link alle fonti, prompt, ID dei modelli e note di revisione, invece di salvare soltanto la risposta finale. Telli.sh può aiutarti a organizzare le note di ricerca; non è un’integrazione con Llama Windows e non garantisce che le note restino offline. Crea un account Telli.sh